Privacidad de datos en AI agents: manejo de PII, residencia y minimización
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
La privacidad de datos en AI agents es la disciplina de controlar qué datos personales lee, envía, almacena y elimina un agent a medida que recorre su propio ciclo: qué campos extrae de un sistema de registro, qué transmite a un modelo o a una herramienta de terceros, qué conserva en memoria después y cuánto tiempo permanece todo eso. Es una superficie mayor que la privacidad de una sola llamada a un modelo, porque las llamadas a herramientas de un agent dispersan datos entre varios sistemas en cada ejecución, y no solo hacia un proveedor de modelos. Tres prácticas concentran la mayor parte del peso: manejar la PII de forma deliberada y no por accidente, minimizar desde el principio lo que el agent toca, y saber dónde se procesan realmente los datos, no solo dónde se almacenan.
Por qué la superficie de privacidad de un agent es mayor que la de un modelo
Un solo prompt a un modelo plantea una única pregunta de privacidad: qué puso usted en él. Un agent plantea muchas. Cómo funcionan los AI agents describe el ciclo que ejecuta un agent: percibir, razonar, actuar, observar y repetir, y el paso de percepción por sí solo puede extraer datos de un CRM, de un sistema de soporte y de un almacén de documentos antes de que el agent haya tomado una sola decisión. Cómo usan herramientas los AI agents explica el mecanismo: cada llamada a una herramienta es un flujo de datos, que envía parámetros y recibe un resultado, y cada una es un lugar por donde los datos personales pueden viajar a un sistema que no formaba parte de la conversación original.
La privacidad de datos se ubica bajo el paraguas más amplio de la gobernanza de AI, las políticas y la supervisión que mantienen cualquier sistema de AI alineado con las expectativas regulatorias y de la organización. Lo que justifica una práctica propia para los agents es esa dispersión: la seguridad de AI agents pregunta si se puede engañar al agent para que haga algo dañino, mientras que la privacidad de datos plantea una pregunta más acotada y más silenciosa, que no requiere que nadie esté atacando nada. Aun cuando todo funciona exactamente como se diseñó, ¿los datos de quién fueron adónde y era necesario que fueran?
Manejo de PII: conózcala antes de moverla
Los datos personales abarcan más que los campos evidentes. El nombre y el correo electrónico son PII, pero también lo son una dirección IP, un ID de dispositivo, la descripción en texto libre de un ticket de soporte sobre una situación médica y el comentario de una evaluación de desempeño vinculado a un empleado. Un agent que lee cualquier sistema con registros reales de clientes o empleados está manejando PII, lo haya etiquetado alguien así o no. El AI Benefits Enrollment Agent es un ejemplo claro: ayudar a un empleado a elegir un plan de salud implica tocar datos vinculados a la salud e información de dependientes que exigen un estándar más alto que el de un ticket de soporte promedio, ya sea que el diseño del agent lo trate así por defecto o no.
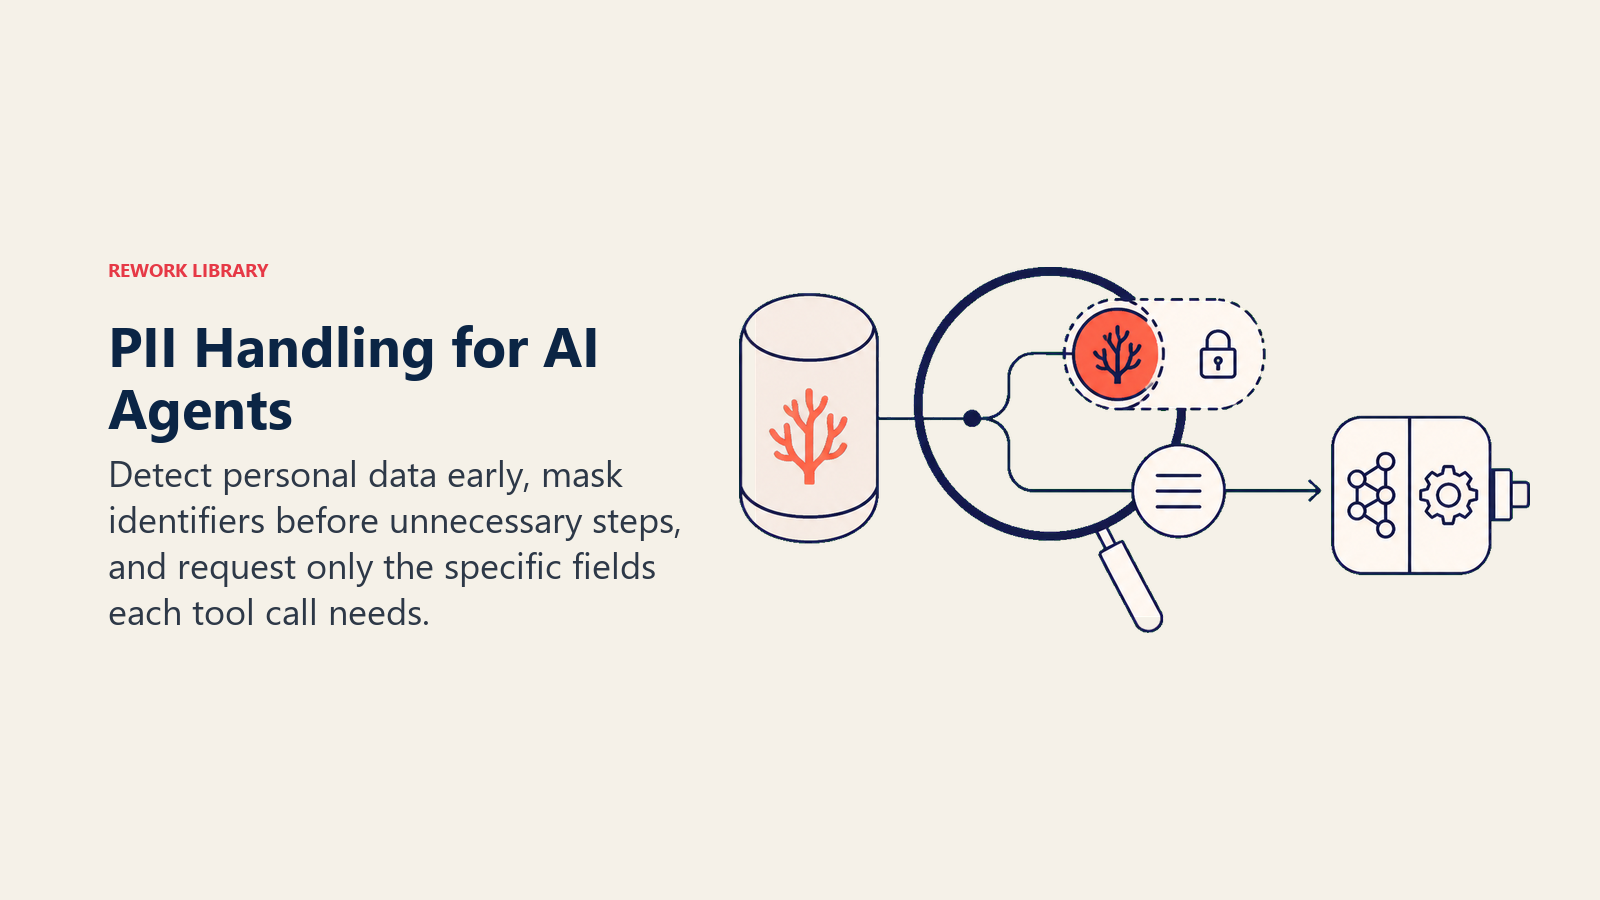
Algunos hábitos marcan la diferencia entre manejar esos datos de forma deliberada y filtrarlos por accidente:
- Nunca deje PII en bruto en un registro de depuración ni en un prompt que se almacene en caché o se retenga en el proveedor. Los registros suelen tratarse como un espacio interno y seguro. Normalmente no lo son, sobre todo cuando un registro se envía a una herramienta de observabilidad de terceros o a la retención de registros de un proveedor de modelos externo.
- Redacte o enmascare los datos antes de que lleguen a un paso que no necesita la versión identificable. Un paso que clasifica el tema de un ticket de soporte no necesita en contexto el nombre completo ni el número de cuenta del cliente para hacerlo; a menudo basta con un ID de ticket.
- Acote las llamadas a herramientas a campos específicos, no a registros completos. La versión de privacidad del diseño de herramientas con mínimo privilegio consiste en pedir
customer.plan_tieren lugar deget_full_customer_recordcuando el nivel del plan es todo lo que un paso realmente necesita. - Trate cada nueva integración de herramientas como un nuevo flujo de datos que revisar, no solo como una nueva capacidad que celebrar. Una herramienta técnicamente capaz de devolver todo el historial de compras de un cliente es una decisión de privacidad cada vez que se llama, no solo una decisión de ingeniería.
Minimización: la misma disciplina del mínimo privilegio, aplicada a los datos
La seguridad de AI agents defiende el mínimo privilegio en el acceso a herramientas: darle al agent solo los permisos que su trabajo real requiere, nada más. La minimización de datos es el mismo principio aplicado a los datos en lugar de a los permisos: extraiga solo los campos que un paso realmente necesita, no el registro completo porque estuviera disponible en una sola llamada a la API.
Esto no es solo una cortesía de cumplimiento. También es un problema de gestión del contexto: cada campo que un agent lleva a su ventana de contexto sin necesitarlo es a la vez un riesgo de privacidad y un peso muerto que el modelo debe procesar en cada paso. La gestión del contexto de AI agents cubre el lado del presupuesto de ese mismo instinto, conservar en el contexto solo lo que un paso necesita, aplicado a los tokens en general y no específicamente a los datos personales. Ambas disciplinas apuntan en la misma dirección por la misma razón de fondo: extraerlo todo por si acaso es peor que extraer exactamente lo necesario, ya sea que a usted le preocupe el costo de los tokens o la próxima pregunta de un delegado de protección de datos.
La memoria es donde la deuda de privacidad se acumula en silencio
AI Agent Memory explica cómo la memoria a largo plazo de un agent conserva hechos e historial entre sesiones, normalmente en una base de datos o un almacén vectorial que el agent puede consultar después. Ahí es exactamente donde la deuda de privacidad tiende a acumularse sin que se note. Un almacén de memoria que guarda indefinidamente cada detalle que un agent ha aprendido sobre un cliente, sin caducidad ni ruta de eliminación, es un pasivo creciente aunque nada en él parezca inusual un día cualquiera.
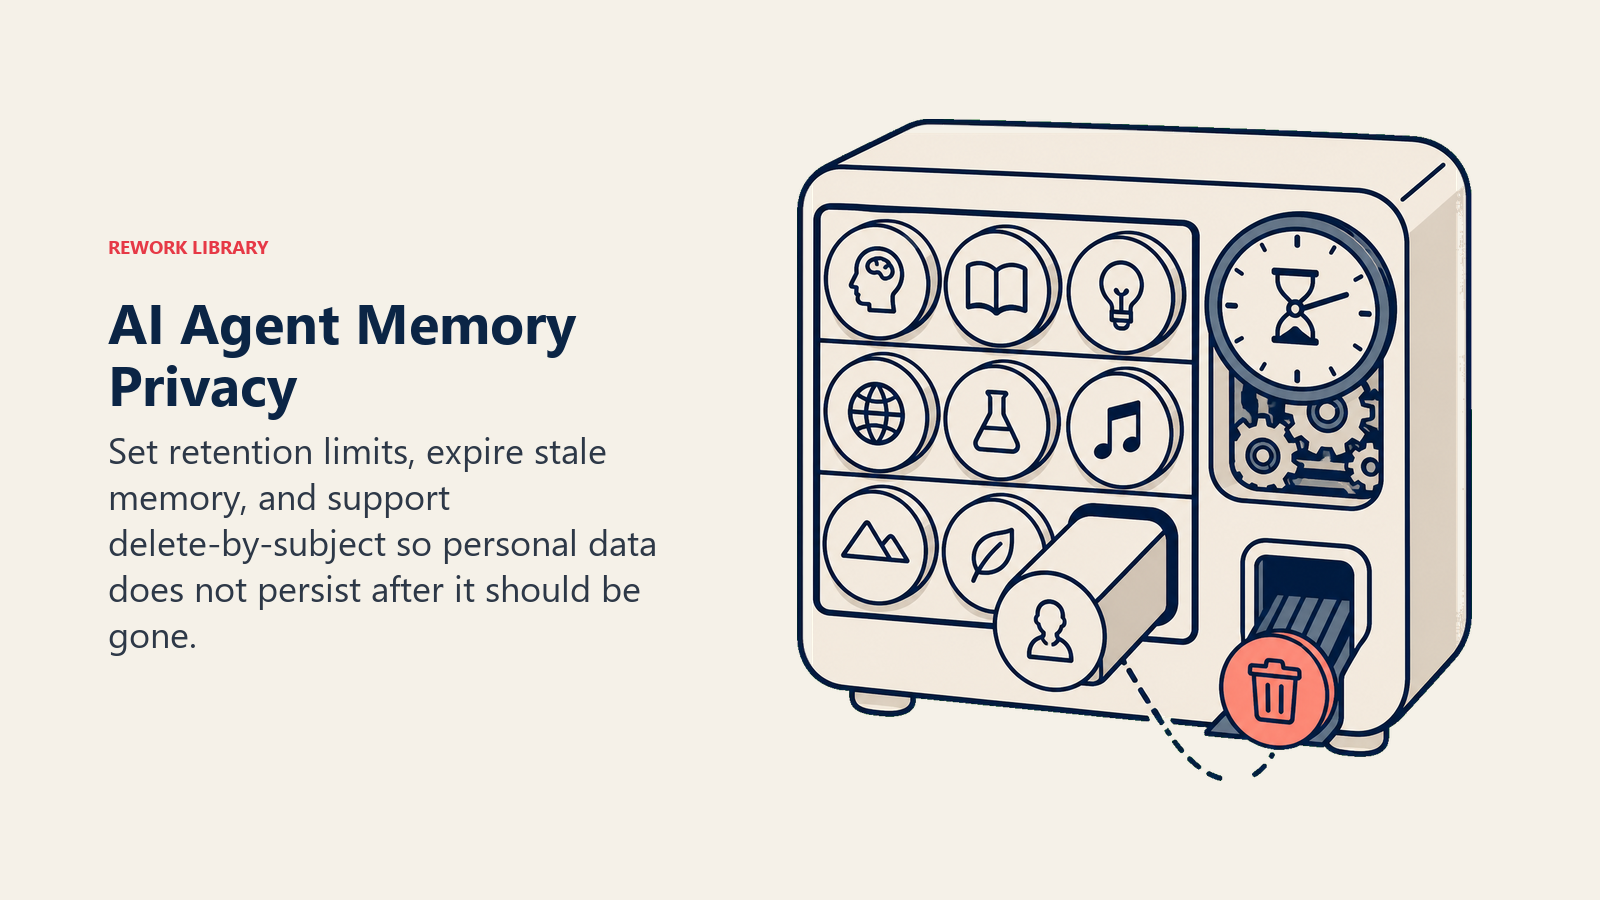
Dos capacidades importan aquí específicamente por la regulación de privacidad, no solo por buena higiene. Primero, una política de retención y caducidad: decida qué se le permite conservar a un almacén de memoria y por cuánto tiempo, en lugar de optar por "para siempre". Segundo, y a menudo se pasa por alto, una capacidad de eliminación por titular: bajo derechos de supresión de tipo GDPR, una persona puede pedir que se eliminen sus datos, y el almacén de memoria de un agent necesita una forma real de encontrar y eliminar todo lo vinculado a esa persona, y no solo el registro en su base de datos principal mientras una copia en la sombra permanece en un índice vectorial que nadie recuerda revisar.
Residencia de datos, brevemente: el almacenamiento no es toda la pregunta
Dónde se almacena un registro solía ser la mayor parte de la pregunta sobre residencia de datos. Un agent añade una segunda ubicación que importa igual: dónde se procesan los datos cuando una llamada a una herramienta o un paso de recuperación los trae al razonamiento de un modelo. Los datos personales regulados que se leen en un modelo que opera en una región distinta a la de su almacenamiento son un flujo de datos con su propio perfil de cumplimiento, no un detalle de implementación.
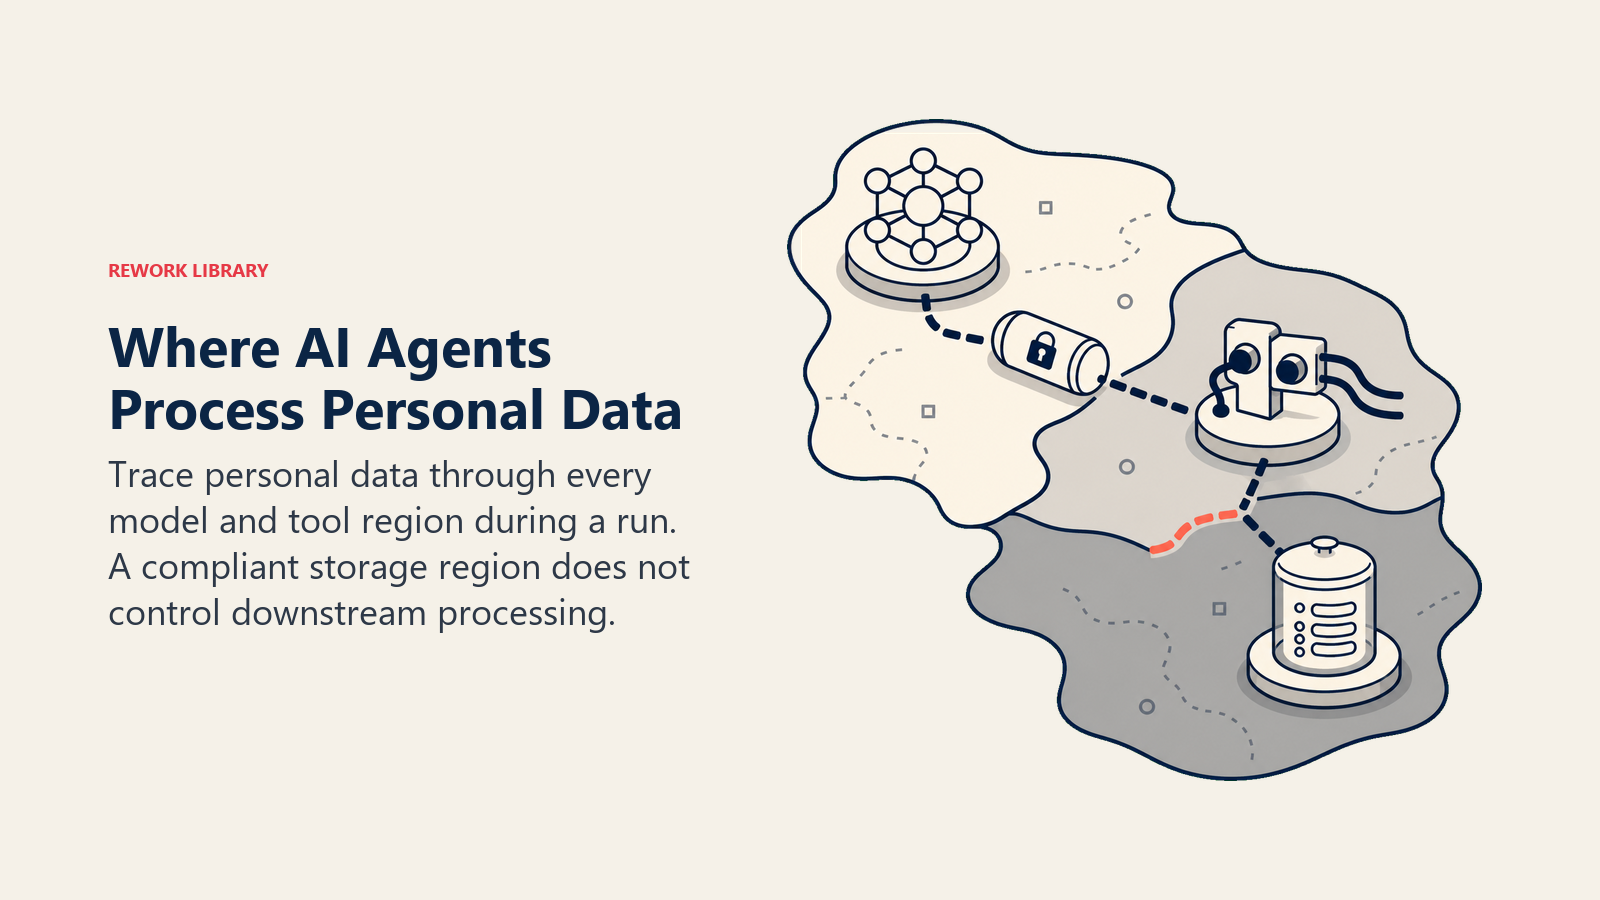
AI Agent Compliance cubre este terreno con verdadera profundidad, incluyendo cómo se mapea frente a la EU AI Act y qué debe capturar un registro de auditoría, y es el lugar al que acudir para el mapeo regulatorio. La conclusión específica de privacidad aquí es más simple: sepa, herramienta por herramienta, dónde procesa realmente cada una los datos que toca, y no solo dónde los almacena el sistema subyacente, y trate a cualquier agent que razone sobre datos personales regulados como una relación con un proveedor que merece el mismo escrutinio que un nuevo subencargado, porque eso es lo que es.
No es una preocupación hipotética que los equipos puedan relegar. El Data and Privacy Benchmark Study 2026 de Cisco, que encuestó a más de 5.200 profesionales de privacidad y seguridad, encontró que el 81% de las organizaciones enfrenta una mayor demanda de localización de datos y el 85% afirma que esto añade costo, complejidad y riesgo reales a la prestación de servicios transfronterizos. El mismo estudio encontró que, aunque el 75% de las organizaciones ya cuenta con un órgano dedicado de gobernanza de AI, solo el 12% lo describe como realmente maduro. La mayoría de las empresas ha empezado a construir la estructura. Muy pocas la han terminado.
Cuánto cuesta realmente una higiene de datos deficiente
El costo de equivocarse no es abstracto. El Cost of a Data Breach Report 2026 de IBM encontró que solo el 37% de las organizaciones cifra los datos sensibles en reposo y en tránsito, lo que significa que la mayoría de las organizaciones afectadas por brechas carecía de un control básico mucho antes de que interviniera un agent o un modelo. El mismo informe encontró que más del 20% de las organizaciones reportó una brecha dirigida directamente a modelos o aplicaciones de AI, con las APIs, aplicaciones o plug-ins comprometidos empatados como causa raíz principal con un 27%, la misma superficie que crean las llamadas a herramientas de un agent. Por separado, el OWASP Top 10 para aplicaciones LLM ubica la divulgación de información sensible en el puesto LLM02, tras estar en sexto lugar en la edición anterior, señal de la rapidez con que este riesgo ha subido en la lista a medida que más sistemas adquirieron la capacidad de recuperar y actuar sobre datos personales en lugar de solo hablar de ellos en abstracto.
Si usted va a incorporar una nueva plataforma de AI o un proveedor de agents que tocará datos personales, nuestras comparativas de herramientas de AI ponderan el manejo de datos como parte de la evaluación, y la matriz de evaluación de proveedores SaaS le ofrece una plantilla ponderada para puntuar la postura de privacidad y seguridad de una nueva herramienta antes de conectarla a cualquier cosa que toque datos reales de clientes o empleados.
Una lista de verificación inicial práctica
Cinco preguntas que vale la pena responder antes de que un agent obtenga acceso a cualquier sistema que contenga datos personales:
| Pregunta | Qué detecta |
|---|---|
| ¿Qué PII necesita ver realmente este agent para hacer su trabajo? | Acota el acceso de las herramientas a campos, no a registros completos |
| ¿Dónde aparece PII en bruto en registros, prompts o cachés? | Detecta las fugas accidentales que nadie diseñó a propósito |
| ¿Cuánto tiempo necesita realmente persistir lo que el agent recuerda? | Obliga a definir una política de retención en lugar de un valor indefinido por defecto |
| ¿Puede encontrar y eliminar todo lo vinculado a una persona si se lo piden? | Pone a prueba si los derechos de supresión son reales o teóricos |
| ¿Dónde procesa realmente cada llamada a una herramienta los datos que toca? | Revela el procesamiento transfronterizo que la ubicación del almacenamiento por sí sola oculta |
Datos clave
- La superficie de privacidad de un agent es mayor que la de una sola llamada a un modelo porque cada llamada a una herramienta es su propio flujo de datos, que dispersa datos personales entre varios sistemas en una sola ejecución.
- La minimización de datos para agents es el mismo principio que el acceso a herramientas con mínimo privilegio, aplicado a los datos: extraer solo los campos que un paso necesita, no el registro completo.
- La memoria a largo plazo de un agent es donde la deuda de privacidad se acumula en silencio; necesita tanto una política de retención y caducidad como una capacidad real de eliminación por titular para atender solicitudes de supresión.
- El Data and Privacy Benchmark Study 2026 de Cisco encontró que el 81% de las organizaciones enfrenta una mayor demanda de localización de datos y que solo el 12% describe como madura su estructura de gobernanza de AI, pese a que el 75% cuenta con una.
- El Cost of a Data Breach Report 2026 de IBM encontró que solo el 37% de las organizaciones cifra los datos sensibles en reposo y en tránsito, y que las APIs, aplicaciones o plug-ins comprometidos estaban empatados como causa raíz principal (27%) de las brechas dirigidas a modelos o aplicaciones de AI.
Preguntas frecuentes sobre la privacidad de datos en AI agents
¿Qué es la privacidad de datos en AI agents?
Es la práctica de controlar qué datos personales lee un agent, envía a un modelo o herramienta, almacena y finalmente elimina mientras ejecuta su ciclo. Abarca el manejo deliberado de la PII, la minimización de lo que el agent consulta y saber dónde se procesan realmente los datos, no solo dónde se almacenan.
¿En qué se diferencia la privacidad de datos de la seguridad de datos en un AI agent?
La seguridad pregunta si se puede manipular a un agent para que haga algo dañino, como filtrar datos a un atacante. La privacidad plantea una pregunta más acotada que aplica incluso cuando nadie está atacando nada: los datos de quién fueron adónde durante una ejecución normal y correcta, y si era necesario que fueran allí.
¿Qué es la minimización de datos en un AI agent?
Es la práctica de extraer solo los campos específicos que una tarea necesita en lugar de un registro completo solo porque una llamada a la API lo deja todo disponible. Sigue la misma lógica que el acceso a herramientas con mínimo privilegio, aplicada a los datos en lugar de a los permisos, y reduce tanto la exposición de privacidad como el contexto innecesario.
¿Puede la memoria de un AI agent vulnerar el derecho al olvido de alguien?
Sí, si el almacén de memoria no tiene forma de encontrar y eliminar, a solicitud, todo lo vinculado a una persona específica. La memoria a largo plazo, explicada en AI Agent Memory, conserva hechos entre sesiones y, sin una política de retención ni una capacidad real de eliminación por titular, puede mantener datos mucho más allá del momento en que la persona tiene derecho a que se eliminen.
¿Almacenar los datos en la región correcta resuelve la residencia de datos de un AI agent?
No por sí solo. Un agent puede llevar datos almacenados en una región conforme a un modelo o herramienta que los procesa en otro lugar durante una ejecución. La residencia de datos para un agent significa verificar dónde procesa realmente cada herramienta y modelo lo que toca, y no solo dónde residen los registros subyacentes.
A dónde ir a continuación
La privacidad de datos de un agent está estrechamente ligada a otras dos disciplinas que se tratan en otras partes de esta biblioteca. La seguridad de AI agents cubre el lado del modelo de amenazas, es decir, evitar que se manipule al agent para filtrar datos a propósito. AI Agent Compliance cubre en profundidad el mapeo regulatorio, el registro de auditoría y la EU AI Act. Lea la privacidad junto con ambas y no de forma aislada, ya que un agent verdaderamente bien gobernado necesita las tres funcionando en conjunto.

On this page
- Por qué la superficie de privacidad de un agent es mayor que la de un modelo
- Manejo de PII: conózcala antes de moverla
- Minimización: la misma disciplina del mínimo privilegio, aplicada a los datos
- La memoria es donde la deuda de privacidad se acumula en silencio
- Residencia de datos, brevemente: el almacenamiento no es toda la pregunta
- Cuánto cuesta realmente una higiene de datos deficiente
- Una lista de verificación inicial práctica
- Datos clave
- A dónde ir a continuación