Privacidade de Dados em AI Agents: Tratamento de PII, Residência e Minimização
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
A privacidade de dados em AI agents é a disciplina de controlar quais dados pessoais um agent lê, envia, armazena e apaga ao percorrer o próprio loop: quais campos ele extrai de um sistema de registro, o que repassa a um modelo ou a uma ferramenta de terceiros, o que guarda na memória depois e por quanto tempo tudo isso permanece. É uma superfície maior do que a privacidade de uma única chamada de modelo, porque as chamadas de ferramentas de um agent espalham dados por vários sistemas a cada execução, e não apenas para um provedor de modelo. Três práticas carregam a maior parte do peso: tratar a PII de forma deliberada, e não por acidente; minimizar o que o agent toca desde o início; e saber onde os dados realmente são processados, e não apenas onde estão armazenados.
Por que a Superfície de Privacidade de um Agent É Maior que a de um Modelo
Um único prompt a um modelo traz uma pergunta de privacidade: o que você colocou nele. Um agent traz várias. Como os AI agents funcionam descreve o loop que um agent executa, perceber, raciocinar, agir, observar e repetir, e só a etapa de percepção já pode puxar dados de um CRM, de um sistema de suporte e de um repositório de documentos antes de o agent tomar uma única decisão. Como os AI agents usam ferramentas mostra o mecanismo: cada chamada de ferramenta é um fluxo de dados, que envia parâmetros e recebe um resultado, e cada uma é um ponto em que dados pessoais podem viajar para um sistema que nem fazia parte da conversa original.
A privacidade de dados fica sob o guarda-chuva mais amplo da governança de IA, as políticas e a supervisão que mantêm qualquer sistema de IA alinhado às expectativas regulatórias e organizacionais. O que a torna merecedora de uma prática dedicada para agents é essa dispersão: a segurança de AI agents pergunta se o agent pode ser enganado para fazer algo prejudicial, enquanto a privacidade de dados faz uma pergunta mais estreita e mais silenciosa, que não exige que ninguém esteja atacando nada. Mesmo quando tudo funciona exatamente como projetado, os dados de quem foram para onde, e era preciso?
Tratamento de PII: Conheça-a Antes de Movê-la
Os dados pessoais abrangem mais do que os campos óbvios. Nome e e-mail são PII, mas também são um endereço IP, um ID de dispositivo, a descrição em texto livre de um ticket de suporte sobre uma situação médica e um comentário de avaliação de desempenho ligado a um funcionário. Um agent que lê qualquer sistema com registros reais de clientes ou funcionários está tratando PII, quer alguém tenha rotulado assim ou não. O AI Benefits Enrollment Agent é um exemplo claro: ajudar um funcionário a escolher um plano de saúde significa tocar em dados ligados à saúde e em informações de dependentes que exigem um nível de cuidado maior do que um ticket de suporte médio, quer o design do agent trate isso assim por padrão ou não.
Alguns hábitos fazem a diferença entre tratar esses dados de forma deliberada e vazá-los por acidente:
- Nunca deixe PII bruta em um log de depuração ou em um prompt que seja armazenado em cache ou retido no provedor. O logging costuma ser tratado como um espaço interno seguro. Em geral não é, principalmente quando um log é enviado a uma ferramenta de observabilidade de terceiros ou à retenção de logs de um provedor externo de modelo.
- Oculte ou mascare os dados antes de chegarem a um passo que não precisa da versão identificável. Um passo que classifica o assunto de um ticket de suporte não precisa do nome completo e do número da conta do cliente no contexto para fazer isso; um ID de ticket costuma bastar.
- Delimite as chamadas de ferramentas a campos específicos, e não a registros inteiros. A versão de privacidade do design de ferramentas com privilégio mínimo é pedir
customer.plan_tierem vez deget_full_customer_recordquando o nível do plano é tudo de que um passo realmente precisa. - Trate cada nova integração de ferramenta como um novo fluxo de dados a revisar, e não apenas como uma nova capacidade a celebrar. Uma ferramenta tecnicamente capaz de devolver todo o histórico de compras de um cliente é uma decisão de privacidade toda vez que é chamada, e não apenas uma decisão de engenharia.
Minimização: a Mesma Disciplina do Privilégio Mínimo, Aplicada aos Dados
A segurança de AI agents defende o privilégio mínimo no acesso a ferramentas: dê a um agent apenas as permissões que o trabalho dele realmente exige, nada além. A minimização de dados é o mesmo princípio aplicado a dados em vez de permissões: extraia apenas os campos de que um passo realmente precisa, e não o registro inteiro só porque estava disponível em uma chamada de API.
Isso não é só uma gentileza de compliance. É também um problema de gerenciamento de contexto: cada campo que um agent puxa para a janela de contexto sem realmente precisar dele é, ao mesmo tempo, um risco de privacidade e um peso morto que o modelo precisa processar a cada passo. O gerenciamento de contexto de AI agents trata do lado do orçamento desse mesmo instinto, manter no contexto apenas o que um passo precisa, aplicado a tokens em geral e não a dados pessoais especificamente. As duas disciplinas apontam na mesma direção pelo mesmo motivo de fundo: puxar tudo por precaução é pior do que puxar exatamente o necessário, quer você se preocupe com o custo de tokens ou com a próxima pergunta de um encarregado de proteção de dados.
A Memória É Onde o Débito de Privacidade se Acumula em Silêncio
A memória de AI agents trata de como a memória de longo prazo de um agent persiste fatos e histórico entre sessões, em geral em um banco de dados ou em um vector store que o agent pode consultar depois. É exatamente aí que o débito de privacidade tende a se acumular sem ser notado. Um repositório de memória que guarda para sempre todo detalhe que um agent já aprendeu sobre um cliente, sem expiração e sem caminho de exclusão, é um passivo crescente, mesmo que nada nele pareça incomum em um dia qualquer.
Duas capacidades importam aqui especificamente por causa da regulação de privacidade, e não apenas da boa higiene. Primeiro, uma política de retenção e expiração: decida o que um repositório de memória pode guardar e por quanto tempo, em vez de adotar "para sempre" como padrão. Segundo, e muitas vezes esquecida, uma capacidade de exclusão por titular: sob direitos de apagamento no estilo do GDPR, uma pessoa pode pedir que seus dados sejam excluídos, e o repositório de memória de um agent precisa de uma forma real de localizar e remover tudo ligado a essa pessoa, e não apenas o registro no seu banco de dados principal enquanto uma cópia sombra permanece em um índice vetorial que ninguém lembra de verificar.
Residência de Dados, em Resumo: Armazenamento Não É Toda a Questão
Onde um registro é armazenado costumava ser a maior parte da questão da residência de dados. Um agent acrescenta um segundo local que importa tanto quanto: onde os dados são processados quando uma chamada de ferramenta ou uma etapa de recuperação os traz para o raciocínio de um modelo. Dados pessoais regulados lidos em um modelo executado em uma região diferente de onde estão armazenados formam um fluxo de dados com perfil de conformidade próprio, e não um detalhe de implementação.
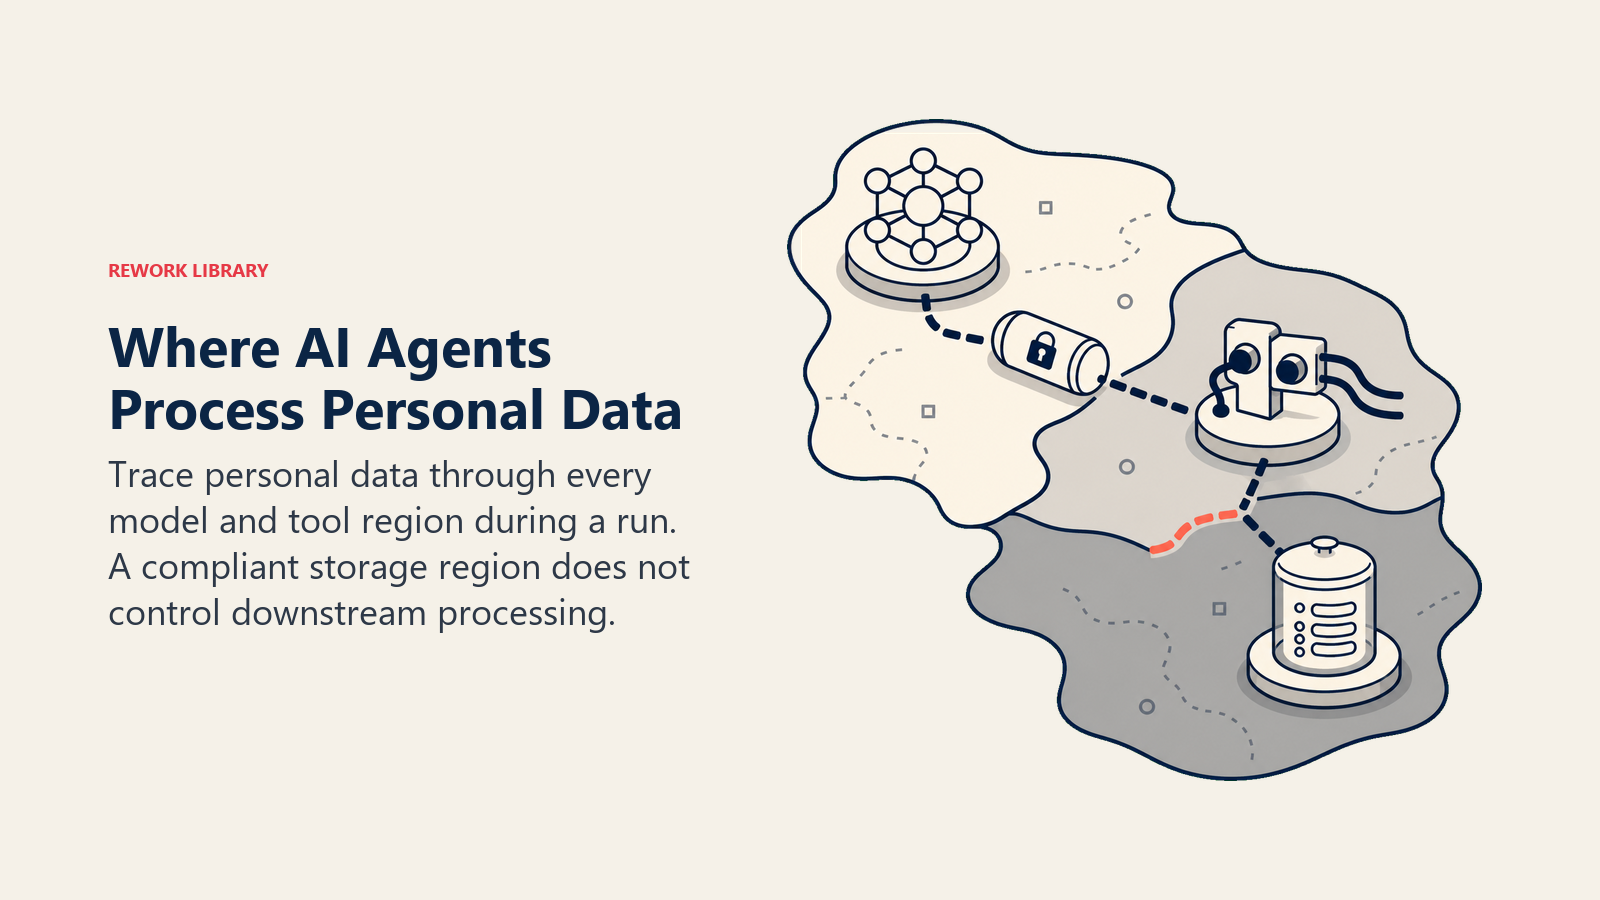
A conformidade de AI agents cobre esse terreno com real profundidade, inclusive como ele se mapeia com o EU AI Act e o que uma trilha de auditoria precisa capturar, e é o lugar para consultar o mapeamento regulatório. A conclusão específica de privacidade aqui é mais simples: saiba, ferramenta por ferramenta, onde cada uma realmente processa os dados em que toca, e não apenas onde o sistema subjacente os armazena, e trate qualquer agent que raciocine sobre dados pessoais regulados como uma relação com fornecedor que merece o mesmo escrutínio de um novo suboperador, porque é isso que ele é.
Essa não é uma preocupação hipotética que as equipes possam deixar para depois. O Cisco 2026 Data and Privacy Benchmark Study, que ouviu mais de 5.200 profissionais de privacidade e segurança, constatou que 81% das organizações enfrentam uma demanda crescente por localização de dados e 85% afirmam que isso acrescenta custo, complexidade e risco reais à prestação de serviços transfronteiriça. O mesmo estudo constatou que, embora 75% das organizações já tenham um órgão dedicado de governança de IA, apenas 12% o descrevem como realmente maduro. A maioria das empresas começou a construir a estrutura. Muito poucas a concluíram.
O que a Higiene Fraca de Dados Realmente Custa
O custo de errar aqui não é abstrato. O IBM Cost of a Data Breach Report de 2026 constatou que apenas 37% das organizações criptografam dados sensíveis em repouso e em trânsito, o que significa que a maioria das organizações violadas não tinha um controle básico muito antes de um agent ou um modelo entrar em cena. O mesmo relatório constatou que mais de 20% das organizações relataram uma violação direcionada a modelos ou aplicações de IA, com APIs, aplicações ou plug-ins comprometidos empatados como principal causa raiz, em 27%, exatamente a superfície que as chamadas de ferramentas de um agent criam. Separadamente, o OWASP Top 10 para aplicações de LLM coloca a divulgação de informações sensíveis em LLM02, acima do sexto lugar da edição anterior, sinal de quão rápido esse risco subiu na lista à medida que mais sistemas ganharam a capacidade de recuperar dados pessoais e agir sobre eles, em vez de apenas discuti-los em abstrato.
Se você está trazendo uma nova plataforma de IA ou um fornecedor de agents que vai tocar em dados pessoais, nossas comparações de ferramentas de IA ponderam o tratamento de dados como parte da avaliação, e o scorecard de avaliação de fornecedores SaaS oferece um modelo ponderado para pontuar a postura de privacidade e segurança de uma nova ferramenta antes de conectá-la a qualquer coisa que toque dados reais de clientes ou funcionários.
Um Checklist Prático para Começar
Cinco perguntas que valem ser respondidas antes de um agent ganhar acesso a qualquer sistema que guarde dados pessoais:
| Pergunta | O que ela detecta |
|---|---|
| Que PII este agent realmente precisa ver para fazer o trabalho dele? | Delimita o acesso das ferramentas a campos, e não a registros inteiros |
| Onde a PII bruta aparece em logs, prompts ou caches? | Detecta os vazamentos acidentais que ninguém projetou de propósito |
| Por quanto tempo tudo o que o agent lembra realmente precisa persistir? | Força uma política de retenção em vez de um padrão indefinido |
| Você consegue encontrar e excluir tudo o que está ligado a uma pessoa, se solicitado? | Testa se os direitos de apagamento são reais ou teóricos |
| Onde cada chamada de ferramenta realmente processa os dados em que toca? | Revela o processamento transfronteiriço que a localização do armazenamento sozinha esconde |
Key Facts
- A superfície de privacidade de um agent é maior do que a de uma única chamada de modelo porque cada chamada de ferramenta é um fluxo de dados próprio, que espalha dados pessoais por vários sistemas em uma única execução.
- A minimização de dados para agents é o mesmo princípio do acesso a ferramentas com privilégio mínimo, aplicado a dados: extraia apenas os campos de que um passo precisa, e não o registro inteiro.
- A memória de longo prazo de um agent é onde o débito de privacidade se acumula em silêncio; ela precisa tanto de uma política de retenção e expiração quanto de uma capacidade real de exclusão por titular para pedidos de apagamento.
- O Cisco 2026 Data and Privacy Benchmark Study constatou que 81% das organizações enfrentam uma demanda crescente por localização de dados e que apenas 12% descrevem sua estrutura de governança de IA como madura, apesar de 75% terem uma em vigor.
- O IBM Cost of a Data Breach Report de 2026 constatou que apenas 37% das organizações criptografam dados sensíveis em repouso e em trânsito, e que APIs, aplicações ou plug-ins comprometidos ficaram empatados como principal causa raiz (27%) das violações direcionadas a modelos ou aplicações de IA.
Perguntas Frequentes sobre a Privacidade de Dados em AI Agents
O que é a privacidade de dados em AI agents?
É a prática de controlar quais dados pessoais um agent lê, envia a um modelo ou ferramenta, armazena e, por fim, apaga ao executar o seu loop. Abrange tratar a PII de forma deliberada, minimizar o que o agent acessa e saber onde os dados realmente são processados, e não apenas onde estão armazenados.
Como a privacidade de dados difere da segurança de dados em um AI agent?
A segurança pergunta se um agent pode ser manipulado para fazer algo prejudicial, como vazar dados para um atacante. A privacidade faz uma pergunta mais estreita, que vale mesmo quando nada está sendo atacado: os dados de quem foram para onde durante uma execução normal e correta, e era mesmo preciso que fossem para lá.
O que é a minimização de dados em um AI agent?
É a prática de extrair apenas os campos específicos de que uma tarefa precisa, e não um registro inteiro só porque uma chamada de API disponibiliza tudo. É a mesma lógica do acesso a ferramentas com privilégio mínimo, aplicada a dados em vez de permissões, e reduz tanto a exposição de privacidade quanto o contexto desnecessário.
A memória de um AI agent pode violar o direito de alguém de ser esquecido?
Sim, se o repositório de memória não tiver como localizar e excluir, sob solicitação, tudo o que está ligado a uma pessoa específica. A memória de longo prazo, tratada em memória de AI agents, persiste fatos entre sessões e, sem uma política de retenção e uma capacidade real de exclusão por titular, pode manter dados muito além do momento em que a pessoa tem o direito de pedir sua remoção.
Armazenar os dados na região certa resolve a residência de dados de um AI agent?
Não por si só. Um agent pode puxar dados armazenados em uma região em conformidade para um modelo ou ferramenta que os processa em outro lugar durante uma execução. A residência de dados para um agent significa verificar onde cada ferramenta e modelo realmente processa o que toca, e não apenas onde os registros subjacentes ficam.
Para Onde Ir Agora
A privacidade de dados de um agent está intimamente ligada a duas outras disciplinas tratadas em outras partes desta biblioteca. A segurança de AI agents cobre o lado do modelo de ameaças, evitando que o agent seja manipulado para vazar dados de propósito. A conformidade de AI agents cobre em profundidade o mapeamento regulatório, a trilha de auditoria e o lado do EU AI Act. Leia a privacidade junto com as duas, e não isoladamente, já que um agent genuinamente bem governado precisa das três funcionando em conjunto.

On this page
- Por que a Superfície de Privacidade de um Agent É Maior que a de um Modelo
- Tratamento de PII: Conheça-a Antes de Movê-la
- Minimização: a Mesma Disciplina do Privilégio Mínimo, Aplicada aos Dados
- A Memória É Onde o Débito de Privacidade se Acumula em Silêncio
- Residência de Dados, em Resumo: Armazenamento Não É Toda a Questão
- O que a Higiene Fraca de Dados Realmente Custa
- Um Checklist Prático para Começar
- Key Facts
- Para Onde Ir Agora