Bahasa Indonesia
Privasi Data AI Agent: Penanganan PII, Residensi, dan Minimisasi
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Privasi data AI agent adalah disiplin mengendalikan data pribadi apa yang dibaca, dikirim, disimpan, dan dihapus agent selama menjalankan loop-nya sendiri: field mana yang ditarik dari sistem of record, apa yang diteruskan ke model atau tool pihak ketiga, apa yang disimpan di memori sesudahnya, dan berapa lama semua itu bertahan. Cakupannya lebih luas daripada privasi untuk satu panggilan model, karena panggilan tool agent menyebarkan data ke beberapa sistem pada setiap proses, bukan hanya ke satu penyedia model. Tiga praktik memikul sebagian besar bobotnya: menangani PII secara sengaja, bukan kebetulan, meminimalkan apa yang disentuh agent sejak awal, dan mengetahui di mana data sebenarnya diproses, bukan hanya di mana data disimpan.
Mengapa Cakupan Privasi Agent Lebih Luas daripada Model
Satu prompt ke model hanya memiliki satu pertanyaan privasi: apa yang Anda masukkan ke dalamnya. Agent memiliki banyak. Cara kerja AI agent menggambarkan loop yang dijalankan agent: mengamati, bernalar, bertindak, memeriksa hasil, ulangi, dan langkah mengamati saja dapat menarik data dari CRM, sistem support, dan penyimpanan dokumen sebelum agent membuat satu keputusan pun. Cara AI agent menggunakan tool membahas mekanismenya: setiap panggilan tool adalah aliran data, mengirim parameter keluar dan menerima hasil kembali, dan masing-masing adalah tempat data pribadi dapat berpindah ke sistem yang sama sekali bukan bagian dari percakapan awal.
Privasi data berada di bawah payung yang lebih luas yaitu tata kelola AI, kebijakan dan pengawasan yang menjaga setiap sistem AI tetap selaras dengan ekspektasi regulasi dan organisasi. Yang membuatnya layak mendapat praktik tersendiri untuk agent adalah penyebaran itu: keamanan AI agent bertanya apakah agent dapat diakali untuk melakukan sesuatu yang merugikan, sedangkan privasi data bertanya hal yang lebih sempit dan lebih sunyi yang tidak mensyaratkan ada yang menyerang apa pun. Bahkan ketika semuanya berjalan persis seperti dirancang, data siapa yang pergi ke mana, dan apakah memang perlu?
Penanganan PII: Kenali Sebelum Memindahkannya
Data pribadi mencakup lebih dari field yang jelas. Nama dan email adalah PII, tetapi begitu pula alamat IP, ID perangkat, deskripsi teks bebas dari tiket support tentang kondisi medis, dan komentar penilaian kinerja yang terkait dengan karyawan. Agent yang membaca sistem mana pun dengan record pelanggan atau karyawan yang nyata sedang menangani PII, baik ada yang melabelinya demikian maupun tidak. AI Benefits Enrollment Agent adalah contoh yang jelas: membantu karyawan memilih paket kesehatan berarti menyentuh data terkait kesehatan dan informasi tanggungan yang memiliki standar lebih tinggi daripada tiket support rata-rata, baik desain agent memperlakukannya demikian secara default maupun tidak.
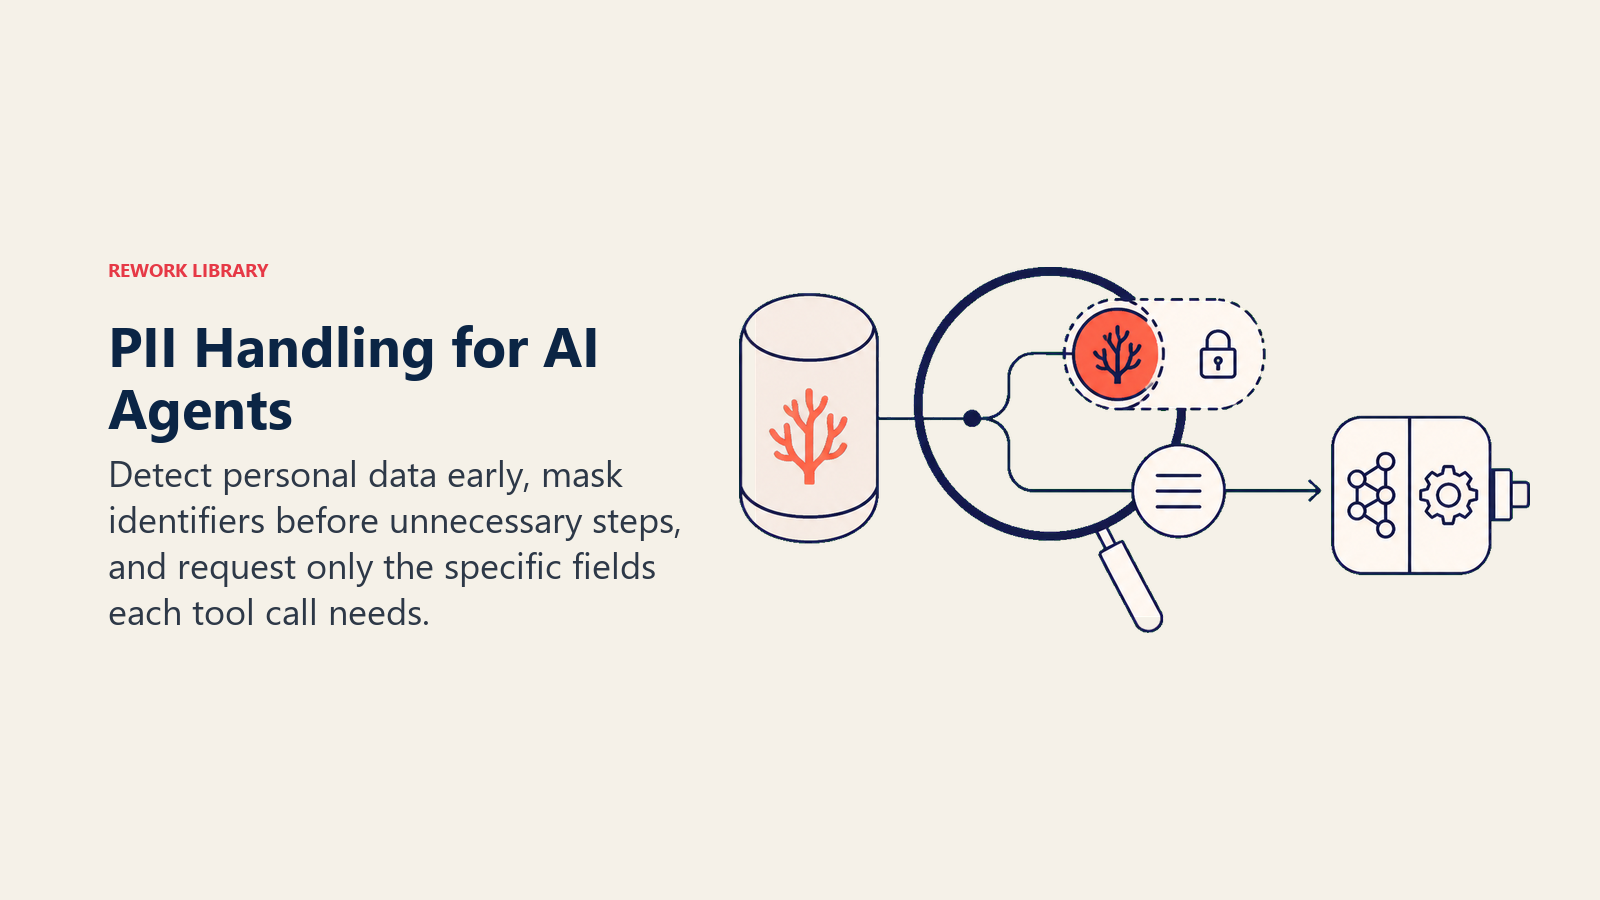
Beberapa kebiasaan membedakan menangani data itu secara sengaja dari membocorkannya secara tidak sengaja:
- Jangan pernah membiarkan PII mentah berada di log debug atau prompt yang di-cache atau disimpan di hulu. Logging sering dianggap ruang internal yang aman. Biasanya tidak, terutama begitu log dikirim ke tool observabilitas pihak ketiga atau ke retensi logging penyedia model eksternal.
- Redaksi atau samarkan sebelum data mencapai langkah yang tidak memerlukan versi yang dapat diidentifikasi. Langkah yang mengklasifikasikan topik tiket support tidak membutuhkan nama lengkap dan nomor akun pelanggan di konteks untuk melakukannya; ID tiket sering sudah cukup.
- Batasi panggilan tool ke field tertentu, bukan seluruh record. Versi privasi dari desain tool least-privilege adalah meminta
customer.plan_tier, bukanget_full_customer_record, ketika plan tier adalah satu-satunya yang dibutuhkan sebuah langkah. - Perlakukan setiap integrasi tool baru sebagai aliran data baru yang perlu ditinjau, bukan hanya kapabilitas baru untuk dirayakan. Tool yang secara teknis mampu mengembalikan seluruh riwayat pembelian pelanggan adalah keputusan privasi setiap kali dipanggil, bukan hanya keputusan engineering.
Minimisasi: Disiplin yang Sama dengan Least Privilege, Diterapkan pada Data
Keamanan AI agent membangun argumen untuk least privilege pada akses tool: beri agent hanya izin yang benar-benar dibutuhkan pekerjaannya, tidak lebih. Minimisasi data adalah prinsip yang identik yang diterapkan pada data, bukan izin: tarik hanya field yang benar-benar dibutuhkan sebuah langkah, bukan seluruh record hanya karena kebetulan tersedia dalam satu panggilan API.
Ini bukan sekadar basa-basi kepatuhan. Ini juga masalah manajemen konteks: setiap field yang ditarik agent ke context window-nya yang sebenarnya tidak dibutuhkan adalah risiko privasi sekaligus beban mati yang harus diproses model di setiap langkah. Manajemen konteks AI agent membahas sisi penganggaran dari naluri yang sama, hanya menyimpan apa yang dibutuhkan sebuah langkah di konteks, diterapkan pada token secara umum, bukan pada data pribadi secara khusus. Kedua disiplin itu mengarah ke arah yang sama karena alasan mendasar yang sama: menarik segalanya untuk berjaga-jaga lebih buruk daripada menarik persis yang dibutuhkan, baik Anda khawatir soal biaya token maupun pertanyaan berikutnya dari petugas perlindungan data.
Memori Adalah Tempat Utang Privasi Menumpuk Diam-Diam
AI Agent Memory membahas bagaimana memori jangka panjang agent menyimpan fakta dan riwayat lintas sesi, biasanya dalam database atau vector store yang dapat di-query agent kemudian. Di situlah utang privasi cenderung menumpuk tanpa disadari. Memori yang menyimpan setiap detail yang pernah dipelajari agent tentang seorang pelanggan, tanpa batas waktu, tanpa kedaluwarsa dan tanpa jalur penghapusan, adalah kewajiban yang terus membesar meski tidak ada yang tampak ganjil pada hari tertentu.
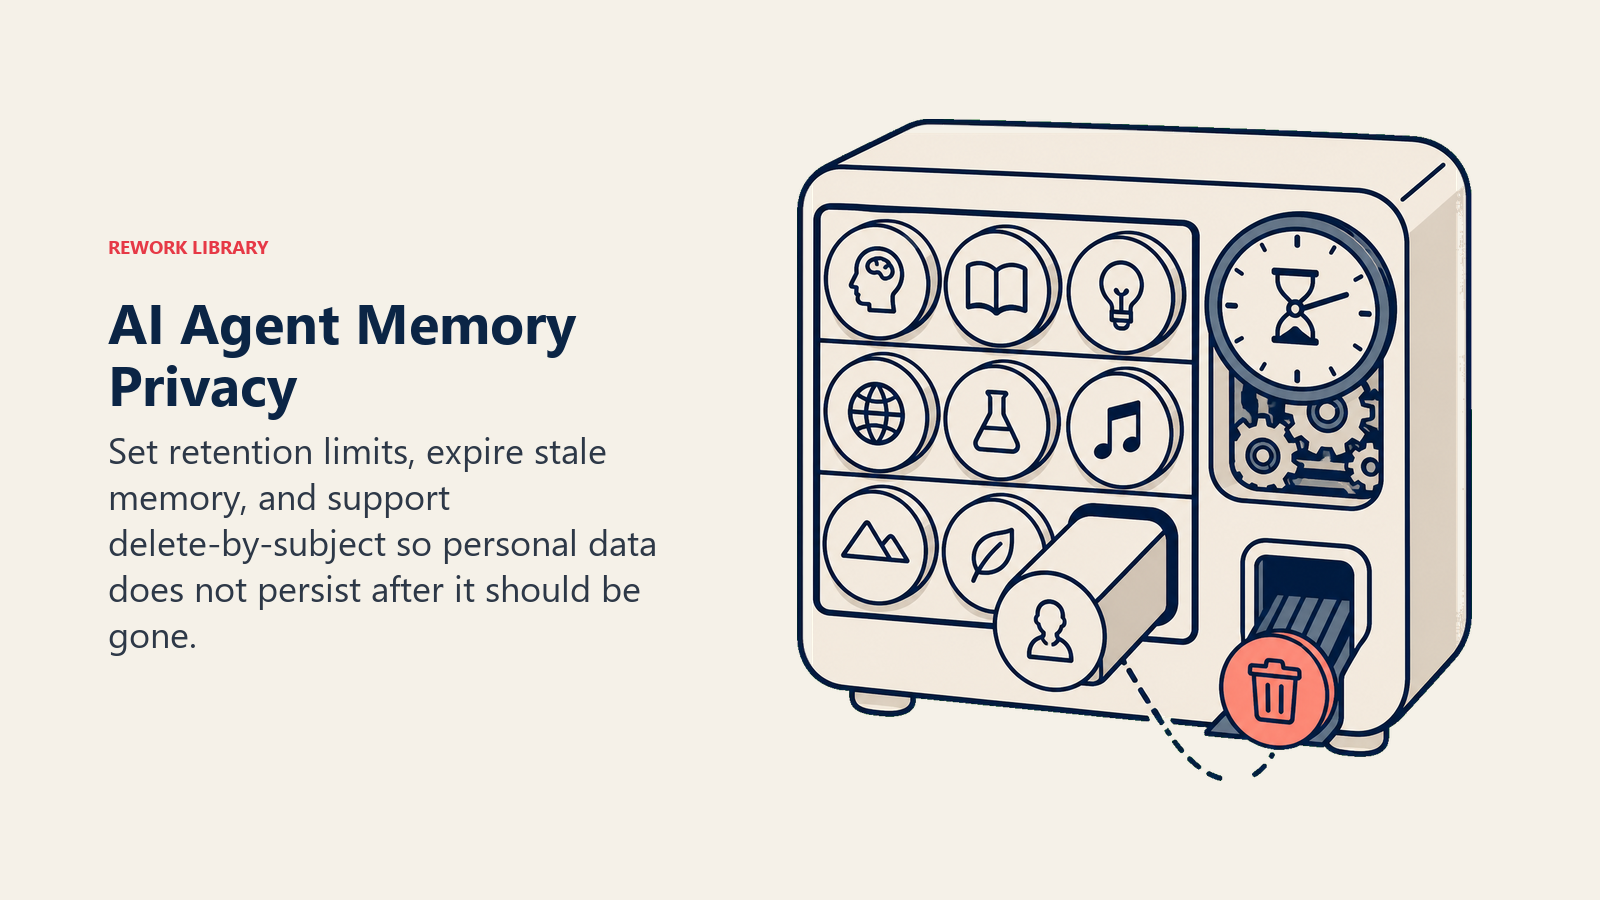
Dua kapabilitas penting di sini khususnya karena regulasi privasi, bukan sekadar kebersihan yang baik. Pertama, kebijakan retensi dan kedaluwarsa: tentukan apa yang boleh disimpan memori dan untuk berapa lama, alih-alih secara default selamanya. Kedua, dan sering terlewat, kapabilitas hapus-per-subjek: di bawah hak penghapusan ala GDPR, seseorang dapat meminta datanya dihapus, dan memori agent memerlukan cara nyata untuk menemukan dan menghapus semua yang terkait dengan orang itu, bukan hanya record di database utama Anda sementara salinan bayangan masih tersisa di indeks vektor yang tidak diingat siapa pun untuk diperiksa.
Residensi Data, Secara Singkat: Penyimpanan Bukan Seluruh Pertanyaannya
Di mana sebuah record disimpan dulu merupakan sebagian besar pertanyaan residensi data. Agent menambahkan lokasi kedua yang sama pentingnya: di mana data diproses ketika panggilan tool atau langkah retrieval menariknya ke dalam penalaran model. Data pribadi teregulasi yang dibaca ke model yang berjalan di wilayah berbeda dari tempat penyimpanannya adalah aliran data dengan profil kepatuhan tersendiri, bukan detail implementasi.
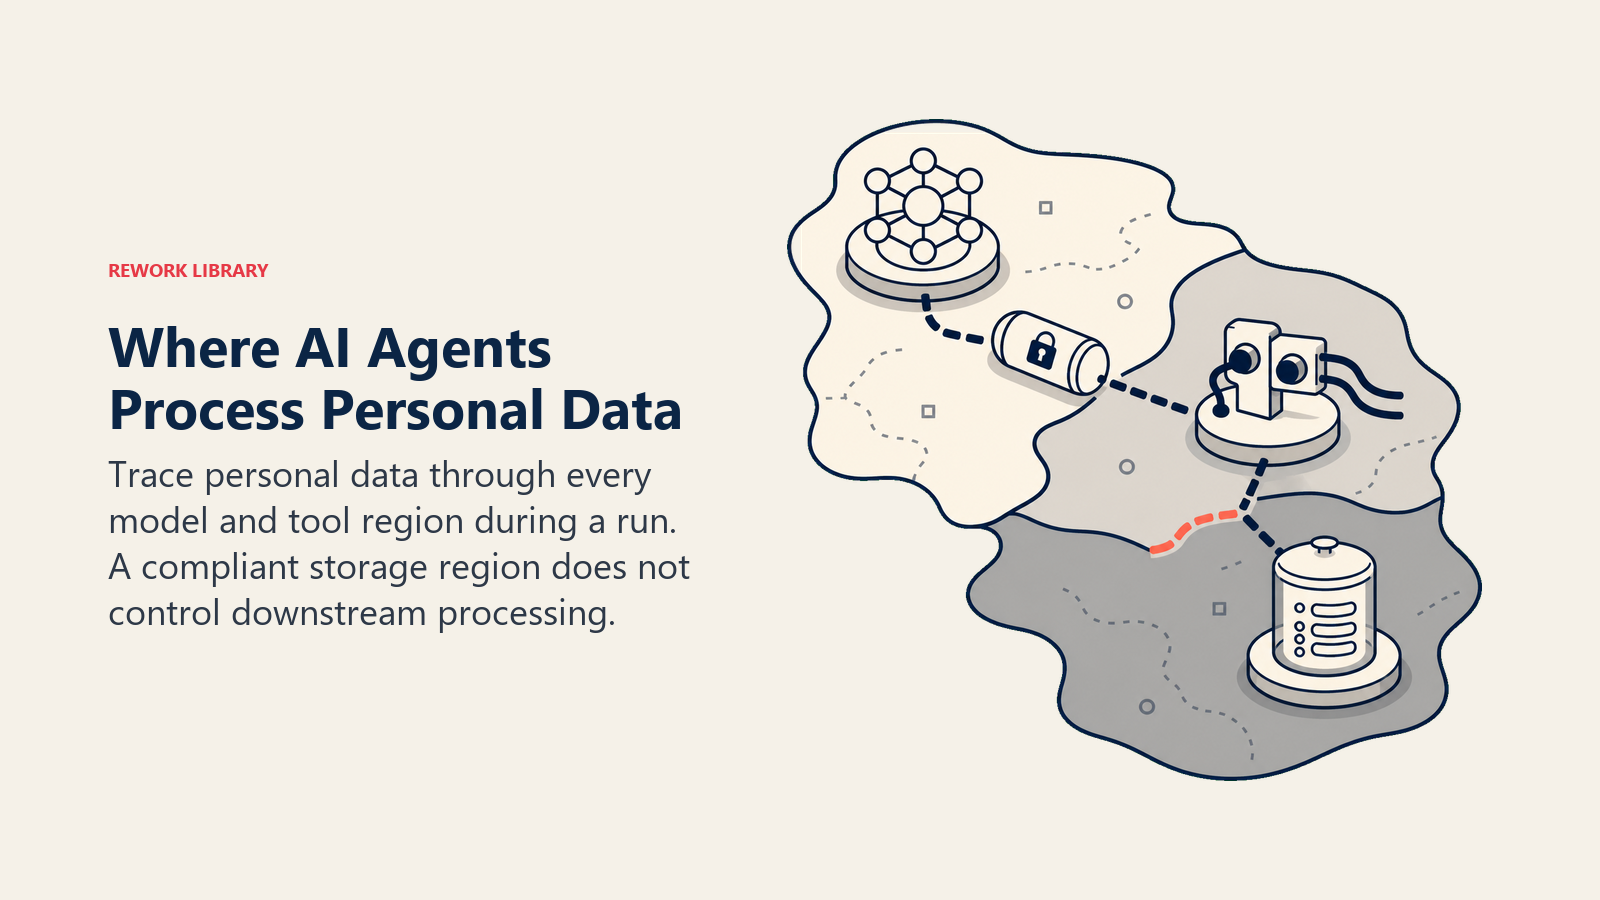
Kepatuhan AI Agent membahas bidang ini secara mendalam, termasuk pemetaannya terhadap EU AI Act dan apa yang perlu ditangkap audit trail, dan merupakan tempat yang tepat untuk pemetaan regulasi. Kesimpulan khusus privasi di sini lebih sederhana: ketahui, tool demi tool, di mana masing-masing benar-benar memproses data yang disentuhnya, bukan hanya di mana sistem yang mendasarinya menyimpan, dan perlakukan setiap agent yang bernalar atas data pribadi teregulasi sebagai hubungan vendor yang layak mendapat pengawasan yang sama seperti subprocessor baru, karena memang itulah dia.
Ini bukan kekhawatiran hipotetis yang dapat diturunkan prioritasnya oleh tim. Studi Data and Privacy Benchmark 2026 dari Cisco, yang mensurvei lebih dari 5.200 profesional privasi dan keamanan, menemukan bahwa 81% organisasi menghadapi permintaan lokalisasi data yang meningkat, dan 85% menyatakan hal itu menambah biaya, kompleksitas, dan risiko nyata pada penyampaian layanan lintas negara. Studi yang sama menemukan bahwa meskipun 75% organisasi kini memiliki badan tata kelola AI khusus, hanya 12% yang menyebutnya benar-benar matang. Kebanyakan perusahaan sudah mulai membangun strukturnya. Sangat sedikit yang menyelesaikannya.
Berapa Sebenarnya Biaya Higiene Data yang Lemah
Biaya kesalahan di sini tidak abstrak. Laporan Cost of a Data Breach 2026 dari IBM menemukan bahwa hanya 37% organisasi yang mengenkripsi data sensitif saat disimpan dan saat ditransmisikan, artinya sebagian besar organisasi yang mengalami pelanggaran tidak memiliki kontrol dasar jauh sebelum agent atau model terlibat. Laporan yang sama menemukan bahwa lebih dari 20% organisasi melaporkan pelanggaran yang menyasar model atau aplikasi AI secara langsung, dengan API, aplikasi, atau plug-in yang disusupi menjadi akar masalah utama bersama pada angka 27%, tepat permukaan yang diciptakan panggilan tool agent. Secara terpisah, OWASP Top 10 for LLM Applications menempatkan Sensitive Information Disclosure di LLM02, naik dari posisi keenam pada edisi sebelumnya, tanda betapa cepat risiko ini naik di daftar seiring makin banyak sistem yang dapat benar-benar mengambil dan bertindak atas data pribadi, bukan sekadar membahasnya secara abstrak.
Jika Anda membawa platform AI atau vendor agent baru yang akan menyentuh data pribadi, perbandingan tool AI kami menimbang penanganan data sebagai bagian dari evaluasi, dan scorecard evaluasi vendor SaaS memberi Anda template berbobot untuk menilai postur privasi dan keamanan tool baru sebelum menghubungkannya ke apa pun yang menyentuh data pelanggan atau karyawan yang nyata.
Checklist Awal yang Praktis
Lima pertanyaan yang layak dijawab sebelum agent mendapat akses ke sistem mana pun yang menyimpan data pribadi:
| Pertanyaan | Apa yang terdeteksi |
|---|---|
| PII apa yang sebenarnya perlu dilihat agent ini untuk menjalankan tugasnya? | Membatasi akses tool ke field, bukan seluruh record |
| Di mana PII mentah muncul di log, prompt, atau cache? | Menangkap kebocoran tidak sengaja yang tidak dirancang siapa pun |
| Berapa lama apa pun yang diingat agent sebenarnya perlu bertahan? | Memaksa adanya kebijakan retensi, bukan default tanpa batas |
| Dapatkah Anda menemukan dan menghapus semua yang terkait satu orang bila diminta? | Menguji apakah hak penghapusan nyata atau hanya teoretis |
| Di mana setiap panggilan tool benar-benar memproses data yang disentuhnya? | Mengungkap pemrosesan lintas negara yang tersembunyi di balik lokasi penyimpanan |
Key Facts
- Cakupan privasi agent lebih luas daripada satu panggilan model karena setiap panggilan tool adalah aliran data tersendiri, menyebarkan data pribadi ke banyak sistem dalam satu proses.
- Minimisasi data untuk agent adalah prinsip yang sama dengan akses tool least-privilege, diterapkan pada data: tarik hanya field yang dibutuhkan sebuah langkah, bukan seluruh record.
- Memori jangka panjang agent adalah tempat utang privasi menumpuk diam-diam; memori memerlukan kebijakan retensi dan kedaluwarsa serta kapabilitas hapus-per-subjek yang nyata untuk permintaan penghapusan.
- Studi Data and Privacy Benchmark 2026 dari Cisco menemukan 81% organisasi menghadapi permintaan lokalisasi data yang meningkat, dan hanya 12% yang menyebut struktur tata kelola AI mereka matang meski 75% sudah memilikinya.
- Laporan Cost of a Data Breach 2026 dari IBM menemukan hanya 37% organisasi yang mengenkripsi data sensitif saat disimpan dan saat ditransmisikan, dan API, aplikasi, atau plug-in yang disusupi menjadi akar masalah teratas bersama (27%) pada pelanggaran yang menyasar model atau aplikasi AI.
Pertanyaan yang Sering Diajukan tentang Privasi Data AI Agent
Apa itu privasi data AI agent?
Praktik mengendalikan data pribadi apa yang dibaca agent, dikirim ke model atau tool, disimpan, dan akhirnya dihapus selama menjalankan loop-nya. Cakupannya meliputi penanganan PII secara sengaja, meminimalkan apa yang diakses agent, dan mengetahui di mana data sebenarnya diproses, bukan hanya di mana data disimpan.
Apa bedanya privasi data dengan keamanan data untuk AI agent?
Keamanan bertanya apakah agent dapat dimanipulasi untuk melakukan sesuatu yang merugikan, seperti membocorkan data ke penyerang. Privasi bertanya hal yang lebih sempit yang berlaku bahkan ketika tidak ada yang menyerang: data siapa yang pergi ke mana selama proses normal yang berfungsi dengan benar, dan apakah data itu memang perlu pergi ke sana.
Apa itu minimisasi data untuk AI agent?
Praktik menarik hanya field spesifik yang dibutuhkan tugas, bukan seluruh record hanya karena panggilan API menyediakan semuanya. Logikanya sama dengan akses tool least-privilege, diterapkan pada data, bukan izin, dan mengurangi paparan privasi sekaligus konteks yang tidak perlu.
Dapatkah memori AI agent melanggar hak seseorang untuk dilupakan?
Ya, jika memori tidak memiliki cara untuk menemukan dan menghapus semua yang terkait orang tertentu atas permintaan. Memori jangka panjang, yang dibahas di AI Agent Memory, menyimpan fakta lintas sesi, dan tanpa kebijakan retensi serta kapabilitas hapus-per-subjek yang nyata, memori dapat menyimpan data jauh melewati saat seseorang berhak meminta penghapusannya.
Apakah menyimpan data di wilayah yang tepat menyelesaikan residensi data AI agent?
Tidak dengan sendirinya. Agent dapat menarik data yang disimpan di wilayah yang patuh ke model atau tool yang memprosesnya di tempat lain sama sekali selama proses berjalan. Residensi data untuk agent berarti memeriksa di mana setiap tool dan model benar-benar memproses apa yang disentuhnya, bukan hanya di mana record yang mendasarinya berada.
Langkah Selanjutnya
Privasi data untuk agent terkait erat dengan dua disiplin lain yang dibahas di tempat lain di library ini. Keamanan AI agent membahas sisi model ancaman, mencegah agent dimanipulasi untuk membocorkan data dengan sengaja. Kepatuhan AI Agent membahas pemetaan regulasi, audit trail, dan sisi EU AI Act secara mendalam. Baca privasi bersama keduanya, bukan secara terpisah, karena agent yang benar-benar terkelola dengan baik membutuhkan ketiganya bekerja bersama.

On this page
- Mengapa Cakupan Privasi Agent Lebih Luas daripada Model
- Penanganan PII: Kenali Sebelum Memindahkannya
- Minimisasi: Disiplin yang Sama dengan Least Privilege, Diterapkan pada Data
- Memori Adalah Tempat Utang Privasi Menumpuk Diam-Diam
- Residensi Data, Secara Singkat: Penyimpanan Bukan Seluruh Pertanyaannya
- Berapa Sebenarnya Biaya Higiene Data yang Lemah
- Checklist Awal yang Praktis
- Key Facts
- Langkah Selanjutnya