AI Agent Data Privacy: Umgang mit PII, Datenresidenz und Datenminimierung
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
AI Agent Data Privacy ist die Disziplin, zu kontrollieren, welche personenbezogenen Daten ein Agent liest, sendet, speichert und löscht, während er seine eigene Schleife durchläuft: welche Felder er aus einem führenden System zieht, was er an ein Modell oder ein Drittanbieter-Tool weitergibt, was er danach im Memory behält und wie lange all das bestehen bleibt. Das ist eine größere Angriffsfläche als der Datenschutz bei einem einzelnen Modellaufruf, denn die Tool-Aufrufe eines Agents streuen Daten bei jedem Lauf über mehrere Systeme, nicht nur zu einem einzigen Modellanbieter. Drei Praktiken tragen das meiste Gewicht: PII bewusst statt zufällig zu behandeln, von vornherein zu minimieren, was der Agent berührt, und zu wissen, wo Daten tatsächlich verarbeitet werden, nicht nur, wo sie gespeichert sind.
Warum die Datenschutzfläche eines Agents größer ist als die eines Modells
Ein einzelner Prompt an ein Modell wirft eine Datenschutzfrage auf: Was haben Sie hineingegeben? Ein Agent wirft viele auf. Wie AI Agents funktionieren beschreibt die Schleife eines Agents: wahrnehmen, schlussfolgern, handeln, beobachten, wiederholen, und allein der Wahrnehmungsschritt kann Daten aus einem CRM, einem Support-System und einem Dokumentenspeicher ziehen, bevor der Agent eine einzige Entscheidung getroffen hat. Wie AI Agents Tools nutzen behandelt den Mechanismus: Jeder Tool-Aufruf ist ein Datenfluss, der Parameter hinaussendet und ein Ergebnis zurückbekommt, und jeder ist eine Stelle, an der personenbezogene Daten zu einem System wandern können, das mit der ursprünglichen Konversation gar nichts zu tun hatte.
Datenschutz liegt unter dem breiteren Dach der AI Governance, also der Richtlinien und der Aufsicht, die jedes AI-System im Einklang mit regulatorischen und organisatorischen Erwartungen halten. Was ihn für Agents zu einer eigenen Praxis macht, ist genau diese Streuung: AI Agent Security fragt, ob der Agent dazu gebracht werden kann, etwas Schädliches zu tun, während Datenschutz eine engere, leisere Frage stellt, für die niemand etwas angreifen muss. Selbst wenn alles exakt wie entworfen funktioniert: Wessen Daten gingen wohin, und war das nötig?
Umgang mit PII: Kennen Sie sie, bevor Sie sie bewegen
Personenbezogene Daten umfassen mehr als die offensichtlichen Felder. Name und E-Mail sind PII, aber auch eine IP-Adresse, eine Geräte-ID, die Freitextbeschreibung einer medizinischen Situation in einem Support-Ticket und ein Kommentar aus einer Leistungsbeurteilung, der einem Mitarbeitenden zugeordnet ist. Ein Agent, der ein beliebiges System mit echten Kunden- oder Mitarbeiterdatensätzen liest, verarbeitet PII, ob das jemand so bezeichnet hat oder nicht. Der AI Benefits Enrollment Agent ist ein klares Beispiel: Einem Mitarbeitenden bei der Wahl eines Krankenversicherungsplans zu helfen, bedeutet, gesundheitsnahe Daten und Angaben zu Angehörigen zu berühren, für die eine höhere Hürde gilt als für ein durchschnittliches Support-Ticket, ob das Design des Agents sie standardmäßig so behandelt oder nicht.
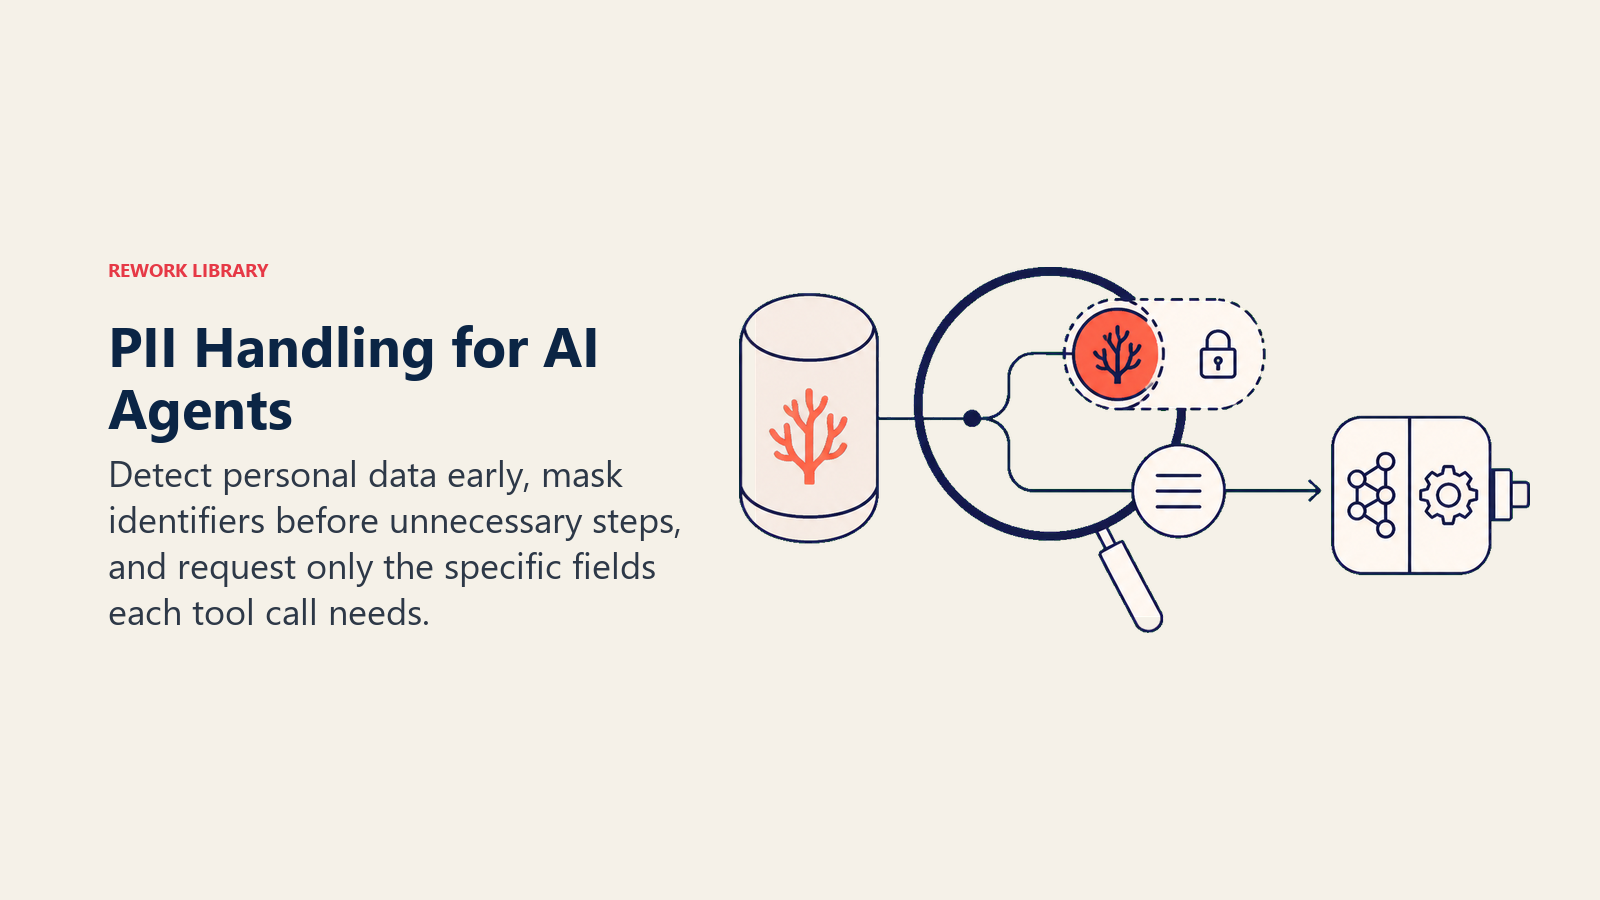
Einige Gewohnheiten machen den Unterschied zwischen bewusstem Umgang mit diesen Daten und versehentlichem Preisgeben:
- Lassen Sie rohe PII nie in einem Debug-Log oder einem Prompt liegen, der im Upstream gecacht oder aufbewahrt wird. Logging gilt oft als sicherer, interner Raum. Das ist es meist nicht, besonders wenn ein Log an ein Observability-Tool eines Drittanbieters oder in die Log-Aufbewahrung eines externen Modellanbieters geschickt wird.
- Schwärzen oder maskieren Sie, bevor Daten einen Schritt erreichen, der die identifizierbare Version nicht braucht. Ein Schritt, der das Thema eines Support-Tickets klassifiziert, braucht dafür weder den vollen Namen noch die Kontonummer des Kunden im Kontext; eine Ticket-ID reicht oft.
- Begrenzen Sie Tool-Aufrufe auf bestimmte Felder, nicht auf ganze Datensätze. Die Datenschutzvariante des Least-Privilege-Tool-Designs ist,
customer.plan_tieranzufordern stattget_full_customer_record, wenn die Tarifstufe alles ist, was ein Schritt tatsächlich braucht. - Behandeln Sie jede neue Tool-Integration als neuen Datenfluss, den es zu prüfen gilt, nicht nur als neue Fähigkeit, die man feiert. Ein Tool, das technisch die gesamte Kaufhistorie eines Kunden zurückgeben kann, ist bei jedem Aufruf eine Datenschutzentscheidung und nicht nur eine technische.
Minimierung: dieselbe Disziplin wie Least Privilege, auf Daten angewandt
AI Agent Security plädiert für Least Privilege beim Tool-Zugriff: Geben Sie einem Agent nur die Berechtigungen, die seine tatsächliche Aufgabe erfordert, nicht mehr. Datenminimierung ist dasselbe Prinzip, angewandt auf Daten statt auf Berechtigungen: Ziehen Sie nur die Felder, die ein Schritt wirklich braucht, nicht den ganzen Datensatz, nur weil er in einem API-Aufruf verfügbar war.
Das ist nicht nur eine Compliance-Nettigkeit. Es ist auch ein Problem des Context Managements: Jedes Feld, das ein Agent in sein Kontextfenster zieht und nicht wirklich braucht, ist zugleich ein Datenschutzrisiko und Ballast, den das Modell bei jedem Schritt verarbeiten muss. AI Agent Context Management behandelt die Budgetseite desselben Instinkts, nur das im Kontext zu halten, was ein Schritt braucht, angewandt auf Tokens im Allgemeinen statt speziell auf personenbezogene Daten. Beide Disziplinen zeigen aus demselben Grund in dieselbe Richtung: Alles vorsorglich zu ziehen ist schlechter, als genau das zu ziehen, was gebraucht wird, ob Sie sich nun um Token-Kosten sorgen oder um die nächste Frage eines Datenschutzbeauftragten.
Im Memory sammeln sich unbemerkt Datenschutz-Altlasten an
AI Agent Memory behandelt, wie das Langzeitgedächtnis eines Agents Fakten und Verlauf über Sessions hinweg speichert, meist in einer Datenbank oder einem Vektorspeicher, den der Agent später abfragen kann. Genau dort bauen sich Datenschutz-Altlasten unbemerkt auf. Ein Memory-Speicher, der jedes Detail, das ein Agent je über einen Kunden gelernt hat, unbegrenzt aufbewahrt, ohne Ablauf und ohne Löschweg, ist eine wachsende Verbindlichkeit, selbst wenn an einem beliebigen Tag nichts daran ungewöhnlich aussieht.
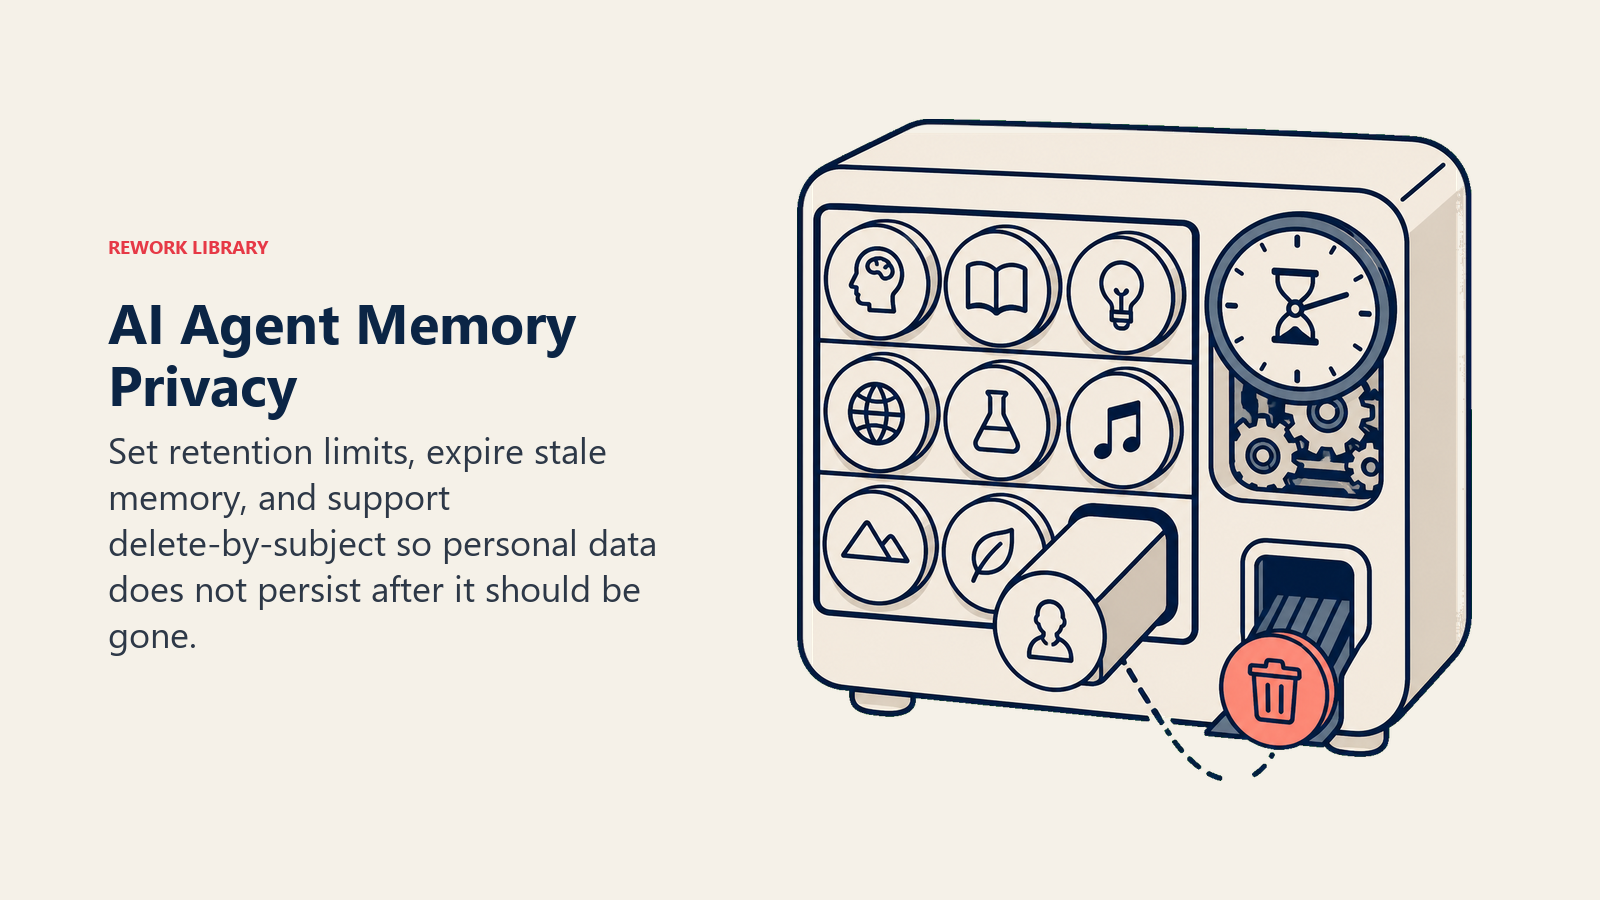
Zwei Fähigkeiten sind hier gerade wegen der Datenschutzregulierung wichtig, nicht nur wegen guter Hygiene. Erstens eine Richtlinie zu Aufbewahrung und Ablauf: Legen Sie fest, was ein Memory-Speicher aufbewahren darf und wie lange, statt standardmäßig „für immer“ zu wählen. Zweitens, und oft übersehen, die Fähigkeit zum Löschen nach Person: Nach DSGVO-artigen Löschrechten kann eine Person verlangen, dass ihre Daten gelöscht werden, und der Memory-Speicher eines Agents braucht einen echten Weg, alles zu finden und zu entfernen, was dieser Person zugeordnet ist, nicht nur den Datensatz in Ihrer primären Datenbank, während in einem Vektorindex, den niemand zu prüfen daran denkt, eine Schattenkopie liegen bleibt.
Datenresidenz kurz gefasst: Speicherung ist nicht die ganze Frage
Wo ein Datensatz gespeichert ist, war früher der größte Teil der Datenresidenz-Frage. Ein Agent fügt einen zweiten Ort hinzu, der genauso wichtig ist: wo die Daten verarbeitet werden, wenn ein Tool-Aufruf oder ein Retrieval-Schritt sie in das Schlussfolgern eines Modells zieht. Regulierte personenbezogene Daten, die in ein Modell gelesen werden, das in einer anderen Region läuft als der, in der sie gespeichert sind, sind ein Datenfluss mit eigenem Compliance-Profil, kein Implementierungsdetail.
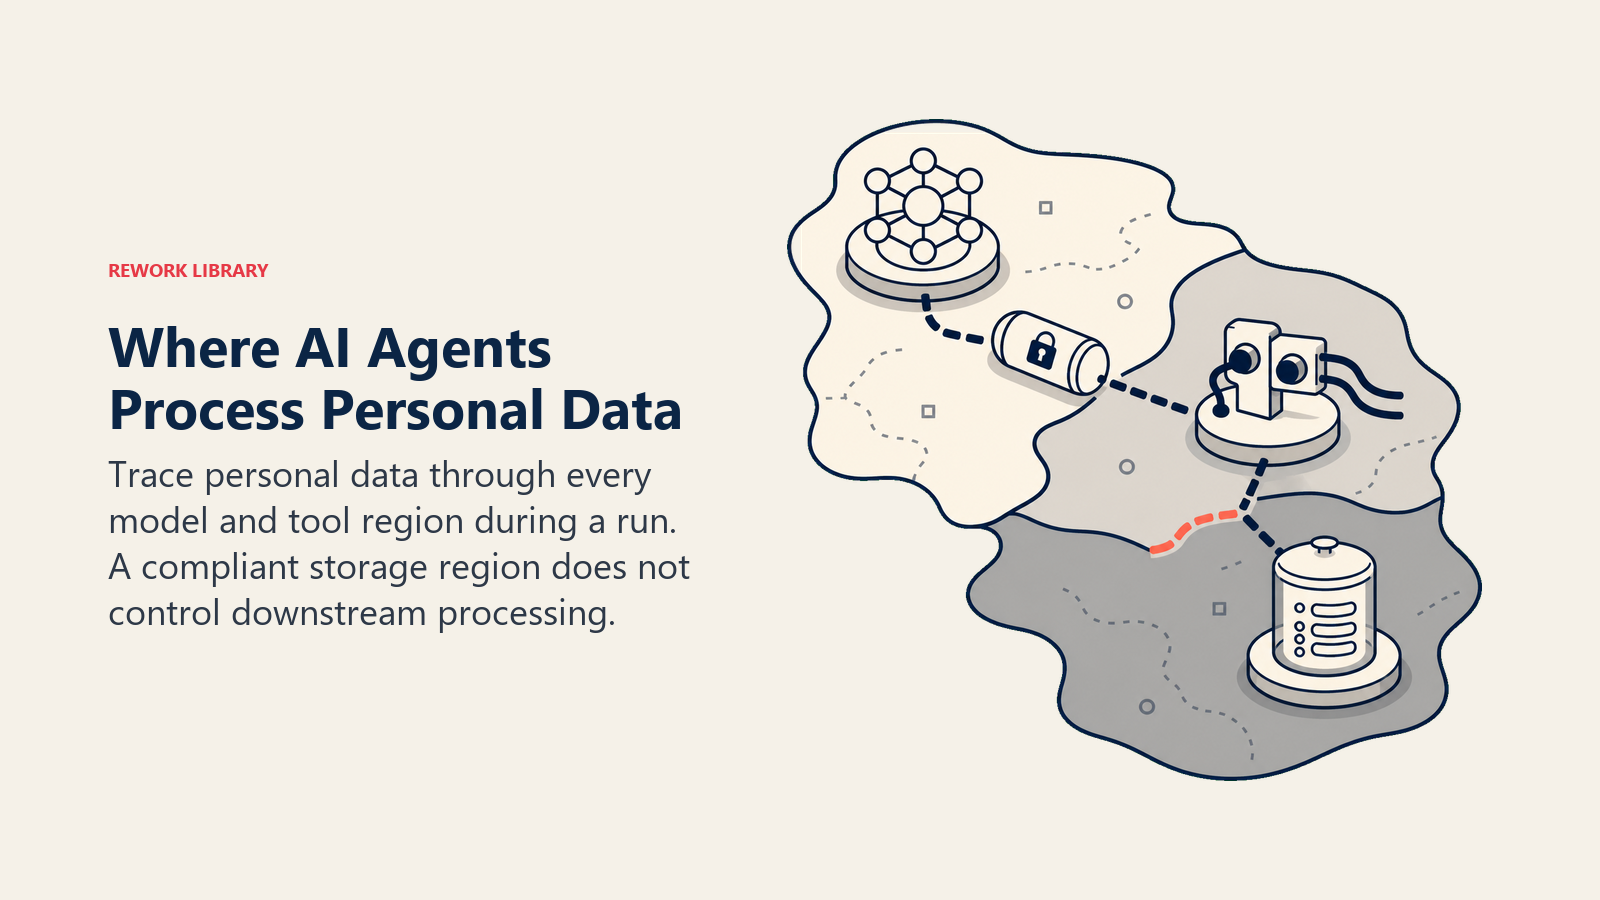
AI Agent Compliance behandelt dieses Feld wirklich ausführlich, einschließlich des Abgleichs mit dem EU AI Act und dessen, was ein Audit Trail erfassen muss, und ist die richtige Adresse für die regulatorische Zuordnung. Die datenschutzspezifische Erkenntnis hier ist einfacher: Wissen Sie, Tool für Tool, wo jedes die Daten, die es berührt, tatsächlich verarbeitet, nicht nur, wo das zugrunde liegende System sie speichert, und behandeln Sie jeden Agent, der über regulierte personenbezogene Daten schlussfolgert, als Anbieterbeziehung, die dieselbe Sorgfalt verdient wie ein neuer Auftragsverarbeiter, denn genau das ist er.
Das ist keine hypothetische Sorge, die Teams niedrig priorisieren könnten. Die Data and Privacy Benchmark Study 2026 von Cisco, für die mehr als 5.200 Datenschutz- und Sicherheitsfachleute befragt wurden, ergab, dass 81 % der Organisationen eine gestiegene Nachfrage nach Datenlokalisierung erleben und 85 % sagen, dass sie grenzüberschreitende Dienstleistungen spürbar teurer, komplexer und riskanter macht. Dieselbe Studie ergab, dass zwar 75 % der Organisationen inzwischen ein eigenes AI-Governance-Gremium haben, aber nur 12 % es als tatsächlich ausgereift beschreiben. Die meisten Unternehmen haben begonnen, die Struktur aufzubauen. Sehr wenige haben sie fertiggestellt.
Was schwache Datenhygiene tatsächlich kostet
Die Kosten, wenn man es falsch macht, sind nicht abstrakt. Der Cost of a Data Breach Report 2026 von IBM ergab, dass nur 37 % der Organisationen sensible Daten im Ruhezustand und bei der Übertragung verschlüsseln. Die meisten betroffenen Organisationen ließen also schon eine Basiskontrolle vermissen, lange bevor ein Agent oder ein Modell überhaupt beteiligt war. Derselbe Bericht fand, dass mehr als 20 % der Organisationen einen Vorfall meldeten, der direkt auf AI-Modelle oder -Anwendungen zielte, wobei kompromittierte APIs, Anwendungen oder Plug-ins mit 27 % gemeinsam die häufigste Ursache waren, genau die Fläche, die die Tool-Aufrufe eines Agents erzeugen. Unabhängig davon führen die OWASP Top 10 für LLM-Anwendungen Sensitive Information Disclosure auf Platz LLM02, nach Platz sechs in der Vorgängerausgabe, ein Zeichen dafür, wie schnell dieses Risiko in der Liste aufgestiegen ist, seit mehr Systeme personenbezogene Daten tatsächlich abrufen und darauf handeln können, statt nur abstrakt darüber zu sprechen.
Wenn Sie eine neue AI-Plattform oder einen Agent-Anbieter einführen, der personenbezogene Daten berührt, gewichten unsere Vergleiche von AI-Tools den Umgang mit Daten als Teil der Bewertung, und die Bewertungsmatrix für SaaS-Anbieter liefert Ihnen eine gewichtete Vorlage, um die Datenschutz- und Sicherheitslage eines neuen Tools zu bewerten, bevor Sie es mit irgendetwas verbinden, das echte Kunden- oder Mitarbeiterdaten berührt.
Eine praktische Start-Checkliste
Fünf Fragen, die Sie beantworten sollten, bevor ein Agent Zugriff auf ein System mit personenbezogenen Daten erhält:
| Frage | Was sie aufdeckt |
|---|---|
| Welche PII muss dieser Agent tatsächlich sehen, um seine Aufgabe zu erfüllen? | Begrenzt den Tool-Zugriff auf Felder statt auf ganze Datensätze |
| Wo taucht rohe PII in Logs, Prompts oder Caches auf? | Deckt die versehentlichen Lecks auf, die niemand absichtlich entworfen hat |
| Wie lange muss alles, woran sich der Agent erinnert, tatsächlich bestehen bleiben? | Erzwingt eine Aufbewahrungsrichtlinie statt eines unbegrenzten Standards |
| Können Sie auf Verlangen alles finden und löschen, was einer Person zugeordnet ist? | Prüft, ob Löschrechte real oder nur theoretisch sind |
| Wo verarbeitet jeder Tool-Aufruf die Daten, die er berührt, tatsächlich? | Macht grenzüberschreitende Verarbeitung sichtbar, die der Speicherort allein verbirgt |
Key Facts
- Die Datenschutzfläche eines Agents ist größer als die eines einzelnen Modellaufrufs, weil jeder Tool-Aufruf ein eigener Datenfluss ist, der personenbezogene Daten in einem einzigen Lauf an mehrere Systeme streut.
- Datenminimierung bei Agents ist dasselbe Prinzip wie Least-Privilege-Tool-Zugriff, angewandt auf Daten: Ziehen Sie nur die Felder, die ein Schritt braucht, nicht den ganzen Datensatz.
- Im Langzeit-Memory von Agents sammeln sich Datenschutz-Altlasten unbemerkt an; es braucht sowohl eine Richtlinie zu Aufbewahrung und Ablauf als auch eine echte Löschfunktion nach Person für Löschanfragen.
- Die Data and Privacy Benchmark Study 2026 von Cisco ergab, dass 81 % der Organisationen eine gestiegene Nachfrage nach Datenlokalisierung erleben und nur 12 % ihre AI-Governance-Struktur als ausgereift beschreiben, obwohl 75 % eine haben.
- Der Cost of a Data Breach Report 2026 von IBM ergab, dass nur 37 % der Organisationen sensible Daten im Ruhezustand und bei der Übertragung verschlüsseln und dass kompromittierte APIs, Anwendungen oder Plug-ins mit 27 % gemeinsam die häufigste Ursache von Vorfällen waren, die auf AI-Modelle oder -Anwendungen zielten.
Häufig gestellte Fragen zu AI Agent Data Privacy
Was ist AI Agent Data Privacy?
Es ist die Praxis, zu kontrollieren, welche personenbezogenen Daten ein Agent liest, an ein Modell oder Tool sendet, speichert und schließlich löscht, während er seine Schleife durchläuft. Sie umfasst den bewussten Umgang mit PII, die Minimierung dessen, worauf der Agent zugreift, und das Wissen, wo Daten tatsächlich verarbeitet werden, nicht nur, wo sie gespeichert sind.
Wie unterscheidet sich Datenschutz von Datensicherheit bei einem AI Agent?
Sicherheit fragt, ob ein Agent dazu manipuliert werden kann, etwas Schädliches zu tun, etwa Daten an einen Angreifer preiszugeben. Datenschutz stellt eine engere Frage, die auch dann gilt, wenn nichts angegriffen wird: Wessen Daten gingen bei einem normalen, korrekt funktionierenden Lauf wohin, und mussten sie überhaupt dorthin gehen?
Was ist Datenminimierung bei einem AI Agent?
Es ist die Praxis, nur die konkreten Felder zu ziehen, die eine Aufgabe braucht, statt eines ganzen Datensatzes, nur weil ein API-Aufruf ihn komplett verfügbar macht. Es ist dieselbe Logik wie beim Least-Privilege-Tool-Zugriff, angewandt auf Daten statt auf Berechtigungen, und es verringert sowohl die Datenschutzexposition als auch unnötigen Kontext.
Kann das Memory eines AI Agents das Recht auf Vergessenwerden verletzen?
Ja, wenn der Memory-Speicher keinen Weg bietet, auf Verlangen alles zu finden und zu löschen, was einer bestimmten Person zugeordnet ist. Langzeit-Memory, behandelt in AI Agent Memory, speichert Fakten über Sessions hinweg, und ohne Aufbewahrungsrichtlinie und eine echte Löschfunktion nach Person kann es Daten weit über den Zeitpunkt hinaus behalten, ab dem eine Person Anspruch auf deren Entfernung hat.
Löst die Speicherung der Daten in der richtigen Region die Datenresidenz bei AI Agents?
Nicht allein. Ein Agent kann Daten, die in einer konformen Region gespeichert sind, während eines Laufs in ein Modell oder Tool ziehen, das sie ganz woanders verarbeitet. Datenresidenz bei einem Agent bedeutet zu prüfen, wo jedes Tool und jedes Modell das, was es berührt, tatsächlich verarbeitet, nicht nur, wo die zugrunde liegenden Datensätze liegen.
Wie es weitergeht
Datenschutz bei einem Agent ist eng mit zwei weiteren Disziplinen verbunden, die an anderer Stelle in dieser Bibliothek behandelt werden. AI Agent Security behandelt die Bedrohungsmodell-Seite, also zu verhindern, dass der Agent dazu manipuliert wird, absichtlich Daten preiszugeben. AI Agent Compliance behandelt die regulatorische Zuordnung, den Audit Trail und die Seite des EU AI Act ausführlich. Lesen Sie Datenschutz zusammen mit beiden statt isoliert, denn ein wirklich gut gesteuerter Agent braucht alle drei im Zusammenspiel.

On this page
- Warum die Datenschutzfläche eines Agents größer ist als die eines Modells
- Umgang mit PII: Kennen Sie sie, bevor Sie sie bewegen
- Minimierung: dieselbe Disziplin wie Least Privilege, auf Daten angewandt
- Im Memory sammeln sich unbemerkt Datenschutz-Altlasten an
- Datenresidenz kurz gefasst: Speicherung ist nicht die ganze Frage
- Was schwache Datenhygiene tatsächlich kostet
- Eine praktische Start-Checkliste
- Key Facts
- Wie es weitergeht