Cómo implementar AI agents en producción: pruebas, despliegue y reversión
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Implementar un AI agent en producción es un proceso por etapas, no un único momento de "encenderlo": probarlo con casos históricos reales, desplegarlo gradualmente detrás de compuertas como el modo sombra y la aprobación humana, monitorear las pocas métricas que realmente predicen un fallo y tener lista una vía de reversión rápida antes de necesitarla. Si se salta una etapa, el agent que funcionó perfecto en una demo se convierte en el agent en el que nadie confía tres semanas después de empezar con tráfico real. Esta guía cubre las cuatro etapas, sea cual sea la plataforma o el framework con el que construyó el agent.
Por qué "funcionó en la demo" no basta
La brecha entre un prototipo funcional y un sistema de producción que sobrevive al contacto con entradas reales, desordenadas y hostiles es donde mueren la mayoría de los proyectos de agents. La iniciativa NANDA del MIT encontró en 2025 que el 95% de los pilotos de generative AI en empresas no lograba un retorno financiero medible, a pesar de una inversión empresarial estimada de entre 30.000 y 40.000 millones de dólares. El planteamiento del propio informe importa aquí: el fallo no estuvo en la calidad del modelo de base, sino en pilotos que nunca recibieron la disciplina operativa necesaria para convertirse en algo en lo que una empresa pudiera apoyarse de verdad.
Gartner le pone una cifra a la versión específica de los agents de ese mismo problema, y predice que más del 40% de los proyectos de agentic AI se cancelarán a finales de 2027, citando como causas principales el aumento de los costos, el valor de negocio poco claro y los controles de riesgo inadecuados, no una tecnología fallida. Las tres son problemas de implementación, no problemas del modelo, y eso es justamente lo que esta guía busca resolver.
Si todavía no ha construido el agent, cómo construir un AI agent cubre los seis componentes básicos que van antes de todo esto, y construir un AI agent con CrewAI y AI agents no-code frente a con código cubren la construcción en sí. Esta guía continúa desde que usted tiene una versión que funciona en pruebas y debe decidir cómo ponerla de forma segura delante de un volumen real.
Etapa 1: pruebe con casos reales, no inventados
Antes de que nada salga, ejecute el agent contra un conjunto de pruebas construido con casos históricos reales, no con casos hipotéticos que imaginó mientras construía. Cómo evaluar y probar AI agents lo explica por completo: construir el conjunto de pruebas, definir qué significa el éxito para este trabajo específico y calificar los resultados con reglas, revisión humana o un LLM como juez. Trate esa práctica de evaluación como un requisito previo de todo lo que sigue, no como un paso que se pueda comprimir cuando la demo ya se ve bien.
Etapa 2: despliegue gradualmente
Nadie debería pasar un agent de cero al 100% del volumen en un solo paso. Un despliegue por etapas detecta los problemas mientras el radio de impacto todavía es pequeño.
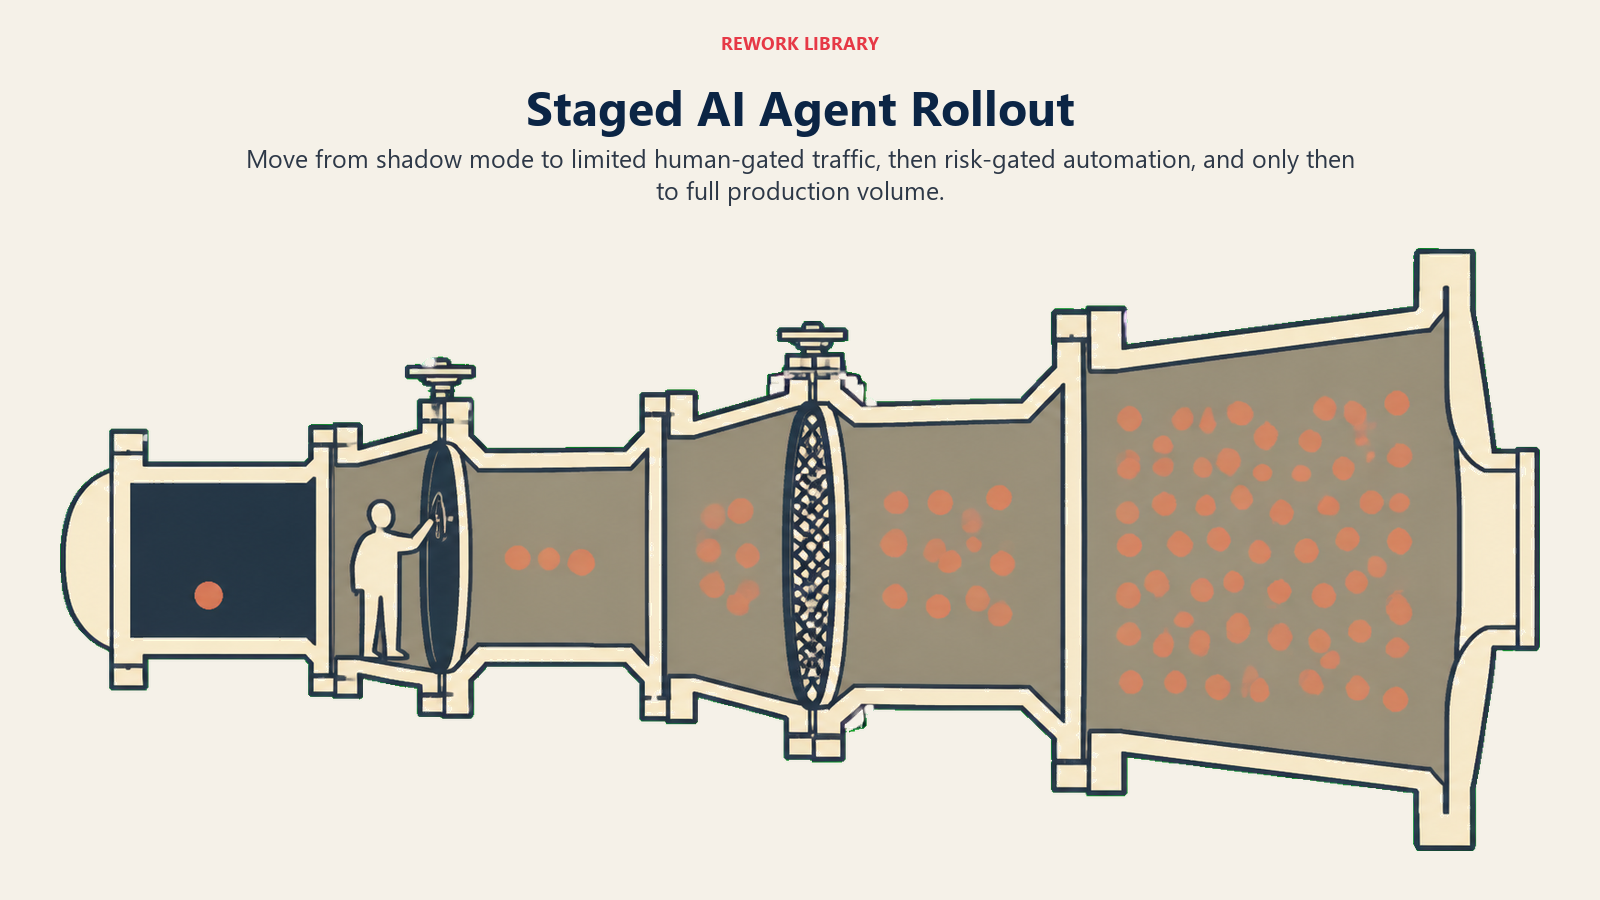
| Etapa | Qué ocurre | Qué detecta |
|---|---|---|
| Modo sombra | El agent se ejecuta con entradas reales pero su salida no se aplica; una persona o el proceso anterior sigue encargándose de todo | Si sus decisiones coinciden con lo que realmente ocurrió, sin ningún riesgo de cara al cliente |
| Tráfico limitado, con aprobación humana | El agent actúa sobre un pequeño porcentaje del volumen, y una persona aprueba antes de que algo salga | Casos límite del mundo real, con una red de seguridad todavía vigente |
| Tráfico completo, condicionado por el riesgo | El agent actúa automáticamente en los casos de bajo riesgo y sigue transfiriendo todo lo de alto riesgo | Si la lógica de decisión (actuar, preguntar o transferir) está bien calibrada |
| Despliegue completo | El agent funciona con todo el volumen, solo con las barreras de protección y el monitoreo | La deriva continua y los casos límite que solo aparecen a escala real |
Dónde coloque las compuertas debe seguir el costo de un error. Un agent como el AI CRM Hygiene Agent, que corrige un registro duplicado, puede pasar por estas etapas con rapidez. Un agent como el AI Collections and AR Agent, que reclama a un cliente un dinero adeudado, o el AI Invoice and AP Agent, que aprueba un pago, merece una permanencia más larga en la etapa con aprobación humana, porque el costo de una acción autónoma equivocada es dinero real y una relación real con el cliente, no solo una molestia. Intervención humana en los AI agents explica exactamente cómo diseñar esas compuertas de aprobación para que detecten el riesgo real sin convertirse en un sello automático.
Etapa 3: monitoree lo que realmente predice el fallo
Una vez que el agent está en vivo, vigilarlo es una disciplina distinta de probarlo. Observabilidad de los AI agents cubre a fondo toda la pila de trazabilidad y métricas; la versión corta es que necesita ver qué herramienta llamó, con qué resultado, en cada paso, y no solo si la salida final parecía razonable.
Existe una brecha real entre cuántos equipos monitorean a sus agents y cuántos los evalúan de forma adecuada y continua. La encuesta de 2025 de LangChain a constructores de agents encontró que el 89% de las organizaciones ha implementado algún tipo de observabilidad, pero solo el 52,4% ejecuta evaluaciones offline y el 37,3% ejecuta evaluaciones online de forma regular. Vigilar a un agent y calificar con rigor lo que hace no son la misma práctica, y la segunda es la que realmente detecta la deriva de calidad antes de que lo haga un cliente. La misma encuesta halló que la calidad de la salida es la mayor barrera de implementación, citada por el 33% de los encuestados, por delante de la seguridad con el 24,9% y la latencia con el 20%, un útil baño de realidad frente al instinto de sobreinvertir en infraestructura antes de que las decisiones reales del agent sean confiables.
Aquí también cobran relevancia directa MLOps y el monitoreo de modelos: la implementación de agents hereda la misma disciplina de producción que se aplica a cualquier modelo en vivo, más la complejidad añadida de un ciclo de varios pasos con llamadas a herramientas en lugar de una sola predicción.
Etapa 4: tenga una vía de reversión antes de necesitarla
Defina sus disparadores de reversión antes del lanzamiento, no en medio de un incidente. Elija los dos o tres números que le dirían que algo anda mal, como una caída en la tasa de éxito de las tareas, un aumento en la tasa de anulación humana o un salto en las escaladas, y decida de antemano qué ocurre cuando uno de ellos cruza un umbral: si el tráfico vuelve a la versión anterior del agent, regresa a la gestión totalmente humana o se pausa por completo hasta que alguien lo revise.
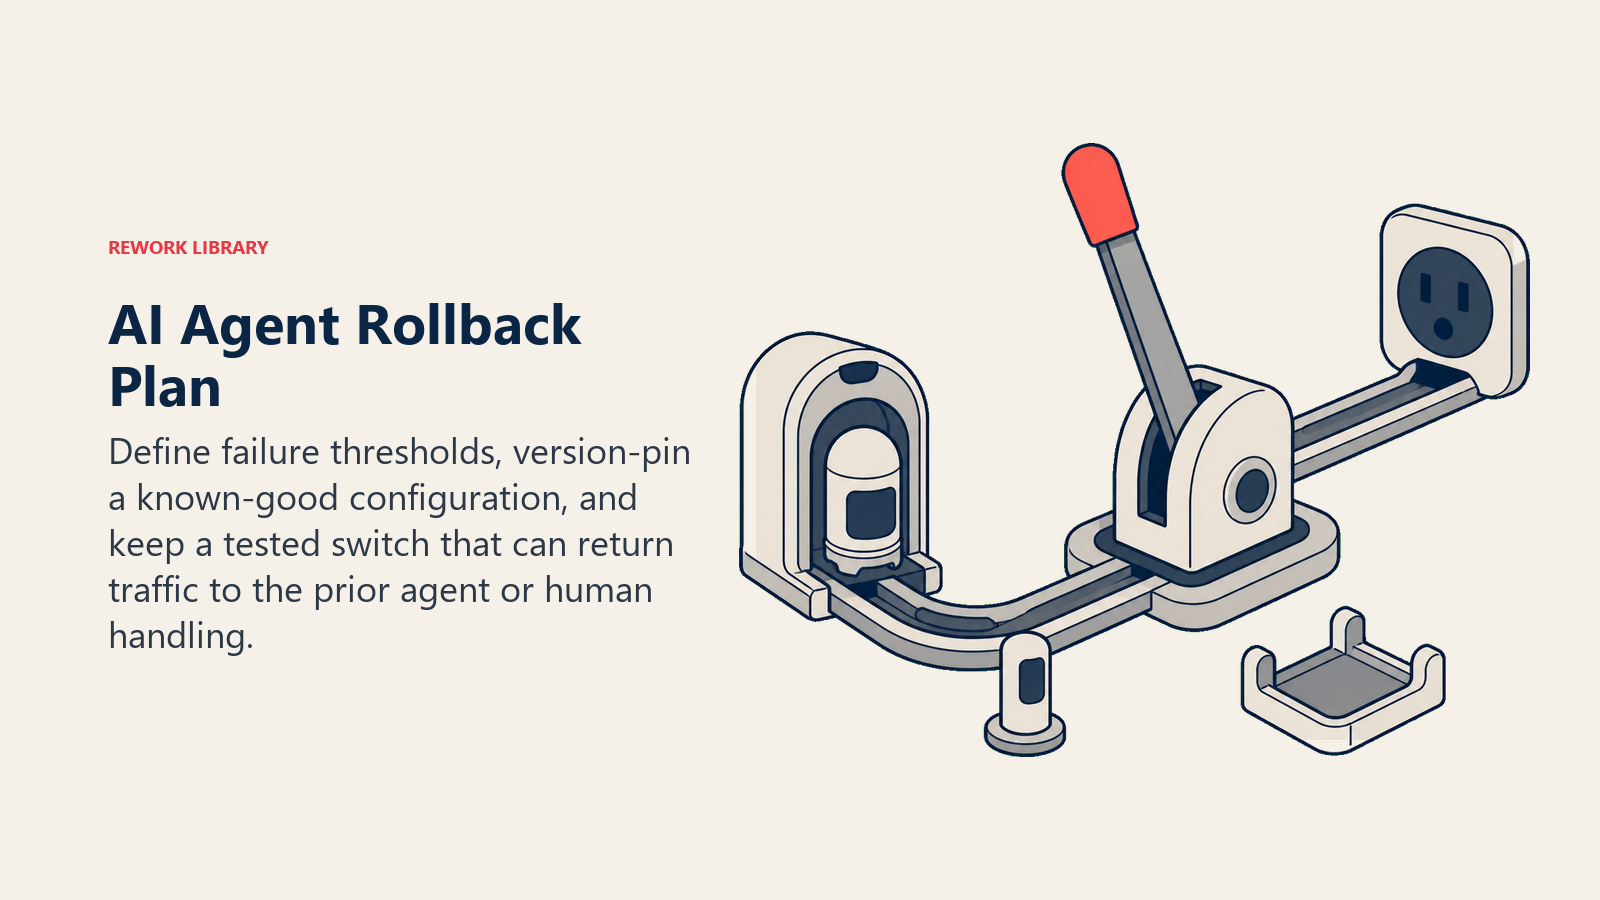
En la práctica, eso significa fijar las versiones de los prompts, las herramientas y la configuración del agent igual que se versiona el código de una aplicación, de modo que "revertir" signifique cambiar a una configuración conocida y estable en lugar de intentar recordar qué cambió. Vale la pena construir antes del lanzamiento, no después de que el primer mal incidente lo justifique por usted, un feature flag o un mecanismo sencillo de reparto de tráfico que pueda sacar el volumen del agent al instante. Apresurar esta etapa es justo el tipo de atajo que más tarde aparece como deuda técnica de AI: el costo de saltarse la planificación de la reversión no desaparece, solo se traslada más adelante y se encarece.
Las barreras de protección, que se explican en barreras de protección de los AI agents, y los límites estrictos que se explican en seguridad de los AI agents, hacen el trabajo continuo de detectar acciones individuales erróneas. La reversión es la palanca aparte, más gruesa, para cuando toda la implementación debe detenerse, no solo una llamada.
Una lista de verificación del despliegue antes de accionar el interruptor
- Un conjunto de pruebas construido con casos históricos reales, con una métrica definida de éxito de las tareas
- Un periodo en modo sombra o con tráfico limitado completado, con los resultados revisados por una persona
- Compuertas de aprobación humana en cualquier acción que sea financiera, irreversible o de cara al cliente a escala
- Trazabilidad y registro en funcionamiento para cada llamada a herramientas, no solo para la salida final
- Un disparador de reversión definido y una forma rápida y probada de ejecutarlo
- Un responsable que rinda cuentas por vigilar al agent después del lanzamiento, no solo por construirlo
Quién autoriza el despliegue
Un agent en producción que toma decisiones reales necesita un responsable además de la persona que lo construyó, alguien que responda por el plan de despliegue, el monitoreo y la decisión de cuándo revertir. Es tanto una cuestión de gobernanza como técnica, y conviene decidirla de forma explícita y no por defecto. Gestión del cambio en AI cubre el lado de la adopción, lograr que las personas que trabajan junto al agent confíen en él y lo usen correctamente, y gobernanza por patrón explica cómo cambian los requisitos de gobernanza según el patrón de AI subyacente sobre el que se construye el agent.
Datos clave
- La iniciativa NANDA del MIT encontró que el 95% de los pilotos de generative AI en empresas no logró un ROI medible en 2025, una brecha que el informe atribuye a la falta de disciplina operativa, no a la calidad del modelo.
- Gartner predice que más del 40% de los proyectos de agentic AI se cancelarán a finales de 2027, por el aumento de los costos, el valor de negocio poco claro y los controles de riesgo inadecuados, todos problemas de implementación y no del modelo.
- Un despliegue por etapas (modo sombra, tráfico limitado con aprobación humana, tráfico completo condicionado por el riesgo y despliegue completo) detecta los problemas mientras el radio de impacto todavía es pequeño.
- La encuesta de 2025 de LangChain encontró que el 89% de las organizaciones tiene algún tipo de observabilidad, pero solo el 52,4% ejecuta evaluaciones offline y el 37,3% ejecuta evaluaciones online con regularidad, una brecha real entre vigilar a un agent y calificarlo con rigor.
- Defina los disparadores y los mecanismos de reversión antes del lanzamiento. Fije las versiones de la configuración del agent para que revertir signifique cambiar a un estado conocido y estable, y no reconstruir lo que cambió durante un incidente.
Siguientes pasos
Un agent en producción no es un proyecto terminado, es un sistema que necesita la misma atención continua que cualquier otra pieza de infraestructura en vivo. Observabilidad de los AI agents profundiza en qué trazar y medir una vez que está en vivo, y barreras de protección de los AI agents cubre los límites estrictos que deben mantenerse sin importar cuán cuidadoso haya sido su despliegue. Si está comparando plataformas con instrumental de producción integrado frente a otras que tendrá que instrumentar usted mismo, el resumen de herramientas para desarrolladores y TI y la guía de compra de plataformas DevOps son buenas siguientes paradas.

On this page
- Por qué "funcionó en la demo" no basta
- Etapa 1: pruebe con casos reales, no inventados
- Etapa 2: despliegue gradualmente
- Etapa 3: monitoree lo que realmente predice el fallo
- Etapa 4: tenga una vía de reversión antes de necesitarla
- Una lista de verificación del despliegue antes de accionar el interruptor
- Quién autoriza el despliegue
- Datos clave
- Siguientes pasos