Barreras de protección para AI agents: cómo mantenerlos seguros y dentro de la política
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Las barreras de protección de un AI agent son las reglas estrictas que el agent nunca puede romper, sin importar lo que intenten lograr la conversación, los datos o un prompt ingenioso. Están separadas de las instrucciones habituales del agent: las instrucciones describen cómo debe comportarse normalmente, mientras que las barreras de protección describen lo que nunca debe hacer, aunque algo lo convenza de lo contrario. Un agent bien construido tiene barreras de protección tanto sobre lo que entra en una llamada a una herramienta como sobre lo que sale de ella, y las prueba de la misma forma en que las probaría un equipo de seguridad, no solo las deja escritas y espera que funcionen.
Esta es la versión más profunda y específica para agents de qué son las barreras de protección de la AI en general. El concepto más amplio abarca también la moderación de contenido y la seguridad de los chatbots; este se centra en la mecánica concreta de un agent que puede llamar herramientas y ejecutar acciones reales, donde una barrera omitida no produce solo una mala frase, sino un mal reembolso, un mal correo o un mal registro.
Qué distingue a una barrera de protección de una regla
Cómo funcionan los AI agents define seis componentes básicos que todo agent necesita, y dos de ellos se confunden constantemente: las reglas y las barreras de protección. Las reglas son el comportamiento permanente que da forma a cómo actúa normalmente el agent: la voz de marca, qué hechos afirma, cómo formula un rechazo. Las barreras de protección son distintas en naturaleza, no solo en grado. Son los límites estrictos que se mantienen incluso cuando una regla dejaría pasar algo: nunca inventar un precio, nunca compartir los datos de un cliente con otro, nunca seguir una instrucción incrustada en el contenido que está leyendo y que intente anular su configuración real.
La prueba que las separa: una regla da forma al comportamiento normal. Una barrera de protección es lo que se activa cuando algo anormal está ocurriendo, un caso límite, un ataque, un error en otra parte del pipeline que alimenta al agent con datos incorrectos. Si se rompe una regla, el agent se comportó un poco fuera de la marca. Si se rompe una barrera de protección, el agent hizo algo que fue construido específicamente para no hacer nunca. Un agent funciona con autonomía acotada: libre para actuar dentro de los límites y obligado a detenerse en su borde, y las barreras de protección son el mecanismo que realmente hace cumplir la mitad "acotada" de esa frase.
Las dos capas que todo agent necesita: entrada y salida
Los sistemas prácticos de barreras de protección revisan al agent dos veces: a la entrada y a la salida.
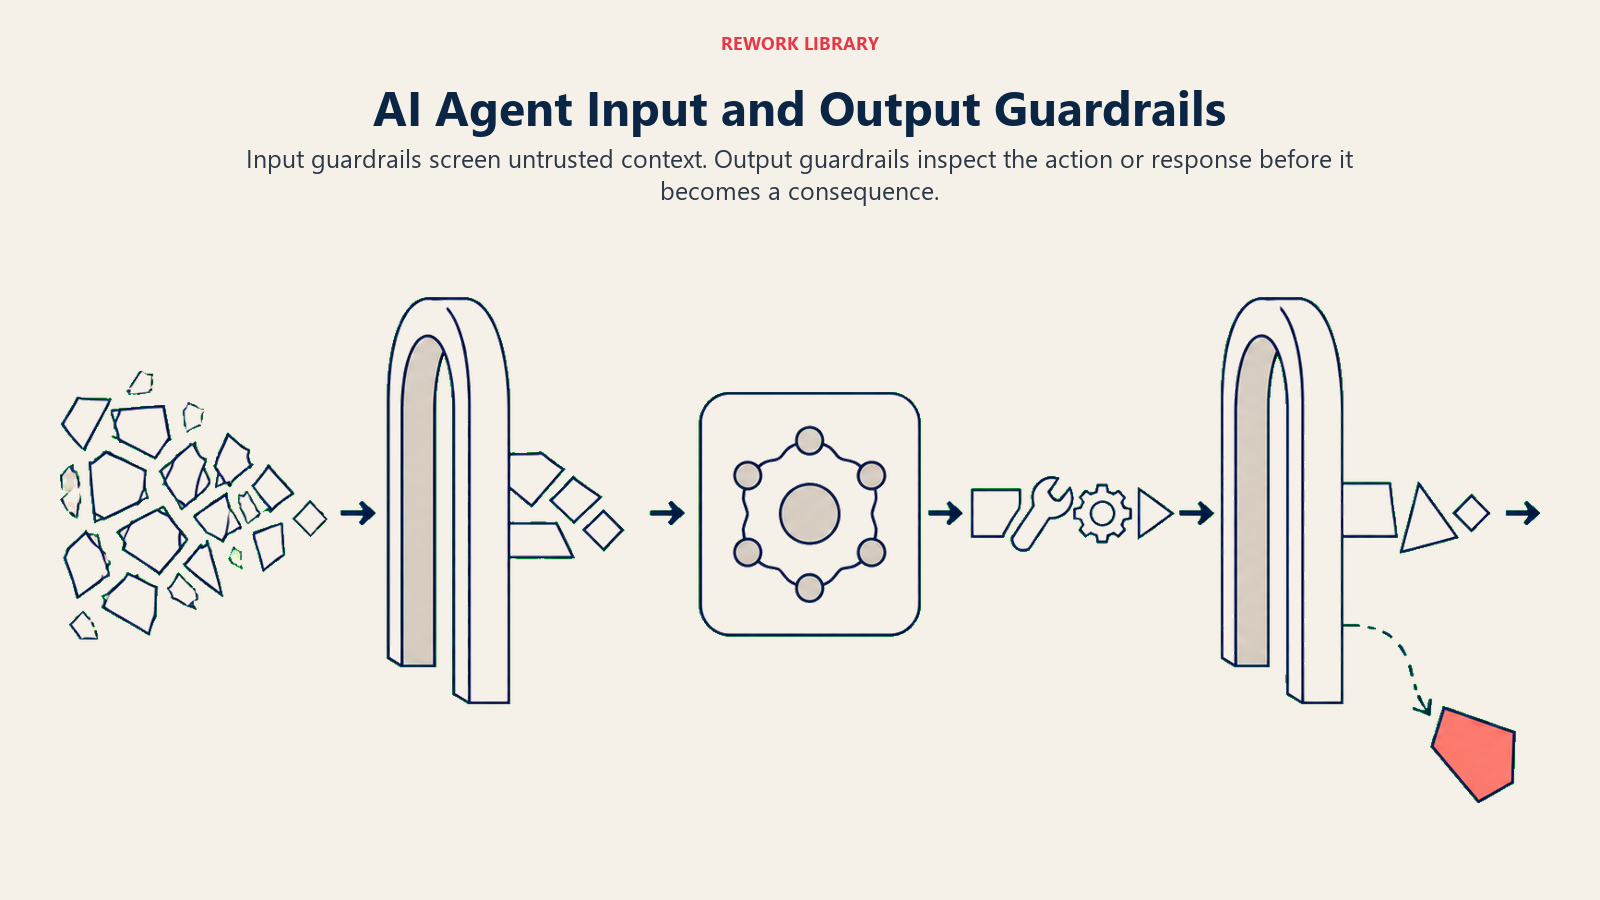
Las barreras de entrada filtran lo que llega al agent antes de que se trate como contexto confiable. Esta es la capa que detecta un intento de prompt injection oculto en un documento que el agent está a punto de leer, o una solicitud de llamada a una herramienta que no coincide con nada de lo que realmente se le pidió al agent. Es el filo más agudo de aplicar la seguridad de la AI a los agents en particular. Los filtros basados en patrones detectan plantillas de ataque conocidas; un modelo clasificador detecta las nuevas.
Las barreras de salida filtran lo que el agent está por hacer o decir antes de que se concrete. Esta es la capa que detecta una respuesta redactada que filtra los datos de otro cliente, un parámetro de llamada a una herramienta fuera del rango esperado (un reembolso de $50,000 cuando la política limita los reembolsos automáticos a $500) o una respuesta que viola una política declarada aunque nada anterior lo haya señalado.
Ninguna de las dos capas basta por sí sola. La guía de OWASP al respecto es directa: defensa en profundidad, porque un solo filtro, por bueno que sea, tarde o temprano es eludido por algo nuevo. Ejecutar ambas capas de forma independiente significa que un fallo de un lado aún se detecta del otro.
Las listas de permitidos superan a las listas de denegados para las herramientas del agent
El error más común con las barreras de protección es intentar enumerar todo lo que un agent no debería hacer. Esa lista es infinita. La versión viable es la opuesta: enumerar exactamente lo que el agent tiene permitido hacer y bloquear todo lo demás por defecto.
Esto es lo que OWASP llama Excessive Agency (agencia excesiva), LLM06 en su Top 10 para aplicaciones de LLM: un sistema al que se le otorga más funcionalidad, permisos o autonomía de los que el trabajo realmente necesita. Un agent creado para redactar sugerencias de reembolso no necesita una herramienta que los emita. Un agent que investiga cuentas no necesita acceso de envío a su cliente de correo. Cada herramienta que un agent puede llamar es en sí misma una decisión de barrera de protección: si le da la herramienta, ha concedido el permiso, lo haya querido o no para cada situación en la que esa herramienta pueda usarse.
El patrón Autonomous Agent lo llama límites de alcance: una lista explícita de herramientas permitidas a las que el agent puede acceder, revisada antes del despliegue, sin ampliación en tiempo de ejecución. Si el agent necesita una nueva capacidad a mitad de una tarea, es una señal para que una persona tome una decisión de configuración, no algo que el agent se conceda a sí mismo.
Dónde se ubican las barreras de protección en el ciclo del agent
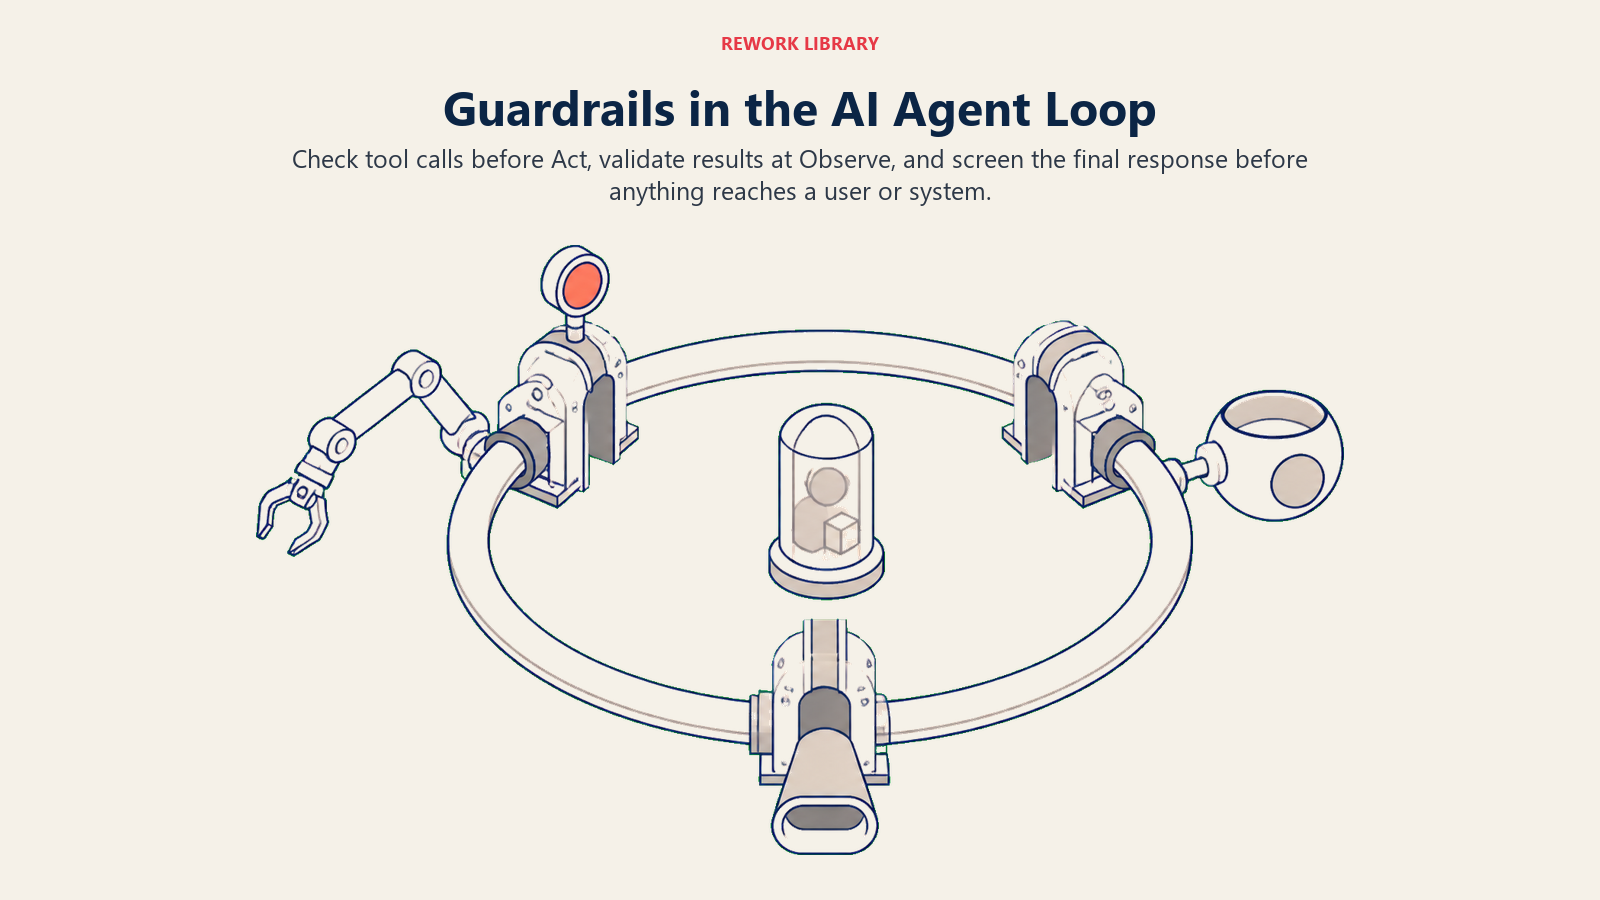
Sobre el ciclo de percibir, razonar, actuar y observar, las barreras de protección corresponden a tres puntos específicos, no flotan de forma general alrededor del agent:
| Paso del ciclo | Control de la barrera de protección | Ejemplo |
|---|---|---|
| Antes de Actuar | ¿Esta llamada a una herramienta está en la lista de permitidos y sus parámetros están dentro de los límites esperados? | Bloquear una llamada a la herramienta de reembolsos por encima del umbral de aprobación automática antes de que se ejecute |
| Al Observar | ¿El resultado de la herramienta parece coherente antes de que el agent razone a partir de él? | Marcar una API de calendario que devuelve una fecha de hace años como señal para detenerse, no para continuar |
| Antes de la respuesta final | ¿La salida redactada viola una política declarada, aunque todos los pasos anteriores hayan parecido correctos? | Detectar una respuesta que indica un precio que nunca se le dio al agent, una probable alucinación |
Incorporar el control en el propio ciclo, en lugar de dejarlo como un proceso de revisión separado que ocurre después, es lo que hace que una barrera de protección sea una barrera de protección y no un documento de política. Se activa en tiempo real, antes de que llegue la consecuencia, en cada ejecución, no sobre una muestra de ejecuciones que un equipo de cumplimiento revisa semanas más tarde. También es lo que produce el registro de auditoría que exigen los requisitos de gobernanza de cada patrón: un registro de exactamente qué barrera se activó, cuándo y por qué.
Cómo probar si sus barreras de protección realmente funcionan
Una barrera que nadie ha intentado romper es una barrera sobre la que usted solo supone. El AI red teaming, la prueba adversarial estructurada en la que alguien intenta activamente que el agent haga lo que no debe hacer, es lo que convierte "tenemos barreras de protección" de una afirmación en un hecho verificado.
Ejecútelo antes del lanzamiento, por supuesto. Vuelva a ejecutarlo después de cualquier cambio en el prompt, la lista de herramientas o el modelo subyacente, porque una barrera que resistió frente al modelo del trimestre pasado puede fallar en silencio frente al de este trimestre. Trate cada casi-error real, un caso en el que el agent estuvo a punto de hacer lo incorrecto pero una barrera lo detuvo, como datos de prueba gratuitos: le indica exactamente qué someter a red teaming con más rigor la próxima vez.
El Perfil de AI generativa AI 600-1 del NIST plantea esto dentro de su función MEASURE: la gestión de riesgos no está completa hasta que haya probado si sus controles resisten en condiciones adversariales, no solo si existen sobre el papel. La mayoría de las organizaciones aún no llega a ese punto en gobernanza de la AI en general. Una encuesta de 2026 a 193 líderes de cumplimiento, riesgo y auditoría encontró que el 83% de las organizaciones afirma usar herramientas de AI, pero solo alrededor del 25% ha implementado un marco de gobernanza sólido, lo que significa que la mayoría de los AI agents en producción hoy funcionan con barreras de protección que se escribieron una vez y desde entonces nunca se probaron de forma adversarial.
Barreras de protección frente a intervención humana: trabajos distintos
Las barreras de protección y los puntos de control con intervención humana se mezclan constantemente, pero resuelven problemas distintos, y un agent maduro necesita ambos.
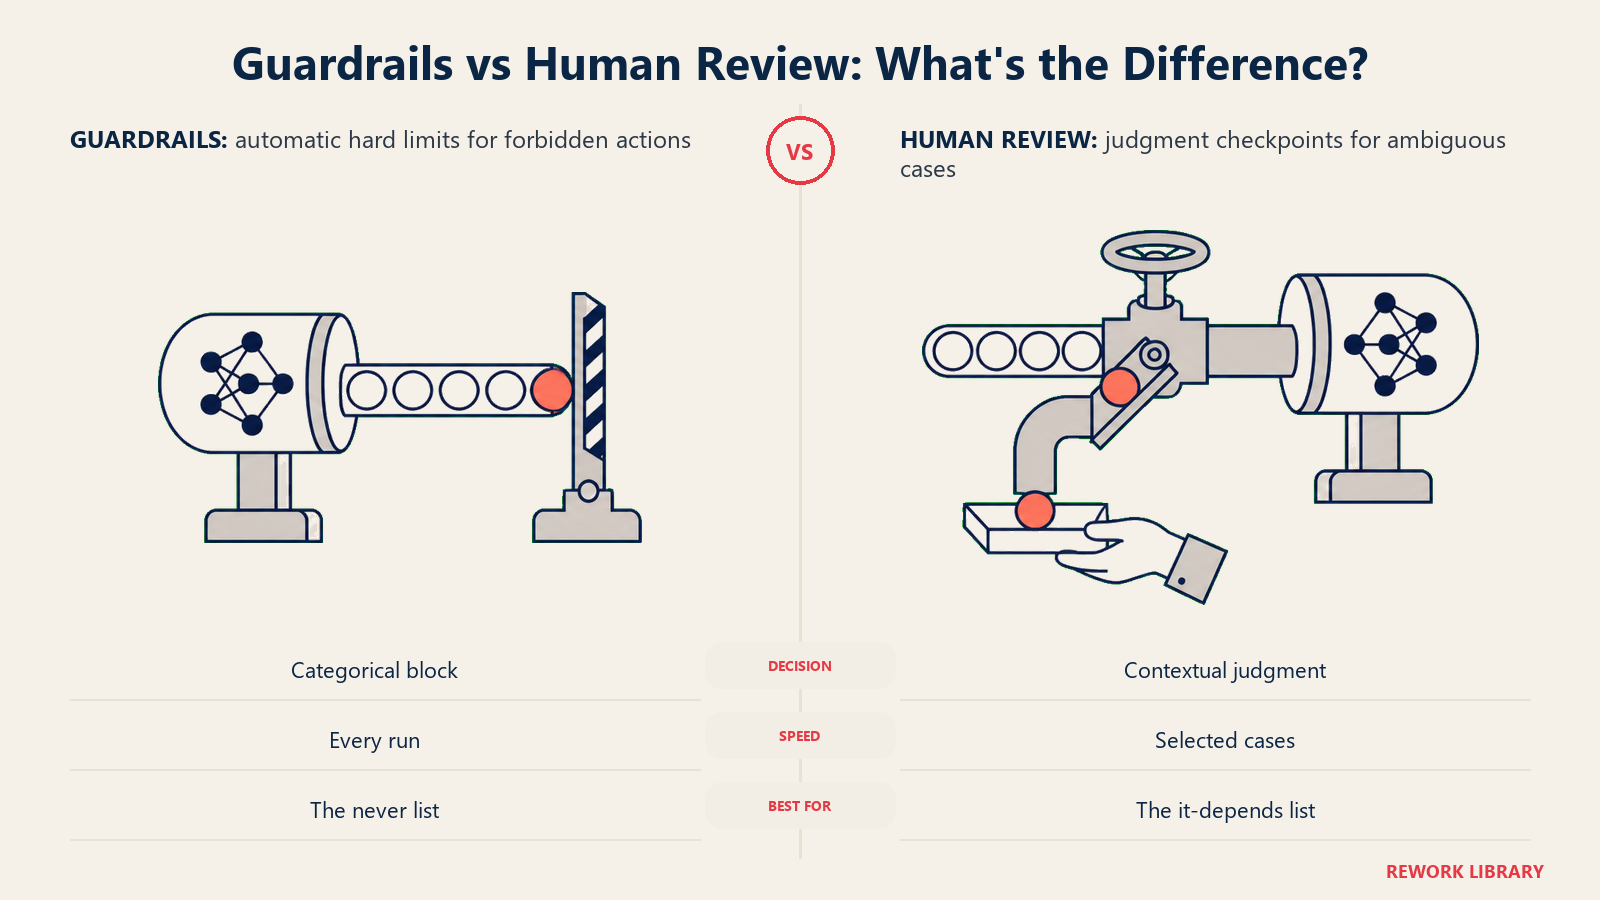
Una barrera de protección es automática y categórica. No pide permiso, hace cumplir una línea: nunca hacer X, sin importar el contexto. Se ejecuta en cada paso del ciclo, a velocidad de máquina, sin nadie mirando en tiempo real.
Un punto de control con intervención humana es una pausa, no un bloqueo. Sirve para los casos en que la respuesta correcta depende genuinamente de un criterio que una política no puede codificar por completo de antemano: una excepción de precio que tiene sentido para esta cuenta en particular, una cláusula contractual dudosa que necesita la lectura de un abogado. El agent no sabe que la respuesta es incorrecta; sabe que la situación es de las que necesitan una segunda opinión.
En conjunto: las barreras de protección manejan la lista de "nunca", y los puntos de control humanos manejan la lista de "depende". Un agent con solo barreras de protección es rígido y aun así lo superan situaciones que quien redactó las reglas no anticipó. Un agent con solo puntos de control humanos es lento y anula el propósito mismo de automatizar el trabajo. Necesita el piso firme y la válvula de criterio, no uno u otra.
Un conjunto inicial de barreras de protección por función
Algunos ejemplos concretos, tomados de los planes de esta biblioteca, de cómo se ve una barrera de protección cuando es lo bastante específica como para hacerse cumplir:
| Agent | Barrera de protección |
|---|---|
| Invoice AP Agent | Nunca pagar una factura que no coincida con una orden de compra aprobada, sin importar cuán alta sea la puntuación de coincidencia |
| Expense Approval Agent | Nunca aprobar automáticamente por encima de un umbral fijo en dólares, sin ninguna lógica de excepciones que pueda anularlo |
| AI Contract Review Agent | Nunca enviar una redline ni una respuesta a la contraparte sin la aprobación de una persona sobre el cambio específico |
| AI Security Monitoring Agent | Nunca cerrar automáticamente una alerta de severidad crítica; enviarla al SOC sin importar la propia confianza del agent |
| AI Access Provisioning Agent | Nunca otorgar acceso elevado o de administrador sin un aprobador designado registrado |
Cada una de estas es deliberadamente estrecha y binaria. Una barrera formulada como "use buen criterio con los pagos" no es una barrera de protección, es un deseo. "Nunca pagar sin una orden de compra coincidente" es algo que se puede construir, probar y demostrar.
Si usted está estandarizando las políticas de barreras de protección y de acceso para agents orientados a TI en particular, la categoría de herramientas de desarrollo y TI y la guía para elegir software ITSM cubren los motores de políticas y los workflows de aprobación sobre los que terminan ejecutándose la mayoría de estas barreras.
Datos clave
- Una barrera de protección es un límite estricto que se mantiene incluso cuando todo en una situación intenta eludirlo; una regla da forma al comportamiento normal, una barrera de protección detiene el comportamiento anormal.
- Las barreras de protección eficaces funcionan en dos capas: filtrado de entrada antes de que el contenido se convierta en contexto confiable y filtrado de salida antes de que una acción o respuesta se concrete.
- Usar listas de permitidos para las herramientas (mínimo privilegio) supera a intentar denegar cada acción mala; OWASP llama a no hacerlo Excessive Agency, LLM06 en su Top 10 para aplicaciones de LLM.
- Una barrera de protección vale tanto como las pruebas adversariales que la respaldan. Una encuesta de 2026 encontró que el 83% de las organizaciones usa herramientas de AI, pero solo alrededor del 25% tiene un marco de gobernanza sólido.
- Las barreras de protección y los puntos de control con intervención humana cumplen trabajos distintos: las barreras hacen cumplir automáticamente la lista de "nunca", los puntos de control manejan los casos de "depende" que requieren criterio.
Preguntas frecuentes sobre las barreras de protección de los AI agents
¿Qué es una barrera de protección de un AI agent?
Una barrera de protección es un límite estricto incorporado a un agent que se mantiene sin importar el contexto: nunca inventar un precio, nunca compartir los datos de un cliente con otro, nunca enviar un correo sin aprobación. Se diferencia de una instrucción normal porque está diseñada para mantenerse incluso cuando algo intenta activamente eludirla, ya sea un atacante, un error o un caso límite que nadie anticipó.
¿Cuál es la diferencia entre una barrera de protección y una regla?
Las reglas describen cómo debe comportarse normalmente un agent: tono, redacción, qué hechos afirma. Las barreras de protección describen lo que nunca debe hacer, incluso en situaciones que una regla no anticipó. Si se rompe una regla, el agent actuó un poco fuera de la marca. Si se rompe una barrera de protección, el agent hizo algo que fue construido específicamente para evitar.
¿Las barreras de protección deben usar una lista de permitidos o una lista de denegados para las herramientas?
Una lista de permitidos. Intentar enumerar cada acción que un agent no debería realizar es una lista interminable; enumerar exactamente lo que tiene permitido hacer y bloquear todo lo demás por defecto es finito y auditable. OWASP llama Excessive Agency a otorgar a un agent más permisos de los que necesita su trabajo, uno de sus 10 principales riesgos para aplicaciones de LLM.
¿Cómo sé si las barreras de protección de mi agent realmente funcionan?
Pruébelas de forma adversarial, de la misma manera en que lo haría un equipo de seguridad, antes del lanzamiento y de nuevo después de cualquier cambio en el prompt, las herramientas o el modelo. Una barrera que nunca ha sido atacada activamente en las pruebas es una barrera sobre la que usted supone, no una que haya verificado.
¿Las barreras de protección reemplazan la necesidad de puntos de control con intervención humana?
No, cubren modos de fallo distintos. Las barreras de protección son automáticas y categóricas, creadas para la lista de "nunca". Los puntos de control con intervención humana son para decisiones de criterio que una barrera no puede codificar por completo de antemano. Un agent maduro necesita ambos: el piso firme y la válvula de criterio.
A dónde ir a continuación
Las barreras de protección, los puntos de control humanos y las defensas contra injection son tres partes del mismo sistema, no tres proyectos separados. Comience con prompt injection para entender el ataque que estas barreras están diseñadas para resistir, y luego la intervención humana para AI agents para la capa de criterio que las acompaña. Para ver cómo encajan los seis componentes básicos desde el principio, cómo funcionan los AI agents es el lugar para empezar.

On this page
- Qué distingue a una barrera de protección de una regla
- Las dos capas que todo agent necesita: entrada y salida
- Las listas de permitidos superan a las listas de denegados para las herramientas del agent
- Dónde se ubican las barreras de protección en el ciclo del agent
- Cómo probar si sus barreras de protección realmente funcionan
- Barreras de protección frente a intervención humana: trabajos distintos
- Un conjunto inicial de barreras de protección por función
- Datos clave
- A dónde ir a continuación