RAG para AI agents: cómo fundamentar a los agents en sus datos
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
RAG, generación aumentada por recuperación (retrieval-augmented generation), es la forma en que un AI agent responde y actúa con sus documentos y datos reales en lugar de adivinar a partir de lo que un modelo haya aprendido por casualidad durante el entrenamiento. El agent convierte una pregunta o tarea en una búsqueda, recupera los fragmentos más relevantes de una knowledge base y genera su siguiente paso únicamente con lo que encontró, citando la fuente. Para un agent, el RAG no es una función añadida a posteriori. Es la capa de fundamentación que mantiene cada acción atada a algo real y actual.
El RAG en una frase, para un agent
La mecánica central: primero recuperar, después generar, y nunca omitir el paso de recuperación. La generación aumentada por recuperación como técnica fue presentada por Lewis et al. en 2020, y combina un paso de búsqueda con un modelo de lenguaje para que la salida esté fundamentada en material fuente específico y verificable, y no en conocimiento general de entrenamiento. Gartner reconoció lo central que esto se ha vuelto para la AI empresarial al publicar, en septiembre de 2025, una Market Guide dedicada a la búsqueda empresarial con AI (Enterprise AI Search), que identifica la convergencia de la búsqueda, el RAG y la agentic AI como un motor principal del mercado.
Esa página del glosario cubre la mecánica en profundidad: embeddings vectoriales, el pipeline de recuperación, el chunking. El patrón RAG Assistant también cubre a fondo el caso de uso independiente, un chatbot que recupera una vez y responde, con sus propias cifras de ROI y su desglose de modos de fallo. Esta página trata algo más acotado: cómo encaja la recuperación dentro de un agent que además razona, usa herramientas y actúa, y no solo un bot de preguntas y respuestas que responde y se detiene.
Por qué un agent necesita recuperación y no solo un prompt más grande
El atajo tentador es omitir la recuperación y pegar directamente en el prompt todo lo que el agent podría necesitar. Eso se rompe rápido, por tres razones.
Primero, el conocimiento de entrenamiento queda obsoleto el día en que se congela. Un modelo entrenado hace meses no sabe que su política de devoluciones cambió la semana pasada ni que el contrato de un cliente se renovó ayer. La recuperación extrae de una fuente viva, de modo que la respuesta nunca es más antigua que su última actualización de documentos.
Segundo, una ventana de contexto más grande no es un pase libre. Meter una knowledge base completa en cada prompt cuesta más en tokens y en latencia en cada llamada, y la investigación sobre el rendimiento con contextos largos ha encontrado repetidamente que los modelos no aprovechan por igual todo lo que hay en un contexto grande. La información relevante se pasa por alto con más frecuencia cuanto más enterrada está, sobre todo en medio de una entrada larga. La recuperación resuelve esto entregándole al modelo solo el puñado de fragmentos realmente relevantes para esta pregunta específica, en lugar de todo lo que usted posee. La memoria de los AI agents explica en más detalle esta limitación de la ventana de contexto, ya que es tanto un problema de memoria como de recuperación.
Tercero, la recuperación supera al fine-tuning para todo lo que cambia. El fine-tuning incorpora el conocimiento en los pesos de un modelo, es costoso de repetir y vuelve a quedar obsoleto en cuanto cambia un documento fuente. La recuperación lee de la fuente en el momento de la pregunta, así que la próxima vez que alguien pregunte, ya tiene la actualización.
Dónde se ubica la recuperación en el ciclo del agent
Un agent no recupera una sola vez al principio y se detiene. La recuperación suele ocurrir durante el paso de percibir, cuando el agent reúne el contexto que necesita para actuar, y en realidad es una llamada a una herramienta como cualquier otra: "buscar en la knowledge base" figura en la lista de herramientas del agent junto a "consultar el CRM" y "agendar la reunión".
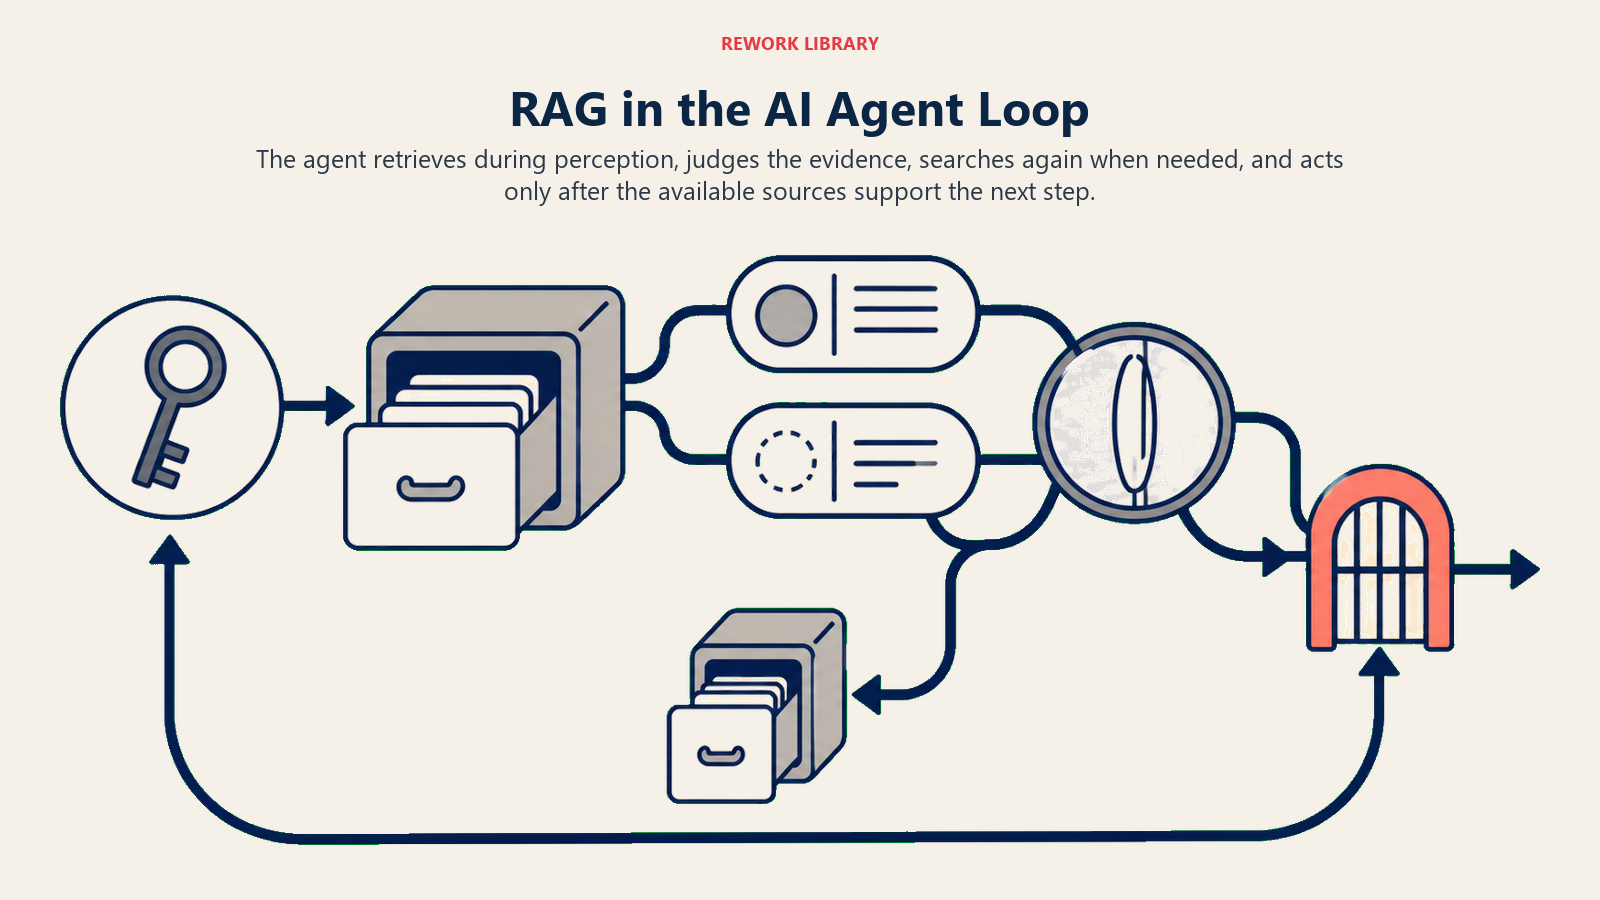
Aquí se nota la diferencia entre un chatbot RAG independiente y un agent que usa RAG. Un asistente independiente recupera una vez y responde. Un agent puede revisar lo que obtuvo, notar que el resultado es incompleto o contradictorio, recuperar de nuevo con una consulta más acotada y solo entonces decidir qué hacer. Ese ciclo, recuperar, razonar sobre lo que volvió, quizás recuperar otra vez y luego actuar, es lo que lo hace agentic y no una consulta de un solo intento.
RAG, herramientas y memoria: cómo elegir la fundamentación adecuada
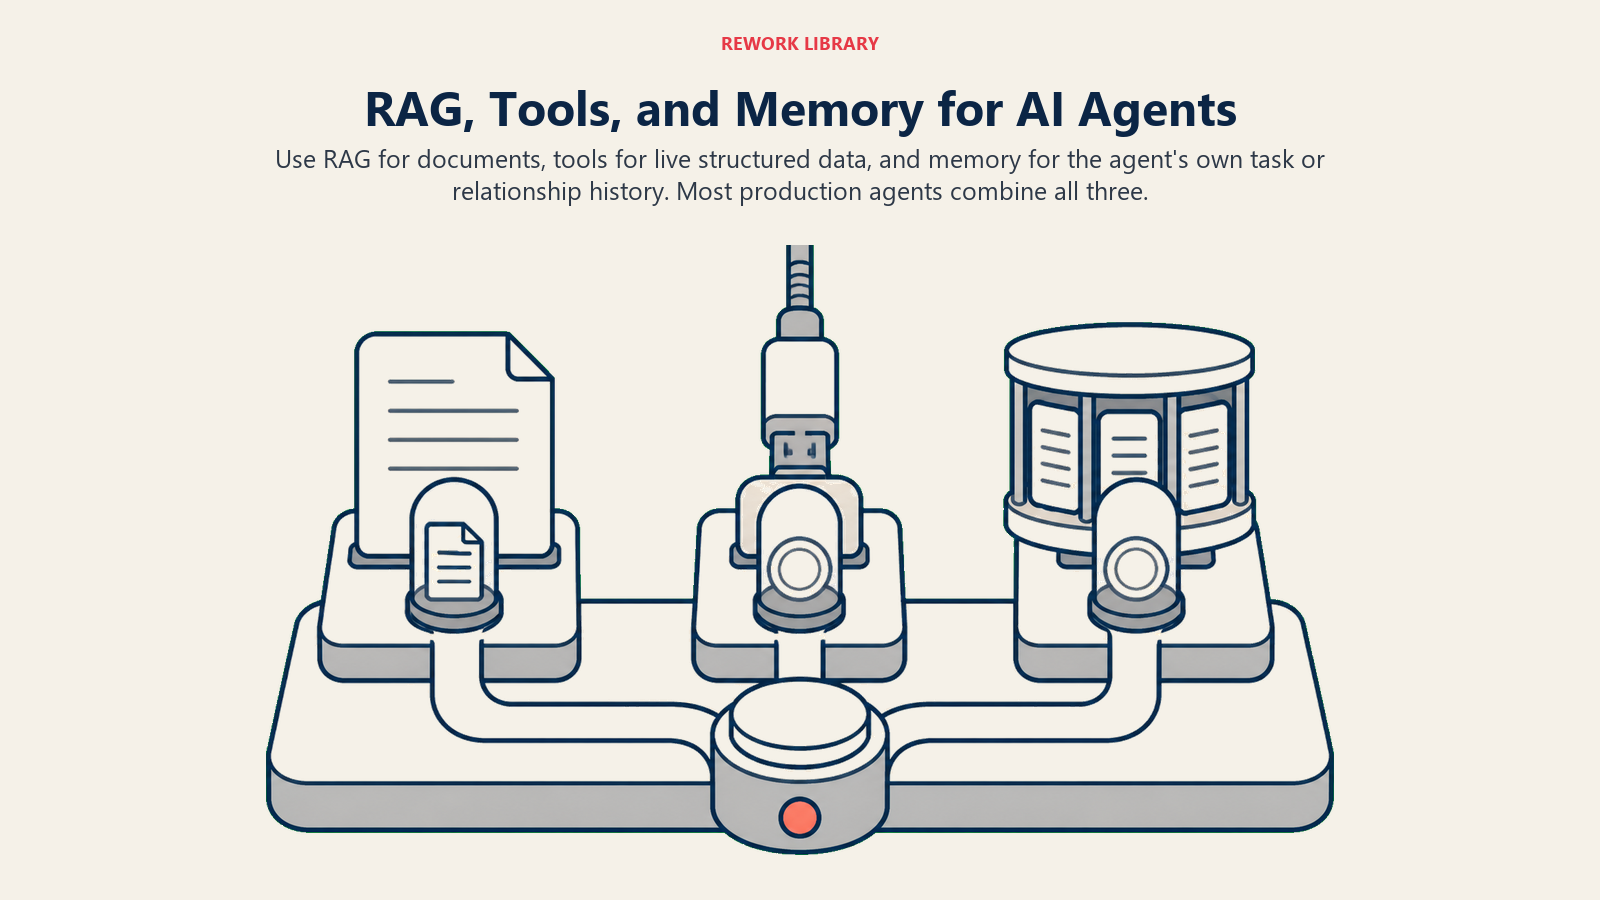
No todo dato que un agent necesita vive en un documento. Saber qué mecanismo de fundamentación corresponde a cada tipo de información evita que construya lo que no debe.
| Fuente de fundamentación | Mejor uso | Ejemplo | Qué tan actual es la respuesta |
|---|---|---|---|
| RAG (recuperación) | Conocimiento no estructurado: políticas, wikis, contratos, documentación | "¿Cuál es nuestra política de licencia parental?" | Tan reciente como la última actualización del documento |
| Herramientas y APIs | Datos estructurados, transaccionales y en tiempo real | "¿Cuál es el nivel de cuenta de este cliente?" o "¿Está libre el jueves a las 2 p. m.?" | En vivo, en el momento de la llamada |
| Memoria | El propio historial del agent con esta tarea o este usuario | "¿Ya le propuse un horario a este prospecto?" | Específica de esta ejecución o relación |
La mayoría de los agents en producción usan dos o tres de estas fuentes a la vez. El AI Knowledge Base Agent recupera de su centro de ayuda (RAG), consulta el nivel de cuenta y la versión del cliente mediante el CRM (una llamada a una herramienta) y recuerda si esa misma pregunta ya surgió en esta sesión (memoria) antes de decidir si responde, pregunta o transfiere. Consulte la memoria de los AI agents para ver el lado de corto y largo plazo de esa tercera fila.
Agents fundamentados con RAG en la práctica
El patrón se sostiene con bases de conocimiento muy distintas. Tres ejemplos de esta biblioteca muestran su forma.
El AI Knowledge Base Agent recupera de artículos del centro de ayuda y de wikis internas, responde usando solo lo que encuentra, cita por su nombre el artículo fuente en cada respuesta y, lo que es crucial, marca la pregunta como una brecha de contenido cuando la recuperación vuelve vacía. Cero resultados no es solo un disparador de transferencia, es una señal que le dice a su equipo de contenido exactamente qué escribir a continuación.
El AI Policy Q&A Agent ejecuta el mismo patrón de recuperar y luego citar sobre un corpus distinto: el manual del empleado en lugar de un centro de ayuda de soporte. Responde preguntas de políticas de RR. HH. y de TI estrictamente a partir de lo que está escrito, indica cuán recientemente se actualizó la sección citada y deriva a RR. HH. en cuanto el manual no cubre la pregunta, en lugar de adivinar la política de la empresa.
El AI Contract Review Agent usa la recuperación de otra manera: en lugar de responder una pregunta, recupera su playbook interno (condiciones de pago aceptables, topes de responsabilidad, posiciones de propiedad intelectual) y compara un contrato entrante con él cláusula por cláusula, y pone de manifiesto cada desviación para que una persona decida. La misma mecánica de recuperar y luego fundamentar, aplicada a la comparación en lugar de a las preguntas y respuestas.
Si está comparando plataformas para construir alguno de estos agents, la guía de compra de software de knowledge base y el resumen de herramientas de soporte cubren opciones compatibles con la recuperación que vale la pena revisar.
La mecánica, brevemente
Los documentos fuente se dividen en fragmentos, cada fragmento se convierte en un vector mediante un modelo de embeddings, y esos vectores viven en una base de datos vectorial diseñada para la búsqueda rápida por similitud. Una pregunta se convierte en un vector de la misma manera, el sistema encuentra los fragmentos cuyos vectores están más cerca de ella, y esos fragmentos, no toda la knowledge base, entran en el contexto del modelo junto con la pregunta. El tamaño de los fragmentos, el filtrado por metadatos (departamento, fecha del documento, versión del producto) y la frecuencia con que se actualiza el índice afectan la calidad de las respuestas más que el modelo específico con el que se genera. Para el recorrido completo de los embeddings y la búsqueda vectorial, consulte ¿Qué son las bases de datos vectoriales?
Dónde falla el RAG en un agent
Los mismos modos de fallo que afectan a un asistente RAG independiente afectan aún más a un agent, porque un agent puede actuar sobre una mala recuperación en lugar de simplemente mostrarla.
Una knowledge base obsoleta es el fallo más común y el más difícil de notar, porque el agent igual responde con seguridad. Solo que responde con la política del trimestre pasado. Una knowledge base sin responsable se va desviando, y nadie lo nota hasta que un cliente actúa con información equivocada.
Una cita alucinada es el fallo más peligroso, porque parece un éxito: una respuesta segura con una fuente adjunta que, al revisarla con atención, en realidad no dice lo que el agent afirmó. Es exactamente el tipo de fallo sobre el que advierte el OWASP Top 10 para aplicaciones de LLM bajo el riesgo de desinformación y exceso de confianza: los usuarios confían más en una respuesta con cita que en una sin ella, de modo que una cita equivocada causa más daño que una respuesta simplemente equivocada.
Ambos fallos apuntan a la misma solución: alguien debe ser responsable de la knowledge base, revisarla con una periodicidad y tratar cada recuperación con cero resultados o con baja confianza como una señal que vale la pena investigar, no como ruido que ignorar.
Cuándo el RAG es la herramienta equivocada
La recuperación no resuelve todos los problemas de fundamentación. Si la información cambia cada pocos minutos (inventario en vivo, el calendario de hoy, el saldo de una cuenta en este segundo), una llamada a una herramienta del sistema en vivo supera a la recuperación desde una copia indexada que ya está ligeramente desactualizada para cuando se indexa. Y si los usuarios ya encuentran sin problema el documento correcto, y el verdadero problema es que nadie lo lee, la solución puede ser una mejor búsqueda o un documento más corto, no una capa generativa encima.
La propia guía de Anthropic sobre la construcción de agents plantea la recuperación como una de tres ampliaciones, junto con las herramientas y la memoria, que convierten un modelo simple en algo capaz de hacer realmente un trabajo. Ninguna de las tres sustituye a las otras dos. Un agent que solo recupera puede responder preguntas pero no puede actuar. Un agent que solo llama a herramientas puede actuar pero no puede explicar una política que nunca se le dio. La mayoría de los agents bien construidos necesitan las tres, dimensionadas según lo que cada parte de la tarea realmente requiere.
Datos clave
- El RAG fundamenta las respuestas y acciones de un AI agent en documentos y datos reales, en lugar del conocimiento de entrenamiento congelado de un modelo, al recuperar fragmentos relevantes antes de generar una respuesta.
- Dentro de un agent, la recuperación suele ser una llamada a una herramienta que el agent hace durante su paso de percibir, y un agent capaz puede recuperar, evaluar lo que obtuvo y recuperar de nuevo antes de actuar.
- El conocimiento en documentos requiere RAG, los datos estructurados en vivo requieren una llamada a una herramienta o API, y el historial de tareas del propio agent requiere memoria. La mayoría de los agents reales combinan las tres.
- El fallo más peligroso del RAG es una cita alucinada: una respuesta segura con una fuente adjunta que en realidad no respalda la afirmación, y por eso importan tanto como la propia tecnología de recuperación un responsable de contenido designado y una cadencia de revisión.
Preguntas frecuentes sobre el RAG para AI agents
¿Qué es el RAG en el contexto de un AI agent?
El RAG (generación aumentada por recuperación) es la forma en que un AI agent fundamenta sus respuestas y acciones en documentos y datos reales. En lugar de apoyarse en lo que un modelo aprendió durante el entrenamiento, el agent busca en una knowledge base, recupera el material más relevante y genera su siguiente paso a partir de ese contenido recuperado, citando la fuente.
¿El RAG es lo mismo que un AI agent?
No. El RAG es una técnica de fundamentación, no un agent por sí mismo. Un asistente RAG independiente recupera una vez y responde una pregunta. Un AI agent puede usar el RAG como una de varias herramientas: recuperar, razonar sobre lo que encontró, a veces recuperar de nuevo y luego realizar una acción, lo que es un ciclo más amplio que el que cubre la recuperación por sí sola.
¿Cuándo necesita un agent RAG en lugar de una llamada normal a una herramienta o API?
Use RAG para el conocimiento no estructurado que vive en documentos: políticas, wikis, contratos, documentación de producto. Use una llamada a una herramienta o API para datos estructurados y en tiempo real, como el saldo de una cuenta, un espacio de calendario o el estado de un pedido. La mayoría de los agents necesitan ambos, dirigidos a distintos tipos de información.
¿En qué se diferencia el RAG para un agent del patrón RAG Assistant?
El patrón RAG Assistant describe un chatbot independiente que recupera y responde, nada más. El RAG para un agent describe la recuperación como una entrada dentro de un ciclo más amplio que además razona, llama a otras herramientas, recuerda los pasos previos y actúa. La mecánica de recuperación es la misma. Lo que la rodea no lo es.
¿Cuál es el mayor riesgo de usar RAG dentro de un agent autónomo?
Una cita alucinada, en la que el agent genera una respuesta segura y cita una fuente que en realidad no contiene esa afirmación, y luego actúa en consecuencia. Como un agent puede realizar acciones reales y no solo mostrar una respuesta, este modo de fallo puede llevarlo a actuar con información que nunca existió realmente. Las verificaciones puntuales periódicas, a cargo de un responsable designado de la knowledge base, lo detectan antes de que se agrave.
A dónde ir a continuación
La recuperación es una de las tres formas en que un agent se ancla en la realidad, junto con las herramientas y la memoria. Si el problema de conocimiento de su agent es en realidad un problema de "recordar lo que ya pasó" y no de "encontrar un documento", la memoria de los AI agents lo cubre directamente. Y una vez integrada la recuperación, cómo evaluar y probar AI agents explica cómo detectar una mala recuperación o una cita alucinada antes de que llegue a un cliente.

On this page
- El RAG en una frase, para un agent
- Por qué un agent necesita recuperación y no solo un prompt más grande
- Dónde se ubica la recuperación en el ciclo del agent
- RAG, herramientas y memoria: cómo elegir la fundamentación adecuada
- Agents fundamentados con RAG en la práctica
- La mecánica, brevemente
- Dónde falla el RAG en un agent
- Cuándo el RAG es la herramienta equivocada
- Datos clave
- A dónde ir a continuación