Red teaming de AI agents: pruebas adversariales para sistemas autónomos
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Hacer red teaming a un AI agent significa atacarlo deliberadamente antes de que lo haga un adversario real: alimentarlo con documentos envenenados, instrucciones ambiguas y casos límite diseñados para que haga un mal uso de una herramienta, filtre datos o actúe fuera de su alcance, y luego documentar exactamente qué se rompió. Va más allá del red teaming de un chatbot o de un modelo simple, porque un agent que cae en un ataque no solo genera una mala frase, puede llamar a una herramienta y convertir el error en una acción real. Este artículo explica qué cambia cuando el sistema bajo prueba puede actuar, la superficie de ataque propia de los agents y cómo construir un hábito de pruebas a su alrededor en lugar de un evento único antes del lanzamiento.
En qué se diferencia del red teaming de un modelo
El AI red teaming como práctica general ya abarca los prompts adversariales, los intentos de jailbreak y la evaluación de seguridad de cualquier sistema de AI, y todo lo de esa disciplina sigue aplicando a un agent en el fondo. Lo que cambia es la superficie que usted ataca. El red teaming de un modelo simple prueba lo que dirá: ¿puede lograr que produzca contenido dañino, filtre datos de entrenamiento o contradiga su entrenamiento de seguridad? El red teaming de un agent prueba lo que hará: ¿puede lograr que llame a una herramienta que no debería, actúe sobre un dato en el que nunca debió confiar o complete una tarea de varios pasos de una manera que hace silenciosamente lo incorrecto mientras parece exitosa?
Esa distinción se corresponde con el límite entre Generate y Execute que atraviesa el diseño de agents en general. Un modelo engañado para dar un mal paso de Generate produce un mal párrafo que alguien puede detectar antes de que importe. Un agent engañado para dar un mal paso de Execute ya envió el correo, emitió el reembolso o cambió el registro. El red teaming de un agent es específicamente la práctica de probar el paso de Execute bajo presión adversarial, no solo el razonamiento que lleva hasta él.
La superficie de ataque propia de los agents
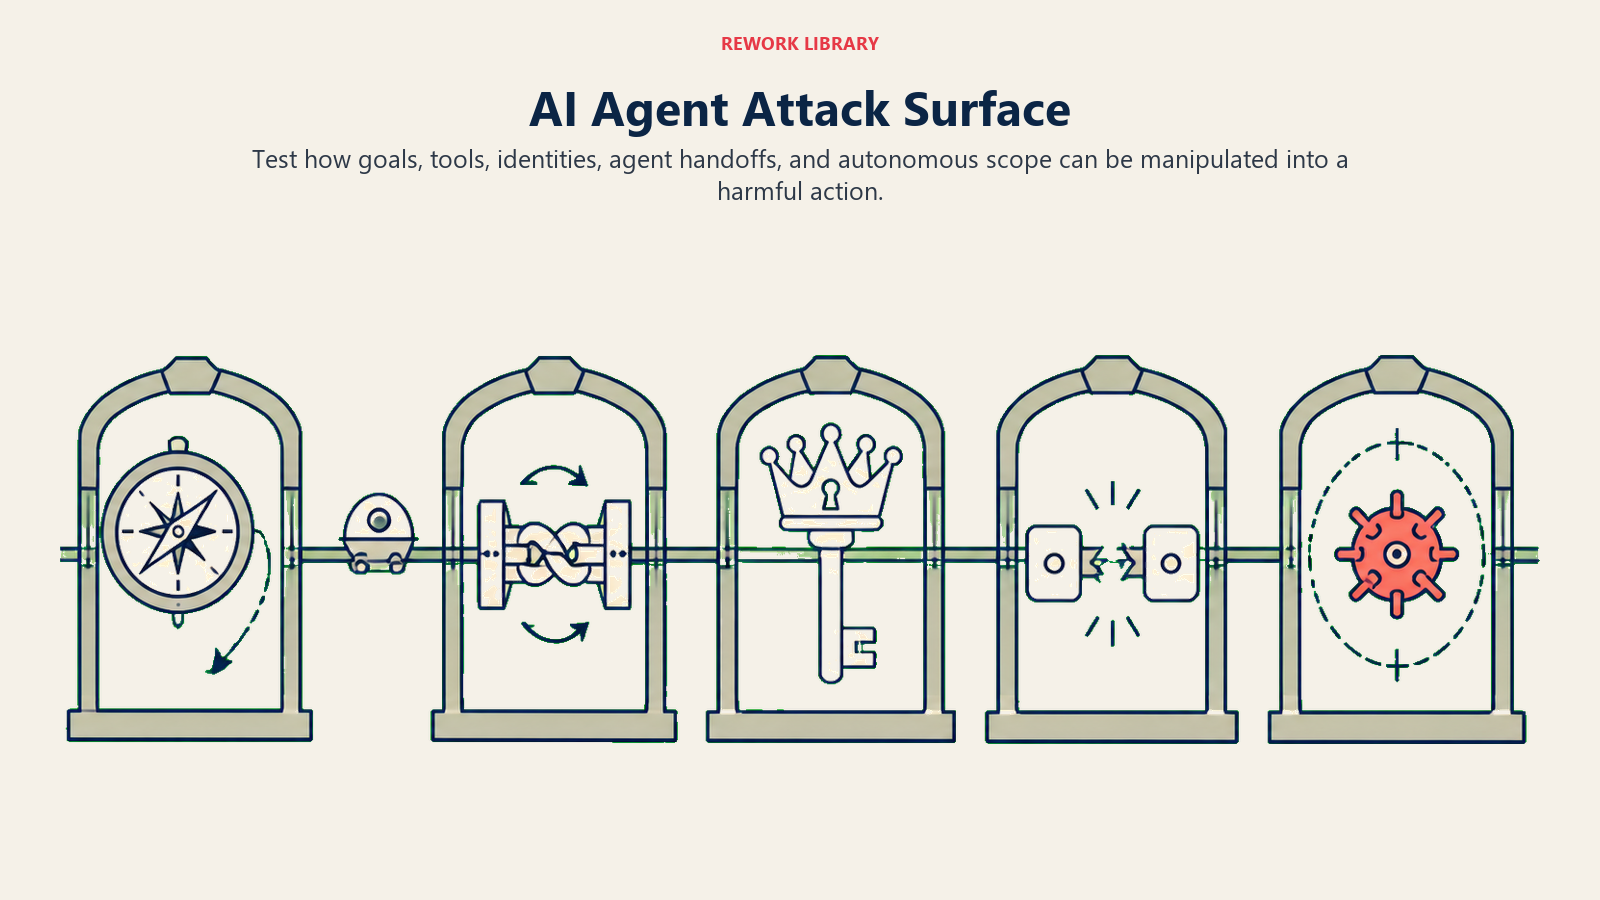
El OWASP Top 10 para aplicaciones agentic 2026, elaborado con la colaboración de más de 100 expertos, investigadores y profesionales de la industria, nombra categorías de riesgo que vale la pena probar de forma específica porque no aparecen en un red team centrado solo en el modelo. Algunas que se corresponden directamente con planes de construcción reales de agents:
| Categoría de riesgo | Qué prueba | Dónde aparece |
|---|---|---|
| Secuestro del objetivo | ¿Pueden unas instrucciones ocultas en el contenido que lee el agent redirigir su tarea real? | Un agent que responde solo a partir de una knowledge base, engañado por un documento envenenado para que recomiende lo incorrecto |
| Mal uso de herramientas | ¿Puede una entrada ambigua hacer que el agent llame a la herramienta correcta de la manera incorrecta, o encadene herramientas hasta un resultado no previsto? | Un AI Invoice AP Agent manipulado para emparejar una factura con la orden de compra equivocada |
| Abuso de identidad y privilegios | ¿Se puede empujar al agent a reutilizar credenciales o a escalar el acceso más allá de su tarea? | Un AI Access Provisioning Agent engañado para conceder un acceso elevado que debió señalar |
| Fallos en cascada | ¿La mala salida de un agent se convierte en la mala entrada de otro en una configuración multiagente? | Transferencias dentro de un sistema multiagente que no validan lo que reciben |
| Comportamiento rebelde | ¿Un agent comprometido se mantiene dentro de su alcance autorizado mientras persigue en silencio el objetivo equivocado? | Si un AI Security Monitoring Agent detectaría realmente que esto ocurre en otro lugar |
La mecánica del punto de entrada más común, el prompt injection, se explica en profundidad en otra parte de esta biblioteca. El trabajo de un red team con ese riesgo en particular no es volver a explicarlo. Es demostrar si sus defensas reales contra él resisten.
Qué hace distinto una prueba adversarial real
Un red team que solo prueba el ataque obvio una vez y sigue adelante pasará por alto casi todo lo que importa. La nota de investigación de 2026 de Cloud Security Alliance sobre la guía de red teaming de agents de AI del NIST encontró que las técnicas de ataque nuevas y específicas para agents lograron una tasa de éxito del 81% en el secuestro de tareas, frente a solo el 11% de los ataques base conocidos más fuertes. Probar un agent con patrones de ataque genéricos y públicamente conocidos subestima de forma drástica lo expuesto que está en realidad.
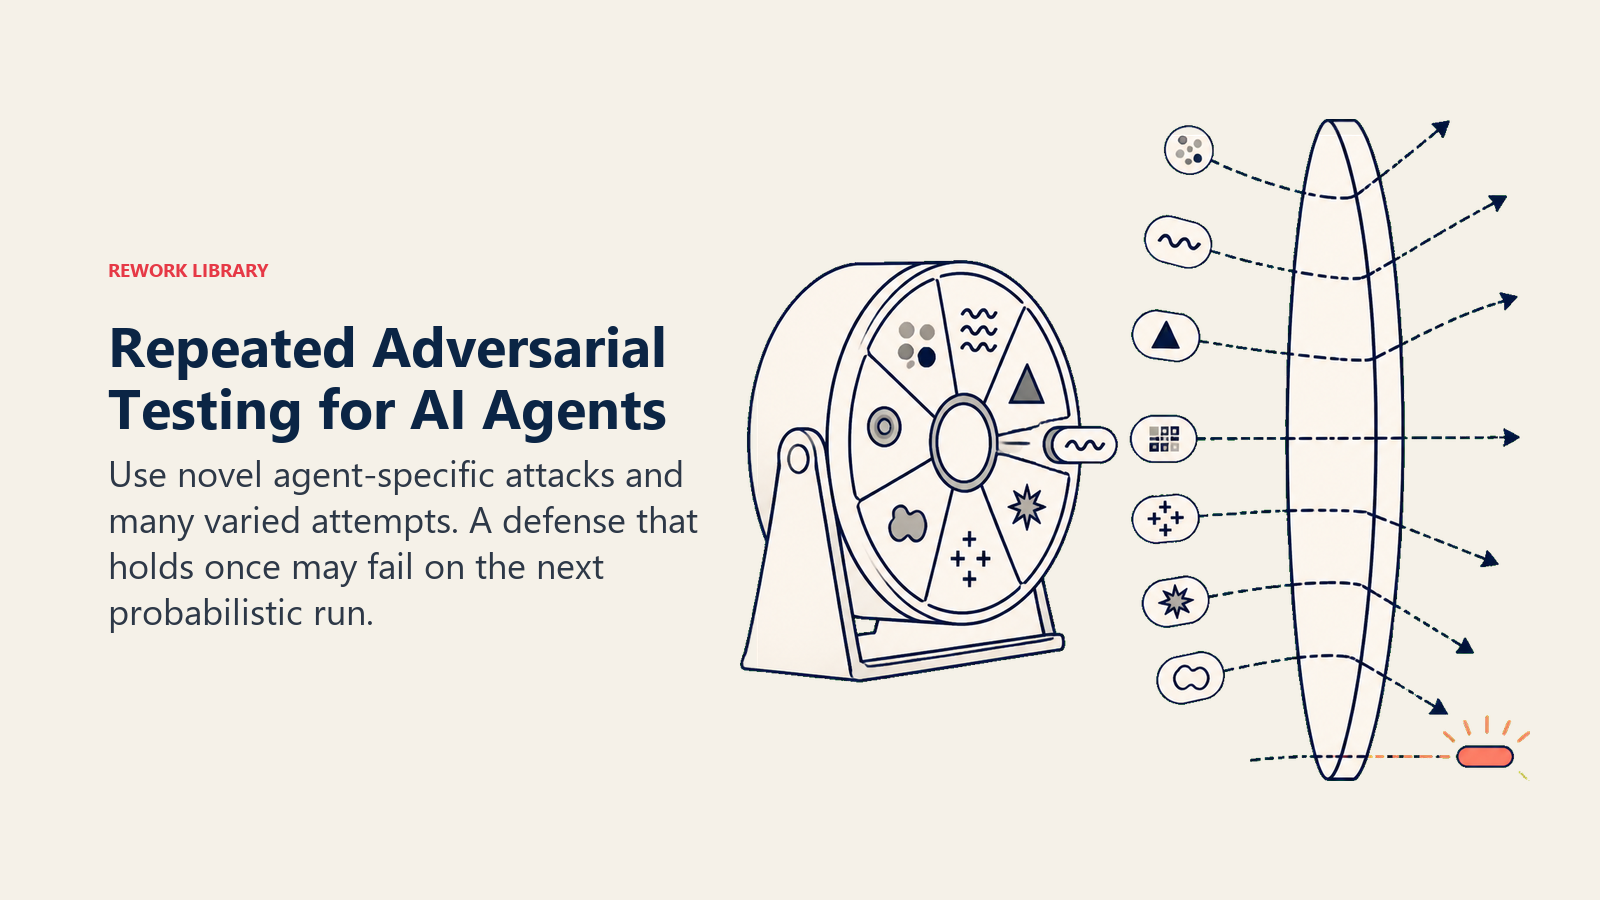
La repetición importa tanto como la técnica. La misma investigación encontró tasas de éxito de un solo intento con un promedio del 57%, que subían al 80% cuando un integrante del red team tenía 25 intentos repetidos sobre la misma tarea. Los agents son probabilísticos, de modo que una defensa que resistió una vez puede fallar en el siguiente intento con una redacción ligeramente distinta. El propio programa piloto del NIST detrás de estos datos, ARIA, reunió a unos 51 integrantes de red team en 508 sesiones de prueba sobre siete aplicaciones de AI presentadas, una referencia útil de cómo se ven las pruebas realmente rigurosas frente a una revisión interna rápida.
Algunas técnicas que vale la pena incorporar a sus propias pruebas, sin importar la escala:
- Envenene el contenido, no la conversación. Oculte el ataque en un documento, correo o página web que se le pida procesar al agent, tal como llegaría un injection indirecto real, en lugar de escribirlo directamente en un cuadro de chat.
- Pruebe la transferencia, no solo el rechazo. No se limite a comprobar si el agent bloquea una mala acción. Verifique si reconoce correctamente los casos que deberían escalarse a una persona e intente construir un caso diseñado para parecer rutinario cuando en realidad requiere criterio.
- Ataque la memoria, no solo un turno aislado. Introduzca un dato falso al inicio de una sesión o tarea y compruebe si el agent sigue confiando en él varios pasos después.
- Repita el intento. Una sola pasada no dice casi nada sobre un sistema probabilístico. Ejecute el mismo patrón de ataque varias veces con pequeñas variaciones antes de concluir que una defensa resiste.
Manual, automatizado y continuo, aplicados a los agents
La práctica general del red teaming ya distingue las pruebas manuales (una persona que ataca el sistema con creatividad), las automatizadas (variantes de ataque generadas y ejecutadas a escala) y las continuas (permanentes, no una compuerta de una sola vez). Para los agents en particular, las tres se ganan su lugar en momentos distintos.
Ejecute una pasada manual antes del lanzamiento, centrada en los escenarios específicos del manual de escenarios de su propio agent, los casos que su equipo realmente espera que maneje. Una biblioteca de ataques genérica detecta debilidades genéricas; una pasada manual de alguien que conoce el trabajo real del agent detecta las propias de su despliegue. Agregue pruebas automatizadas de mayor escala una vez que tenga una línea base, ya que pueden ejecutar muchas más variaciones de las que una persona tiene tiempo de probar. Luego siga probando de forma programada, no solo una vez. Vuelva a probar después de cualquier cambio en el prompt, la lista de herramientas o el modelo subyacente, porque una defensa que resistió frente a la versión del modelo del trimestre pasado puede fallar en silencio frente a esta. El Perfil de AI generativa AI 600-1 del NIST lo plantea dentro de su función MEASURE: la gestión de riesgos no está completa hasta que se haya probado si un control resiste bajo presión adversarial, y no solo confirmado que existe sobre el papel. Para los agents con acceso de escritura a dinero, datos de clientes o comunicaciones externas, una frecuencia trimestral es un piso razonable, no un techo.
Cómo convertir los hallazgos en correcciones
Un informe de red team que no cambia la configuración del agent es un documento, no una defensa. Cada hallazgo real debería asociarse con uno de los seis componentes básicos con los que se construye un agent: una herramienta cuyo alcance resultó demasiado amplio se acota, se agrega una barrera de protección que faltaba, se endurece una regla de lógica de decisión que dejó pasar un mal caso, o se incorpora de forma explícita al manual de escenarios un escenario que debió escalarse y no lo hizo.
Las barreras de protección para AI agents explican el principio de la lista de permitidos sobre la lista de denegados que la mayoría de los hallazgos de un red team terminan reforzando: es más fácil y seguro enumerar exactamente lo que un agent puede hacer que intentar listar todo lo que no debería. Y cuando un hallazgo revela un caso que realmente necesita criterio y no una regla más estricta, es una señal para un punto de control con intervención humana, no para una barrera de protección más complicada que intente codificar un criterio que en realidad no puede ejercer. La regla Audit-Or-Block del patrón Autonomous Agent es una red de seguridad útil para todo lo que un red team no puede despejar por completo: si el agent no puede producir una traza completa de la decisión para una acción, no debería poder emprender esa acción por sí solo, sin importar cómo haya salido la prueba.
Cómo construir un hábito de pruebas sin un equipo de seguridad dedicado
La mayoría de los equipos que construyen sus primeros agents no tienen un red team en plantilla, y eso no es una razón para omitir esto. Empiece con el agent de mayores consecuencias que opera, el que toca dinero, datos de clientes o envía comunicaciones externas, y haga que alguien intente romperlo deliberadamente con casos históricos reales antes del lanzamiento: ¿cuál es la peor entrada que realistamente podría recibir y qué hace el agent con ella? Ese único ejercicio, hecho con honestidad, detecta más de lo que la mayoría de los equipos espera.
A partir de ahí, los servicios externos de red teaming y las herramientas de pruebas adversariales automatizadas pueden ampliar la cobertura sin que usted tenga que construir la capacidad internamente, sobre todo cuando ya opera tantos agents que las pruebas manuales por sí solas no alcanzan. Si está evaluando plataformas para construir o alojar agents, pregunte directamente cómo respaldan este tipo de pruebas antes de comprometerse. Nuestras comparaciones de herramientas de desarrollo y cómo elegir una plataforma de DevOps cubren las preguntas de pruebas y de pipeline que vale la pena hacer sin importar qué plataforma de agents elija.
Datos clave
- El OWASP Top 10 para aplicaciones agentic 2026 se elaboró con más de 100 expertos de la industria y nombra riesgos, como el secuestro del objetivo, el mal uso de herramientas y los fallos en cascada, que no aparecen en un red team centrado solo en el modelo.
- Las técnicas de ataque específicas para agents lograron una tasa de éxito del 81% en el secuestro de tareas en pruebas vinculadas al NIST, frente al 11% de los ataques base conocidos, lo que muestra que el red teaming genérico subestima gravemente la exposición real.
- Las mismas pruebas encontraron tasas de éxito de un solo intento de alrededor del 57%, que subían al 80% con 25 intentos repetidos, y por eso probar un agent una vez y darlo por despejado no es una prueba real.
- El programa piloto ARIA del NIST reunió a unos 51 integrantes de red team en 508 sesiones sobre siete aplicaciones de AI, un punto de referencia útil de cómo se ve la escala de pruebas rigurosas.
- Un hallazgo del red team solo importa si cambia las herramientas, las barreras de protección, la lógica de decisión o el manual de escenarios del agent. Vuelva a probar después de cualquier cambio en el prompt, las herramientas o el modelo, no solo una vez antes del lanzamiento.
Preguntas frecuentes sobre el red teaming de AI agents
¿Qué es el red teaming para AI agents?
Es la práctica de atacar deliberadamente a un agent antes de que lo haga un adversario real: probar si un contenido envenenado, unas instrucciones ambiguas o unos casos límite pueden hacer que haga un mal uso de una herramienta, filtre datos o actúe fuera de su alcance previsto, y luego corregir lo que se rompe.
¿En qué se diferencia el red teaming de un agent del de un chatbot o un modelo?
El red teaming de un modelo prueba lo que un sistema dirá. El red teaming de un agent prueba lo que hará, ya que un agent que cae en un ataque puede llamar a una herramienta y convertir el error en una acción real, no solo en una mala respuesta que alguien detecta antes de que importe.
¿Qué es el OWASP Top 10 para aplicaciones agentic?
Un marco, elaborado con más de 100 expertos de la industria, que nombra los riesgos de seguridad propios de los sistemas de AI autónomos: el secuestro del objetivo, el mal uso de herramientas, el abuso de privilegios, los fallos en cascada entre agents y el comportamiento de agents rebeldes, entre otros. Es una lista de verificación útil para definir qué debería probar realmente un red team específico para agents.
¿Con qué frecuencia se debe hacer red teaming a un agent?
Como mínimo antes del lanzamiento, y de nuevo después de cualquier cambio significativo en el prompt, la lista de herramientas o el modelo subyacente. Para los agents con acceso a dinero, datos de clientes o comunicaciones externas, una nueva prueba trimestral es un piso razonable.
¿Se necesita un equipo de seguridad dedicado para hacer red teaming a un agent?
No. Empiece haciendo que alguien intente romper deliberadamente su agent de mayores consecuencias con casos históricos reales antes del lanzamiento. Los servicios externos de red teaming y las herramientas de pruebas adversariales automatizadas pueden ampliar la cobertura a partir de ahí, a medida que usted opere más agents de los que las pruebas manuales por sí solas pueden cubrir.
A dónde ir a continuación
El red teaming le dice dónde se rompen realmente las defensas de un agent. El prompt injection es el ataque específico que conviene entender a fondo primero, ya que es el punto de entrada detrás de la mayoría de los hallazgos que arroja un red team. Las barreras de protección para AI agents son el lado de implementación, lo que usted realmente está probando y reforzando, y la observabilidad de los AI agents es la forma de detectar lo que un red team pasó por alto una vez que el agent está en producción.

On this page
- En qué se diferencia del red teaming de un modelo
- La superficie de ataque propia de los agents
- Qué hace distinto una prueba adversarial real
- Manual, automatizado y continuo, aplicados a los agents
- Cómo convertir los hallazgos en correcciones
- Cómo construir un hábito de pruebas sin un equipo de seguridad dedicado
- Datos clave
- A dónde ir a continuación