Cómo razonan los AI agents: ReAct, planificación y reflexión
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Un AI agent razona alternando entre pensar y actuar: escribe un breve pensamiento sobre qué hacer a continuación, ejecuta una acción, normalmente una llamada a una herramienta, lee lo que ocurrió y vuelve a pensar antes de su siguiente movimiento. Ese patrón intercalado se llama ReAct, y es la base sobre la que se construyen la mayoría de los agents. Dos técnicas lo extienden aún más: la planificación, en la que el agent traza varios pasos antes de ejecutar cualquiera de ellos, y la reflexión, en la que critica su propio intento y vuelve a probar cuando el primer resultado no basta.
El razonamiento es el paso "Reason" del ciclo, hecho visible
Cómo funcionan los AI agents describe el ciclo del agent como percibir, razonar, actuar, observar y repetir. Este artículo trata de lo que ocurre dentro del paso de razonar, y es menos misterioso de lo que suena. "Razonar" aquí significa que el modelo genera texto intermedio sobre su propio siguiente movimiento antes de comprometerse con una acción, en la misma conversación, donde usted puede leerlo. No es un proceso oculto que ocurre en otro lugar. Un agent de soporte que decide cómo manejar un ticket podría generar algo como "este mensaje menciona un pago fallido y un tono molesto, así que debo revisar el historial de la transacción antes de redactar una respuesta" antes de llamar a cualquier herramienta.
Ese hábito de escribir los pasos intermedios del razonamiento se llama chain-of-thought, y es el componente básico que sustenta todo lo de este artículo. Qué es chain-of-thought cubre la técnica por sí sola. Lo que sigue aquí trata específicamente de cómo ese razonamiento se integra en un ciclo que además ejecuta acciones reales, lo cual es un problema distinto de razonar sobre una pregunta estática.
ReAct: razonar y actuar en el mismo ciclo
ReAct, abreviatura de "reasoning and acting" (razonar y actuar), proviene de un artículo de 2022 de Yao y colegas que mostró que los modelos de lenguaje rinden mejor cuando intercalan pasos breves de razonamiento con acciones, en lugar de razonar hasta una respuesta final y solo entonces actuar, o actuar sin ningún razonamiento. El patrón es simple: Thought (pensamiento), luego Action (acción), luego Observation (observación), repetido hasta terminar la tarea. El pensamiento explica lo que el agent intenta resolver a continuación, la acción suele ser una llamada a una herramienta y la observación es lo que devolvió.
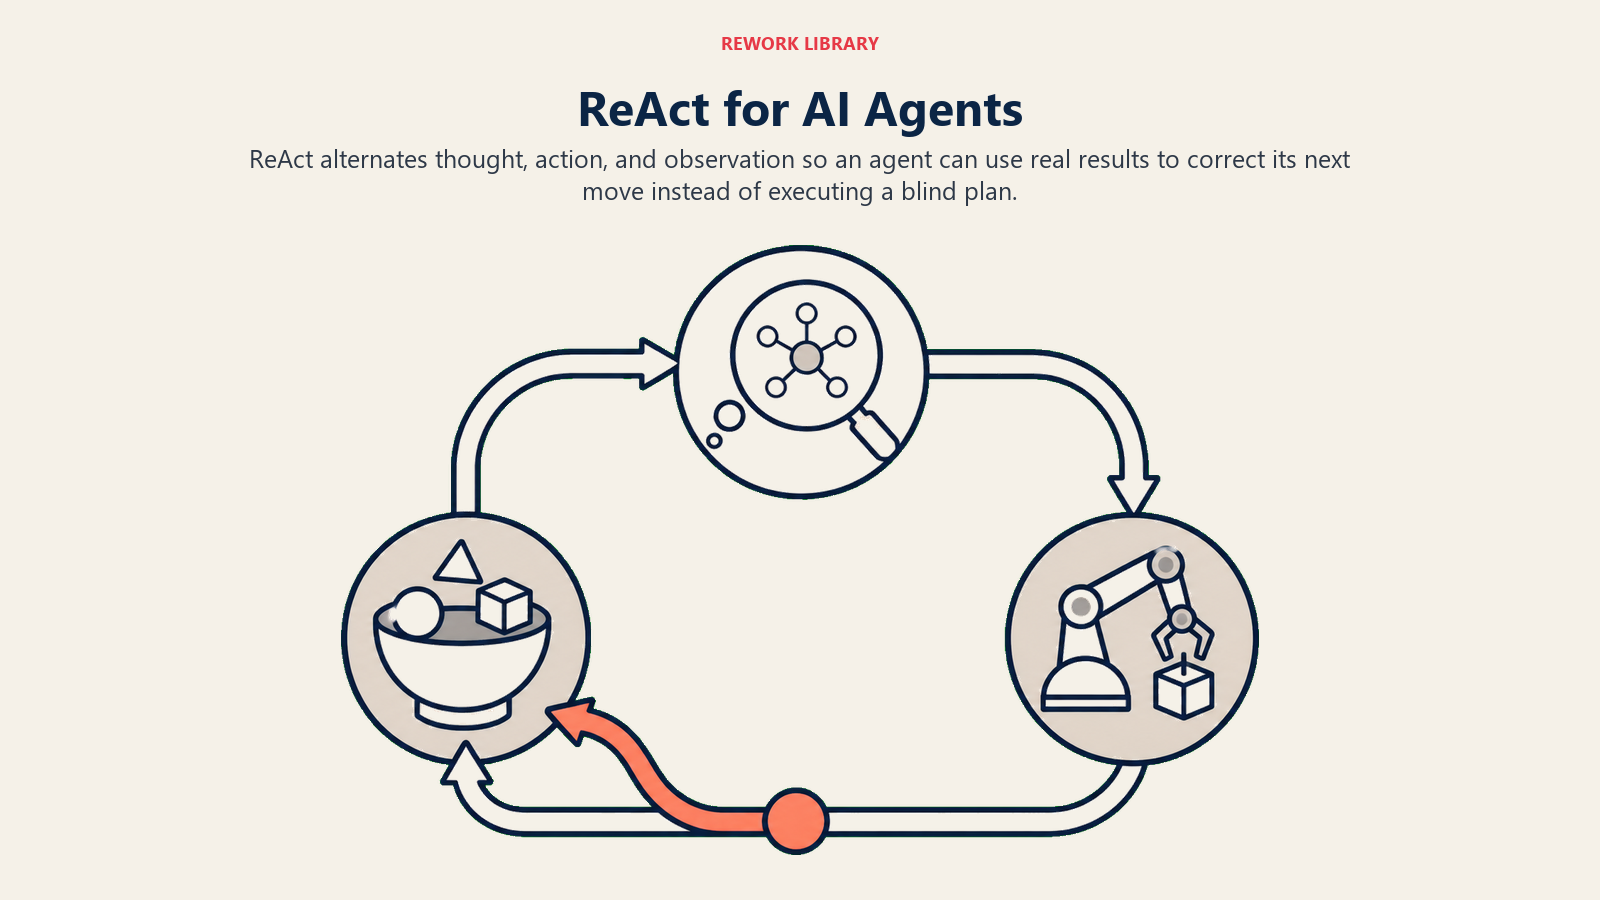
Los resultados de la investigación original fueron sustanciales. En dos benchmarks que ponen a prueba la toma de decisiones interactiva, ALFWorld y WebShop, ReAct superó a las referencias de imitation learning y reinforcement learning por 34 puntos porcentuales (71% frente a 37%) y por aproximadamente 11 puntos porcentuales (40% frente a 29,1%), usando solo uno o dos ejemplos para demostrar el patrón. La razón por la que intercalar funciona mejor que planificar todo por adelantado y ejecutar a ciegas es sencilla: el agent puede corregir el rumbo según lo que realmente ocurrió, no según lo que supuso que ocurriría. Si una búsqueda no devuelve nada útil, el siguiente pensamiento puede decirlo y probar otra consulta, en lugar de seguir adelante con un plan construido a partir de una suposición.
Este es el mismo mecanismo detrás del ciclo descrito en el patrón Autonomous Agent: ingerir el estado actual, analizar lo que se sabe y lo que falta, predecir la mejor acción siguiente, generarla, ejecutarla y repetir. ReAct es la mitad de razonamiento de ese ciclo hecha concreta.
Planificación: pensar varios pasos por adelantado
El ReAct puro improvisa un paso a la vez, lo cual funciona bien en tareas donde el siguiente movimiento correcto solo se aclara después de ver el último resultado. Algunas tareas se benefician de más estructura. La planificación hace que el agent descomponga un objetivo en un conjunto ordenado de subpasos antes de ejecutar cualquiera de ellos, algo más parecido a escribir un esquema antes de redactar que a inventar el texto frase por frase.
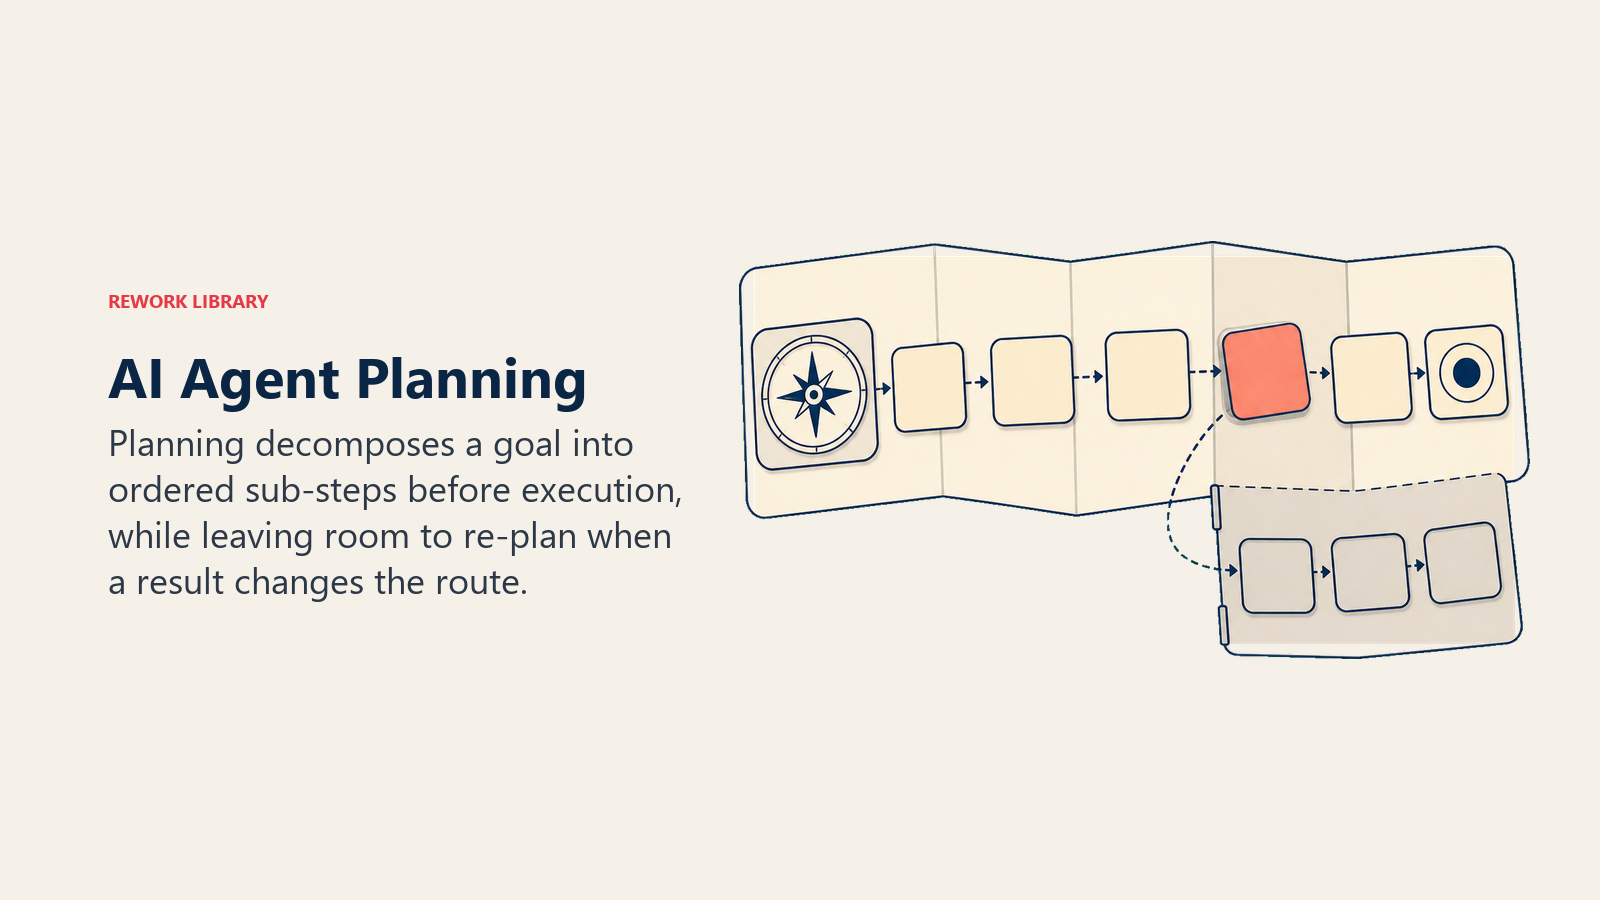
Una tarea de pronóstico de ingresos es un buen ejemplo. En lugar de improvisar una consulta a la vez, un agent construido sobre el plan del AI Forecasting Agent se beneficia de planificar primero su enfoque: obtener las tasas históricas de cierre por segmento, revisar la cobertura actual del pipeline, ponderar los deals abiertos según su etapa y luego combinarlos en un rango. Cada uno de esos subpasos podría ejecutar internamente su propio ciclo ReAct, pero la forma general se decidió de antemano en lugar de descubrirse paso a paso.
La planificación no es un compromiso de una sola vez. Cuando un paso falla o nueva información cambia el panorama, un agent bien construido replanifica en lugar de forzar el plan original. Una extensión que vale la pena conocer es el razonamiento tree-of-thought, en el que el agent explora más de un plan candidato y los compara antes de decidirse, útil cuando de verdad hay más de un enfoque razonable. Qué son los modelos de razonamiento cubre ese terreno con más profundidad, junto con el cambio más amplio hacia modelos que dedican más cómputo a deliberar antes de responder.
Reflexión: detectar sus propios errores
La reflexión añade una capacidad distinta: tras producir un intento, el agent evalúa su propia salida frente al objetivo y la corrige cuando se queda corta, en lugar de tratar el primer borrador como definitivo.
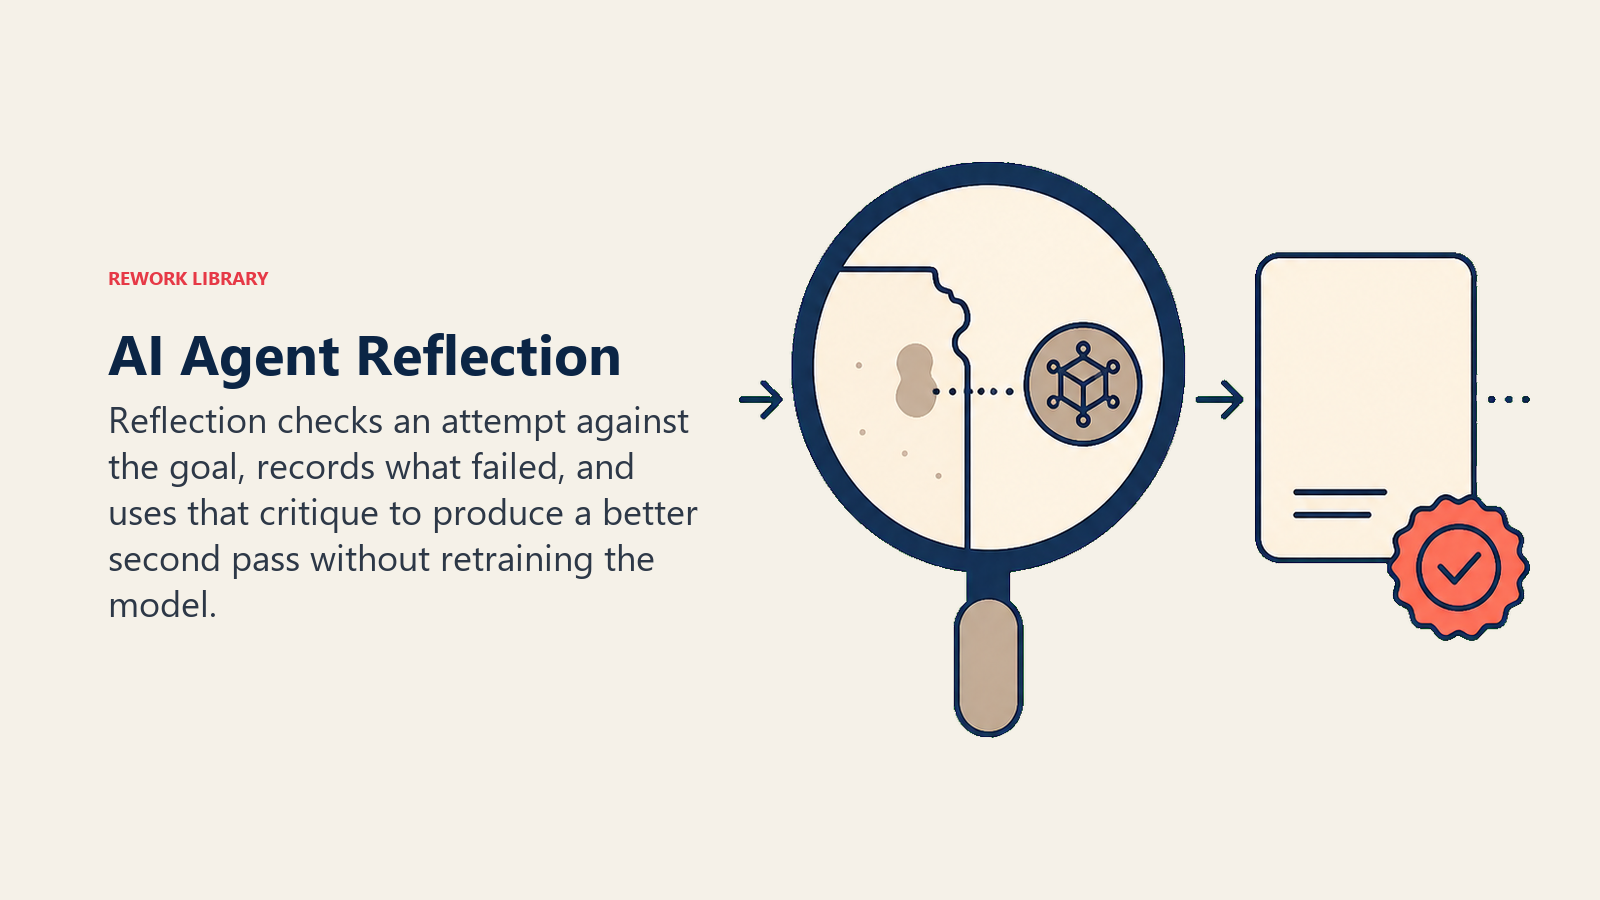
Vale la pena conocer las cifras reales de la investigación detrás de esto, un artículo de 2023 sobre Reflexion de Shinn y colegas. Su enfoque alcanzó un 91% de precisión pass@1 en el benchmark de programación HumanEval, frente al 80% de la referencia estándar de GPT-4 de entonces, usando únicamente un ciclo de autocrítica verbal almacenado en la memoria entre intentos. Sin reentrenamiento y sin nuevos pesos del modelo: solo el agent leyendo su propio intento fallido, anotando en lenguaje sencillo qué salió mal y volviendo a intentarlo con esa nota en su contexto. Esa autocrítica almacenada es una forma de la memoria de trabajo que se cubre en cómo funcionan los AI agents; si quiere un panorama más completo de cómo los agents retienen información así a lo largo de pasos y ejecuciones, AI memory es la referencia más profunda.
En términos de negocio, el plan del Content Drafting Agent usa una idea relacionada: redactar, contrastar el borrador con las pautas de marca y los elementos requeridos, y corregirlo antes de entregarlo a una persona para la revisión final. La autoverificación no reemplaza la revisión humana. Reduce la cantidad de borradores que llegan con un problema evidente y evitable.
Todo junto: un recorrido por una traza de razonamiento
Así se ven las tres técnicas combinadas en una tarea real. Al plan del AI Research Agent se le pide elaborar un informe sobre una empresa objetivo antes de una llamada de ventas.
- Planificar. El agent divide el objetivo en subtareas: actividad reciente de financiamiento, cambios en el liderazgo y cualquier noticia del último trimestre.
- Ciclo ReAct, subtarea uno. Thought: "Necesito noticias recientes de financiamiento". Action: buscar. Observation: tres resultados, uno de una fuente creíble. Thought: "Esto parece actual y relevante, lo voy a leer". Action: obtener la página. Observation: ronda de financiamiento confirmada con fecha y monto.
- Ciclo ReAct, subtareas dos y tres. El mismo ciclo de pensamiento, acción y observación se repite para los cambios de liderazgo y las noticias recientes, y cada ciclo se detiene cuando el agent considera que tiene señal suficiente.
- Reflexionar. Antes de finalizar, el agent contrasta su propio borrador con el objetivo original: ¿cubre las tres subtareas?, ¿hay algo desactualizado o sin confirmar?, ¿falta una fuente para alguna afirmación? Si aparece una brecha, esta se convierte en una búsqueda adicional y dirigida en lugar de entregar el informe con un vacío.
Tres técnicas, un resultado coherente y una traza en cada paso que una persona podría releer y entender, lo cual importa tanto como la respuesta final.
Por qué la profundidad del razonamiento es una disyuntiva entre costo y confianza
Nada de esto es gratis. Cada pensamiento que el agent escribe son tokens, y cada ciclo ReAct adicional o pasada de reflexión añade latencia. Una consulta simple no necesita planificación de varios pasos ni una pasada de autocrítica; necesita una respuesta rápida y directa. Qué son los modelos de razonamiento cubre la pregunta más amplia de cuándo vale la pena el razonamiento extendido y deliberado, y cuándo es mejor una respuesta estándar y rápida, una distinción que se aplica tanto a la profundidad de razonamiento interno de un agent como a la elección de un modelo.
El otro lado de la disyuntiva es la confianza, no solo el costo. Un modelo puede razonar hasta una acción equivocada con la misma fluidez y seguridad con que razona hasta una correcta. La guía Building Effective Agents de Anthropic, basada en implementaciones en producción, defiende mantener los ciclos agentic tan simples como lo permita la tarea en lugar de recurrir por defecto a la máxima autonomía, precisamente porque más pasos de razonamiento significan más lugares por donde un error puede colarse sin ser notado. Por eso cada traza de razonamiento debe registrarse y poder revisarse, no solo la acción final; AI agent observability cubre lo que debe incluir esa capa de registro y monitoreo.
Datos clave
- Razonar en un agent significa que el modelo genera texto intermedio visible sobre su siguiente movimiento antes de actuar, con mayor frecuencia mediante un proceso de estilo chain-of-thought.
- ReAct intercala razonamiento y acción en el mismo ciclo. En la investigación original, superó a las referencias de imitation learning y reinforcement learning por 34 puntos en ALFWorld y por aproximadamente 11 puntos en WebShop.
- La planificación descompone un objetivo en subpasos ordenados antes de ejecutar, y un agent bien construido replanifica cuando un paso falla o nueva información cambia el panorama.
- La reflexión hace que el agent critique su propio intento y lo corrija. La investigación de Reflexion alcanzó un 91% de pass@1 en HumanEval frente a una referencia del 80% usando un ciclo de autocrítica verbal, sin ningún reentrenamiento.
- Un razonamiento más profundo cuesta más tokens, tiempo y dinero, y no reduce el riesgo de una acción equivocada con total seguridad, por lo que las trazas de razonamiento deben registrarse y poder revisarse, no simplemente aceptarse con confianza.
Preguntas frecuentes sobre cómo razonan los AI agents
¿Qué es ReAct en los AI agents?
ReAct significa razonar y actuar (reasoning and acting). Es un patrón en el que un AI agent intercala breves pasos de razonamiento (pensamientos) con acciones reales (normalmente llamadas a herramientas) y lee el resultado (una observación) antes de su siguiente pensamiento, en lugar de razonar hasta una respuesta final antes de actuar o de actuar sin ningún razonamiento.
¿Cuál es la diferencia entre planificación y reflexión en los AI agents?
La planificación ocurre antes de la ejecución: el agent divide un objetivo en un conjunto ordenado de subpasos por adelantado. La reflexión ocurre después de un intento: el agent evalúa su propia salida frente al objetivo y la corrige si se queda corta. Muchos agents en producción usan ambas, junto con un razonamiento paso a paso de estilo ReAct dentro de cada subtarea planificada.
¿Añadir más pasos de razonamiento hace que un AI agent sea más preciso?
A menudo, pero no de forma automática ni gratuita. La investigación sobre ReAct y sobre los enfoques basados en reflexión muestra mejoras reales de precisión en tareas de varios pasos. Pero cada paso de razonamiento adicional cuesta tokens y tiempo, y una traza de razonamiento más larga aún puede llegar a una conclusión equivocada con total seguridad, por lo que la traza debe registrarse y revisarse, no aceptarse sin más porque sea más larga.
¿Puede un AI agent corregir sus propios errores?
Sí, dentro de ciertos límites. La reflexión permite que un agent detecte y corrija ciertas clases de errores, como una prueba fallida o un borrador incompleto, criticando su propia salida y volviendo a intentarlo. No puede detectar errores que no se aprecian con la información que tiene a su alcance, y por eso la revisión humana sigue importando en las decisiones de consecuencias.
¿Cómo se relaciona el razonamiento de un agent con los modelos de razonamiento como o1 de OpenAI?
Están relacionados pero son distintos. Los modelos de razonamiento se entrenan para dedicar cómputo adicional a deliberar antes de responder a cualquier pregunta individual. Las técnicas de razonamiento de un agent, como ReAct, la planificación y la reflexión, son patrones para estructurar esa deliberación a lo largo de una tarea de varios pasos que además implica ejecutar acciones reales. Un agent puede construirse sobre un modelo estándar o sobre un modelo de razonamiento, y la elección depende de lo exigente que sea el razonamiento de la tarea.
¿Es chain-of-thought lo mismo que el razonamiento de un agent?
Chain-of-thought es la técnica de base: lograr que un modelo escriba pasos intermedios de razonamiento en lugar de saltar directamente a una respuesta. El razonamiento de un agent se apoya en ese mismo hábito, pero lo integra en un ciclo que además ejecuta acciones y recibe de vuelta resultados reales, lo cual es un problema distinto y más complejo que razonar sobre una única pregunta estática.
A dónde ir a continuación
El razonamiento decide qué hace un agent a continuación; cómo usan herramientas los AI agents cubre lo que ocurre cuando esa decisión se convierte en una acción. Para ver cómo cambia el ciclo de razonamiento de un solo agent cuando el trabajo se reparte entre varios agents, consulte sistemas multi-agent. Y si está listo para llevar esto a un agent propio, cómo construir un AI agent recorre el proceso de construcción de principio a fin, mientras que el resumen de herramientas de productividad y la guía cómo elegir un asistente de programación con AI son buenas paradas siguientes si lo que está evaluando es un agent de programación con mucho razonamiento.

On this page
- El razonamiento es el paso "Reason" del ciclo, hecho visible
- ReAct: razonar y actuar en el mismo ciclo
- Planificación: pensar varios pasos por adelantado
- Reflexión: detectar sus propios errores
- Todo junto: un recorrido por una traza de razonamiento
- Por qué la profundidad del razonamiento es una disyuntiva entre costo y confianza
- Datos clave
- A dónde ir a continuación