Gestión del contexto de AI agents: presupuesto, compactación y recuperación
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
La gestión del contexto de AI agents es la práctica de decidir qué entra en la ventana de contexto de un modelo en cada paso de una ejecución: qué instrucciones, qué resultados de herramientas, qué documentos recuperados y qué turnos previos merecen realmente un lugar, y qué se resume, se descarta o se busca más adelante. Importa porque un agent no tiene una sola oportunidad con un prompt: opera en ciclo, y cada pasada por ese ciclo compite por el mismo espacio limitado y cada vez más saturado. Si usted trata el contexto como un espacio de trabajo gratuito, el agent se vuelve más lento, más caro y menos preciso cuanto más dura una tarea. Si lo trata como un presupuesto, se mantiene afilado.
Por qué es un problema de agents y no de chat
Una sola pregunta a un chatbot llena una porción pequeña y predecible de una ventana de contexto: un system prompt, la pregunta y una respuesta. Un agent es distinto. Cómo funcionan los AI agents describe el ciclo que ejecuta: percibir, razonar, actuar, observar y repetir, y cada una de esas pasadas puede añadir más a lo que el modelo tiene que retener. Una tarea de diez pasos ha leído diez lotes de resultados de herramientas, ha tomado diez decisiones y posiblemente ha recuperado varios documentos para cuando termina. Nada de eso desaparece automáticamente. Permanece en la ventana de contexto a menos que algo lo gestione de forma deliberada.
El equipo de ingeniería de Anthropic plantea muy bien el problema de fondo en su guía sobre la ingeniería de contexto para AI agents: el contexto es un recurso finito con rendimientos marginales decrecientes. Cada token adicional más allá de lo que un paso realmente necesita no solo cuesta dinero, sino que puede perjudicar activamente el rendimiento, porque la atención de un transformer tiene que repartirse entre todo lo que hay en la ventana, y se reparte con más dispersión a medida que esa ventana se llena. Es un modo de fallo distinto a quedarse sin espacio: el desempeño se degrada silenciosamente mientras todavía queda lugar, una dinámica que la investigación de Chroma sobre rendimiento en contextos largos documentó directamente, al probar 18 modelos líderes y encontrar que la precisión puede empezar a caer mucho antes de que una ventana esté técnicamente llena. AI Agent Memory cubre esa investigación con más profundidad desde el lado del almacenamiento; esta página continúa donde esa termina, en qué hacer concretamente al respecto.
Qué es lo que realmente llena el contexto de un agent
Antes de poder presupuestar una ventana de contexto, usted necesita saber qué compite por espacio dentro de ella. En una ejecución típica de un agent, cinco categorías pelean por los mismos tokens:
| Qué hay en el contexto | Para qué sirve | Por qué crece |
|---|---|---|
| System prompt y reglas | El rol, el tono y el comportamiento permanente del agent | Rara vez crece una vez escrito, pero con el tiempo suele rellenarse con casos límite |
| Esquemas de herramientas | Definiciones de cada herramienta que el agent puede llamar | Crece con cada herramienta que se añade al kit del agent |
| Resultados de llamadas a herramientas | Salida cruda de cada llamada a una API, búsqueda o consulta hasta el momento | Es lo que crece más rápido, sobre todo con respuestas de API extensas |
| Historial de la conversación y de pasos | Lo que se ha preguntado, decidido y hecho hasta ahora en esta ejecución | Crece con cada paso de una tarea de varios pasos |
| Documentos recuperados o memoria | Conocimiento incorporado para responder o decidir | Crece si la recuperación no está acotada con precisión |
En la práctica, los resultados de las llamadas a herramientas suelen ser el mayor responsable. Cómo usan herramientas los AI agents explica cómo una llamada a una herramienta devuelve un resultado crudo que el modelo lee antes de decidir qué sigue, y muchas APIs devuelven mucho más de lo que un agent necesita: un registro completo del cliente cuando necesitaba un solo campo, una respuesta de búsqueda completa cuando necesitaba los tres primeros resultados. El AI Research Agent muestra qué ocurre cuando esto no se gestiona: un informe que lleva diez fuentes completas al contexto en lugar de tres extractos enfocados no solo tarda más en generarse, sino que diluye la atención del modelo entre material que en su mayoría no llegará a la síntesis final de todos modos.
Presupuesto: decida qué merece un lugar antes de que se llene
Un presupuesto de contexto es una idea simple aplicada de forma deliberada en lugar de por accidente: decidir, antes de que comience una ejecución, aproximadamente cuánto de la ventana puede consumir cada categoría anterior, y hacerlo cumplir a medida que avanza la ejecución. El planteamiento de Anthropic es buscar el conjunto más pequeño posible de tokens de alta señal que lleve al modelo al resultado correcto, no el conjunto más grande que podría ser relevante.
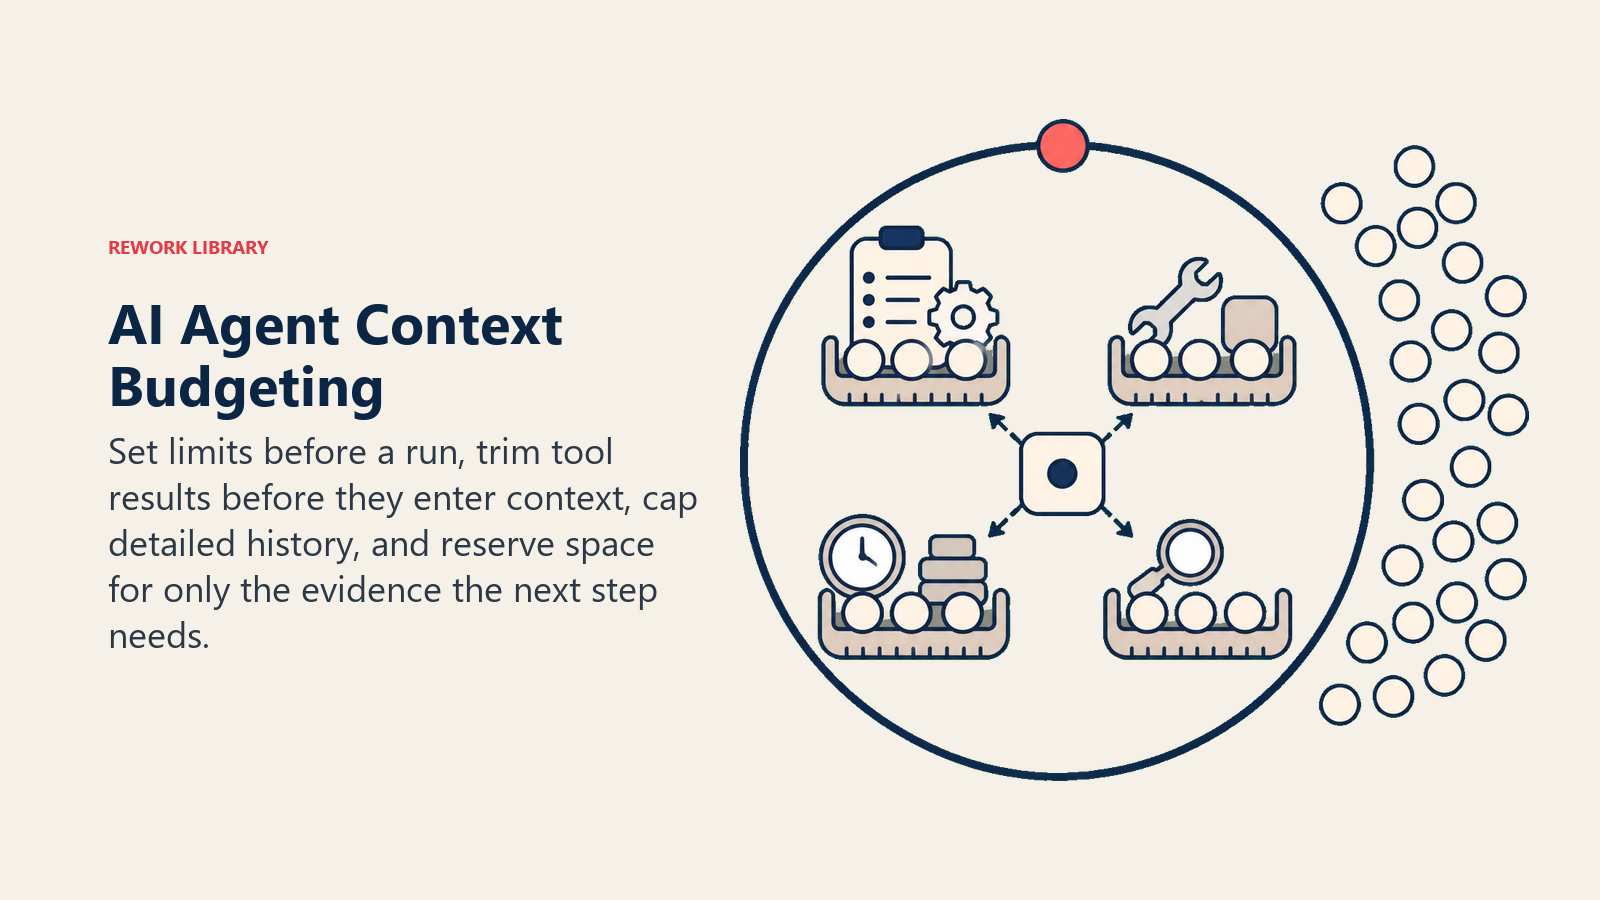
En la práctica, eso se traduce en algunos hábitos concretos:
- Recorte los resultados de las herramientas antes de que entren al contexto, no después. Extraiga de una respuesta de API los dos o tres campos que un paso realmente necesita, en lugar de pasar toda la carga útil.
- Mantenga el system prompt ajustado. Un system prompt relleno con todos los casos límite que alguien haya encontrado es un impuesto permanente sobre cada ejecución, aparezca ese caso límite o no.
- Ponga un tope al historial, no lo deje abierto. Decida cuántos pasos previos de una tarea larga se conservan con todo su detalle y cuántos se compactan (más sobre esto abajo).
- Acote la recuperación con precisión. Traiga los pocos fragmentos que una pregunta realmente necesita en lugar de un documento completo, una lección que RAG para AI agents cubre desde el lado de la fundamentación; también es una decisión de presupuesto de contexto, no solo de precisión.
Compactación: resuma antes de desbordar, no después
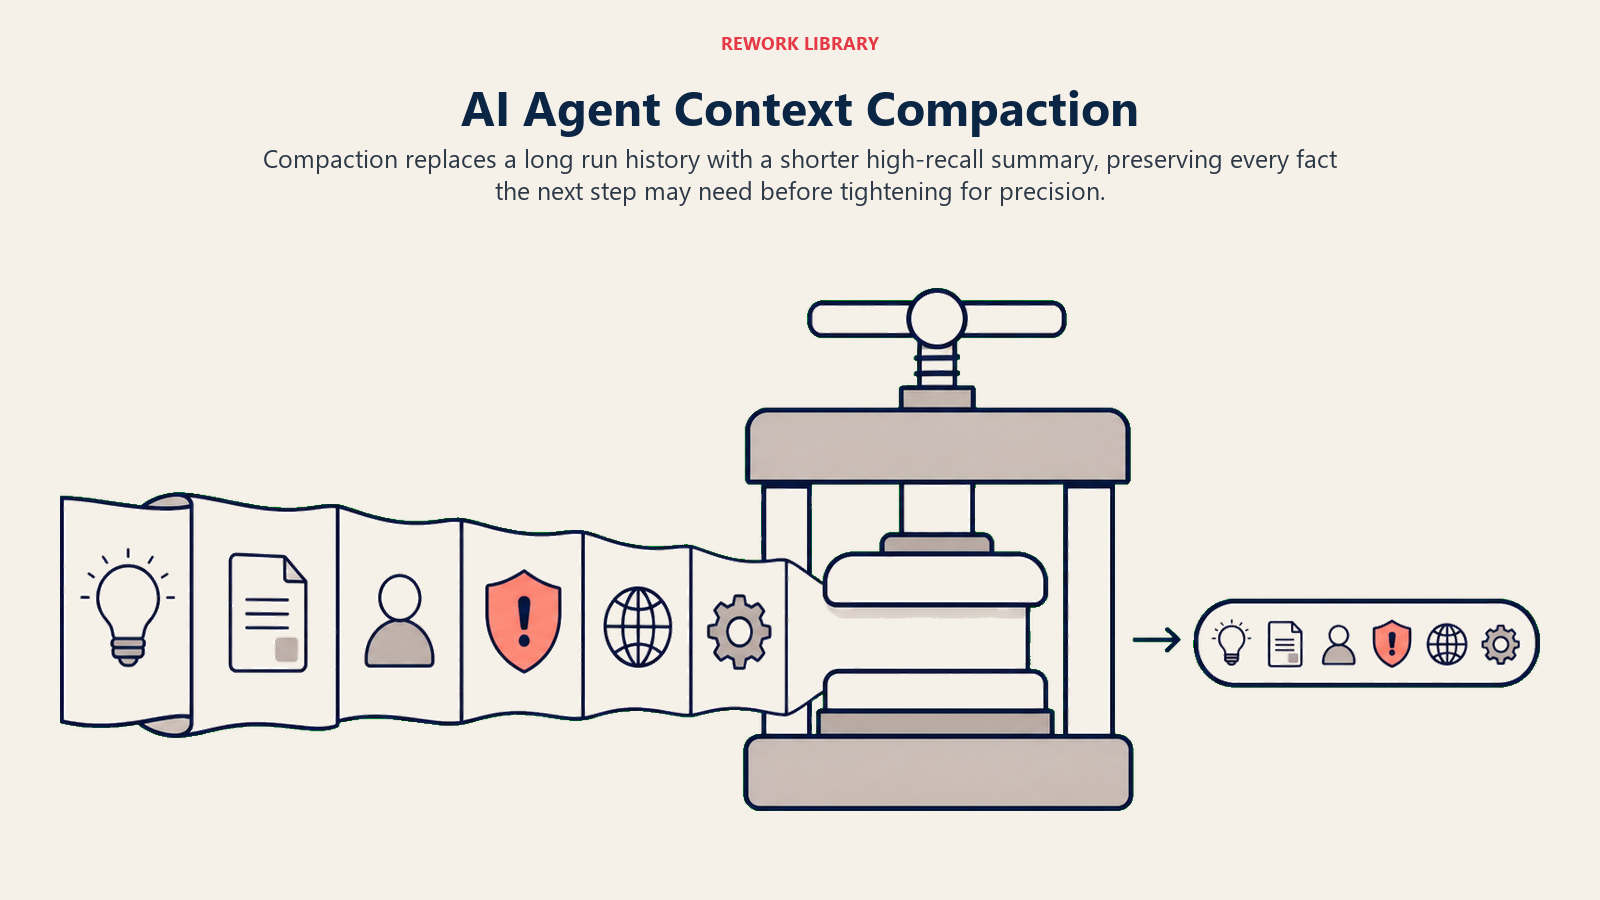
La compactación es lo que se hace cuando una ejecución ya acumuló más historial del que necesita conservar completo: se resume lo ocurrido hasta el momento en una forma comprimida y se continúa la tarea desde ese resumen en lugar de desde toda la transcripción. La guía de Anthropic es específica sobre cómo hacerlo bien: apunte primero a una alta exhaustividad (recall), asegúrese de que el paso de compactación capture cada dato que el siguiente paso podría necesitar, y luego ajuste la precisión una vez que haya confirmado que no se pierde nada importante. Invertir ese orden, optimizar un resumen corto antes de confirmar que está completo, es la forma en que un agent compactado empieza a olvidar silenciosamente cosas que importaban.
Una idea relacionada y más antigua que vale la pena conocer es MemGPT, una propuesta que toma prestada la memoria por niveles de los sistemas operativos: mantener una pequeña cantidad de información "caliente" en el contexto inmediato del modelo y paginar todo lo demás hacia un almacenamiento más lento y más grande, trayéndolo de vuelta solo cuando un paso realmente lo necesita. La compactación y la recuperación just-in-time, que veremos a continuación, son ambas versiones prácticas de esa misma idea de paginación.
La recuperación just-in-time supera a cargarlo todo por adelantado
El instinto, cuando un agent podría necesitar un dato, es cargarlo en el contexto desde el principio, por si acaso. El mejor patrón, y en el que más se apoya la guía de Anthropic, es la recuperación just-in-time: darle al agent una referencia ligera (una ruta de archivo, un ID de registro, una herramienta de búsqueda) y dejar que traiga el contenido real solo en el paso donde lo necesite. Eso refleja cómo trabaja una persona. Nadie memoriza un manual de políticas completo antes de responder una sola pregunta sobre licencia parental; busca la sección pertinente cuando llega la pregunta.
Esta es exactamente la mecánica que describe RAG para AI agents: la recuperación, dentro de un agent, es en realidad una llamada a una herramienta como cualquier otra, ubicada en el paso de percepción del ciclo y activada cuando un paso específico necesita información específica, en lugar de cargarse en bloque al inicio. El beneficio para la gestión del contexto es independiente del beneficio de fundamentación. Aun si un modelo pudiera técnicamente alojar toda una knowledge base en su ventana, hacerlo seguiría siendo un error, porque cada token que supere lo que el paso actual necesita diluye la atención del modelo sobre los tokens que realmente importan en este momento.
Delegar a sub-agents: una ventana limpia para un trabajo enfocado
Cuando un solo paso dentro de una tarea mayor necesita mucha lectura, investigación o exploración para lograr algo acotado, una de las jugadas más eficaces de gestión del contexto es entregar ese paso a un sub-agent separado en lugar de hacerlo en línea. El sub-agent recibe su propia ventana de contexto limpia, hace el trabajo pesado allí y devuelve al agent principal un resultado condensado, a menudo en el rango de 1.000 a 2.000 tokens según los propios ejemplos de Anthropic, en lugar de arrastrar de vuelta todo su proceso de trabajo.
Los sistemas multi-agent cubren en profundidad el lado de la orquestación de este patrón: cuándo dividir un trabajo entre agents justifica su complejidad y cuándo es sobreingeniería para un trabajo que un solo agent aún podría manejar. Desde la óptica pura de la gestión del contexto, el argumento a favor de un sub-agent es más acotado y más mecánico: un paso que de otro modo inundaría la ventana del agent principal con detalle exploratorio que no necesita seguir cargando es un buen candidato para aislarlo, resumirlo y devolver el resultado.
Vigilar la salud del contexto después del lanzamiento
Una estrategia de contexto que funciona en las pruebas puede desviarse una vez que llega el tráfico real: las salidas de las herramientas se vuelven extensas tras una actualización de una API, una knowledge base crece, un caso límite se escribe a mano en el system prompt y nunca se elimina. La observabilidad de AI agents ya señala las métricas que vale la pena seguir aquí: el aumento de iteraciones del ciclo por ejecución y el aumento del costo por tarea completada son señales tempranas de que el contexto se está inflando silenciosamente, a menudo antes de que la precisión caiga de forma visible. La optimización de costos de AI agents cubre el lado del almacenamiento en caché de la misma moneda, que hace que reenviar contexto reutilizado sea mucho más barato, algo que importa junto con la compactación y no en lugar de ella, ya que incluso el contexto bien almacenado en caché debe procesarse con atención en cada llamada.
Si usted está evaluando plataformas que manejan bien grandes bases de código o sesiones de larga duración, nuestras comparativas de herramientas para desarrolladores y la guía de compra de asistentes de programación con AI abordan el manejo de la ventana de contexto como un verdadero diferenciador y no como una nota al pie, ya que es uno de los lugares donde con más claridad se nota la calidad de un asistente de programación en un proyecto grande.
Datos clave
- Anthropic plantea el contexto como un recurso finito con rendimientos marginales decrecientes: los tokens adicionales más allá de lo que un paso necesita no solo cuestan más, sino que pueden diluir la atención del modelo sobre lo que realmente importa.
- Los resultados de las llamadas a herramientas, y no el historial de la conversación, suelen ser la parte del contexto de un agent que crece más rápido, ya que muchas APIs devuelven mucho más de lo que un solo paso necesita.
- La compactación debe optimizar primero la exhaustividad (capturar todo lo que podría importar) y después la precisión (ajustar el resumen), y no al revés.
- Los sub-agents que manejan un paso acotado y de mucha exploración suelen devolver al agent principal un resultado condensado de aproximadamente 1.000 a 2.000 tokens, en lugar de arrastrar todo su contexto de trabajo.
- El aumento de iteraciones del ciclo y del costo por tarea completada son señales de alerta tempranas de inflación del contexto, a menudo visibles antes de que la precisión caiga.
A dónde ir a continuación
La gestión del contexto es la disciplina diaria que mantiene a un agent rápido, preciso y asequible a medida que las tareas se alargan. AI Agent Memory cubre con más profundidad el lado del almacenamiento, RAG para AI agents cubre la recuperación como técnica de fundamentación en concreto, y la observabilidad de AI agents explica cómo detectar la inflación del contexto después del lanzamiento, antes de que se manifieste como un pico de costos o una caída silenciosa de la precisión.

On this page
- Por qué es un problema de agents y no de chat
- Qué es lo que realmente llena el contexto de un agent
- Presupuesto: decida qué merece un lugar antes de que se llene
- Compactación: resuma antes de desbordar, no después
- La recuperación just-in-time supera a cargarlo todo por adelantado
- Delegar a sub-agents: una ventana limpia para un trabajo enfocado
- Vigilar la salud del contexto después del lanzamiento
- Datos clave
- A dónde ir a continuación