Fine-tuning vs. prompting para AI agents: cuándo usar cada uno
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
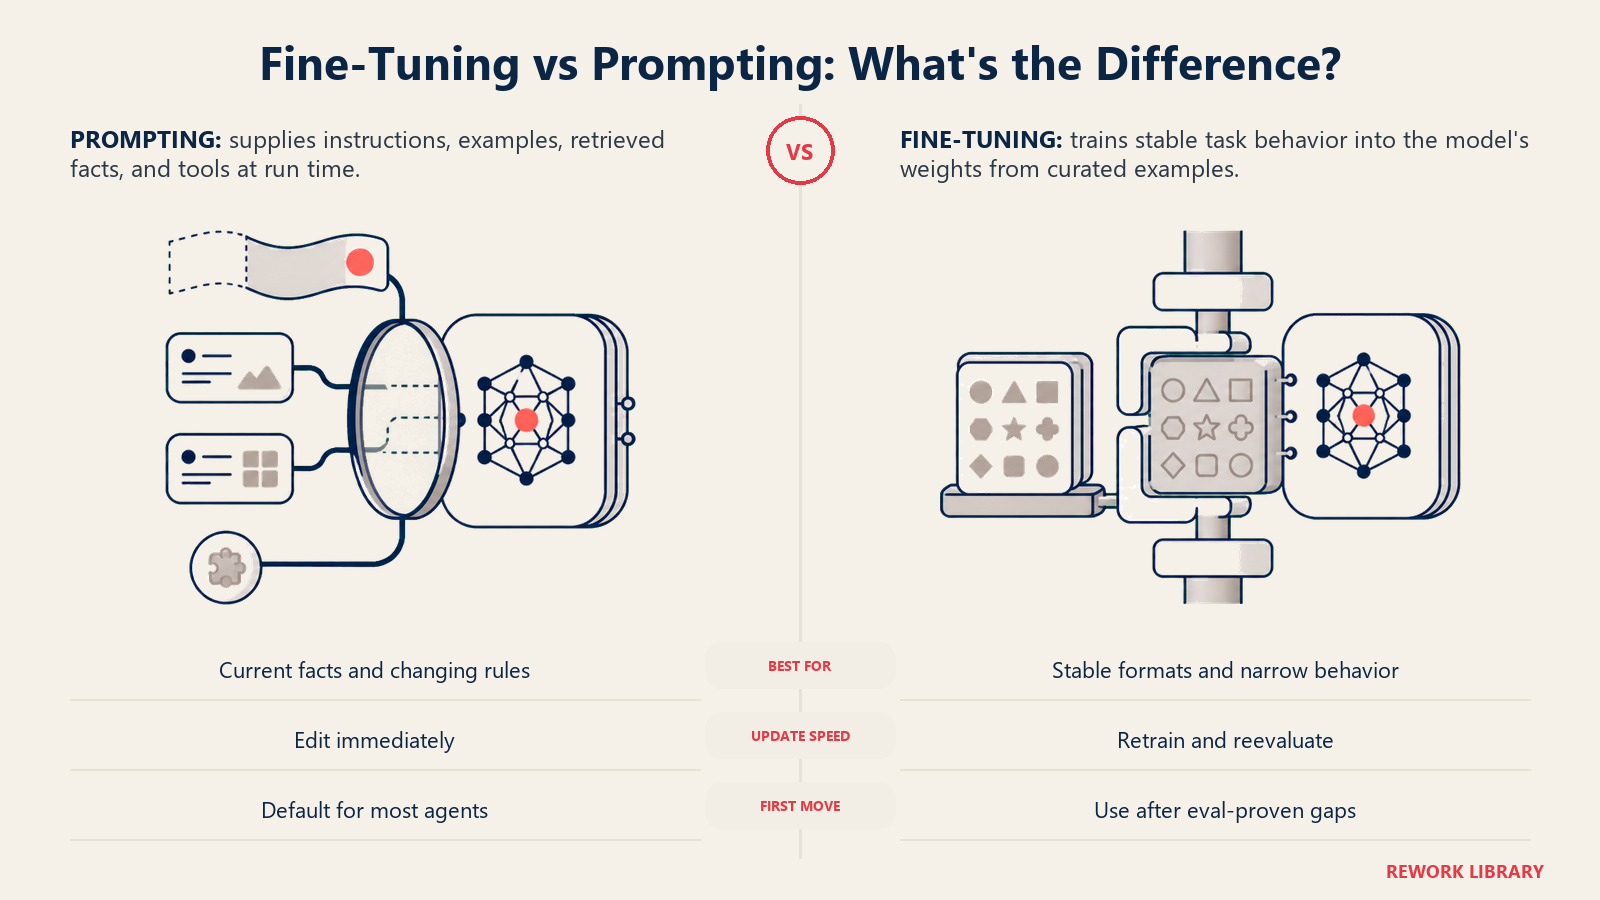
El fine-tuning y el prompting resuelven el mismo problema básico, lograr que un modelo de AI se comporte como su negocio necesita, mediante dos mecanismos muy distintos. El prompting (incluidos RAG y el uso de herramientas) moldea el comportamiento en el momento en que el modelo se ejecuta, mediante instrucciones, ejemplos y contexto recuperado, y es rápido de cambiar y de poner en marcha. El fine-tuning incorpora el comportamiento en los pesos del propio modelo mediante entrenamiento adicional; es más lento de modificar, pero puede fijar una habilidad o un formato específico con más fiabilidad que un prompt. Para la mayoría de los AI agents, el prompting es la opción predeterminada correcta, y el fine-tuning es una herramienta acotada para un tipo concreto de brecha que el prompting realmente no puede cerrar.
Empiece por lo que hace cada uno
El prompting, en el sentido amplio que se usa aquí, abarca todo lo que se puede cambiar sin volver a entrenar el modelo: el system prompt y las reglas, los ejemplos few-shot, la retrieval-augmented generation que incorpora sus documentos y las llamadas a herramientas que permiten al agent consultar datos en vivo. Prompt engineering cubre el oficio de redactar bien esa instrucción, y retrieval-augmented generation cubre cómo un agent se apoya en sus datos reales en lugar de adivinar. Ambos se ejecutan en el momento de la inferencia, en cada llamada, sobre un modelo base de propósito general. El propio equipo de ingeniería de Anthropic presenta la versión moderna de esta práctica como context engineering, y la describe como la progresión natural del prompt engineering para construir agents capaces de trabajo real de varios pasos, precisamente porque nada de eso exige volver a entrenar nada.
Fine-tuning es distinto por naturaleza. Toma un modelo preentrenado y lo entrena más con sus propios ejemplos, ajustando los pesos del modelo para que un comportamiento sea casi automático en lugar de algo que el prompt tiene que pedir en cada llamada. Eso lo vuelve potente para un tipo específico de problema y en gran medida irrelevante para otros, y por eso importa tanto la decisión de cuál elegir.
La opción predeterminada: primero prompt, RAG y herramientas
La guía de OpenAI sobre fine-tuning es directa sobre el orden de las operaciones: primero establezca las evaluaciones, y solo invierta en fine-tuning después de haber definido una forma de medir si realmente ayuda. No es una cautela excesiva, es toda la estrategia. Sin evals, no puede saber si un modelo con fine-tuning es mejor que un prompt bien escrito; simplemente está adivinando con pasos adicionales.
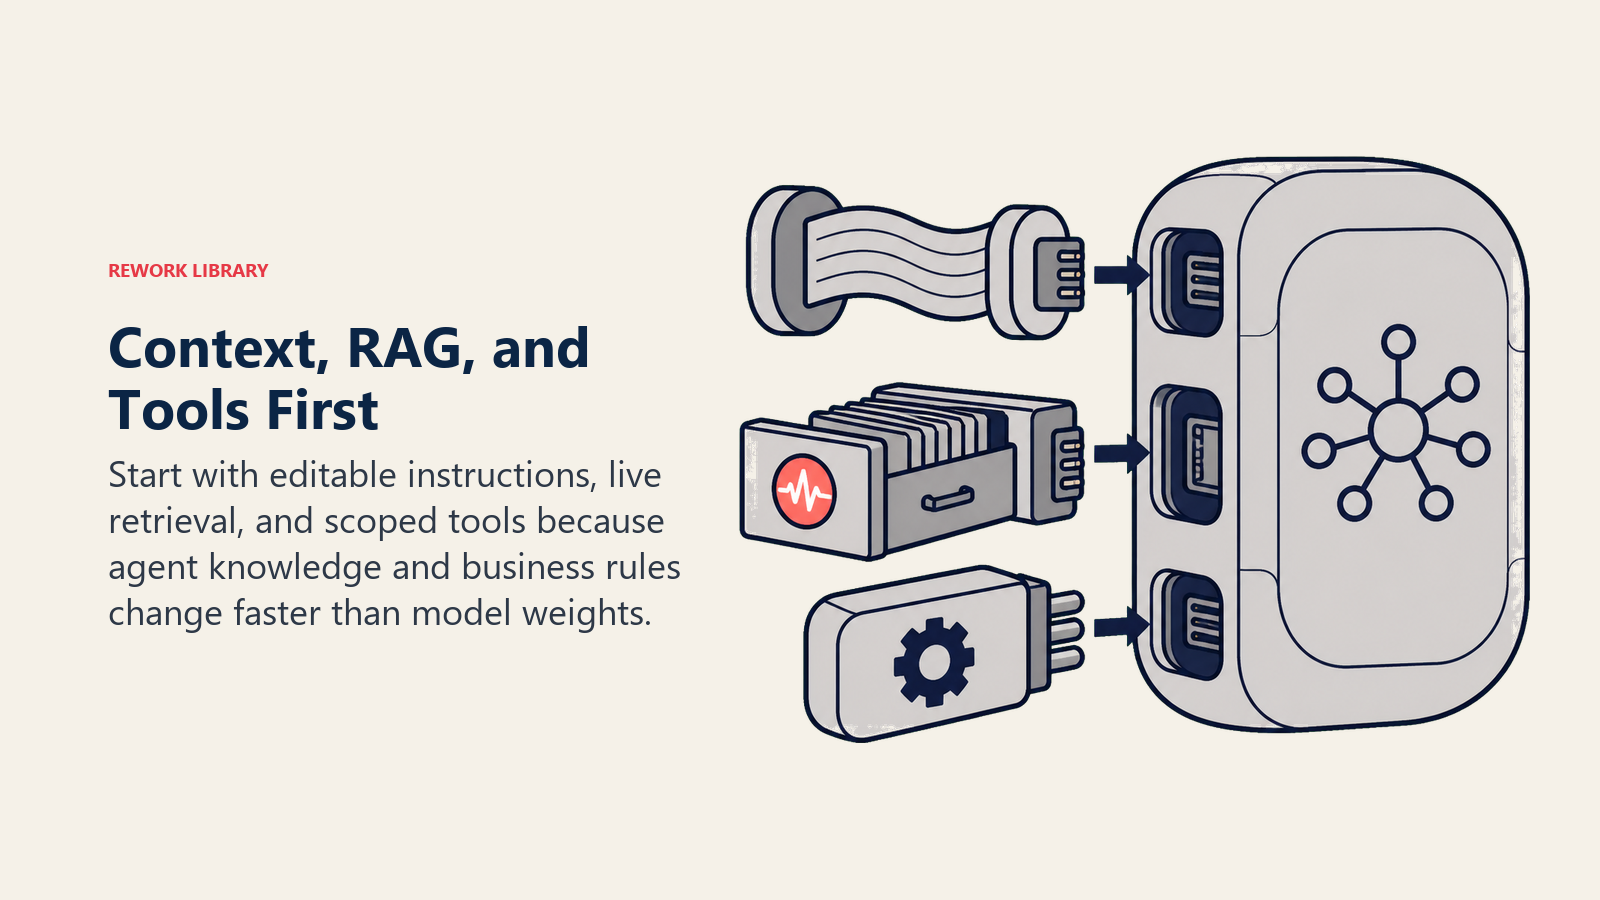
La razón práctica por la que el prompting va primero en el caso de los agents es que casi todo lo que un agent debe hacer bien cambia con demasiada frecuencia como para fijarlo en los pesos. Las reglas de negocio se actualizan. Las políticas cambian. Un catálogo de productos varía cada semana. RAG para AI agents lo plantea directamente: la recuperación lee de la fuente en el momento de la pregunta, de modo que la siguiente actualización se refleja la próxima vez que alguien consulte. Un modelo con fine-tuning que memorizó la política del trimestre pasado queda desactualizado el día en que la política cambia, y volver a entrenarlo no se resuelve el mismo día como sí ocurre al editar un documento o un prompt. El caso independiente de este patrón, un modelo que recupera una vez y responde, se cubre en el patrón RAG Assistant; un agent suele necesitar el mismo anclaje más la capacidad de actuar sobre lo que encuentra.
Dónde el fine-tuning sí se gana su lugar
El fine-tuning no está obsoleto, simplemente apunta a un objetivo más acotado de lo que la mayoría de los equipos supone cuando recurre a él por primera vez. La documentación de OpenAI menciona los casos en los que ayuda de manera consistente: tareas de clasificación, trabajos de traducción con matices, generación de contenido en un formato muy específico y corrección de fallos del modelo al seguir instrucciones que un mejor prompt no ha resuelto. Observe lo que falta en esa lista: el conocimiento general y los datos que cambian con frecuencia, justo el terreno que el prompting y RAG cubren mejor.
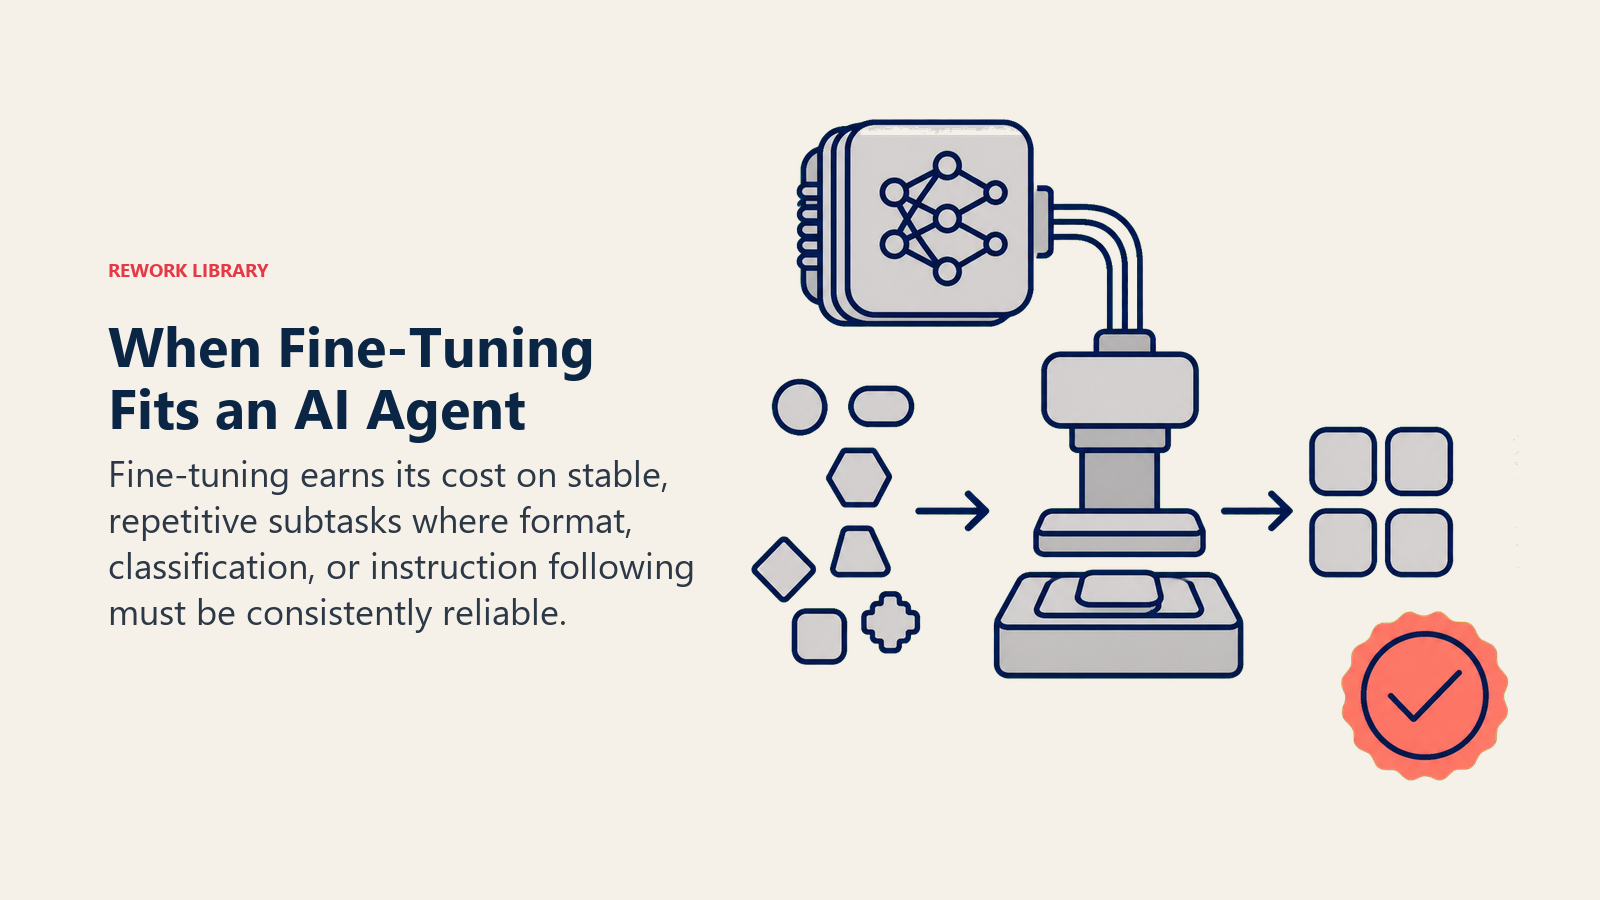
Una forma útil de separar ambos: el fine-tuning es bueno para enseñarle a un modelo cómo responder (formato, tono, un comportamiento de clasificación acotado, seguir de manera fiable un patrón de instrucciones inusual), mientras que el prompting y la recuperación son mejores para enseñarle con qué responder (datos actuales, sus políticas específicas, el historial de cuenta de este cliente). Un agent casi siempre necesita más de lo segundo que de lo primero, porque su trabajo consiste sobre todo en actuar correctamente con información actual, no en producir un tipo de texto de estilo distintivo.
Dentro de un agent más grande, el uso legítimo más común del fine-tuning no es en absoluto el paso principal de razonamiento del agent. Es una subtarea acotada y de alto volumen, ejecutada como una pieza de un ciclo mayor y no como todo el cerebro del agent. El AI Support Triage Agent, que clasifica los tickets entrantes en la cola correcta, es justamente el tipo de tarea de clasificación consistente, repetitiva y de alto volumen en la que un modelo pequeño con fine-tuning puede superar a un modelo general grande al que se le pide hacer la misma tarea acotada en cada llamada. El AI Document Processing Agent, que extrae campos estructurados de documentos desordenados y con formatos inconsistentes, es otro. Ambos son problemas de formato y patrón más que de conocimiento, que es precisamente el punto fuerte del fine-tuning.
Un marco de decisión
| Pregunta | Apunta hacia prompting/RAG/herramientas | Apunta hacia fine-tuning |
|---|---|---|
| ¿El conocimiento de base cambia cada semana o cada mes? | Sí, favorece la recuperación | Rara vez, solo si es realmente estable |
| ¿La brecha es un dato faltante o un formato, tono o comportamiento incorrecto? | Dato faltante | Formato o comportamiento incorrecto |
| ¿Necesita citar o explicar de dónde salió una respuesta? | Sí, la recuperación es trazable | Los pesos no son inspeccionables de la misma manera |
| ¿Es una subtarea acotada, de alto volumen y repetitiva? | No necesariamente | A menudo es el mejor encaje |
| ¿Ya probó un prompt bien escrito y buenos ejemplos? | Pruebe esto primero de todos modos | Solo después de que esto haya fallado de verdad |
| ¿Tiene las evals necesarias para medir si funcionó? | Constrúyalas en cualquier caso | Obligatorio antes de empezar |
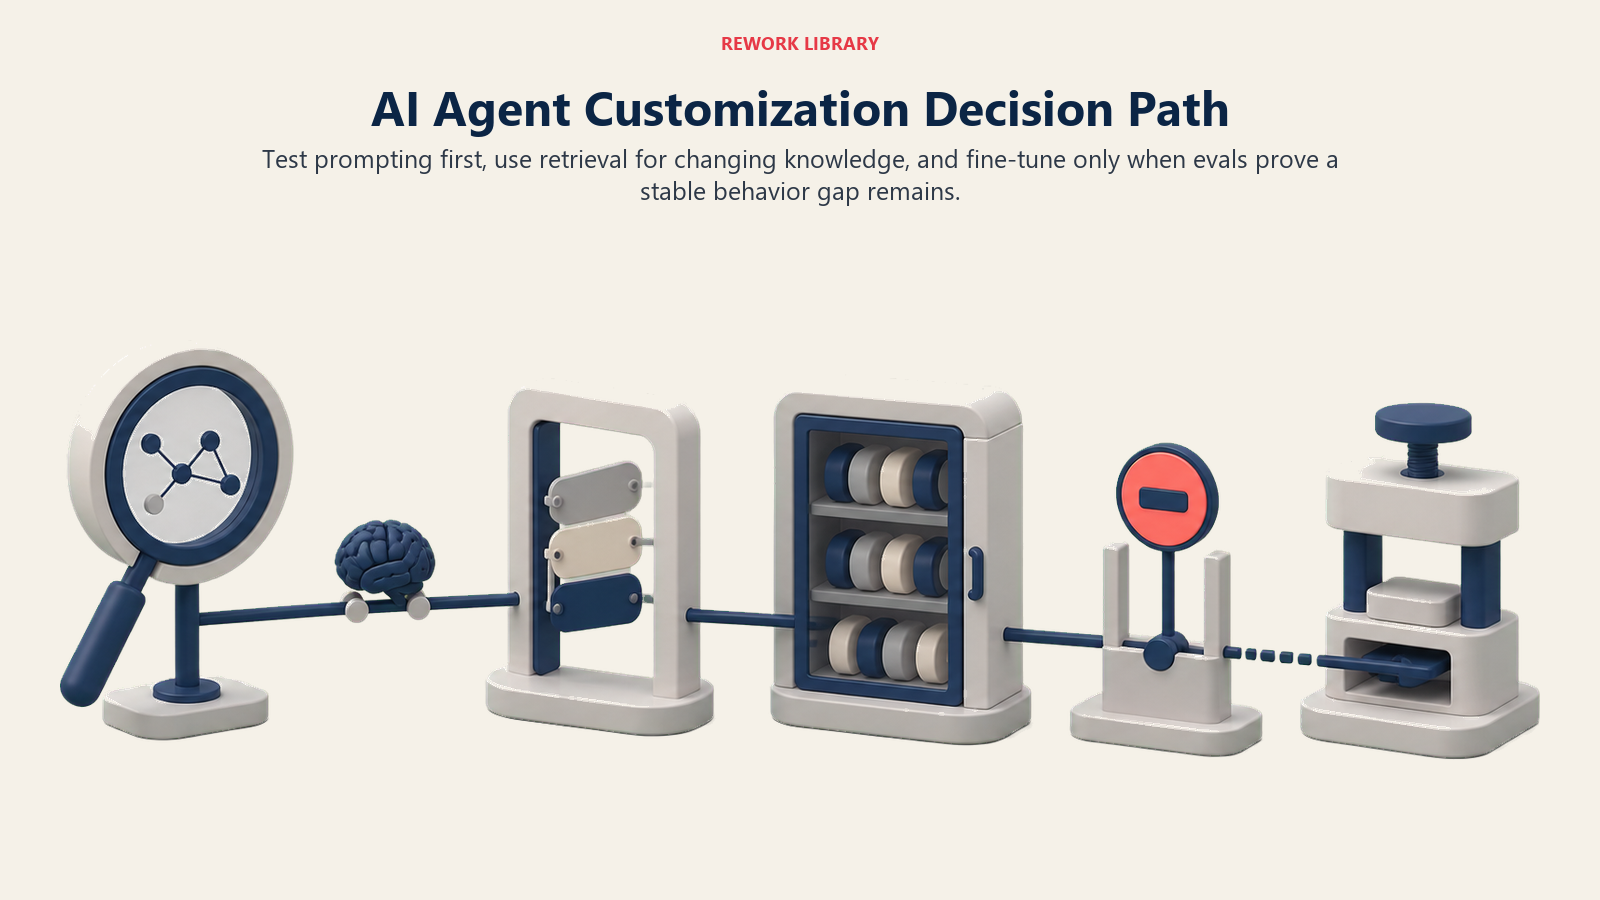
La mayoría de las filas apuntan en la misma dirección para la mayoría de los agents: empiece con prompting, añada recuperación para todo lo que requiera conocimiento actual o propio, y reserve el fine-tuning para las filas específicas en las que realmente es la mejor opción, no como una vía de mejora predeterminada.
El lado del costo en la decisión
El fine-tuning no es solo una decisión técnica, es un compromiso de infraestructura: un pipeline de entrenamiento, un conjunto de datos etiquetado que hay que mantener a medida que cambia su negocio, evaluación para confirmar que la versión con fine-tuning es realmente mejor y una cadencia de reentrenamiento cuando la tarea de base se desvía. Nada de eso es gratis, y nada de eso desaparece después del primer entrenamiento, como sí ocurre con la edición de un prompt.
Vale la pena sopesar ese compromiso frente a la frecuencia con que los proyectos de agentic AI se estancan por razones que nada tienen que ver con la capacidad bruta del modelo. Gartner predice que más del 40% de los proyectos de agentic AI serán cancelados para fines de 2027, y cita entre las causas principales el aumento de los costos y un valor de negocio poco claro. Comprometerse con un pipeline de fine-tuning antes de haber demostrado el caso de uso con un método más barato y rápido es una buena manera de añadir costo y complejidad a un proyecto antes de saber si va a funcionar. Si está comparando plataformas con este criterio, nuestras comparativas de herramientas de AI evalúan a los proveedores por más que la calidad bruta del modelo, y la guía de compra de plataformas de AI chatbot recorre justamente esta disyuntiva entre prompting y personalización desde el lugar del comprador.
Cuando la respuesta es realmente "ambos"
Nada de esto significa que el fine-tuning y el prompting sean mutuamente excluyentes en todo un sistema de agents. Un agent grande que maneja muchos tipos de pasos puede usar legítimamente un modelo pequeño con fine-tuning para un paso de clasificación acotado y repetitivo, y un modelo de frontera con prompting y anclado con RAG para los pasos de razonamiento y redacción que requieren conocimiento actual y criterio. Cómo construir un AI agent cubre los seis componentes básicos que todo agent necesita, y la elección entre fine-tuning y prompting no es una decisión que se toma una sola vez, sino una que se toma paso por paso, según lo que ese paso específico realmente requiere.
Datos clave
- La propia guía de fine-tuning de OpenAI empieza con "good evals first": establezca una forma de medir si el fine-tuning ayudó antes de invertir en él, no después.
- El fine-tuning es más adecuado para clasificación, traducción con matices, formatos de salida específicos y corrección de fallos al seguir instrucciones, no para enseñarle a un modelo datos nuevos o que cambian con frecuencia.
- La recuperación lee de la fuente en el momento de la pregunta, por lo que refleja las actualizaciones de inmediato; un modelo con fine-tuning solo está tan actualizado como su último entrenamiento.
- El uso legítimo más común del fine-tuning dentro de un agent es una subtarea acotada y de alto volumen, como la clasificación de tickets o la extracción de campos de documentos, ejecutada como un paso, no como todo el proceso de razonamiento del agent.
- Gartner atribuye más del 40% de las cancelaciones proyectadas de proyectos de agentic AI para 2027, en parte, al aumento de los costos, un riesgo real cuando se construye un pipeline de fine-tuning antes de haber demostrado el caso de uso.
Preguntas frecuentes sobre fine-tuning vs. prompting para AI agents
¿Debo hacer fine-tuning o usar prompting con mi AI agent?
Empiece con prompting, recuperación y herramientas en casi todos los casos de uso de agents. Vale la pena considerar el fine-tuning solo después de que un prompt bien escrito y buenos ejemplos hayan fallado de verdad en resolver un problema específico y acotado, como un formato de salida inconsistente o una tarea de clasificación que un prompt sigue haciendo mal.
¿Cuál es la principal diferencia entre el fine-tuning y el prompting?
El prompting moldea el comportamiento de un modelo de propósito general en el momento en que se ejecuta, mediante instrucciones, ejemplos y contexto recuperado, y es rápido de cambiar. El fine-tuning entrena más a un modelo con sus propios datos y ajusta sus pesos para que un comportamiento sea casi automático, pero es más lento de actualizar y requiere un pipeline continuo de entrenamiento y evaluación.
¿Puede el fine-tuning reemplazar a RAG para mantener actualizado a un agent?
No. El fine-tuning incorpora el conocimiento en los pesos del modelo en el momento del entrenamiento, por lo que queda desactualizado en cuanto cambia un documento fuente. RAG recupera de la fuente en vivo en el momento de la pregunta, y por eso la recuperación, y no el fine-tuning, es la herramienta adecuada para el conocimiento que cambia con regularidad.
¿Qué tipos de tareas de un agent son un buen encaje para el fine-tuning?
Subtareas acotadas, de alto volumen y repetitivas, con una forma de entrada y salida consistente: clasificar tickets en colas, extraer campos estructurados de documentos desordenados o reproducir de manera fiable un tono o formato muy específico. Suelen ser un paso dentro de un agent más grande, no todo su proceso de razonamiento.
¿Necesito experiencia en machine learning para hacer fine-tuning de un modelo para un agent?
Necesita menos de lo que podría esperar para una tarea acotada con un buen conjunto de datos, pero aun así requiere un proceso de evaluación real para confirmar que la versión con fine-tuning supera a una alternativa bien orientada con prompting. Omitir las evals es la forma más común de terminar con un modelo con fine-tuning que en realidad no es mejor, solo distinto.
A dónde ir a continuación
Si el prompting y la recuperación son el punto de partida correcto para su agent, RAG para AI agents explica cómo anclarlo en sus propios datos, y cómo construir un AI agent muestra dónde encaja esa decisión entre el resto de los componentes de un agent. Si el costo es parte de lo que lo empuja hacia el fine-tuning, optimización de costos de AI agents cubre el almacenamiento en caché y el enrutamiento de modelos, dos palancas que a menudo resuelven el mismo problema sin un pipeline de entrenamiento.
