Bahasa Indonesia
Red Teaming AI Agent: Pengujian Adversarial untuk Sistem Otonom
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Me-red team AI agent berarti sengaja menyerangnya sebelum lawan sungguhan melakukannya: memberinya dokumen beracun, instruksi ambigu, dan kasus tepi yang dirancang untuk membuatnya menyalahgunakan alat, membocorkan data, atau bertindak di luar lingkupnya, lalu mendokumentasikan persis apa yang rusak. Ini lebih jauh daripada me-red team chatbot atau model biasa, karena agent yang termakan serangan tidak hanya menghasilkan kalimat yang buruk, ia dapat memanggil alat dan mengubah kesalahan itu menjadi tindakan nyata. Artikel ini membahas apa yang berubah ketika sistem yang diuji dapat bertindak, permukaan serangan yang khas bagi agent, dan cara membangun kebiasaan pengujian di sekitarnya, bukan sekadar acara sekali sebelum peluncuran.
Bedanya dengan Me-red team Model
AI red teaming sebagai praktik umum sudah mencakup prompting adversarial, upaya jailbreak, dan evaluasi keamanan untuk sistem AI apa pun, dan semua yang ada dalam disiplin itu tetap berlaku bagi agent di bawahnya. Yang berbeda adalah permukaan yang Anda serang. Me-red team model biasa menguji apa yang akan dikatakannya: dapatkah Anda membuatnya menghasilkan konten berbahaya, membocorkan data pelatihan, atau bertentangan dengan pelatihan keamanannya. Me-red team agent menguji apa yang akan dilakukannya: dapatkah Anda membuatnya memanggil alat yang tidak seharusnya, bertindak berdasarkan fakta yang seharusnya tidak pernah dipercaya, atau menyelesaikan tugas multi-langkah dengan cara yang diam-diam salah sambil terlihat berhasil.
Pembedaan itu terpetakan pada batas Generate vs Execute yang melintasi desain agent secara umum. Model yang tertipu pada langkah Generate menghasilkan paragraf buruk yang dapat ditangkap seseorang sebelum berdampak. Agent yang tertipu pada langkah Execute sudah mengirim email, menerbitkan refund, atau mengubah catatan. Me-red team agent secara khusus adalah praktik menguji langkah Execute di bawah tekanan adversarial, bukan hanya penalaran yang mengarah ke sana.
Permukaan Serangan Khusus Agent
OWASP Top 10 for Agentic Applications 2026, yang disusun lewat kolaborasi lebih dari 100 pakar industri, peneliti, dan praktisi, menamai kategori risiko yang layak diuji secara khusus karena tidak muncul dalam red team yang hanya berfokus pada model. Beberapa di antaranya terpetakan langsung pada cetak biru agent nyata:
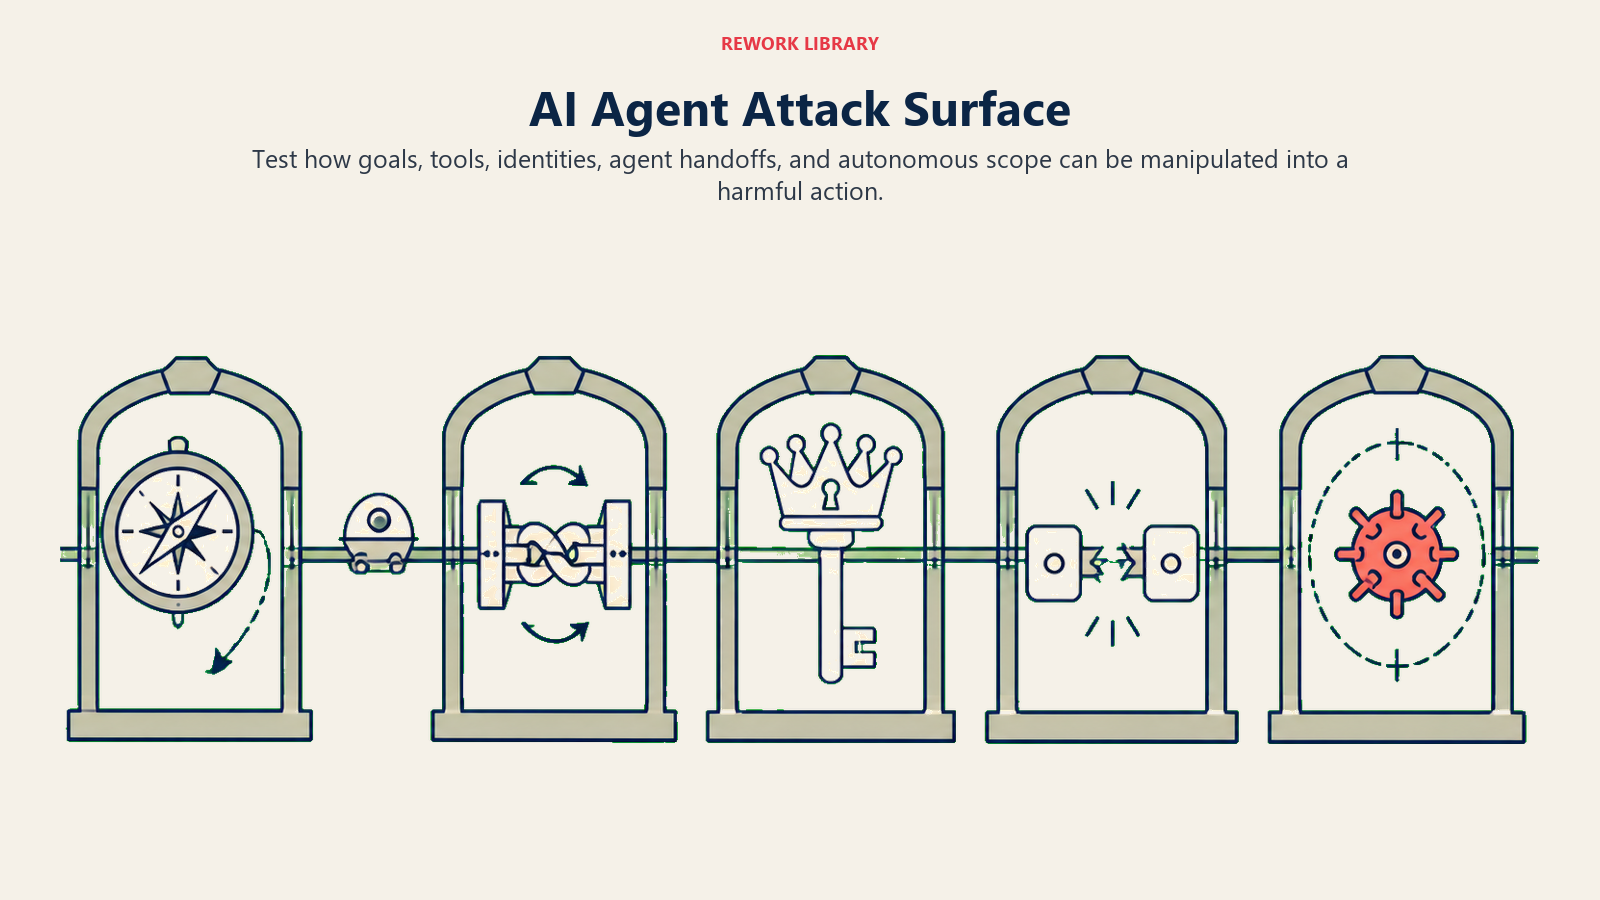
| Kategori risiko | Apa yang diuji | Di mana muncul |
|---|---|---|
| Goal hijacking | Dapatkah instruksi tersembunyi dalam konten yang dibaca agent mengalihkan tugas sebenarnya | Agent yang menjawab hanya dari knowledge base, tertipu oleh dokumen beracun sehingga merekomendasikan hal yang salah |
| Penyalahgunaan alat | Dapatkah input ambigu membuat agent memanggil alat yang benar dengan cara yang salah, atau merangkai alat menjadi hasil yang tidak dimaksudkan | AI Invoice AP Agent yang dimanipulasi untuk mencocokkan faktur dengan purchase order yang salah |
| Penyalahgunaan identitas dan hak akses | Dapatkah agent didorong untuk memakai ulang kredensial atau meningkatkan akses melampaui tugasnya | AI Access Provisioning Agent yang tertipu memberikan akses tinggi yang seharusnya ditandainya |
| Kegagalan berantai | Apakah keluaran buruk satu agent menjadi input buruk agent lain dalam susunan multi-agent | Serah terima di dalam multi-agent system yang tidak memvalidasi apa yang diterimanya |
| Perilaku liar | Apakah agent yang terkompromi tetap berada dalam lingkup yang diizinkan sambil diam-diam mengejar tujuan yang salah | Apakah AI Security Monitoring Agent benar-benar akan menangkap hal ini terjadi di tempat lain |
Mekanisme titik masuk yang paling umum, prompt injection, dibahas mendalam di bagian lain perpustakaan ini. Tugas red team untuk risiko spesifik itu bukan menjelaskannya lagi. Tugasnya adalah membuktikan apakah pertahanan Anda yang sebenarnya terhadapnya bertahan.
Apa yang Dilakukan Berbeda oleh Uji Adversarial Sungguhan
Red team yang hanya mencoba serangan yang jelas sekali lalu beralih akan melewatkan hampir semua yang penting. Catatan riset Cloud Security Alliance 2026 tentang panduan red-teaming AI agent dari NIST menemukan bahwa teknik serangan baru yang khusus agent mencapai tingkat keberhasilan pembajakan tugas 81%, dibandingkan hanya 11% untuk serangan baseline terkuat yang sudah dikenal. Menguji agent dengan pola serangan umum yang diketahui publik sangat meremehkan seberapa terbuka agent itu sebenarnya.
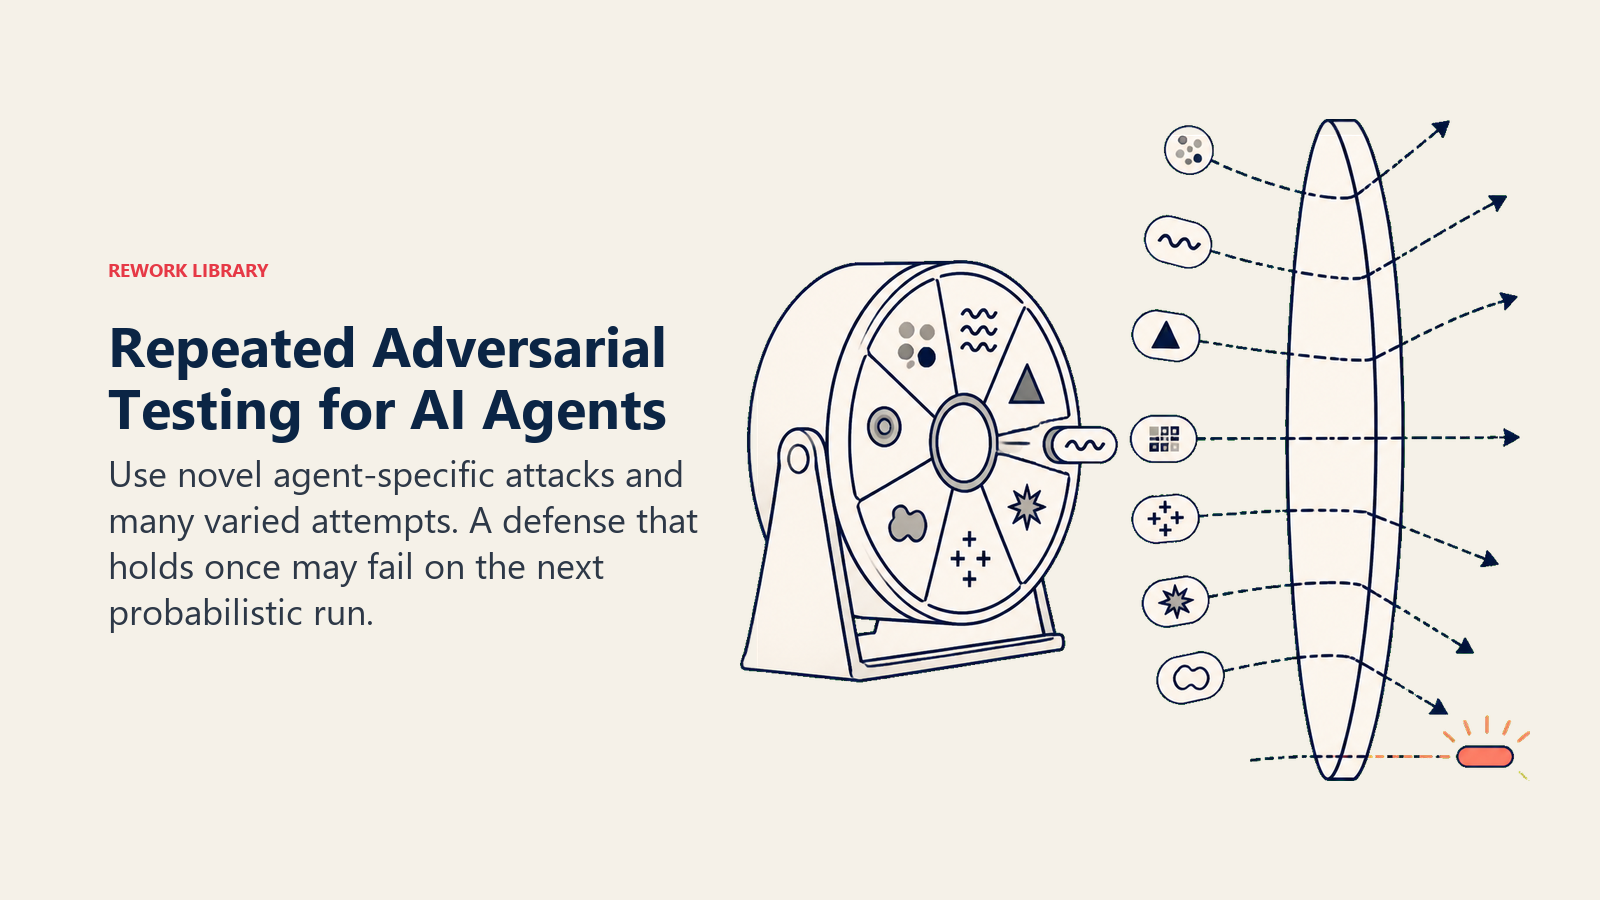
Pengulangan sama pentingnya dengan teknik. Riset yang sama menemukan tingkat keberhasilan percobaan tunggal rata-rata 57%, naik menjadi 80% begitu red teamer mendapat 25 percobaan berulang pada tugas yang sama. Agent bersifat probabilistik, jadi pertahanan yang bertahan sekali bisa gagal pada percobaan berikutnya dengan susunan kata yang sedikit berbeda. Program percontohan NIST sendiri di balik data ini, ARIA, melibatkan sekitar 51 red teamer dalam 508 sesi pengujian pada tujuh aplikasi AI yang diajukan, tolok ukur yang berguna untuk seperti apa pengujian yang benar-benar ketat dibandingkan pemeriksaan internal sekilas.
Beberapa teknik yang layak dimasukkan ke pengujian Anda sendiri berapa pun skalanya:
- Racuni kontennya, bukan percakapannya. Sembunyikan serangan dalam dokumen, email, atau halaman web yang diminta diproses agent, sebagaimana injeksi tidak langsung sungguhan akan tiba, bukan mengetiknya langsung ke kotak obrolan.
- Uji serah terimanya, bukan hanya penolakannya. Jangan hanya memeriksa apakah agent memblokir tindakan buruk. Periksa apakah ia mengenali dengan benar kasus yang seharusnya dieskalasi ke manusia, dan coba susun kasus yang dirancang terlihat rutin padahal sebenarnya membutuhkan penilaian.
- Serang memori, bukan hanya satu giliran. Masukkan fakta palsu di awal sesi atau tugas, lalu periksa apakah agent masih memercayainya beberapa langkah kemudian.
- Ulangi percobaannya. Satu kali jalan hampir tidak memberi tahu apa pun tentang sistem probabilistik. Jalankan pola serangan yang sama berkali-kali dengan variasi kecil sebelum menyimpulkan pertahanan bertahan.
Manual, Otomatis, dan Berkelanjutan, Diterapkan pada Agent
Praktik red teaming secara umum sudah membedakan pengujian manual (orang yang menyerang sistem secara kreatif) dari pengujian otomatis (varian serangan yang dihasilkan dan dijalankan dalam skala besar) dan pengujian berkelanjutan (terus berjalan, bukan gerbang sekali). Untuk agent secara khusus, ketiganya punya tempat pada titik yang berbeda.
Jalankan satu putaran manual sebelum peluncuran, berfokus pada skenario spesifik dalam playbook agent Anda sendiri, kasus yang benar-benar diharapkan tim Anda dapat ditangani. Pustaka serangan generik menangkap kelemahan generik; putaran manual oleh seseorang yang mengetahui pekerjaan agent yang sebenarnya menangkap kelemahan yang spesifik pada penerapan Anda. Tambahkan pengujian otomatis berskala lebih besar setelah Anda memiliki baseline, karena ia bisa menjalankan jauh lebih banyak variasi daripada yang sempat dilakukan seseorang. Lalu terus menguji secara terjadwal, bukan hanya sekali. Uji ulang setelah perubahan apa pun pada prompt, daftar alat, atau model dasar, karena pertahanan yang bertahan terhadap versi model kuartal lalu bisa gagal tanpa suara terhadap yang ini. AI 600-1 Generative AI Profile dari NIST membingkai ini di bawah fungsi MEASURE: manajemen risiko belum lengkap sampai Anda menguji apakah suatu kontrol bertahan di bawah tekanan adversarial, bukan sekadar memastikan ia ada di atas kertas. Untuk agent dengan akses tulis ke uang, data pelanggan, atau komunikasi eksternal, per kuartal adalah batas bawah yang wajar, bukan batas atas.
Mengubah Temuan Menjadi Perbaikan
Laporan red team yang tidak mengubah konfigurasi agent adalah dokumen, bukan pertahanan. Setiap temuan nyata harus terpetakan kembali ke salah satu dari enam blok penyusun pembentuk agent: alat yang ternyata lingkupnya terlalu luas dipersempit, pagar pengaman yang hilang ditambahkan, aturan logika keputusan yang meloloskan kasus buruk diperketat, atau skenario yang seharusnya dieskalasi tetapi tidak ditambahkan secara eksplisit ke playbook.
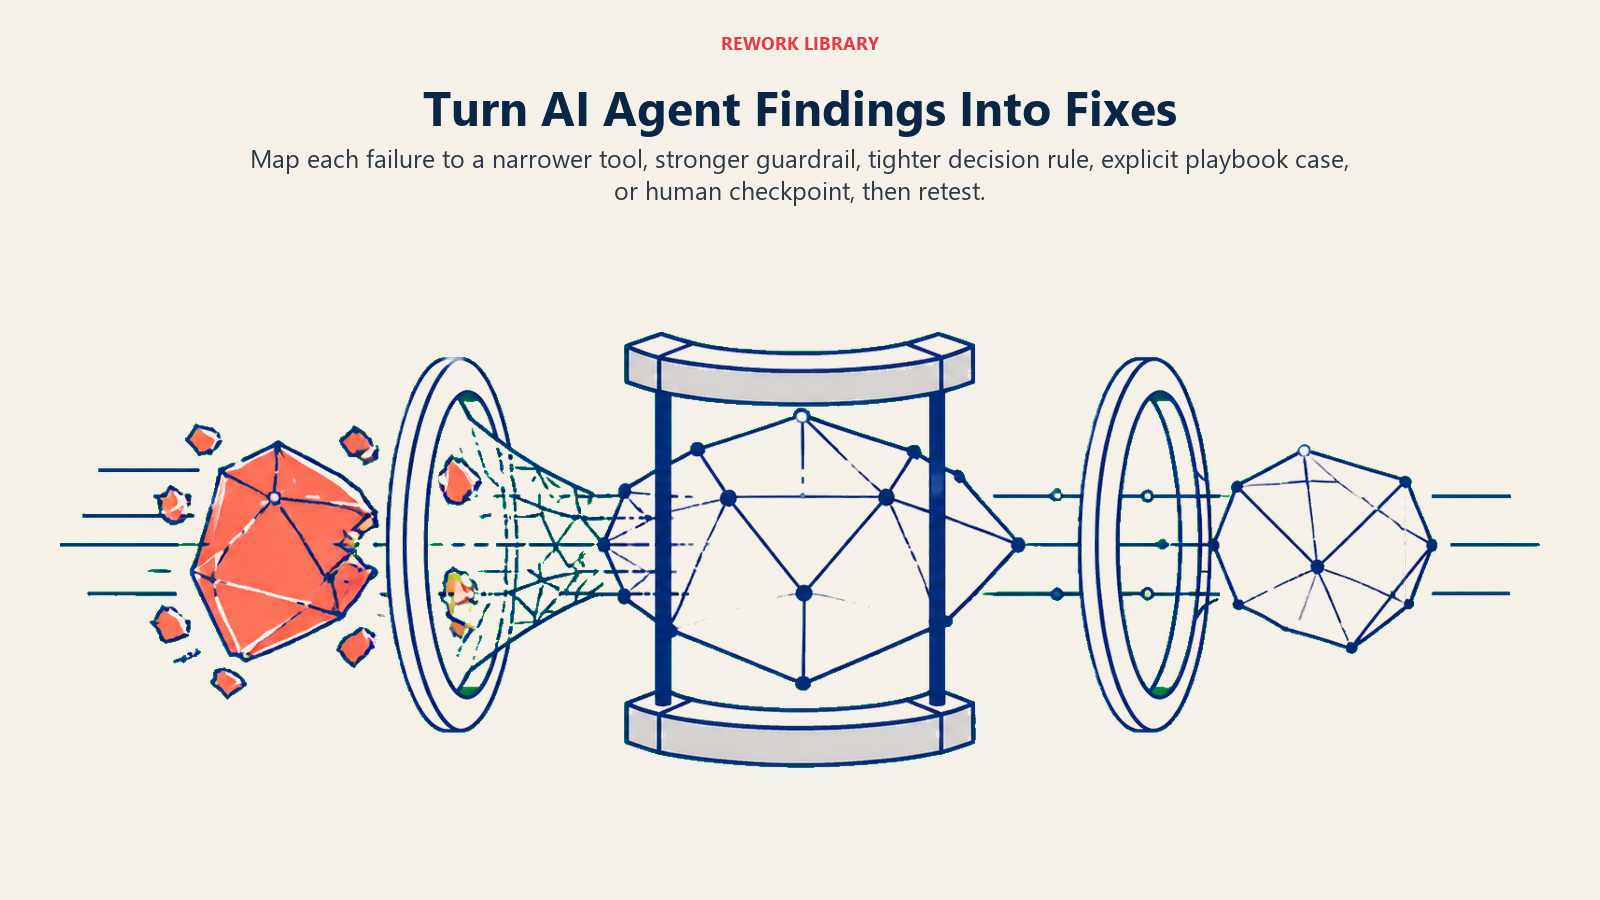
Guardrail AI agent membahas prinsip allow-list di atas deny-list yang akhirnya diperkuat oleh sebagian besar temuan red team: lebih mudah dan lebih aman mendaftar persis apa yang boleh dilakukan agent daripada mencoba mendaftar semua yang tidak boleh. Dan ketika temuan mengungkap kasus yang benar-benar membutuhkan penilaian dan bukan aturan yang lebih ketat, itu sinyal untuk titik pemeriksaan human-in-the-loop, bukan pagar pengaman yang lebih rumit yang mencoba mengodekan penilaian yang sebenarnya tidak dapat dibuatnya. Audit-Or-Block Rule dari pola Autonomous Agent adalah penopang yang berguna untuk apa pun yang tidak dapat dituntaskan red team sepenuhnya: jika agent tidak dapat menghasilkan jejak keputusan lengkap untuk sebuah tindakan, ia tidak boleh diizinkan mengambil tindakan itu sendiri, bagaimanapun hasil pengujiannya.
Membangun Kebiasaan Pengujian Tanpa Tim Keamanan Khusus
Sebagian besar tim yang membangun beberapa agent pertama tidak memiliki red team di staf, dan itu bukan alasan untuk melewatkan ini. Mulailah dengan agent berdampak tertinggi yang Anda jalankan, yang menyentuh uang, data pelanggan, atau mengirim komunikasi eksternal, dan minta seseorang dengan sengaja mencoba merusaknya memakai kasus historis nyata sebelum peluncuran: apa input terburuk yang secara realistis bisa Anda terima, dan apa yang dilakukan agent terhadapnya. Latihan tunggal itu, jika dilakukan dengan jujur, menangkap lebih banyak daripada yang diperkirakan kebanyakan tim.
Dari sana, layanan red-teaming eksternal dan alat pengujian adversarial otomatis dapat memperluas cakupan tanpa mengharuskan Anda membangun kemampuan itu sendiri, terutama begitu Anda menjalankan cukup banyak agent sehingga pengujian manual saja tidak akan mencukupi. Jika Anda mengevaluasi platform untuk membangun atau menjalankan agent, tanyakan langsung bagaimana mereka mendukung jenis pengujian ini sebelum berkomitmen. Perbandingan developer tools kami dan cara memilih platform DevOps sama-sama membahas pertanyaan pengujian dan pipeline yang layak diajukan, platform agent mana pun yang akhirnya Anda pilih.
Key Facts
- OWASP Top 10 for Agentic Applications 2026 disusun bersama lebih dari 100 pakar industri dan menamai risiko, seperti goal hijacking, penyalahgunaan alat, dan kegagalan berantai, yang tidak muncul dalam red team yang hanya berfokus pada model.
- Teknik serangan khusus agent mencapai tingkat keberhasilan pembajakan tugas 81% dalam pengujian yang berafiliasi dengan NIST, dibandingkan 11% untuk serangan baseline yang dikenal, menunjukkan bahwa red teaming generik sangat meremehkan eksposur sebenarnya.
- Pengujian yang sama menemukan tingkat keberhasilan percobaan tunggal sekitar 57% naik menjadi 80% dengan 25 percobaan berulang, itulah sebabnya menguji agent sekali lalu menyatakannya aman bukanlah pengujian yang sebenarnya.
- Program percontohan ARIA dari NIST melibatkan sekitar 51 red teamer dalam 508 sesi pada tujuh aplikasi AI, titik acuan yang berguna untuk seperti apa skala pengujian yang ketat.
- Temuan red team hanya berarti jika mengubah alat, pagar pengaman, logika keputusan, atau playbook agent. Uji ulang setelah perubahan apa pun pada prompt, alat, atau model, bukan hanya sekali sebelum peluncuran.
Pertanyaan yang Sering Diajukan tentang Red Teaming AI Agent
Apa itu red teaming untuk AI agent?
Itu adalah praktik sengaja menyerang agent sebelum lawan sungguhan melakukannya: menguji apakah konten beracun, instruksi ambigu, atau kasus tepi dapat membuatnya menyalahgunakan alat, membocorkan data, atau bertindak di luar lingkup yang dimaksudkan, lalu memperbaiki apa yang rusak.
Apa bedanya me-red team agent dengan me-red team chatbot atau model?
Red teaming model menguji apa yang akan dikatakan sebuah sistem. Red teaming agent menguji apa yang akan dilakukannya, karena agent yang termakan serangan dapat memanggil alat dan mengubah kesalahan itu menjadi tindakan nyata, bukan sekadar respons buruk yang ditangkap seseorang sebelum berdampak.
Apa itu OWASP Top 10 for Agentic Applications?
Kerangka kerja, yang disusun bersama lebih dari 100 pakar industri, yang menamai risiko keamanan khusus sistem AI otonom: di antaranya goal hijacking, penyalahgunaan alat, penyalahgunaan hak akses, kegagalan berantai antar-agent, dan perilaku agent liar. Ini checklist yang berguna untuk menentukan apa yang sebenarnya harus diuji oleh red team khusus agent.
Seberapa sering sebaiknya agent di-red team?
Minimal sebelum peluncuran, dan lagi setelah setiap perubahan berarti pada prompt, daftar alat, atau model dasar. Untuk agent dengan akses ke uang, data pelanggan, atau komunikasi eksternal, uji ulang per kuartal adalah batas bawah yang wajar.
Apakah perlu tim keamanan khusus untuk me-red team agent?
Tidak. Mulailah dengan meminta seseorang sengaja mencoba merusak agent berdampak tertinggi Anda memakai kasus historis nyata sebelum peluncuran. Layanan red-teaming eksternal dan alat pengujian adversarial otomatis dapat memperluas cakupan dari sana saat Anda menjalankan lebih banyak agent daripada yang bisa diimbangi pengujian manual saja.
Langkah Selanjutnya
Red teaming memberi tahu Anda di mana pertahanan agent benar-benar jebol. Prompt injection adalah serangan spesifik yang layak dipahami mendalam terlebih dahulu, karena ia titik masuk di balik sebagian besar temuan yang diungkap red team. Guardrail AI agent adalah sisi implementasinya, apa yang sebenarnya Anda uji dan perkuat, dan observabilitas AI agent adalah cara menangkap apa yang terlewat oleh red team setelah agent berjalan langsung.
