Red Teaming de AI Agents: Testes Adversariais para Sistemas Autônomos
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Fazer red teaming de um AI agent significa atacá-lo de propósito antes que um adversário real o faça: alimentá-lo com documentos contaminados, instruções ambíguas e casos de borda criados para fazê-lo usar mal uma ferramenta, vazar dados ou agir fora do seu escopo, e depois documentar exatamente o que quebrou. Vai além do red teaming de um chatbot ou de um modelo simples, porque um agent que cai em um ataque não gera apenas uma frase ruim: ele pode chamar uma ferramenta e transformar o erro em uma ação real. Este artigo explica o que muda quando o sistema testado pode agir, a superfície de ataque exclusiva dos agents e como construir um hábito de testes em torno disso, em vez de um evento único antes do lançamento.
Em Que Isso Difere do Red Teaming de um Modelo
O red teaming de AI, como prática geral, já cobre prompts adversariais, tentativas de jailbreak e avaliação de segurança para qualquer sistema de AI, e tudo nessa disciplina continua valendo para um agent por baixo dos panos. O que muda é a superfície que você ataca. Fazer red teaming de um modelo simples testa o que ele dirá: dá para fazê-lo produzir conteúdo nocivo, vazar dados de treinamento ou contradizer o seu treinamento de segurança. Fazer red teaming de um agent testa o que ele fará: dá para fazê-lo chamar uma ferramenta que não deveria, agir com base em um fato em que nunca deveria ter confiado ou concluir uma tarefa de várias etapas de um jeito que silenciosamente faz a coisa errada enquanto parece bem-sucedido.
Essa distinção se alinha à fronteira Generate vs Execute que atravessa o design de agents em geral. Um modelo induzido a uma etapa Generate ruim produz um parágrafo ruim que alguém pode pegar antes que importe. Um agent induzido a uma etapa Execute ruim já enviou o e-mail, emitiu o reembolso ou alterou o registro. Fazer red teaming de um agent é, especificamente, a prática de testar a etapa Execute sob pressão adversarial, e não apenas o raciocínio que leva até ela.
A Superfície de Ataque Específica dos Agents
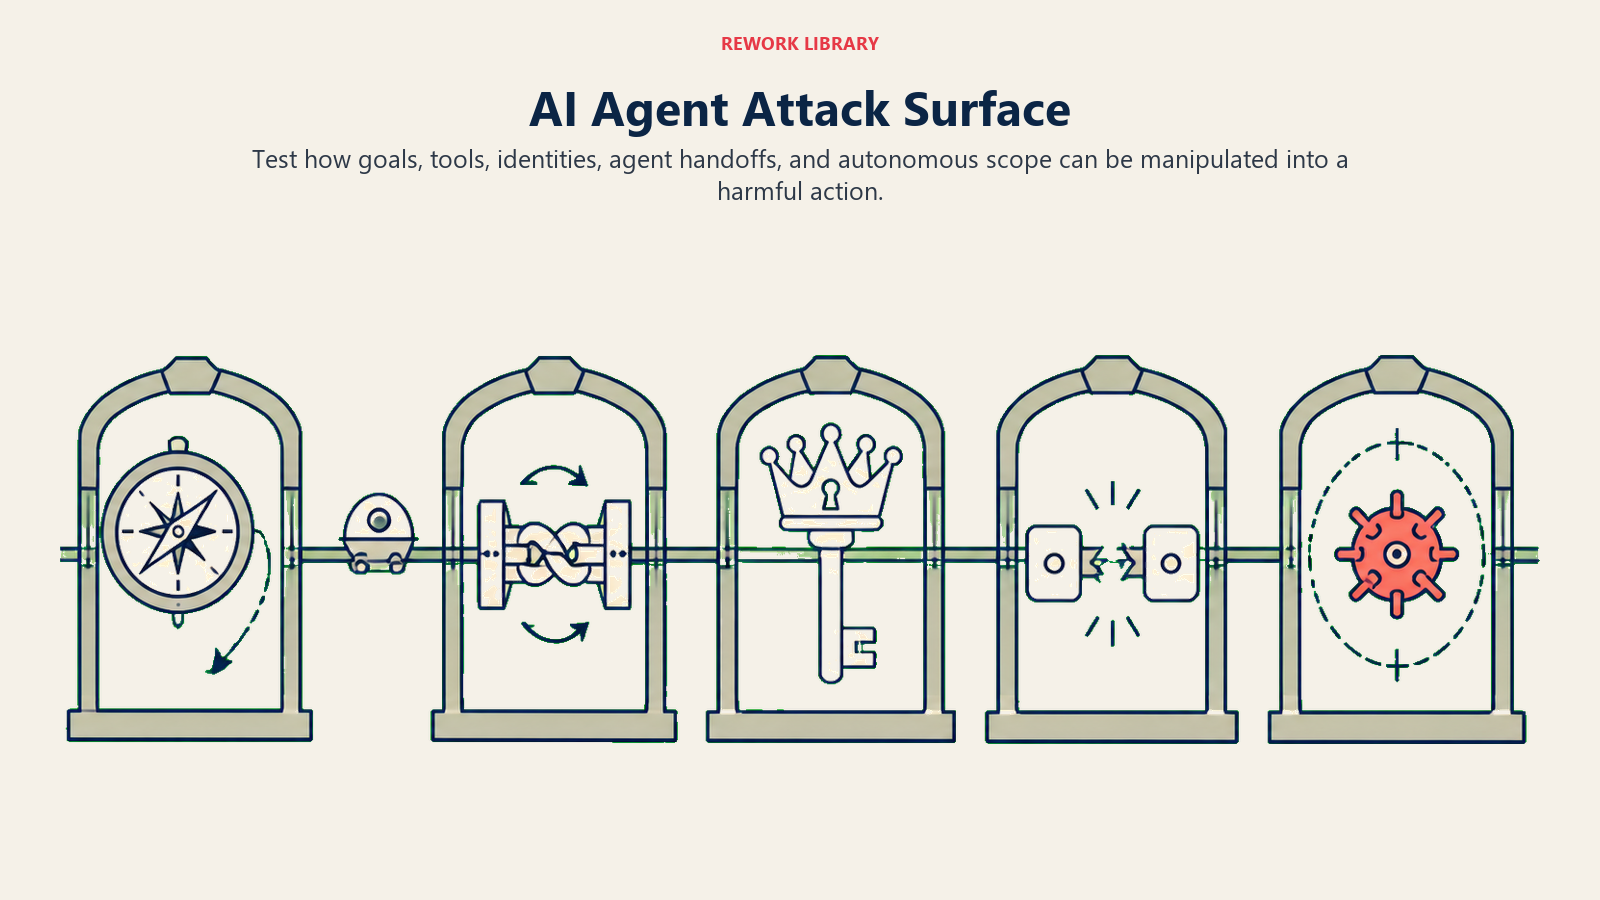
O OWASP Top 10 for Agentic Applications 2026, construído em colaboração com mais de 100 especialistas, pesquisadores e profissionais do setor, nomeia categorias de risco que vale testar especificamente porque não aparecem em um red team voltado só ao modelo. Algumas que se alinham diretamente a blueprints reais de agents:
| Categoria de risco | O que testa | Onde aparece |
|---|---|---|
| Sequestro de objetivo | Instruções ocultas em conteúdo que o agent lê conseguem redirecionar a tarefa real dele | Um agent que responde apenas a partir de uma base de conhecimento, induzido por um documento contaminado a recomendar a coisa errada |
| Uso indevido de ferramentas | Uma entrada ambígua consegue fazer o agent chamar a ferramenta certa do jeito errado, ou encadear ferramentas até um resultado não pretendido | Um AI Invoice AP Agent manipulado para associar uma fatura ao pedido de compra errado |
| Abuso de identidade e de privilégios | O agent pode ser levado a reutilizar credenciais ou a escalar o acesso além da sua tarefa | Um AI Access Provisioning Agent induzido a conceder um acesso elevado que deveria ter sinalizado |
| Falhas em cascata | A saída ruim de um agent vira a entrada ruim de outro em uma configuração multiagente | Transferências dentro de um sistema multiagente que não validam o que recebem |
| Comportamento fora de controle | Um agent comprometido permanece dentro do escopo autorizado enquanto persegue em silêncio o objetivo errado | Se um AI Security Monitoring Agent realmente perceberia isso acontecendo em outro lugar |
A mecânica do ponto de entrada mais comum, o prompt injection, é abordada em profundidade em outra parte desta biblioteca. O trabalho de um red team com esse risco específico não é explicá-lo de novo. É provar se as suas defesas reais contra ele se sustentam.
O Que um Teste Adversarial de Verdade Faz de Diferente
Um red team que tenta o ataque óbvio uma vez e segue em frente vai perder quase tudo o que importa. A nota de pesquisa de 2026 da Cloud Security Alliance sobre a orientação do NIST para red teaming de AI agents constatou que técnicas de ataque inéditas e específicas para agents alcançaram uma taxa de sucesso de 81% no sequestro de tarefas, contra apenas 11% dos ataques de referência conhecidos mais fortes. Testar um agent com padrões de ataque genéricos e publicamente conhecidos subestima drasticamente o quão exposto ele realmente está.
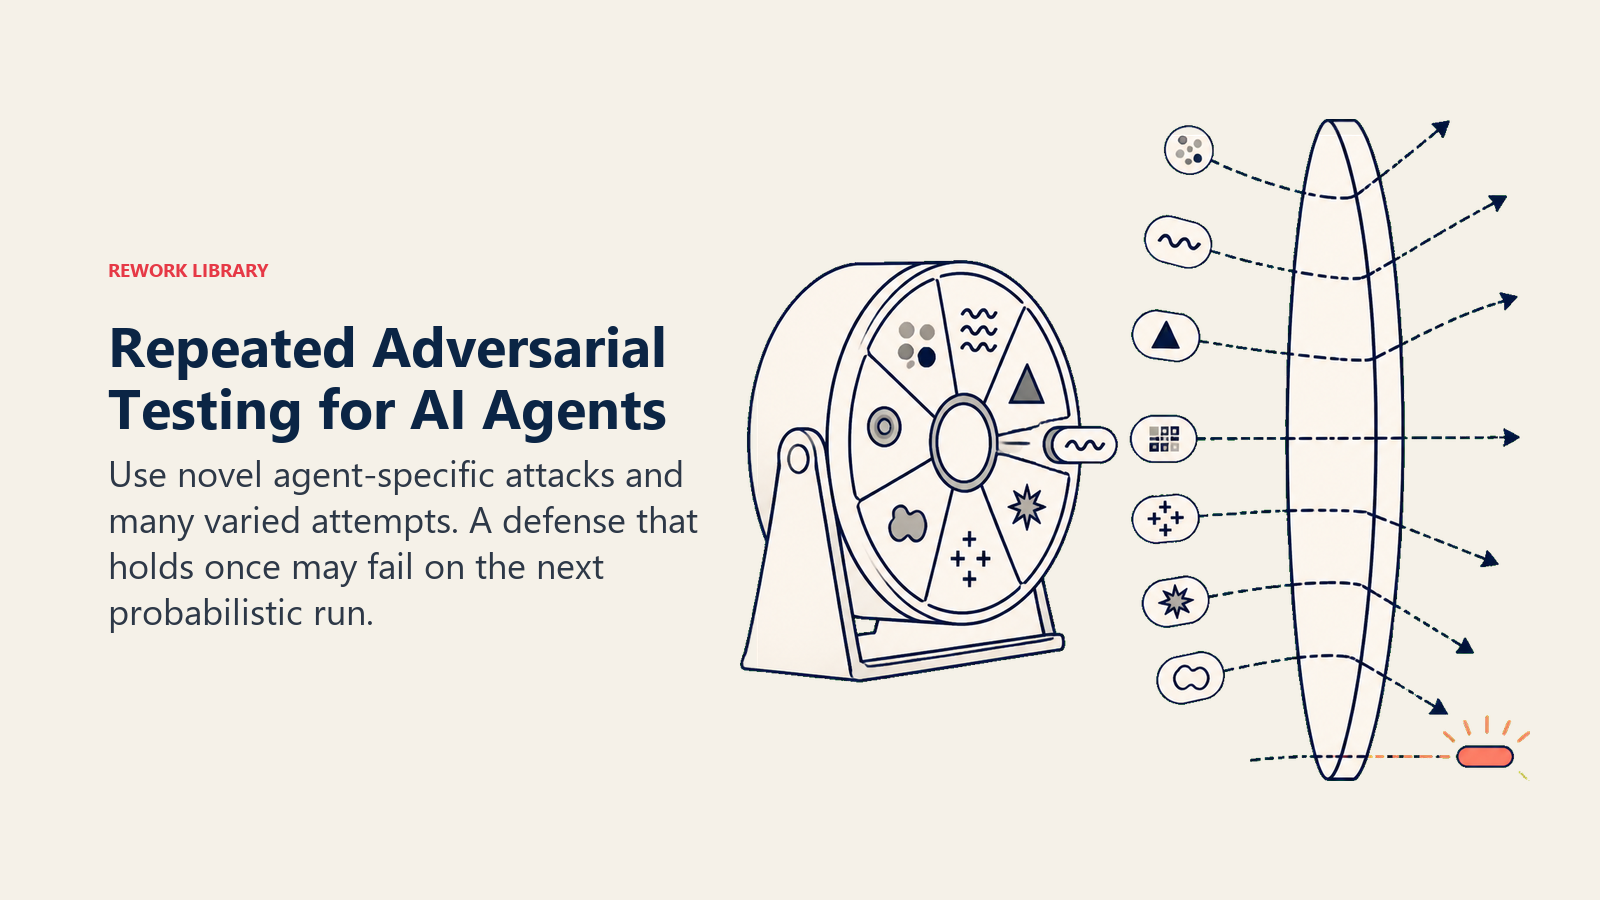
A repetição importa tanto quanto a técnica. A mesma pesquisa constatou taxas de sucesso de tentativa única com média de 57%, subindo para 80% quando um red teamer teve 25 tentativas repetidas na mesma tarefa. Os agents são probabilísticos, então uma defesa que se sustentou uma vez pode falhar na tentativa seguinte com uma formulação ligeiramente diferente. O programa-piloto do próprio NIST por trás desses dados, o ARIA, reuniu cerca de 51 red teamers em 508 sessões de teste sobre sete aplicações de AI submetidas, uma referência útil do que é um teste realmente rigoroso diante de uma passada interna rápida.
Algumas técnicas que vale incorporar aos seus próprios testes, qualquer que seja a escala:
- Contamine o conteúdo, não a conversa. Esconda o ataque em um documento, e-mail ou página da web que o agent é solicitado a processar, do jeito que um injection indireto real chegaria, em vez de digitá-lo direto numa caixa de chat.
- Teste a transferência, não só a recusa. Não verifique apenas se o agent bloqueia uma ação ruim. Verifique se ele reconhece corretamente os casos que deveriam ser escalados a um humano e tente montar um caso desenhado para parecer rotineiro quando na verdade exige julgamento.
- Ataque a memória, não só um único turno. Insira um fato falso no início de uma sessão ou tarefa e verifique se o agent ainda confia nele várias etapas depois.
- Repita a tentativa. Uma única passada não diz quase nada sobre um sistema probabilístico. Execute o mesmo padrão de ataque várias vezes, com pequenas variações, antes de concluir que uma defesa se sustenta.
Manual, Automatizado e Contínuo, Aplicados a Agents
A prática geral de red teaming já distingue o teste manual (uma pessoa atacando o sistema de forma criativa) do automatizado (variantes de ataque geradas e executadas em escala) e do contínuo (permanente, e não um portão único). Para agents em particular, os três têm o seu lugar em momentos diferentes.
Faça uma passada manual antes do lançamento, focada nos cenários específicos do manual do próprio agent, os casos que a sua equipe realmente espera que ele trate. Uma biblioteca genérica de ataques pega fraquezas genéricas; uma passada manual de alguém que conhece o trabalho real do agent pega as específicas da sua implantação. Adicione testes automatizados em maior escala quando tiver uma linha de base, já que eles conseguem executar muito mais variações do que uma pessoa tem tempo de fazer. Depois, continue testando em um cronograma, e não apenas uma vez. Refaça os testes após qualquer mudança no prompt, na lista de ferramentas ou no modelo subjacente, porque uma defesa que se sustentou contra a versão do modelo do trimestre passado pode falhar em silêncio contra esta. O AI 600-1 Generative AI Profile do NIST enquadra isso na sua função MEASURE: a gestão de riscos não está completa até que você tenha testado se um controle se sustenta sob pressão adversarial, e não apenas confirmado que ele existe no papel. Para agents com acesso de escrita a dinheiro, dados de clientes ou comunicação externa, o trimestral é um piso razoável, e não um teto.
Transformando Achados em Correções
Um relatório de red team que não muda a configuração do agent é um documento, não uma defesa. Todo achado real deve voltar a um dos seis blocos de construção com os quais um agent é montado: uma ferramenta que se mostrou ampla demais no escopo é estreitada, uma barreira de proteção ausente é adicionada, uma regra de lógica de decisão que deixou passar um caso ruim é endurecida, ou um cenário que deveria ter sido escalado e não foi é adicionado explicitamente ao manual.
As barreiras de proteção de AI agents tratam do princípio de lista de permissão em vez de lista de bloqueio, que a maioria dos achados de red team acaba reforçando: é mais fácil e mais seguro enumerar exatamente o que um agent pode fazer do que tentar listar tudo o que ele não deveria. E, quando um achado revela um caso que realmente exige julgamento, e não uma regra mais rígida, isso é um sinal para um ponto de controle human-in-the-loop, e não para uma barreira mais complicada tentando codificar um julgamento que ela não consegue de fato fazer. A Audit-Or-Block Rule do padrão Autonomous Agent é um respaldo útil para tudo o que um red team não consegue liberar por completo: se o agent não consegue produzir um rastro completo de decisão para uma ação, ele não deve ter permissão para tomá-la por conta própria, independentemente de como o teste correu.
Construindo um Hábito de Testes Sem uma Equipe de Segurança Dedicada
A maioria das equipes que constroem seus primeiros agents não tem um red team na equipe, e isso não é motivo para pular esta etapa. Comece pelo agent de maior consequência que você opera, aquele que mexe com dinheiro, dados de clientes ou envia comunicação externa, e peça a alguém que tente quebrá-lo de propósito, usando casos históricos reais, antes do lançamento: qual é a pior entrada que você poderia realisticamente receber e o que o agent faz com ela. Esse único exercício, feito com honestidade, pega mais do que a maioria das equipes espera.
A partir daí, serviços externos de red teaming e ferramentas automatizadas de testes adversariais podem ampliar a cobertura sem exigir que você construa a capacidade internamente, sobretudo quando você já roda agents suficientes para que o teste manual sozinho não escale. Se você está avaliando plataformas para construir ou hospedar agents, pergunte diretamente como elas apoiam esse tipo de teste antes de se comprometer. Nossas comparações de ferramentas de dev e como escolher uma plataforma de DevOps cobrem as perguntas sobre testes e pipeline que vale fazer, qualquer que seja a plataforma de agents em que você pouse.
Key Facts
- O OWASP Top 10 for Agentic Applications 2026 foi construído com mais de 100 especialistas do setor e nomeia riscos, como sequestro de objetivo, uso indevido de ferramentas e falhas em cascata, que não aparecem em um red team voltado só ao modelo.
- Técnicas de ataque específicas para agents alcançaram uma taxa de sucesso de 81% no sequestro de tarefas em testes ligados ao NIST, contra 11% dos ataques de referência conhecidos, mostrando que um red teaming genérico subestima muito a exposição real.
- Os mesmos testes constataram taxas de sucesso de tentativa única em torno de 57%, subindo para 80% com 25 tentativas repetidas, e é por isso que testar um agent uma vez e dá-lo como liberado não é um teste de verdade.
- O programa-piloto ARIA do NIST reuniu cerca de 51 red teamers em 508 sessões sobre sete aplicações de AI, um ponto de referência útil da escala de um teste rigoroso.
- Um achado de red team só importa se mudar as ferramentas, as barreiras de proteção, a lógica de decisão ou o manual do agent. Refaça os testes após qualquer mudança no prompt, nas ferramentas ou no modelo, e não apenas uma vez antes do lançamento.
Perguntas Frequentes sobre Red Teaming de AI Agents
O que é red teaming para AI agents?
É a prática de atacar um agent de propósito antes que um adversário real o faça: testar se conteúdo contaminado, instruções ambíguas ou casos de borda conseguem levá-lo a usar mal uma ferramenta, vazar dados ou agir fora do escopo pretendido, e depois corrigir o que quebrar.
Em que o red teaming de um agent difere do red teaming de um chatbot ou de um modelo?
O red teaming de um modelo testa o que um sistema dirá. O red teaming de um agent testa o que ele fará, já que um agent que cai em um ataque pode chamar uma ferramenta e transformar o erro em uma ação real, e não apenas em uma resposta ruim que alguém pega antes que importe.
O que é o OWASP Top 10 for Agentic Applications?
Um framework, construído com mais de 100 especialistas do setor, que nomeia os riscos de segurança específicos de sistemas de AI autônomos: sequestro de objetivo, uso indevido de ferramentas, abuso de privilégios, falhas em cascata entre agents e comportamento fora de controle, entre outros. É um checklist útil para definir o que um red team específico para agents deve de fato testar.
Com que frequência se deve fazer red teaming de um agent?
No mínimo antes do lançamento, e de novo após qualquer mudança relevante no prompt, na lista de ferramentas ou no modelo subjacente. Para agents com acesso a dinheiro, dados de clientes ou comunicação externa, um novo teste trimestral é um piso razoável.
É preciso uma equipe de segurança dedicada para fazer red teaming de um agent?
Não. Comece pedindo a alguém que tente quebrar de propósito o seu agent de maior consequência, usando casos históricos reais, antes do lançamento. Serviços externos de red teaming e ferramentas automatizadas de testes adversariais podem ampliar a cobertura a partir daí, à medida que você roda mais agents do que o teste manual sozinho consegue acompanhar.
Para Onde Ir Agora
O red teaming mostra onde as defesas de um agent realmente se rompem. O prompt injection é o ataque específico que vale entender primeiro em profundidade, já que é o ponto de entrada por trás da maioria dos achados que um red team revela. As barreiras de proteção de AI agents são o lado da implementação, o que você de fato está testando e reforçando, e a observabilidade de AI agents é como você pega o que um red team deixou passar depois que o agent está no ar.

On this page
- Em Que Isso Difere do Red Teaming de um Modelo
- A Superfície de Ataque Específica dos Agents
- O Que um Teste Adversarial de Verdade Faz de Diferente
- Manual, Automatizado e Contínuo, Aplicados a Agents
- Transformando Achados em Correções
- Construindo um Hábito de Testes Sem uma Equipe de Segurança Dedicada
- Key Facts
- Para Onde Ir Agora