Red Teaming von AI Agents: Adversariales Testen für autonome Systeme
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Red Teaming eines AI Agents heißt, ihn gezielt anzugreifen, bevor es ein echter Gegner tut: Sie füttern ihn mit manipulierten Dokumenten, mehrdeutigen Anweisungen und Randfällen, die ihn dazu bringen sollen, ein Tool zu missbrauchen, Daten preiszugeben oder außerhalb seines Zuständigkeitsbereichs zu handeln, und dokumentieren dann genau, was gebrochen ist. Das geht weiter als Red Teaming für einen Chatbot oder ein reines Modell, denn ein Agent, der auf einen Angriff hereinfällt, erzeugt nicht nur einen schlechten Satz, er kann ein Tool aufrufen und den Fehler in eine echte Aktion verwandeln. Dieser Artikel behandelt, was sich ändert, wenn das getestete System handeln kann, die Angriffsfläche, die nur Agents haben, und wie Sie daraus eine Testgewohnheit machen statt eines einmaligen Ereignisses vor dem Start.
Worin sich das vom Red Teaming eines Modells unterscheidet
AI Red Teaming als allgemeine Praxis umfasst bereits adversariales Prompting, Jailbreak-Versuche und Sicherheitsbewertung für jedes AI-System, und alles aus dieser Disziplin gilt darunter weiterhin auch für einen Agent. Anders ist die Fläche, die Sie angreifen. Red Teaming eines reinen Modells testet, was es sagen wird: Können Sie es dazu bringen, schädliche Inhalte zu erzeugen, Trainingsdaten preiszugeben oder seinem Sicherheitstraining zu widersprechen? Red Teaming eines Agents testet, was er tun wird: Können Sie ihn dazu bringen, ein Tool aufzurufen, das er nicht aufrufen sollte, auf eine Tatsache zu handeln, der er nie hätte trauen dürfen, oder eine mehrstufige Aufgabe so abzuschließen, dass er unauffällig das Falsche tut, während es erfolgreich aussieht?
Diese Unterscheidung entspricht der Grenze zwischen Generate und Execute, die sich allgemein durch das Agent-Design zieht. Ein Modell, das zu einem schlechten Generate-Schritt verleitet wird, erzeugt einen schlechten Absatz, den jemand abfangen kann, bevor es darauf ankommt. Ein Agent, der zu einem schlechten Execute-Schritt verleitet wird, hat die E-Mail bereits gesendet, die Rückerstattung ausgelöst oder den Datensatz geändert. Red Teaming eines Agents ist gezielt die Praxis, den Execute-Schritt unter adversarialem Druck zu testen, nicht nur die Argumentation davor.
Die agentenspezifische Angriffsfläche
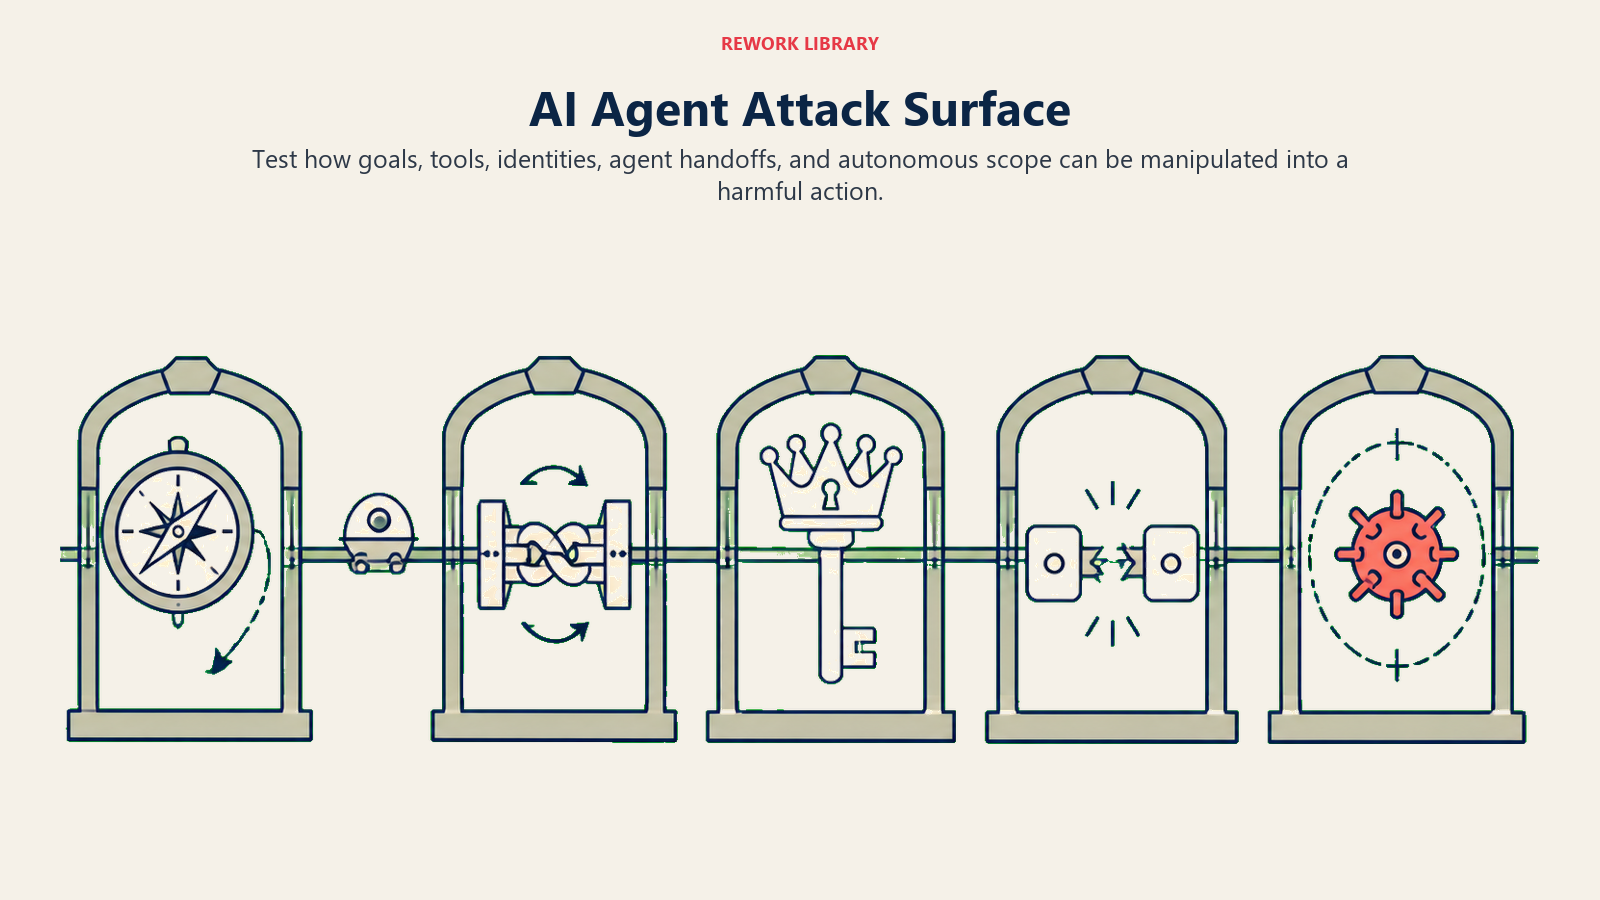
Die OWASP Top 10 für Agentic Applications 2026, entstanden in Zusammenarbeit mit über 100 Branchenexperten, Forschenden und Praktikern, benennen Risikokategorien, auf die sich gezielt zu testen lohnt, weil sie bei einem reinen Modell-Red-Team nicht auftauchen. Einige davon lassen sich direkt auf echte Agent-Blueprints abbilden:
| Risikokategorie | Was sie testet | Wo sie auftritt |
|---|---|---|
| Goal Hijacking | Können versteckte Anweisungen in Inhalten, die der Agent liest, seine eigentliche Aufgabe umlenken | Ein Agent, der nur aus einer Knowledge Base antwortet, wird von einem manipulierten Dokument dazu gebracht, das Falsche zu empfehlen |
| Tool-Missbrauch | Kann eine mehrdeutige Eingabe den Agent dazu bringen, das richtige Tool falsch aufzurufen oder Tools zu einem unbeabsichtigten Ergebnis zu verketten | Ein AI Invoice AP Agent, der manipuliert wird, eine Rechnung der falschen Bestellung zuzuordnen |
| Missbrauch von Identität und Rechten | Lässt sich der Agent dazu bringen, Zugangsdaten wiederzuverwenden oder seinen Zugriff über seine Aufgabe hinaus auszuweiten | Ein AI Access Provisioning Agent, der dazu gebracht wird, erhöhten Zugriff zu gewähren, den er hätte melden müssen |
| Kaskadierende Fehler | Wird die schlechte Ausgabe eines Agents in einem Multi-Agent-Aufbau zur schlechten Eingabe eines anderen | Übergaben in einem Multi-Agent System, die das Empfangene nicht validieren |
| Abtrünniges Verhalten | Bleibt ein kompromittierter Agent in seinem autorisierten Zuständigkeitsbereich, während er unauffällig das falsche Ziel verfolgt | Ob ein AI Security Monitoring Agent das anderswo tatsächlich bemerken würde |
Die Mechanik des häufigsten Einstiegspunkts, Prompt Injection, wird an anderer Stelle in dieser Library ausführlich behandelt. Die Aufgabe eines Red Teams bei diesem konkreten Risiko ist nicht, es noch einmal zu erklären, sondern zu beweisen, ob Ihre tatsächlichen Abwehrmaßnahmen dagegen halten.
Was ein echter adversarialer Test anders macht
Ein Red Team, das den offensichtlichen Angriff nur einmal versucht und weiterzieht, übersieht fast alles, was zählt. Die Forschungsnotiz 2026 der Cloud Security Alliance zu den Red-Teaming-Leitlinien des NIST für AI Agents stellte fest, dass neuartige, agentenspezifische Angriffstechniken eine Erfolgsquote von 81 % beim Task Hijacking erreichten, verglichen mit nur 11 % für die stärksten bekannten Basisangriffe. Einen Agent mit generischen, öffentlich bekannten Angriffsmustern zu testen, unterschätzt erheblich, wie exponiert er tatsächlich ist.
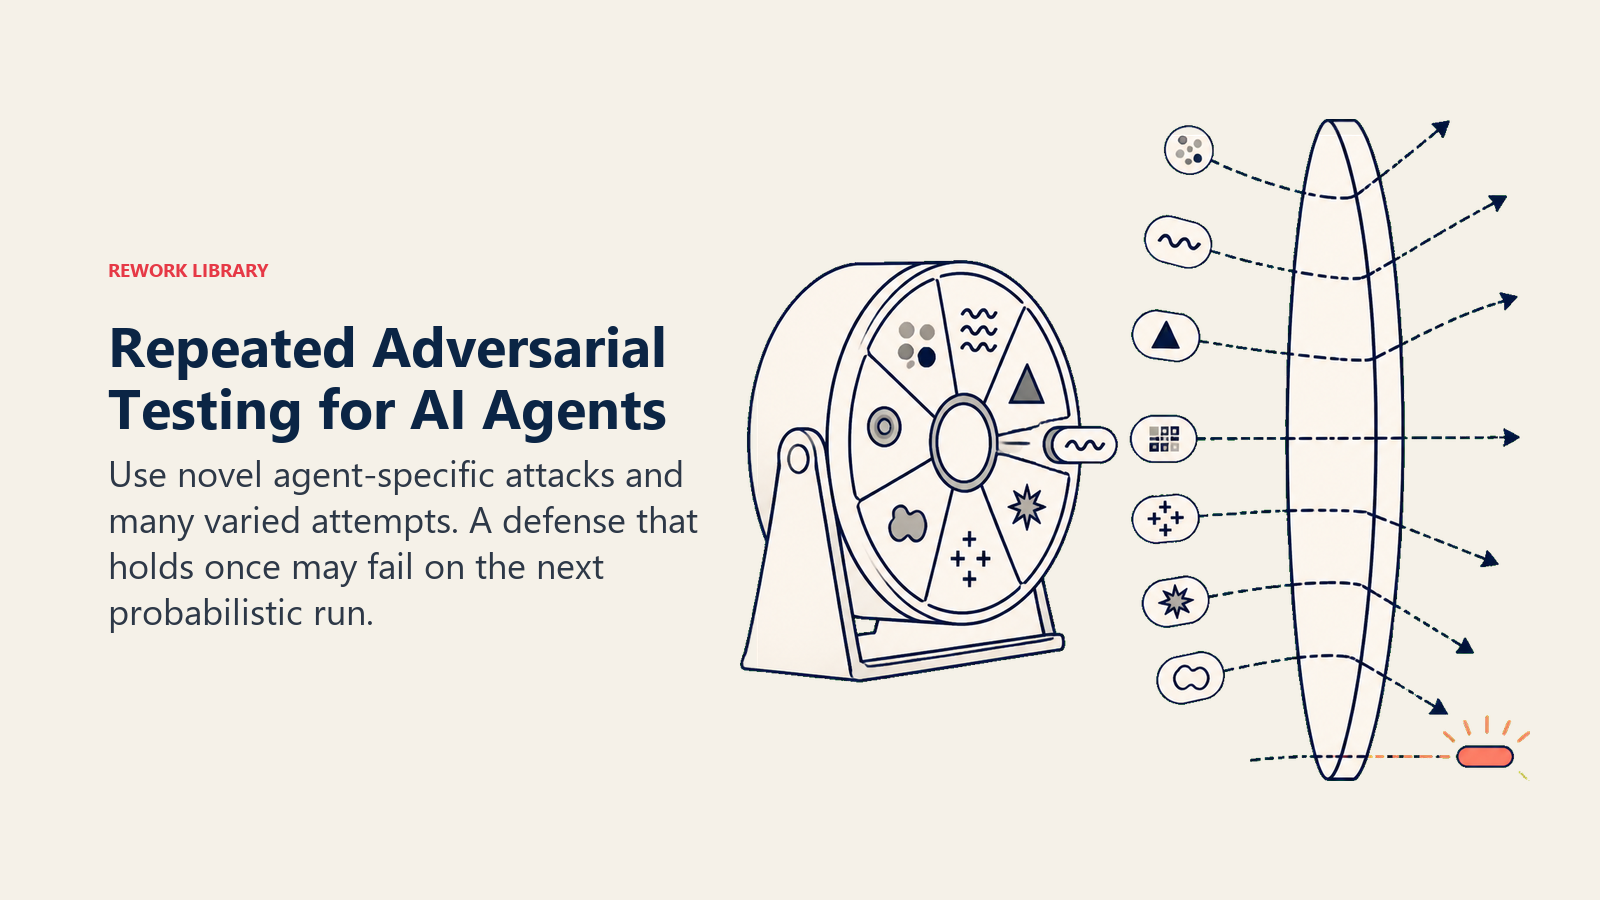
Wiederholung zählt ebenso viel wie Technik. Dieselbe Forschung fand Erfolgsquoten bei einem einzelnen Versuch von durchschnittlich 57 %, die auf 80 % stiegen, sobald ein Red Teamer 25 wiederholte Versuche an derselben Aufgabe hatte. Agents sind probabilistisch, daher kann eine Abwehr, die einmal hielt, beim nächsten Versuch mit leicht anderer Formulierung versagen. Das NIST-Pilotprogramm hinter diesen Daten, ARIA, setzte rund 51 Red Teamer in 508 Testsitzungen an sieben eingereichten AI-Anwendungen ein, ein nützlicher Maßstab dafür, wie wirklich rigoroses Testen im Vergleich zu einem schnellen internen Durchlauf aussieht.
Einige Techniken, die Sie unabhängig vom Umfang in Ihr eigenes Testen einbauen sollten:
- Manipulieren Sie den Inhalt, nicht das Gespräch. Verstecken Sie den Angriff in einem Dokument, einer E-Mail oder einer Webseite, die der Agent verarbeiten soll, so wie eine echte indirekte Injection ankäme, statt ihn direkt in ein Chatfenster zu tippen.
- Testen Sie die Übergabe, nicht nur die Verweigerung. Prüfen Sie nicht nur, ob der Agent eine schlechte Aktion blockiert. Prüfen Sie, ob er Fälle richtig erkennt, die an einen Menschen eskalieren sollten, und versuchen Sie, einen Fall zu konstruieren, der routinemäßig aussieht, aber tatsächlich Urteilsvermögen braucht.
- Greifen Sie das Memory an, nicht nur einen einzelnen Gesprächszug. Geben Sie früh in einer Sitzung oder Aufgabe einen falschen Fakt ein und prüfen Sie, ob der Agent ihm mehrere Schritte später noch vertraut.
- Wiederholen Sie den Versuch. Ein einzelner Durchlauf sagt bei einem probabilistischen System fast nichts. Führen Sie dasselbe Angriffsmuster mehrfach mit kleinen Variationen aus, bevor Sie schließen, dass eine Abwehr hält.
Manuell, automatisiert und kontinuierlich, angewendet auf Agents
Die allgemeine Praxis des Red Teamings unterscheidet bereits zwischen manuellem Testen (ein Mensch greift das System kreativ an), automatisiertem Testen (generierte Angriffsvarianten im großen Maßstab) und kontinuierlichem Testen (fortlaufend, nicht als einmalige Hürde). Für Agents haben alle drei an unterschiedlichen Stellen ihren Platz.
Führen Sie vor dem Start einen manuellen Durchlauf durch, der sich auf die konkreten Szenarien im Playbook Ihres Agents konzentriert, die Fälle, die Ihr Team tatsächlich erwartet. Eine generische Angriffsbibliothek findet generische Schwächen; ein manueller Durchlauf durch jemanden, der die tatsächliche Aufgabe des Agents kennt, findet die, die für Ihren Einsatz spezifisch sind. Ergänzen Sie automatisiertes Testen im größeren Maßstab, sobald Sie eine Baseline haben, denn es kann weit mehr Variationen durchlaufen, als ein Mensch Zeit hat. Testen Sie dann nach Zeitplan weiter, nicht nur einmal. Testen Sie nach jeder Änderung an Prompt, Tool-Liste oder dem zugrunde liegenden Modell erneut, denn eine Abwehr, die gegen die Modellversion des letzten Quartals hielt, kann gegen diese unbemerkt versagen. Das AI 600-1 Generative AI Profile von NIST verortet das unter seiner MEASURE-Funktion: Risikomanagement ist nicht abgeschlossen, bis Sie getestet haben, ob eine Kontrolle unter adversarialem Druck hält, und nicht nur bestätigt haben, dass sie auf dem Papier existiert. Für Agents mit Schreibzugriff auf Geld, Kundendaten oder externe Kommunikation ist vierteljährlich eine vernünftige Untergrenze, keine Obergrenze.
Aus Befunden Korrekturen machen
Ein Red-Team-Bericht, der die Konfiguration des Agents nicht ändert, ist ein Dokument, keine Abwehr. Jeder echte Befund sollte auf einen der sechs Bausteine zurückgeführt werden, aus denen ein Agent besteht: Ein Tool, das sich als zu weit gefasst erwies, wird eingeengt, eine fehlende Leitplanke wird ergänzt, eine Regel der Entscheidungslogik, die einen schlechten Fall durchließ, wird verschärft, oder ein Szenario, das hätte eskalieren sollen, es aber nicht tat, wird ausdrücklich ins Playbook aufgenommen.
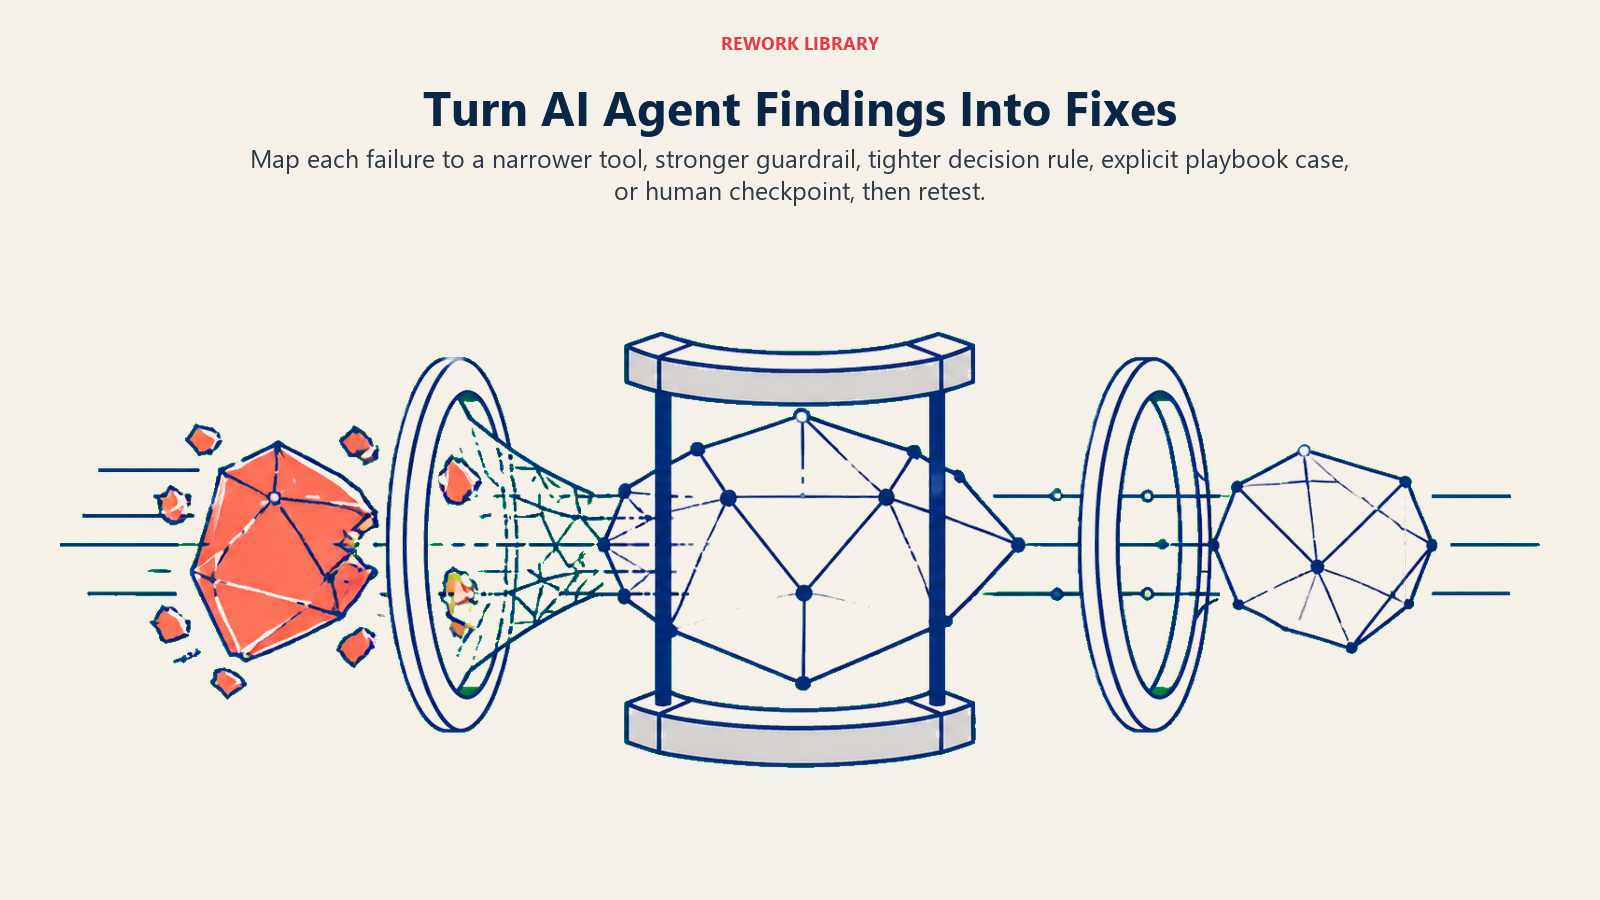
AI-Agent-Leitplanken behandelt das Prinzip „Allow-List statt Deny-List“, das die meisten Red-Team-Befunde am Ende bestätigen: Es ist einfacher und sicherer, genau aufzuzählen, was ein Agent tun darf, als zu versuchen, alles aufzulisten, was er nicht tun soll. Und wenn ein Befund einen Fall offenlegt, der wirklich Urteilsvermögen braucht statt einer strengeren Regel, ist das ein Signal für eine Human-in-the-Loop-Kontrollstelle und nicht für eine kompliziertere Leitplanke, die versucht, ein Urteil zu kodieren, das sie gar nicht fällen kann. Die Audit-or-Block-Regel des Autonomous-Agent-Musters ist ein nützlicher Rückhalt für alles, was ein Red Team nicht vollständig ausräumen kann: Kann der Agent für eine Aktion keine vollständige Entscheidungsspur liefern, darf er diese Aktion nicht eigenständig ausführen, unabhängig davon, wie der Test ausging.
Eine Testgewohnheit aufbauen, ohne dediziertes Security-Team
Die meisten Teams, die ihre ersten Agents bauen, haben kein Red Team im Haus, und das ist kein Grund, darauf zu verzichten. Beginnen Sie mit dem Agent mit den schwerwiegendsten Folgen, den, der Geld oder Kundendaten berührt oder externe Kommunikation versendet, und lassen Sie vor dem Start jemanden gezielt versuchen, ihn mit echten historischen Fällen zu brechen: Was ist die schlimmste Eingabe, die Sie realistisch bekommen könnten, und was tut der Agent damit? Diese eine Übung, ehrlich durchgeführt, findet mehr, als die meisten Teams erwarten.
Von dort aus können externe Red-Teaming-Dienste und automatisierte Tools für adversariales Testen die Abdeckung erweitern, ohne dass Sie die Fähigkeit intern aufbauen müssen, besonders sobald Sie so viele Agents betreiben, dass manuelles Testen allein nicht mehr skaliert. Wenn Sie Plattformen zum Bauen oder Hosten von Agents bewerten, fragen Sie vor der Festlegung direkt nach, wie sie diese Art des Testens unterstützen. Unsere Vergleiche von Entwickler-Tools und So wählen Sie eine DevOps-Plattform behandeln beide die Test- und Pipeline-Fragen, die Sie unabhängig von der gewählten Agent-Plattform stellen sollten.
Key Facts
- Die OWASP Top 10 für Agentic Applications 2026 entstanden mit über 100 Branchenexperten und benennen Risiken wie Goal Hijacking, Tool-Missbrauch und kaskadierende Fehler, die bei einem reinen Modell-Red-Team nicht auftauchen.
- Agentenspezifische Angriffstechniken erreichten in NIST-nahen Tests eine Erfolgsquote von 81 % beim Task Hijacking, gegenüber 11 % bei bekannten Basisangriffen. Generisches Red Teaming unterschätzt die reale Exposition also massiv.
- Dieselben Tests ergaben Erfolgsquoten bei einem einzelnen Versuch von rund 57 %, die mit 25 wiederholten Versuchen auf 80 % stiegen. Deshalb ist es kein echter Test, einen Agent einmal zu testen und für sicher zu erklären.
- Das ARIA-Pilotprogramm des NIST setzte rund 51 Red Teamer in 508 Sitzungen an sieben AI-Anwendungen ein, ein nützlicher Referenzpunkt dafür, wie ein rigoroser Testumfang aussieht.
- Ein Red-Team-Befund zählt nur, wenn er die Tools, Leitplanken, Entscheidungslogik oder das Playbook des Agents verändert. Testen Sie nach jeder Änderung an Prompt, Tools oder Modell erneut, nicht nur einmal vor dem Start.
Häufig gestellte Fragen zu Red Teaming von AI Agents
Was ist Red Teaming für AI Agents?
Es ist die Praxis, einen Agent gezielt anzugreifen, bevor es ein echter Gegner tut: Sie testen, ob manipulierte Inhalte, mehrdeutige Anweisungen oder Randfälle ihn dazu bringen können, ein Tool zu missbrauchen, Daten preiszugeben oder außerhalb seines vorgesehenen Zuständigkeitsbereichs zu handeln, und beheben dann, was bricht.
Worin unterscheidet sich Red Teaming eines Agents von dem eines Chatbots oder Modells?
Modell-Red-Teaming testet, was ein System sagen wird. Agent-Red-Teaming testet, was er tun wird, denn ein Agent, der auf einen Angriff hereinfällt, kann ein Tool aufrufen und den Fehler in eine echte Aktion verwandeln, nicht nur in eine schlechte Antwort, die jemand abfängt, bevor es darauf ankommt.
Was sind die OWASP Top 10 für Agentic Applications?
Ein Framework, entstanden mit über 100 Branchenexperten, das die Sicherheitsrisiken autonomer AI-Systeme benennt, darunter Goal Hijacking, Tool-Missbrauch, Rechtemissbrauch, kaskadierende Fehler zwischen Agents und abtrünniges Agent-Verhalten. Es ist eine nützliche Checkliste, um einzugrenzen, was ein agentenspezifisches Red Team tatsächlich testen sollte.
Wie oft sollte man einen Agent einem Red Teaming unterziehen?
Mindestens vor dem Start und erneut nach jeder wesentlichen Änderung an Prompt, Tool-Liste oder dem zugrunde liegenden Modell. Für Agents mit Zugriff auf Geld, Kundendaten oder externe Kommunikation ist ein vierteljährlicher erneuter Test eine vernünftige Untergrenze.
Braucht man ein dediziertes Security-Team, um einen Agent einem Red Teaming zu unterziehen?
Nein. Beginnen Sie damit, dass jemand vor dem Start gezielt versucht, Ihren Agent mit den schwerwiegendsten Folgen anhand echter historischer Fälle zu brechen. Externe Red-Teaming-Dienste und automatisierte Tools für adversariales Testen können die Abdeckung von dort aus erweitern, wenn Sie mehr Agents betreiben, als manuelles Testen allein bewältigen kann.
Wie es weitergeht
Red Teaming zeigt Ihnen, wo die Abwehr eines Agents tatsächlich bricht. Prompt Injection ist der konkrete Angriff, den man zuerst im Detail verstehen sollte, denn er ist der Einstiegspunkt hinter den meisten Befunden, die ein Red Team zutage fördert. AI-Agent-Leitplanken ist die Umsetzungsseite, also das, was Sie tatsächlich testen und verstärken, und AI Agent Observability zeigt, wie Sie auffangen, was ein Red Team übersehen hat, sobald der Agent live ist.

On this page
- Worin sich das vom Red Teaming eines Modells unterscheidet
- Die agentenspezifische Angriffsfläche
- Was ein echter adversarialer Test anders macht
- Manuell, automatisiert und kontinuierlich, angewendet auf Agents
- Aus Befunden Korrekturen machen
- Eine Testgewohnheit aufbauen, ohne dediziertes Security-Team
- Key Facts
- Wie es weitergeht