Red Teaming AI Agent: Ujian Adversarial untuk Sistem Autonomi
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Red teaming AI agent bermaksud sengaja menyerangnya sebelum musuh sebenar berbuat demikian: menyuapkan dokumen beracun, arahan kabur, dan kes pinggiran yang direka untuk membuatnya menyalahgunakan alat, membocorkan data, atau bertindak di luar skopnya, kemudian mendokumentasikan dengan tepat apa yang rosak. Ia melangkaui red teaming chatbot atau model biasa, kerana agent yang terpedaya dengan serangan bukan sekadar menjana ayat yang buruk, ia boleh memanggil alat dan menukar kesilapan itu menjadi tindakan sebenar. Artikel ini merangkumi apa yang berubah apabila sistem yang diuji boleh bertindak, permukaan serangan yang unik kepada agent, dan cara membina tabiat ujian di sekelilingnya dan bukan acara sekali sahaja sebelum pelancaran.
Perbezaannya daripada Red Teaming Model
Red teaming AI sebagai amalan umum sudah merangkumi prompt adversarial, percubaan jailbreak, dan penilaian keselamatan untuk mana-mana sistem AI, dan semua yang ada dalam disiplin itu masih terpakai kepada agent di bawahnya. Yang berbeza ialah permukaan yang anda serang. Red teaming model biasa menguji apa yang akan dikatakannya: bolehkah anda membuatnya menghasilkan kandungan berbahaya, membocorkan data latihan, atau bercanggah dengan latihan keselamatannya. Red teaming agent menguji apa yang akan dilakukannya: bolehkah anda membuatnya memanggil alat yang tidak sepatutnya, bertindak berdasarkan fakta yang tidak patut dipercayainya, atau menyiapkan tugas berbilang langkah dengan cara yang senyap-senyap melakukan perkara yang salah sambil kelihatan berjaya.
Perbezaan itu selari dengan sempadan Generate berbanding Execute yang menembusi reka bentuk agent secara umum. Model yang terpedaya ke dalam langkah Generate yang buruk menghasilkan perenggan buruk yang boleh ditangkap seseorang sebelum ia penting. Agent yang terpedaya ke dalam langkah Execute yang buruk sudah menghantar e-mel, mengeluarkan bayaran balik, atau menukar rekod. Red teaming agent secara khusus ialah amalan menguji langkah Execute di bawah tekanan adversarial, bukan sekadar penaakulan yang membawa kepadanya.
Permukaan Serangan Khusus Agent
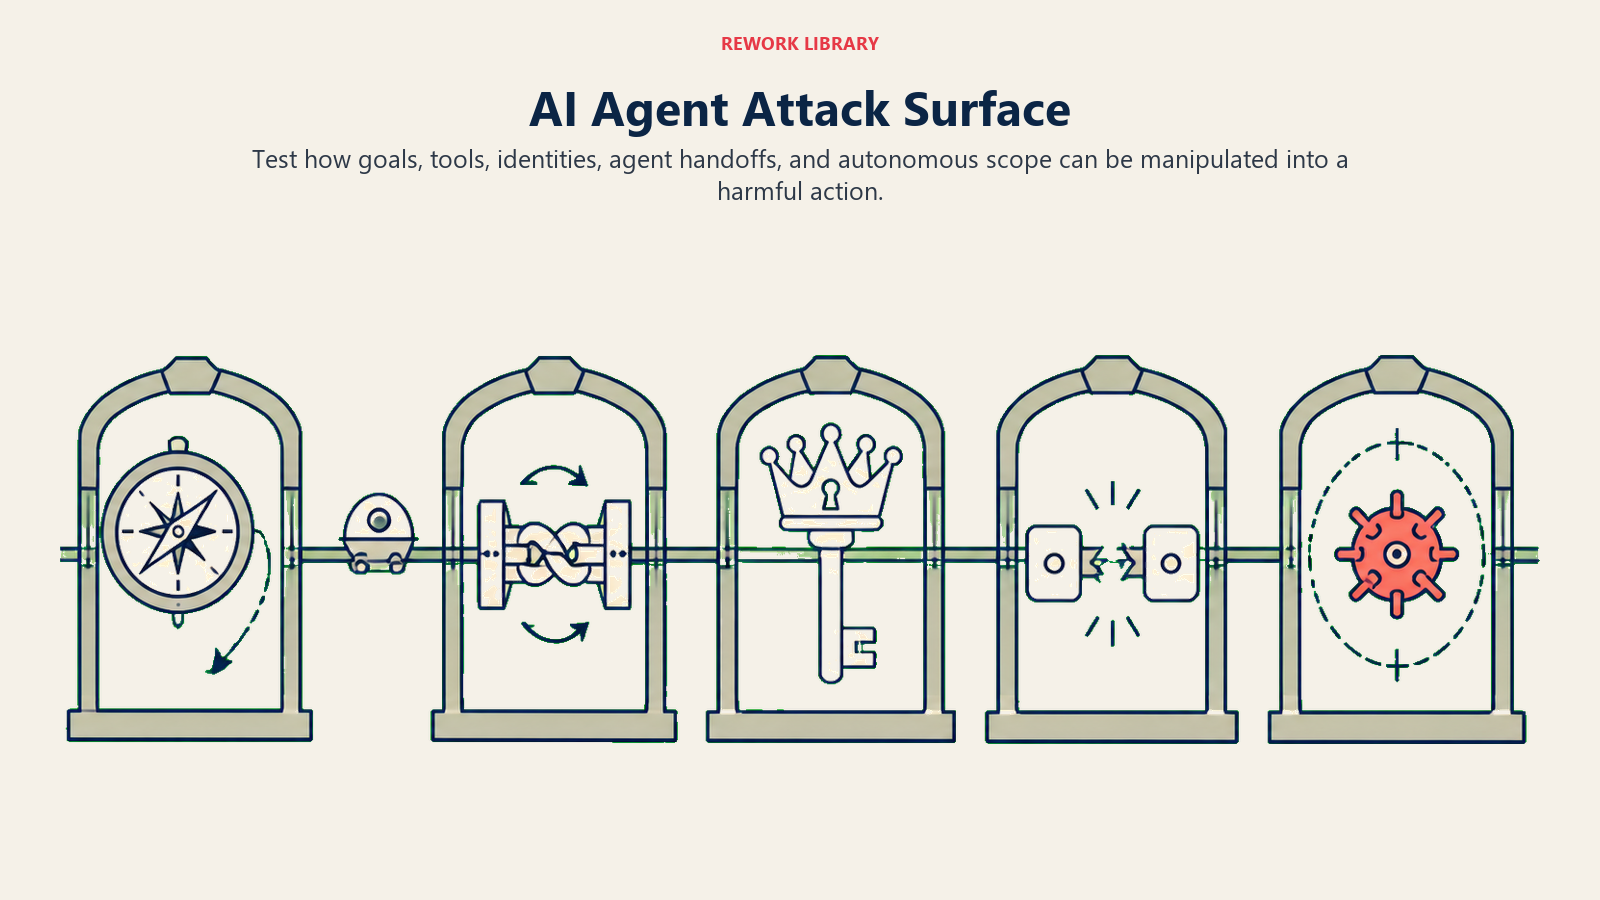
OWASP Top 10 untuk Aplikasi Agentic 2026, yang dibina melalui kerjasama lebih 100 pakar industri, penyelidik, dan pengamal, menamakan kategori risiko yang wajar diuji secara khusus kerana ia tidak muncul dalam red team model sahaja. Beberapa yang selari terus dengan pelan agent sebenar:
| Kategori risiko | Apa yang diuji | Di mana ia muncul |
|---|---|---|
| Rampasan matlamat | Bolehkah arahan tersembunyi dalam kandungan yang dibaca agent mengubah hala tugas sebenarnya | Agent yang menjawab hanya daripada knowledge base, diperdaya oleh dokumen beracun supaya mengesyorkan perkara yang salah |
| Penyalahgunaan alat | Bolehkah input kabur membuat agent memanggil alat yang betul dengan cara yang salah, atau merantai alat kepada hasil yang tidak dimaksudkan | AI Invoice AP Agent yang dimanipulasi supaya memadankan invois dengan pesanan belian yang salah |
| Penyalahgunaan identiti dan keistimewaan | Bolehkah agent didesak menggunakan semula kelayakan atau meningkatkan akses melebihi tugasnya | AI Access Provisioning Agent yang diperdaya supaya memberikan akses tinggi yang sepatutnya ditandakannya |
| Kegagalan berantai | Adakah output buruk satu agent menjadi input buruk agent lain dalam susunan multi-agent | Serahan dalam sistem multi-agent yang tidak mengesahkan apa yang diterima |
| Tingkah laku liar | Adakah agent yang terjejas kekal dalam skop yang dibenarkan sambil senyap-senyap mengejar objektif yang salah | Sama ada AI Security Monitoring Agent benar-benar akan menangkap perkara ini berlaku di tempat lain |
Mekanik pintu masuk paling lazim, prompt injection, dibincangkan secara mendalam di tempat lain dalam pustaka ini. Tugas red team dengan risiko khusus itu bukan untuk menerangkannya semula. Ia untuk membuktikan sama ada pertahanan sebenar anda terhadapnya bertahan.
Apa yang Dilakukan Secara Berbeza oleh Ujian Adversarial Sebenar
Red team yang hanya mencuba serangan yang jelas sekali lalu meneruskan akan terlepas hampir semua perkara yang penting. Nota penyelidikan Cloud Security Alliance 2026 tentang panduan red-teaming AI agent NIST mendapati bahawa teknik serangan baharu khusus agent mencapai kadar kejayaan perampasan tugas sebanyak 81%, berbanding hanya 11% untuk serangan asas yang diketahui paling kuat. Menguji agent dengan corak serangan generik yang diketahui umum sangat memperkecilkan betapa terdedahnya ia sebenarnya.
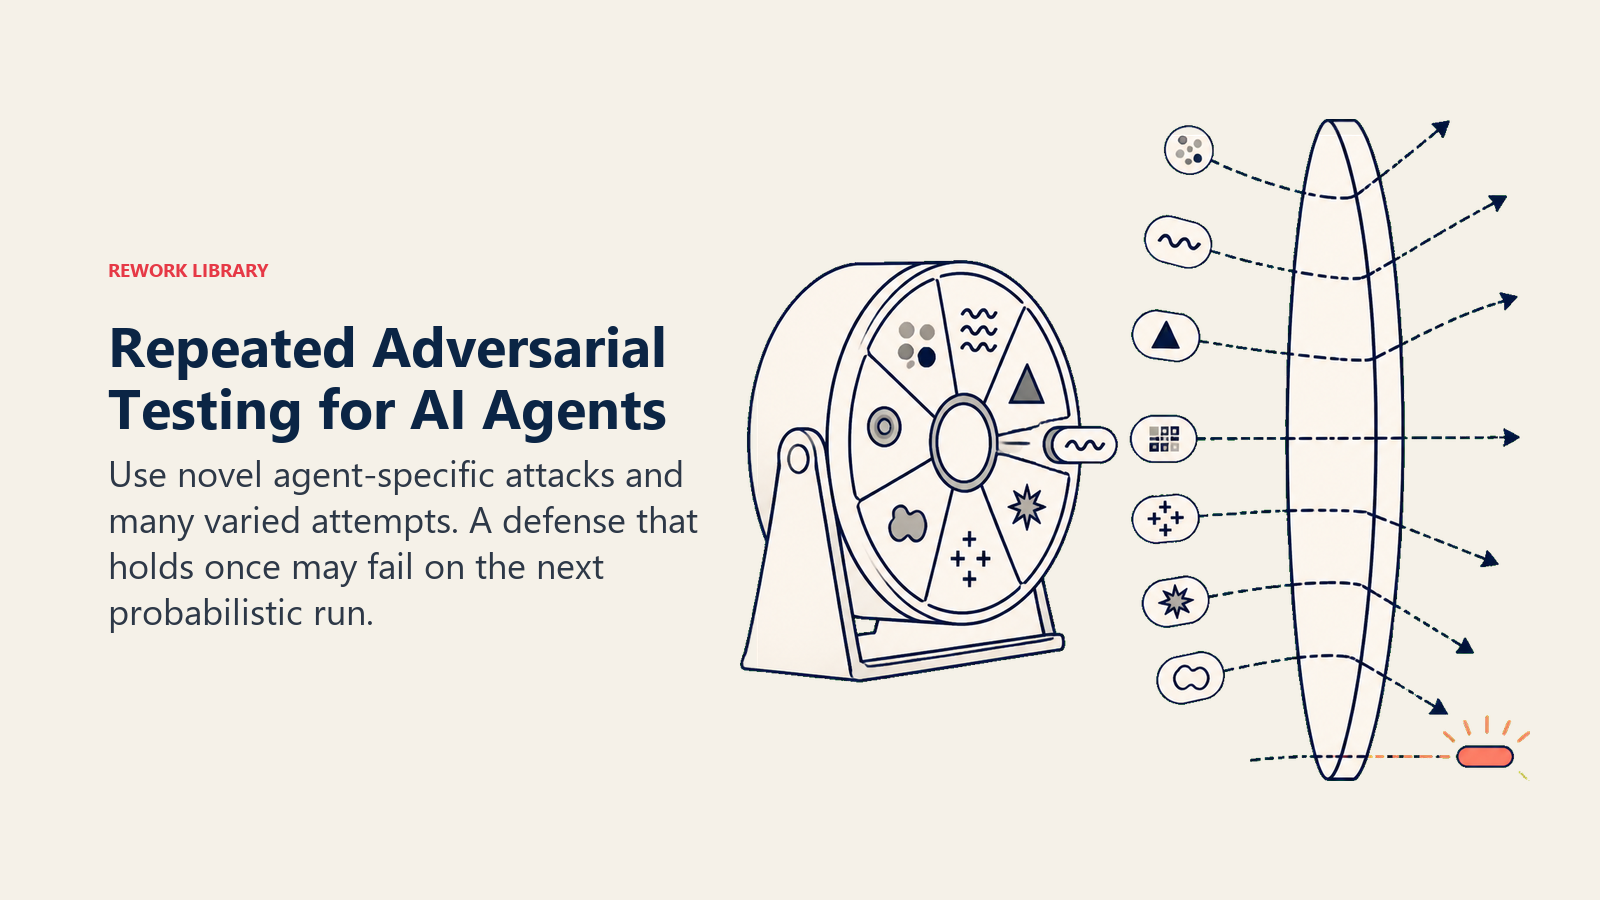
Pengulangan sama pentingnya dengan teknik. Penyelidikan yang sama mendapati kadar kejayaan percubaan tunggal purata 57%, meningkat kepada 80% apabila red teamer diberi 25 percubaan berulang pada tugas yang sama. Agent bersifat probabilistik, jadi pertahanan yang bertahan sekali mungkin gagal pada percubaan seterusnya dengan frasa yang sedikit berbeza. Program perintis NIST sendiri di sebalik data ini, ARIA, menjalankan kira-kira 51 red teamer merentasi 508 sesi ujian ke atas tujuh aplikasi AI yang dihantar, penanda aras berguna untuk rupa ujian yang benar-benar ketat berbanding semakan dalaman yang pantas.
Beberapa teknik yang wajar dibina ke dalam ujian anda sendiri tanpa mengira skala:
- Racunkan kandungan, bukan perbualan. Sembunyikan serangan dalam dokumen, e-mel, atau laman web yang diminta agent untuk diproses, seperti cara injection tidak langsung sebenar tiba, dan bukan menaipnya terus ke dalam kotak sembang.
- Uji serahan, bukan sekadar penolakan. Jangan hanya semak sama ada agent menyekat tindakan buruk. Semak sama ada ia mengenal pasti dengan betul kes yang patut dieskalasikan kepada manusia, dan cuba bina kes yang direka untuk kelihatan rutin sedangkan sebenarnya memerlukan pertimbangan.
- Serang memori, bukan sekadar satu giliran. Suapkan fakta palsu awal dalam sesi atau tugas, dan semak sama ada agent masih mempercayainya beberapa langkah kemudian.
- Ulang percubaan. Satu pusingan tidak memberitahu anda hampir apa-apa tentang sistem probabilistik. Jalankan corak serangan yang sama beberapa kali dengan variasi kecil sebelum menyimpulkan sesuatu pertahanan bertahan.
Manual, Automatik, dan Berterusan, Diterapkan kepada Agent
Amalan umum red teaming sudah membezakan ujian manual (seseorang menyerang sistem dengan kreatif) daripada ujian automatik (varian serangan yang dijana dijalankan pada skala) dan ujian berterusan (berjalan terus, bukan pintu sekali sahaja). Untuk agent secara khusus, ketiga-tiganya mempunyai tempat pada titik berbeza.
Jalankan satu pusingan manual sebelum pelancaran, tertumpu pada senario khusus dalam panduan agent anda sendiri, kes yang benar-benar dijangka dikendalikan oleh pasukan anda. Pustaka serangan generik menangkap kelemahan generik; pusingan manual oleh seseorang yang mengetahui tugas sebenar agent menangkap yang khusus kepada penggunaan anda. Tambah ujian automatik berskala lebih besar sebaik sahaja anda mempunyai garis dasar, kerana ia boleh menjalankan lebih banyak variasi daripada masa yang dimiliki seseorang. Kemudian teruskan menguji mengikut jadual, bukan sekali sahaja. Uji semula selepas sebarang perubahan pada prompt, senarai alat, atau model asas, kerana pertahanan yang bertahan terhadap versi model suku tahun lepas boleh gagal secara senyap terhadap yang ini. Profil AI Generatif AI 600-1 NIST membingkaikan ini di bawah fungsi MEASURE-nya: pengurusan risiko tidak lengkap sehingga anda menguji sama ada sesuatu kawalan bertahan di bawah tekanan adversarial, bukan sekadar mengesahkan ia wujud di atas kertas. Untuk agent dengan akses tulis kepada wang, data pelanggan, atau komunikasi luaran, suku tahunan ialah paras minimum yang munasabah, bukan siling.
Menukar Dapatan kepada Pembaikan
Laporan red team yang tidak mengubah konfigurasi agent ialah dokumen, bukan pertahanan. Setiap dapatan sebenar patut dipetakan kembali kepada salah satu daripada enam blok binaan yang membentuk agent: alat yang ternyata terlalu luas skopnya dikecilkan, pagar pelindung yang tiada ditambah, peraturan logik keputusan yang membenarkan kes buruk lepas diperketat, atau senario yang sepatutnya dieskalasikan tetapi tidak ditambah ke dalam panduan secara eksplisit.
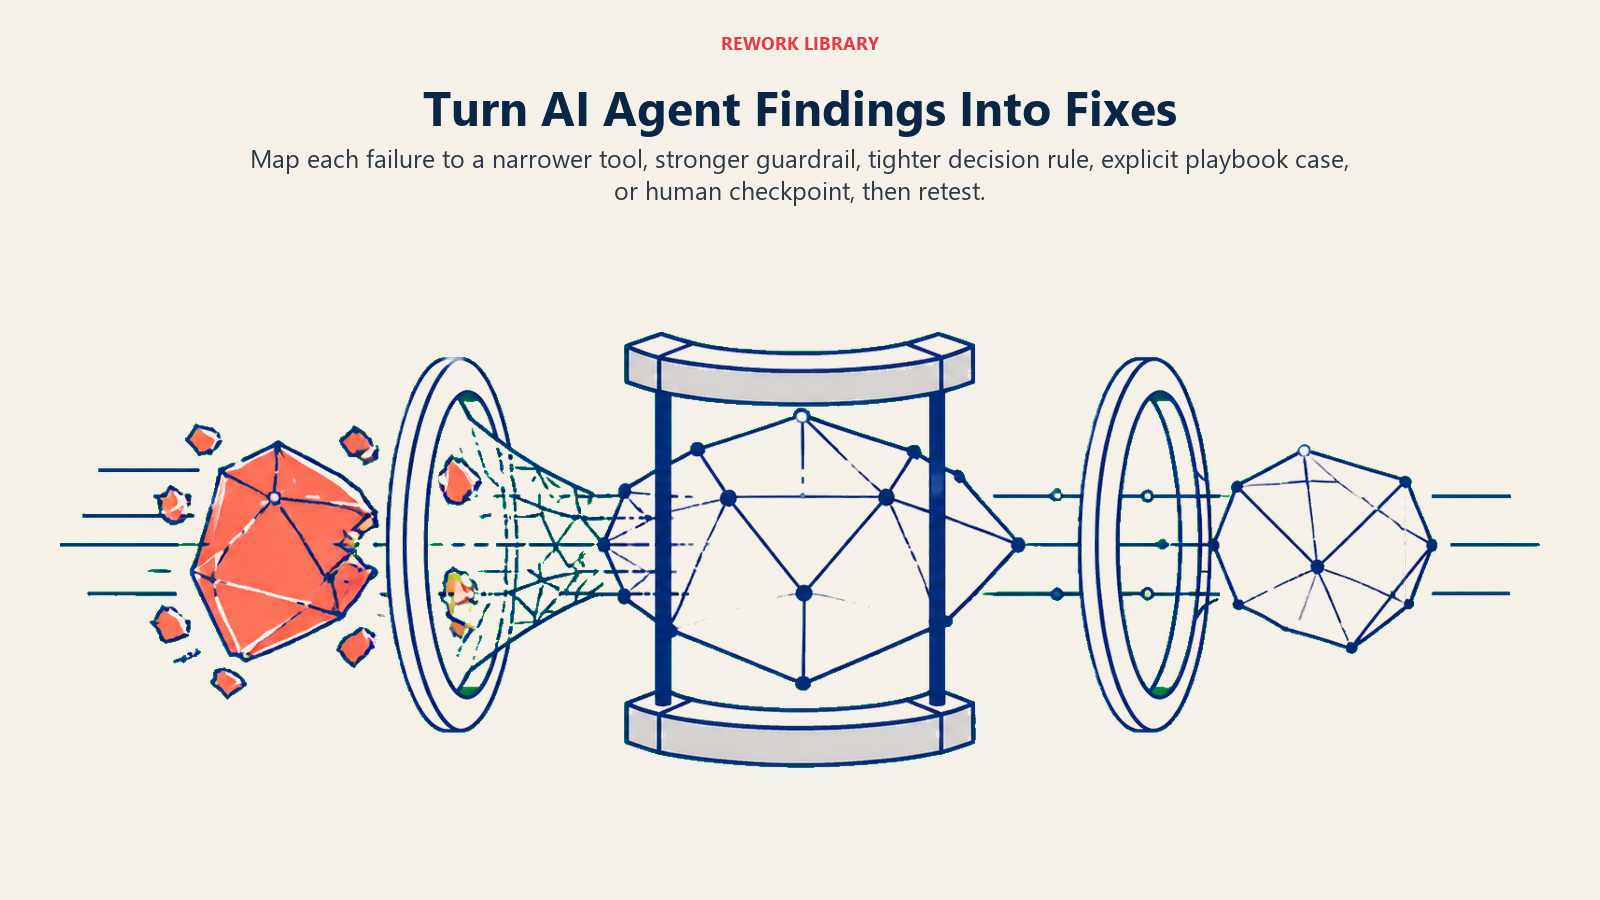
Pagar pelindung AI agent membincangkan prinsip senarai-dibenarkan-mengatasi-senarai-dilarang yang akhirnya diperkukuh oleh kebanyakan dapatan red team: lebih mudah dan lebih selamat menyenaraikan dengan tepat apa yang boleh dilakukan agent berbanding cuba menyenaraikan segala yang tidak sepatutnya. Dan apabila dapatan mendedahkan kes yang benar-benar memerlukan pertimbangan dan bukan peraturan yang lebih ketat, itu isyarat untuk pusat semakan human-in-the-loop, bukan pagar pelindung yang lebih rumit yang cuba mengekodkan pertimbangan yang sebenarnya tidak dapat dibuatnya. Peraturan Audit-Or-Block dalam corak Autonomous Agent ialah sandaran berguna untuk apa-apa yang tidak dapat dibersihkan sepenuhnya oleh red team: jika agent tidak dapat menghasilkan jejak keputusan penuh untuk sesuatu tindakan, ia tidak patut dibenarkan mengambil tindakan itu sendiri, tanpa mengira bagaimana ujian berjalan.
Membina Tabiat Ujian Tanpa Pasukan Keselamatan Khusus
Kebanyakan pasukan yang membina beberapa agent pertama mereka tidak mempunyai red team dalam kakitangan, dan itu bukan sebab untuk melangkau perkara ini. Mulakan dengan agent berimpak paling tinggi yang anda jalankan, yang menyentuh wang, data pelanggan, atau menghantar komunikasi luaran, dan minta seseorang sengaja cuba memecahkannya menggunakan kes sejarah sebenar sebelum pelancaran: apakah input terburuk yang boleh anda terima secara realistik, dan apa yang dilakukan agent dengannya. Satu latihan itu, dilakukan dengan jujur, menangkap lebih banyak daripada yang dijangka kebanyakan pasukan.
Selepas itu, perkhidmatan red-teaming luaran dan alat ujian adversarial automatik boleh meluaskan liputan tanpa memerlukan anda membina keupayaan itu sendiri, terutamanya apabila anda menjalankan cukup banyak agent sehingga ujian manual sahaja tidak dapat berskala. Jika anda menilai platform untuk membina atau menjadi hos agent, tanyakan secara terus bagaimana ia menyokong ujian seperti ini sebelum anda membuat komitmen. Perbandingan alat pembangun kami dan cara memilih platform DevOps kedua-duanya merangkumi soalan ujian dan saluran paip yang wajar ditanya tanpa mengira platform agent mana yang anda pilih.
Fakta Utama
- OWASP Top 10 untuk Aplikasi Agentic 2026 dibina bersama lebih 100 pakar industri dan menamakan risiko, seperti rampasan matlamat, penyalahgunaan alat, dan kegagalan berantai, yang tidak muncul dalam red team model sahaja.
- Teknik serangan khusus agent mencapai kadar kejayaan perampasan tugas 81% dalam ujian yang bersekutu dengan NIST, berbanding 11% untuk serangan asas yang diketahui, menunjukkan bahawa red teaming generik sangat memperkecilkan pendedahan sebenar.
- Ujian yang sama mendapati kadar kejayaan percubaan tunggal sekitar 57% meningkat kepada 80% dengan 25 percubaan berulang, itulah sebabnya menguji agent sekali lalu menganggapnya selamat bukan ujian sebenar.
- Program perintis ARIA NIST menjalankan kira-kira 51 red teamer merentasi 508 sesi ke atas tujuh aplikasi AI, titik rujukan berguna untuk rupa skala ujian yang ketat.
- Dapatan red team hanya penting jika ia mengubah alat, pagar pelindung, logik keputusan, atau panduan agent. Uji semula selepas sebarang perubahan pada prompt, alat, atau model, bukan sekali sahaja sebelum pelancaran.
Soalan Lazim tentang Red Teaming AI Agent
Apakah red teaming untuk AI agent?
Ia amalan sengaja menyerang agent sebelum musuh sebenar berbuat demikian: menguji sama ada kandungan beracun, arahan kabur, atau kes pinggiran boleh membuatnya menyalahgunakan alat, membocorkan data, atau bertindak di luar skop yang dimaksudkan, kemudian membaiki apa yang rosak.
Bagaimana red teaming agent berbeza daripada red teaming chatbot atau model?
Red teaming model menguji apa yang akan dikatakan sesuatu sistem. Red teaming agent menguji apa yang akan dilakukannya, kerana agent yang terpedaya dengan serangan boleh memanggil alat dan menukar kesilapan itu menjadi tindakan sebenar, bukan sekadar respons buruk yang ditangkap seseorang sebelum ia penting.
Apakah OWASP Top 10 untuk Aplikasi Agentic?
Rangka kerja, dibina bersama lebih 100 pakar industri, yang menamakan risiko keselamatan khusus kepada sistem AI autonomi: rampasan matlamat, penyalahgunaan alat, penyalahgunaan keistimewaan, kegagalan berantai antara agent, dan tingkah laku agent liar antaranya. Ia senarai semak berguna untuk menentukan skop apa yang sepatutnya diuji oleh red team khusus agent.
Seberapa kerap anda patut melakukan red team terhadap agent?
Sebelum pelancaran sekurang-kurangnya, dan sekali lagi selepas sebarang perubahan bermakna pada prompt, senarai alat, atau model asas. Untuk agent dengan akses kepada wang, data pelanggan, atau komunikasi luaran, ujian semula suku tahunan ialah paras minimum yang munasabah.
Adakah anda memerlukan pasukan keselamatan khusus untuk melakukan red team terhadap agent?
Tidak. Mulakan dengan meminta seseorang sengaja cuba memecahkan agent berimpak paling tinggi anda menggunakan kes sejarah sebenar sebelum pelancaran. Perkhidmatan red-teaming luaran dan alat ujian adversarial automatik boleh meluaskan liputan dari situ apabila anda menjalankan lebih banyak agent daripada yang mampu diikuti oleh ujian manual sahaja.
Ke Mana Seterusnya
Red teaming memberitahu anda di mana pertahanan agent benar-benar pecah. Prompt injection ialah serangan khusus yang wajar difahami secara mendalam dahulu, kerana ia pintu masuk di sebalik kebanyakan dapatan yang ditemui oleh red team. Pagar pelindung AI agent ialah sisi pelaksanaan, apa yang sebenarnya anda uji dan perkukuh, dan observabiliti AI agent ialah cara anda menangkap apa yang terlepas daripada red team sebaik sahaja agent beroperasi.

On this page
- Perbezaannya daripada Red Teaming Model
- Permukaan Serangan Khusus Agent
- Apa yang Dilakukan Secara Berbeza oleh Ujian Adversarial Sebenar
- Manual, Automatik, dan Berterusan, Diterapkan kepada Agent
- Menukar Dapatan kepada Pembaikan
- Membina Tabiat Ujian Tanpa Pasukan Keselamatan Khusus
- Fakta Utama
- Ke Mana Seterusnya