RAG für AI Agents: Agents in Ihren Daten verankern
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
RAG, Retrieval-Augmented Generation, ist die Art, wie ein AI Agent mit Ihren tatsächlichen Dokumenten und Daten antwortet und handelt, statt aus dem zu raten, was ein Modell zufällig im Training gelernt hat. Der Agent verwandelt eine Frage oder Aufgabe in eine Suche, ruft die relevantesten Abschnitte aus einer Knowledge Base ab und erzeugt seinen nächsten Schritt ausschließlich aus dem, was er gefunden hat, mit Quellenangabe. Für einen Agent ist RAG kein aufgesetztes Feature. Es ist die Verankerungsschicht, die jede Aktion an etwas Reales und Aktuelles bindet.
RAG in einem Satz, für einen Agent
Die Kernmechanik: erst abrufen, dann generieren, und den Abrufschritt niemals überspringen. Retrieval-Augmented Generation als Technik wurde 2020 von Lewis et al. eingeführt und koppelt einen Suchschritt mit einem Sprachmodell, sodass die Ausgabe in konkretem, überprüfbarem Quellenmaterial verankert ist statt in allgemeinem Trainingswissen. Gartner hat erkannt, wie zentral das für Enterprise AI geworden ist, und im September 2025 einen eigenen Market Guide für Enterprise AI Search veröffentlicht, der das Zusammenwachsen von Suche, RAG und agentischer AI als wichtigen Markttreiber nennt.
Diese Glossarseite behandelt die Mechanik im Detail: Vektor-Embeddings, die Retrieval-Pipeline, Chunking. Auch das RAG-Assistant-Muster behandelt den eigenständigen Anwendungsfall ausführlich: ein Chatbot, der einmal abruft und antwortet, mit eigenen ROI-Zahlen und einer Aufschlüsselung der Fehlermodi. Diese Seite geht um etwas Engeres: wie Retrieval in einen Agent passt, der zusätzlich schlussfolgert, Tools nutzt und handelt, und nicht nur in einen Q&A-Bot, der antwortet und aufhört.
Warum ein Agent Retrieval braucht und nicht nur einen größeren Prompt
Die verlockende Abkürzung ist, auf Retrieval zu verzichten und alles, was der Agent brauchen könnte, direkt in den Prompt zu kopieren. Das scheitert schnell, aus drei Gründen.
Erstens veraltet Trainingswissen an dem Tag, an dem es eingefroren wird. Ein Modell, das vor Monaten trainiert wurde, weiß nicht, dass sich Ihre Rückgaberichtlinie letzte Woche geändert hat oder dass der Vertrag eines Kunden gestern verlängert wurde. Retrieval greift auf eine Live-Quelle zu, sodass die Antwort nie älter ist als Ihre letzte Dokumentaktualisierung.
Zweitens ist ein größeres Kontextfenster kein Freifahrtschein. Eine komplette Knowledge Base in jeden Prompt zu packen, kostet bei jedem Aufruf mehr Tokens und Latenz, und Untersuchungen zur Leistung bei langem Kontext haben wiederholt gezeigt, dass Modelle nicht alles in einem großen Kontext gleichmäßig nutzen. Relevante Informationen gehen umso häufiger verloren, je tiefer sie vergraben sind, vor allem in der Mitte einer langen Eingabe. Retrieval löst das, indem es dem Modell nur die wenigen Abschnitte gibt, die für diese konkrete Frage relevant sind, statt alles, was Sie besitzen. AI Agent Memory behandelt diese Einschränkung des Kontextfensters ausführlicher, denn sie ist ebenso ein Memory-Problem wie ein Retrieval-Problem.
Drittens schlägt Retrieval das Fine-Tuning bei allem, was sich ändert. Fine-Tuning brennt Wissen in die Gewichte eines Modells ein, ist teuer zu wiederholen und veraltet erneut, sobald sich ein Quelldokument ändert. Retrieval liest im Moment der Frage aus der Quelle, sodass es beim nächsten Mal die Aktualisierung bereits kennt.
Wo Retrieval in der Agent-Schleife sitzt
Ein Agent ruft nicht einmal am Anfang ab und hört dann auf. Retrieval findet meist beim Wahrnehmen statt, wenn der Agent den Kontext sammelt, den er zum Handeln braucht, und es ist im Kern ein Tool-Aufruf wie jeder andere: „Knowledge Base durchsuchen“ steht in der Tool-Liste des Agents neben „CRM prüfen“ und „Termin buchen“.
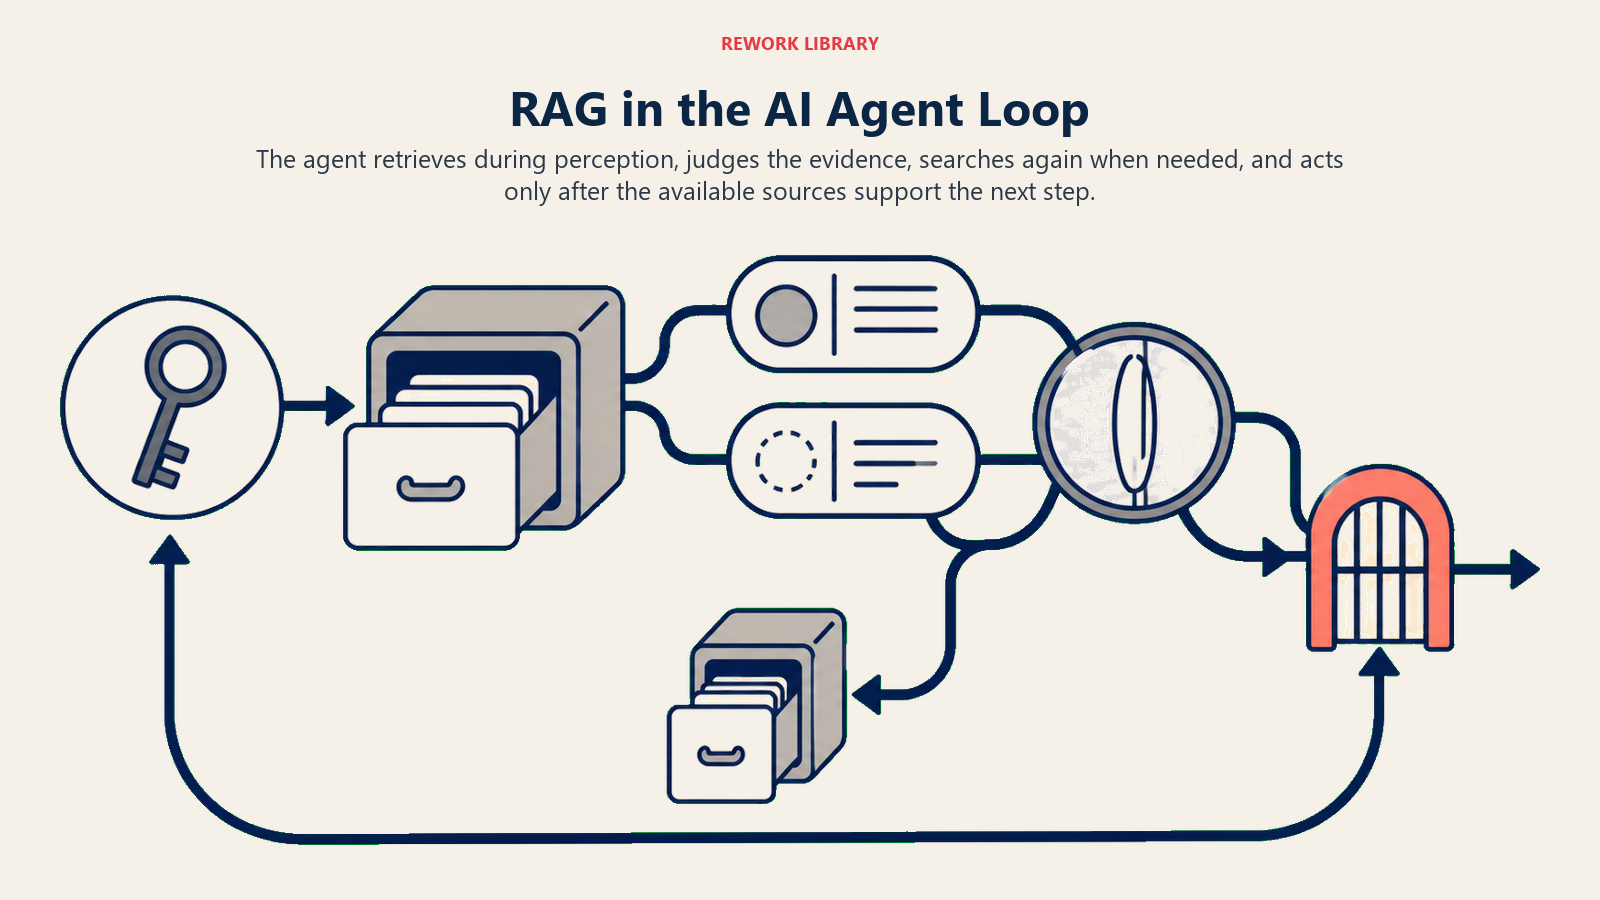
Hier zeigt sich der Unterschied zwischen einem eigenständigen RAG-Chatbot und einem Agent, der RAG nutzt. Ein eigenständiger Assistent ruft einmal ab und antwortet. Ein Agent kann sich ansehen, was zurückkam, bemerken, dass das Ergebnis unvollständig oder widersprüchlich ist, mit einer engeren Anfrage erneut abrufen und erst dann entscheiden, was zu tun ist. Diese Schleife, abrufen, über das Ergebnis nachdenken, eventuell erneut abrufen, dann handeln, macht es agentisch statt zu einer einmaligen Abfrage.
RAG vs. Tools vs. Memory: Die richtige Verankerung wählen
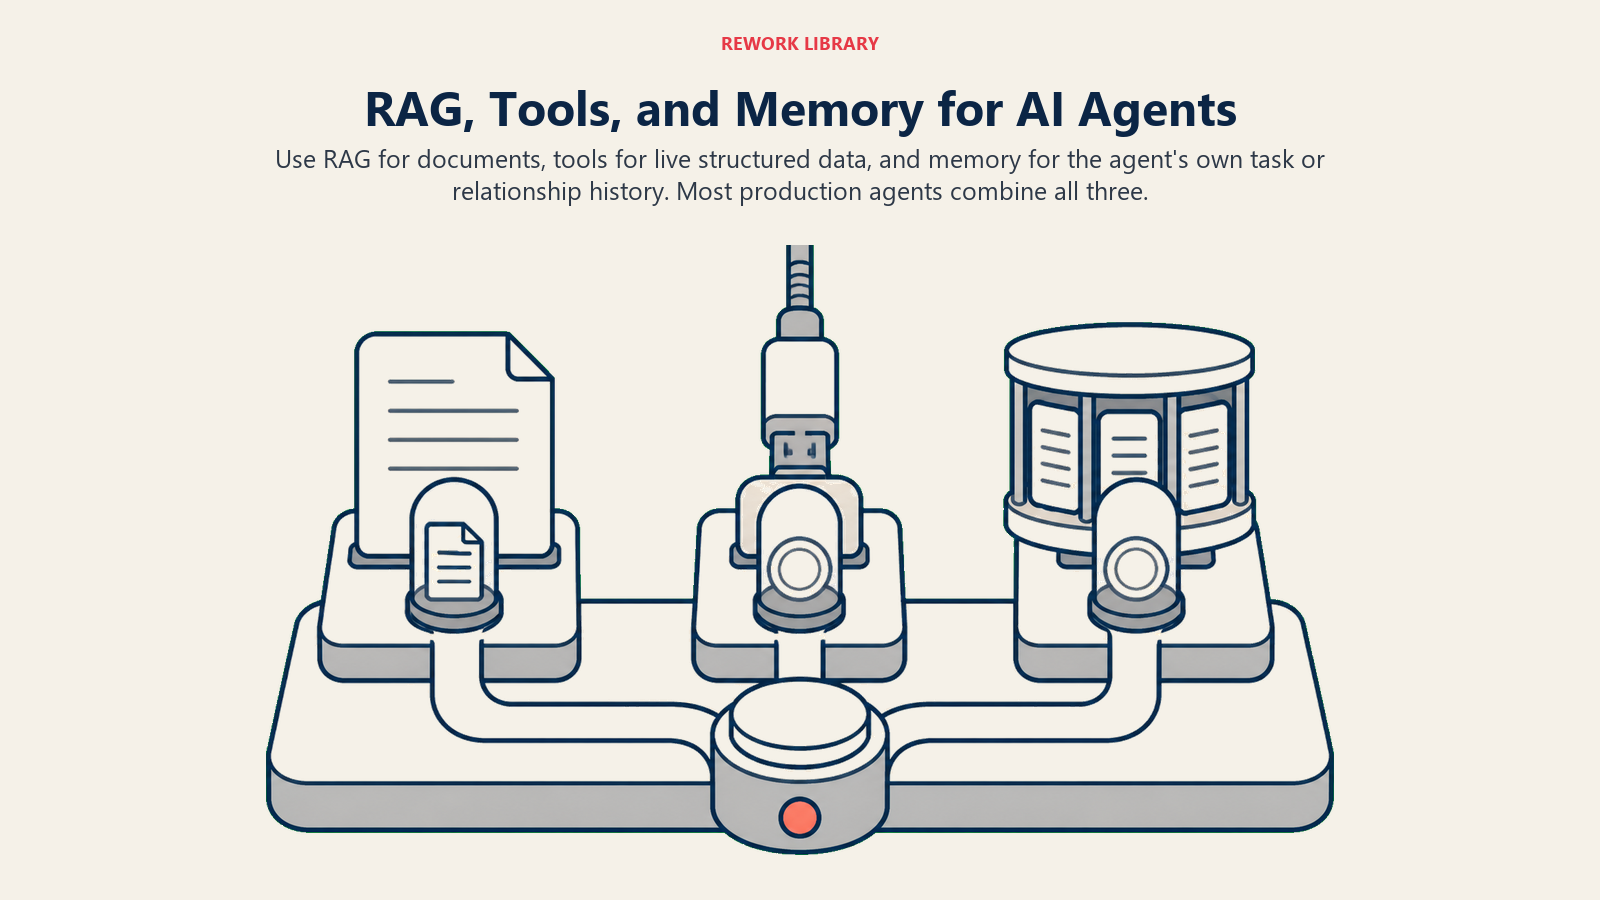
Nicht jede Information, die ein Agent braucht, steckt in einem Dokument. Wer weiß, welcher Verankerungsmechanismus zu welcher Art von Information passt, baut nicht das Falsche.
| Verankerungsquelle | Am besten für | Beispiel | Wie aktuell die Antwort ist |
|---|---|---|---|
| RAG (Retrieval) | Unstrukturiertes Wissen: Richtlinien, Wikis, Verträge, Dokumentation | „Wie lautet unsere Elternzeit-Regelung?“ | So frisch wie die letzte Dokumentaktualisierung |
| Tools und APIs | Strukturierte, transaktionale Echtzeitdaten | „Welche Stufe hat das Konto dieses Kunden?“ oder „Ist Donnerstag um 14 Uhr frei?“ | Live, im Moment des Aufrufs |
| Memory | Die eigene Historie des Agents mit dieser Aufgabe oder diesem Nutzer | „Habe ich diesem Interessenten schon einen Termin vorgeschlagen?“ | Spezifisch für diesen Lauf oder diese Beziehung |
Die meisten Produktiv-Agents nutzen zwei oder drei davon zusammen. Der AI Knowledge Base Agent ruft aus Ihrem Help Center ab (RAG), prüft über das CRM Stufe und Version des Kundenkontos (ein Tool-Aufruf) und merkt sich, ob genau diese Frage in dieser Sitzung schon aufkam (Memory), bevor er entscheidet, ob er antwortet, nachfragt oder übergibt. Zur Kurz- und Langzeitseite der dritten Spalte siehe AI Agent Memory.
RAG-verankerte Agents in der Praxis
Das Muster gilt über sehr unterschiedliche Knowledge Bases hinweg. Drei Beispiele aus dieser Library zeigen die Form.
Der AI Knowledge Base Agent ruft aus Help-Center-Artikeln und internen Wikis ab, antwortet ausschließlich mit dem Gefundenen, nennt in jeder Antwort den Quellartikel beim Namen und markiert, entscheidend, die Frage als Content-Lücke, wenn der Abruf leer zurückkommt. Null Treffer sind nicht nur ein Übergabe-Auslöser, sondern ein Signal, das Ihrem Content-Team genau sagt, was als Nächstes zu schreiben ist.
Der AI Policy Q&A Agent wendet dasselbe Muster aus Abrufen und Zitieren auf ein anderes Korpus an: das Mitarbeiterhandbuch statt eines Support-Help-Centers. Er beantwortet Fragen zu HR- und IT-Richtlinien strikt aus dem, was niedergeschrieben ist, zeigt an, wie kürzlich der zitierte Abschnitt aktualisiert wurde, und leitet an HR weiter, sobald das Handbuch die Frage nicht abdeckt, statt Unternehmensrichtlinien zu erraten.
Der AI Contract Review Agent nutzt Retrieval anders: Statt eine Frage zu beantworten, ruft er Ihr internes Playbook ab (akzeptable Zahlungsbedingungen, Haftungsobergrenzen, IP-Positionen) und vergleicht einen eingehenden Vertrag Klausel für Klausel damit, wobei er jede Abweichung zur Entscheidung durch einen Menschen aufzeigt. Dieselbe Mechanik aus Abrufen und Verankern, angewendet auf Vergleich statt auf Q&A.
Wenn Sie Plattformen vergleichen, um eines davon zu bauen, behandeln der Kaufleitfaden für Knowledge-Base-Software und die Übersicht Support-Tools beide Retrieval-freundliche Optionen, die einen Blick wert sind.
Die Mechanik, kurz gefasst
Quelldokumente werden in Abschnitte (Chunks) zerlegt, jeder Chunk wird über ein Embedding-Modell in einen Vektor umgewandelt, und diese Vektoren liegen in einer Vektordatenbank, die für schnelle Ähnlichkeitssuche gebaut ist. Eine Frage wird auf dieselbe Weise in einen Vektor umgewandelt, das System findet die Chunks, deren Vektoren ihr am nächsten liegen, und diese Chunks, nicht die ganze Knowledge Base, gelangen zusammen mit der Frage in den Kontext des Modells. Chunk-Größe, Metadatenfilter (Abteilung, Dokumentdatum, Produktversion) und die Häufigkeit der Index-Aktualisierung beeinflussen die Antwortqualität stärker als die Frage, mit welchem konkreten Modell Sie generieren. Die ausführliche Anleitung zu Embeddings und Vektorsuche finden Sie unter Was sind Vektordatenbanken?
Wo RAG für einen Agent scheitert
Dieselben Fehlermodi, die einen eigenständigen RAG-Assistenten treffen, treffen einen Agent noch härter, denn ein Agent handelt womöglich auf Basis eines schlechten Abrufs, statt ihn nur anzuzeigen.
Eine veraltete Knowledge Base ist der häufigste und am schwersten zu bemerkende Fehler, denn der Agent antwortet weiterhin selbstsicher. Er antwortet nur aus der Richtlinie des letzten Quartals. Eine Knowledge Base ohne Verantwortlichen driftet, und niemand merkt es, bis ein Kunde auf Basis falscher Informationen handelt.
Ein halluziniertes Zitat ist der gefährlichste Fehler, weil es wie Erfolg aussieht: eine selbstsichere Antwort mit angehängter Quelle, die bei näherem Hinsehen nicht sagt, was der Agent behauptet hat. Genau vor dieser Art von Fehler warnt die OWASP Top 10 für LLM-Anwendungen unter dem Risiko von Fehlinformation und übermäßigem Vertrauen: Nutzer vertrauen einer zitierten Antwort mehr als einer unzitierten, sodass ein falsches Zitat mehr Schaden anrichtet als eine schlicht falsche Antwort.
Beide Fehler führen zur selben Abhilfe: Jemand muss die Knowledge Base verantworten, sie nach Zeitplan prüfen und jeden Abruf ohne Treffer oder mit niedriger Konfidenz als untersuchenswertes Signal behandeln statt als Rauschen, das man ignoriert.
Wann RAG das falsche Werkzeug ist
Retrieval löst nicht jedes Verankerungsproblem. Ändern sich Informationen alle paar Minuten (Live-Bestand, der heutige Kalender, der Kontostand dieser Sekunde), schlägt ein Tool-Aufruf an das Live-System den Abruf aus einer indizierten Kopie, die zum Zeitpunkt der Indizierung schon leicht veraltet ist. Und wenn Nutzer das richtige Dokument problemlos finden und das eigentliche Problem darin besteht, dass es niemand liest, kann die Abhilfe eine bessere Suche oder ein kürzeres Dokument sein, nicht eine generative Schicht obendrauf.
Die Leitlinien von Anthropic zum Bau von Agents beschreiben Retrieval als eine von drei Erweiterungen, neben Tools und Memory, die aus einem schlichten Modell etwas machen, das tatsächlich eine Aufgabe erledigen kann. Keine der drei ersetzt die anderen beiden. Ein Agent, der nur abruft, kann Fragen beantworten, aber nicht handeln. Ein Agent, der nur Tools aufruft, kann handeln, aber keine Richtlinie erklären, die ihm nie gegeben wurde. Die meisten gut gebauten Agents brauchen alle drei, bemessen nach dem, was jeder Teil der Aufgabe tatsächlich verlangt.
Key Facts
- RAG verankert die Antworten und Aktionen eines AI Agents in echten Dokumenten und Daten statt im eingefrorenen Trainingswissen eines Modells, indem vor der Antwort relevante Abschnitte abgerufen werden.
- Innerhalb eines Agents ist Retrieval typischerweise ein Tool-Aufruf, den der Agent in seinem Wahrnehmungsschritt macht, und ein leistungsfähiger Agent kann abrufen, bewerten, was er bekommen hat, und vor dem Handeln erneut abrufen.
- Wissen in Dokumenten verlangt RAG, strukturierte Live-Daten verlangen einen Tool- oder API-Aufruf, und die eigene Aufgabenhistorie des Agents verlangt Memory. Die meisten echten Agents kombinieren alle drei.
- Der gefährlichste RAG-Fehler ist ein halluziniertes Zitat: eine selbstsichere Antwort mit angehängter Quelle, die die Aussage nicht tatsächlich belegt. Deshalb sind ein benannter Content-Verantwortlicher und ein Prüfrhythmus ebenso wichtig wie die Retrieval-Technik selbst.
Häufig gestellte Fragen zu RAG für AI Agents
Was ist RAG im Kontext eines AI Agents?
RAG (Retrieval-Augmented Generation) ist die Art, wie ein AI Agent seine Antworten und Aktionen in echten Dokumenten und Daten verankert. Statt sich auf das zu verlassen, was ein Modell im Training gelernt hat, durchsucht der Agent eine Knowledge Base, ruft das relevanteste Material ab und erzeugt seinen nächsten Schritt aus diesem abgerufenen Inhalt, mit Quellenangabe.
Ist RAG dasselbe wie ein AI Agent?
Nein. RAG ist eine Verankerungstechnik, kein Agent für sich. Ein eigenständiger RAG-Assistent ruft einmal ab und beantwortet eine Frage. Ein AI Agent kann RAG als eines von mehreren Tools nutzen: abrufen, über das Gefundene nachdenken, manchmal erneut abrufen und dann eine Aktion ausführen. Das ist eine breitere Schleife, als Retrieval allein abdeckt.
Wann braucht ein Agent RAG statt eines normalen Tool- oder API-Aufrufs?
Nutzen Sie RAG für unstrukturiertes Wissen, das in Dokumenten liegt: Richtlinien, Wikis, Verträge, Produktdokumentation. Nutzen Sie einen Tool- oder API-Aufruf für strukturierte Echtzeitdaten wie einen Kontostand, einen Kalender-Slot oder einen Bestellstatus. Die meisten Agents brauchen beides, ausgerichtet auf unterschiedliche Arten von Informationen.
Wie unterscheidet sich RAG für einen Agent vom RAG-Assistant-Muster?
Das RAG-Assistant-Muster beschreibt einen eigenständigen Chatbot, der abruft und antwortet, mehr nicht. RAG für einen Agent beschreibt Retrieval als eine Eingabe innerhalb einer größeren Schleife, die auch schlussfolgert, andere Tools aufruft, sich frühere Schritte merkt und handelt. Die Retrieval-Mechanik ist dieselbe. Was sie umgibt, nicht.
Was ist das größte Risiko beim Einsatz von RAG in einem autonomen Agent?
Ein halluziniertes Zitat, bei dem der Agent eine selbstsichere Antwort erzeugt, eine Quelle zitiert, die diese Aussage gar nicht enthält, und danach handelt. Weil ein Agent echte Aktionen ausführen kann und nicht nur eine Antwort anzeigt, kann dieser Fehlermodus ihn dazu bringen, auf Informationen zu handeln, die es nie gab. Regelmäßige Stichproben mit einem benannten Verantwortlichen für die Knowledge Base fangen das ab, bevor es sich aufschaukelt.
Wie es weitergeht
Retrieval ist einer von drei Wegen, wie sich ein Agent in der Realität verankert, neben Tools und Memory. Wenn das Wissensproblem Ihres Agents eher ein Problem des „Erinnerns an das, was schon geschah“ ist als eines des „Findens eines Dokuments“, behandelt AI Agent Memory diese Seite direkt. Und sobald Retrieval angebunden ist, zeigt So bewerten und testen Sie AI Agents, wie Sie einen schlechten Abruf oder ein halluziniertes Zitat abfangen, bevor es einen Kunden erreicht.

On this page
- RAG in einem Satz, für einen Agent
- Warum ein Agent Retrieval braucht und nicht nur einen größeren Prompt
- Wo Retrieval in der Agent-Schleife sitzt
- RAG vs. Tools vs. Memory: Die richtige Verankerung wählen
- RAG-verankerte Agents in der Praxis
- Die Mechanik, kurz gefasst
- Wo RAG für einen Agent scheitert
- Wann RAG das falsche Werkzeug ist
- Key Facts
- Wie es weitergeht