RAG para AI Agents: Como Fundamentar Agents nos Seus Dados
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
RAG, a geração aumentada por recuperação (retrieval-augmented generation), é a forma como um AI agent responde e age usando os seus documentos e dados reais, em vez de chutar a partir do que um modelo aprendeu durante o treinamento. O agent transforma uma pergunta ou tarefa em uma busca, recupera os trechos mais relevantes de uma base de conhecimento e gera o seu próximo passo apenas com o que encontrou, citando a fonte. Para um agent, o RAG não é um recurso acoplado depois. É a camada de fundamentação que mantém cada ação ligada a algo real e atual.
RAG em Uma Frase, para um Agent
A mecânica central: recuperar primeiro, gerar depois, e nunca pular a etapa de recuperação. A geração aumentada por recuperação como técnica foi apresentada por Lewis et al. em 2020, combinando uma etapa de busca com um modelo de linguagem para que a saída seja fundamentada em material de origem específico e verificável, e não em conhecimento geral de treinamento. A Gartner reconheceu o quanto isso se tornou central para a AI corporativa, publicando em setembro de 2025 um Market Guide dedicado a Enterprise AI Search que cita a convergência entre busca, RAG e agentic AI como um dos principais motores do mercado.
Essa página de glossário cobre a mecânica em profundidade: embeddings vetoriais, o pipeline de recuperação, o chunking. O padrão RAG Assistant também cobre em profundidade o caso de uso independente, um chatbot que recupera uma vez e responde, com os seus próprios números de ROI e uma análise de modos de falha. Esta página trata de algo mais específico: como a recuperação se encaixa dentro de um agent que também raciocina, usa ferramentas e executa ações, e não apenas um bot de perguntas e respostas que responde e para.
Por Que um Agent Precisa de Recuperação, e Não Apenas de um Prompt Maior
O atalho tentador é pular a recuperação e colar no prompt tudo o que o agent pode precisar. Isso desmorona rápido, por três motivos.
Primeiro, o conhecimento de treinamento fica defasado no dia em que é congelado. Um modelo treinado meses atrás não faz ideia de que a sua política de devolução mudou na semana passada ou de que o contrato de um cliente foi renovado ontem. A recuperação busca de uma fonte viva, então a resposta nunca é mais velha do que a última atualização dos seus documentos.
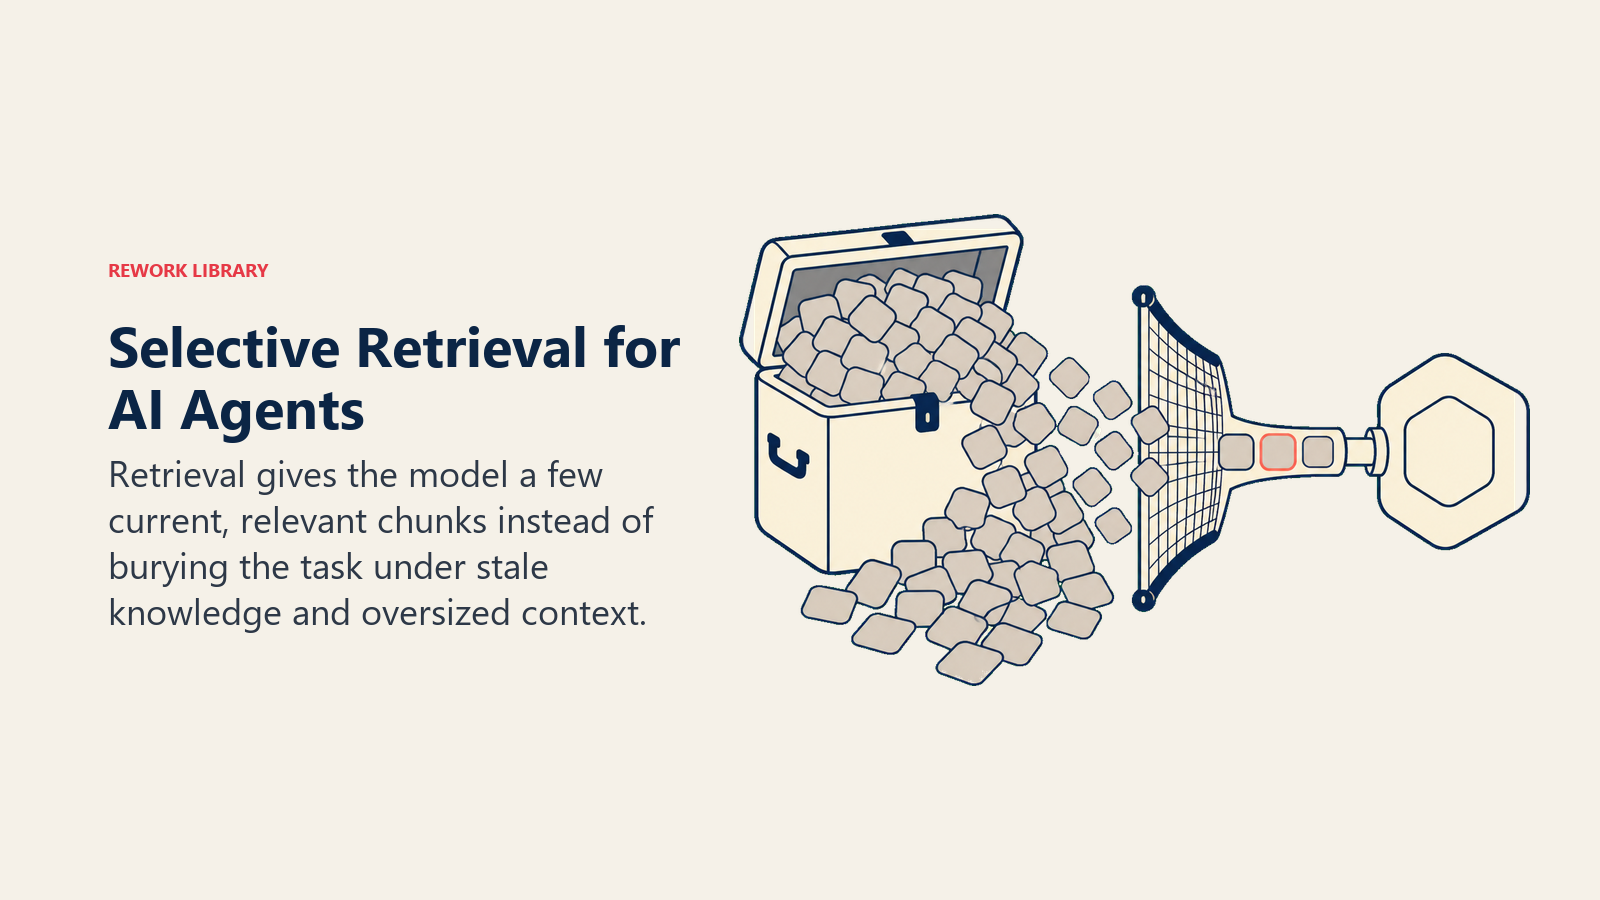
Segundo, uma janela de contexto maior não é um passe livre. Encher cada prompt com uma base de conhecimento inteira custa mais em tokens e em latência a cada chamada, e pesquisas sobre desempenho em contextos longos constataram repetidamente que os modelos não usam tudo em um contexto grande de maneira uniforme. A informação relevante é perdida com mais frequência quanto mais fundo está enterrada, sobretudo no meio de uma entrada longa. A recuperação resolve isso entregando ao modelo apenas o punhado de trechos realmente relevantes para aquela pergunta específica, em vez de tudo o que você possui. A memória de AI agents aborda essa limitação da janela de contexto com mais profundidade, já que é, na verdade, tanto um problema de memória quanto de recuperação.
Terceiro, a recuperação supera o fine-tuning em tudo o que muda. O fine-tuning embute o conhecimento nos pesos do modelo, o que é caro de refazer e volta a ficar defasado assim que um documento de origem muda. A recuperação lê da fonte no momento da pergunta, então, na próxima vez que alguém perguntar, ela já tem a atualização.
Onde a Recuperação Fica no Ciclo do Agent
Um agent não recupera uma vez no início e para. A recuperação costuma acontecer durante a etapa de perceber, quando o agent reúne o contexto de que precisa para agir, e é, na prática, uma chamada de ferramenta como qualquer outra: "buscar na base de conhecimento" fica na lista de ferramentas do agent ao lado de "consultar o CRM" e "agendar a reunião".
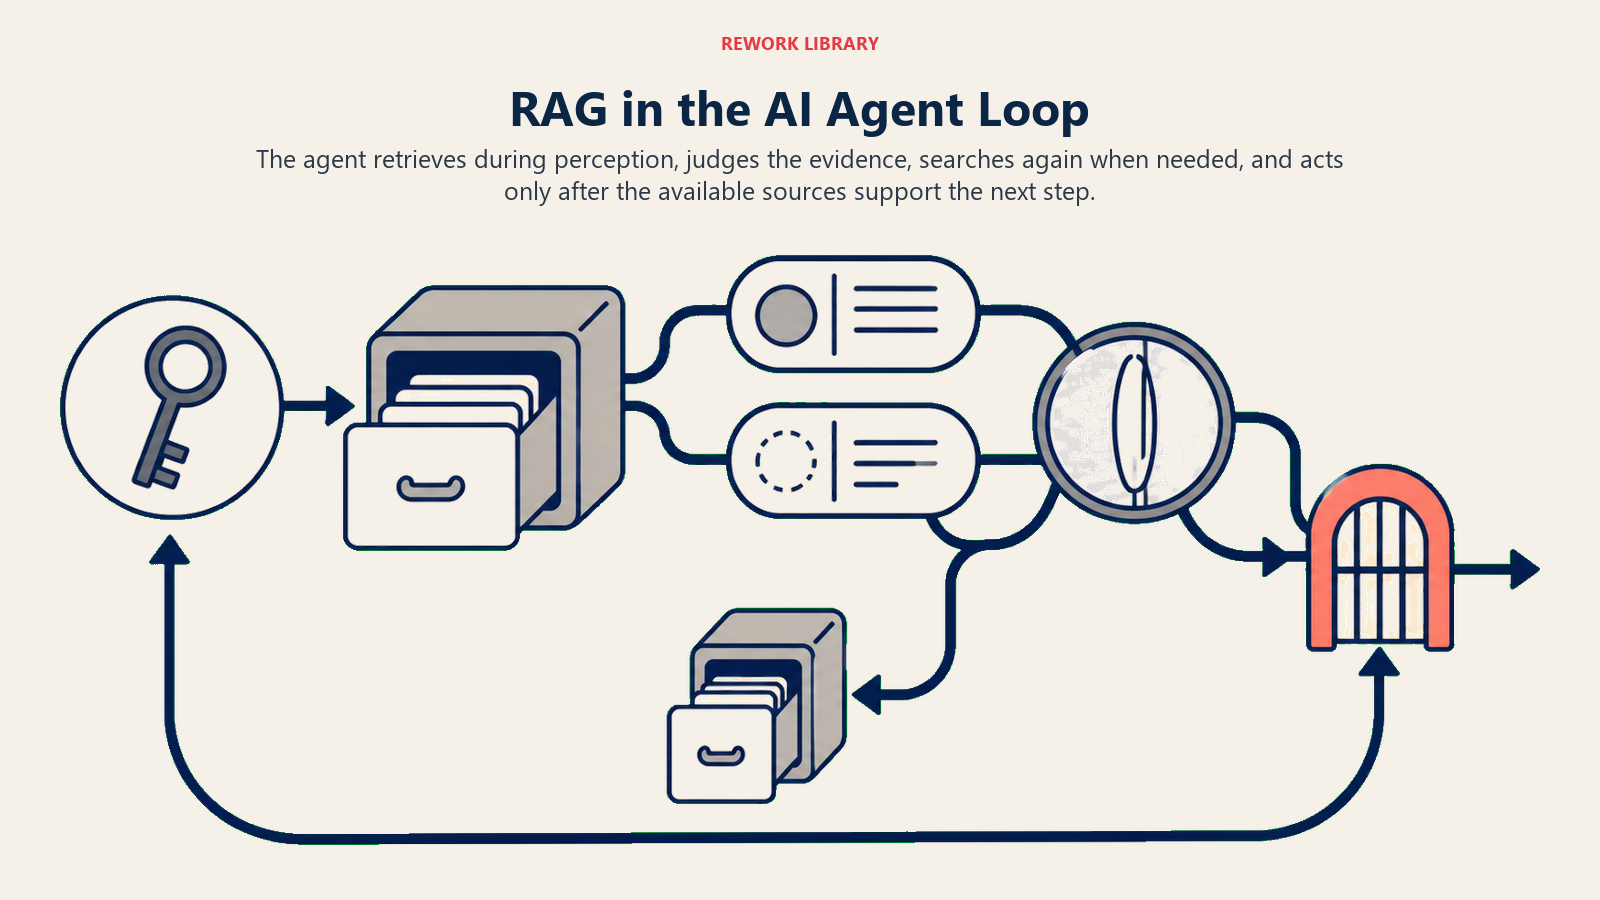
A diferença entre um chatbot RAG independente e um agent que usa RAG aparece aqui. Um assistente independente recupera uma vez e responde. Um agent pode olhar o que recebeu, perceber que o resultado está incompleto ou contraditório, recuperar de novo com uma consulta mais estreita e só então decidir o que fazer. Esse ciclo, recuperar, raciocinar sobre o que voltou, talvez recuperar de novo e então agir, é o que o torna agentic, e não uma consulta de tiro único.
RAG vs. Ferramentas vs. Memória: Escolhendo a Fundamentação Certa
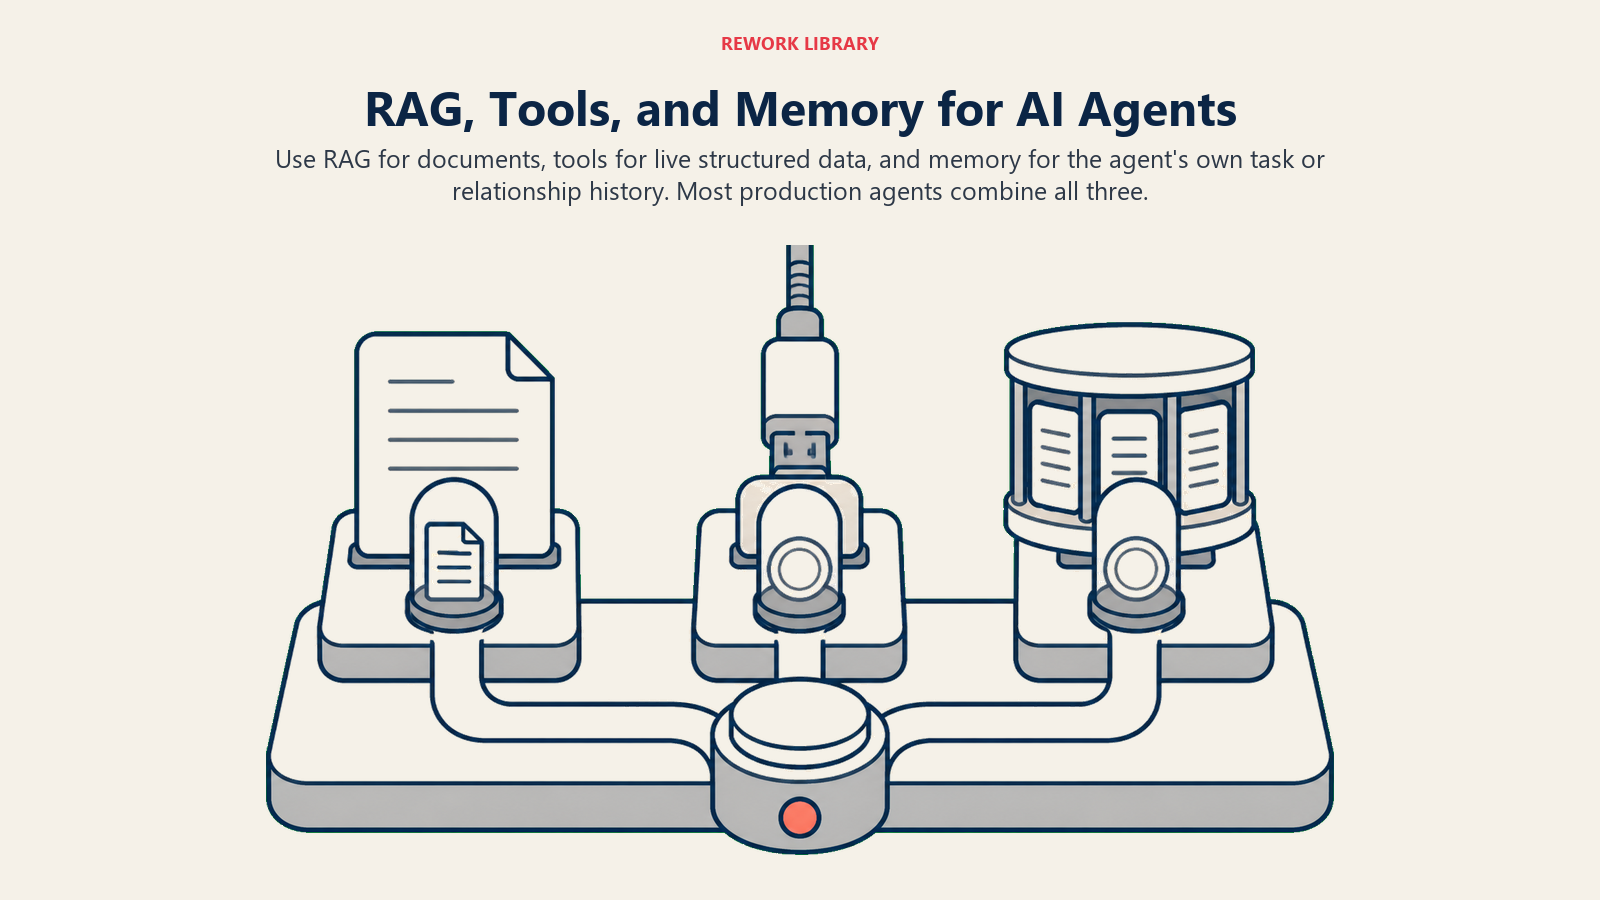
Nem todo fato de que um agent precisa está em um documento. Saber qual mecanismo de fundamentação serve para cada tipo de informação evita que você construa a coisa errada.
| Fonte de fundamentação | Melhor para | Exemplo | Quão atual é a resposta |
|---|---|---|---|
| RAG (recuperação) | Conhecimento não estruturado: políticas, wikis, contratos, documentação | "Qual é a nossa política de licença-paternidade?" | Tão recente quanto a última atualização do documento |
| Ferramentas e APIs | Dados estruturados, transacionais e em tempo real | "Qual é o nível de conta deste cliente?" ou "Quinta-feira às 14h está livre?" | Ao vivo, no momento da chamada |
| Memória | O histórico do próprio agent com esta tarefa ou este usuário | "Eu já propus um horário a este prospect?" | Específica desta execução ou desta relação |
A maioria dos agents em produção usa duas ou três dessas fontes em conjunto. O AI Knowledge Base Agent recupera da sua central de ajuda (RAG), confere o nível e a versão da conta do cliente por meio do CRM (uma chamada de ferramenta) e lembra se essa mesma pergunta já surgiu nesta sessão (memória) antes de decidir se responde, pergunta ou transfere. Veja a memória de AI agents para o lado de curto e longo prazo dessa terceira coluna.
Agents Fundamentados em RAG na Prática
O padrão se mantém em bases de conhecimento muito diferentes. Três exemplos desta biblioteca mostram o formato.
O AI Knowledge Base Agent recupera de artigos da central de ajuda e de wikis internas, responde usando apenas o que encontra, cita o artigo de origem pelo nome em toda resposta e, o que é crucial, sinaliza a pergunta como uma lacuna de conteúdo quando a recuperação volta vazia. Zero resultados não é só um gatilho de transferência, é um sinal que diz à sua equipe de conteúdo exatamente o que escrever em seguida.
O AI Policy Q&A Agent executa o mesmo padrão de recuperar e citar sobre outro corpus: o manual do colaborador em vez de uma central de ajuda de suporte. Ele responde perguntas de políticas de RH e de TI estritamente com base no que está escrito, mostra há quanto tempo a seção citada foi atualizada e encaminha ao RH no momento em que o manual não cobre a pergunta, em vez de chutar a política da empresa.
O AI Contract Review Agent usa a recuperação de outro modo: em vez de responder a uma pergunta, ele recupera o playbook interno (condições de pagamento aceitáveis, tetos de responsabilidade, posições de propriedade intelectual) e compara um contrato recebido com ele cláusula por cláusula, apontando cada desvio para um humano decidir. É a mesma mecânica de recuperar e fundamentar, aplicada à comparação em vez de perguntas e respostas.
Se você está comparando plataformas para construir um desses agents, o guia de compra de software de base de conhecimento e o panorama de ferramentas de suporte cobrem opções amigáveis à recuperação que valem uma olhada.
A Mecânica, em Resumo
Os documentos de origem são divididos em trechos, cada trecho é convertido em um vetor por meio de um modelo de embedding, e esses vetores ficam em um banco de dados vetorial feito para busca rápida por similaridade. Uma pergunta é convertida em vetor do mesmo modo, o sistema encontra os trechos cujos vetores estão mais próximos dela, e esses trechos, e não a base de conhecimento inteira, vão para o contexto do modelo junto com a pergunta. O tamanho do trecho, o filtro por metadados (departamento, data do documento, versão do produto) e a frequência com que o índice é atualizado afetam a qualidade da resposta mais do que o modelo específico com que você gera. Para o passo a passo completo de embeddings e busca vetorial, veja O Que São Bancos de Dados Vetoriais?
Onde o RAG Falha para um Agent
Os mesmos modos de falha que atingem um assistente RAG independente atingem um agent com ainda mais força, porque um agent pode agir com base em uma recuperação ruim em vez de apenas exibi-la.
Uma base de conhecimento desatualizada é a falha mais comum e a mais difícil de perceber, porque o agent continua respondendo com confiança. Só que responde com a política do trimestre passado. Uma base de conhecimento sem dono se desvia, e ninguém percebe até que um cliente aja com base na informação errada.
Uma citação alucinada é a falha mais perigosa, porque parece um sucesso: uma resposta confiante com uma fonte anexada que, numa inspeção mais atenta, não diz de fato o que o agent afirmou. É exatamente o tipo de falha sobre o qual o OWASP Top 10 para Aplicações de LLM alerta, nos riscos de desinformação e de excesso de confiança: os usuários confiam mais em uma resposta citada do que em uma sem citação, então uma citação errada causa mais dano do que uma simples resposta errada.
As duas falhas apontam para a mesma correção: alguém precisa ser dono da base de conhecimento, revisá-la em um cronograma e tratar cada recuperação com zero resultados ou baixa confiança como um sinal que merece investigação, e não como ruído a ignorar.
Quando o RAG É a Ferramenta Errada para o Trabalho
A recuperação não resolve todos os problemas de fundamentação. Se a informação muda a cada poucos minutos (estoque ao vivo, a agenda de hoje, o saldo de uma conta neste segundo), uma chamada de ferramenta ao sistema ao vivo vence a recuperação de uma cópia indexada que já está ligeiramente desatualizada no momento em que é indexada. E se os usuários já encontram o documento certo sem problemas, e o problema real é que ninguém o lê, a correção pode ser uma busca melhor ou um documento mais curto, e não uma camada generativa por cima.
A própria orientação da Anthropic sobre construir agents apresenta a recuperação como uma de três ampliações, ao lado de ferramentas e memória, que transformam um modelo simples em algo capaz de realmente fazer um trabalho. Nenhuma das três substitui as outras duas. Um agent que só recupera consegue responder perguntas, mas não consegue agir. Um agent que só chama ferramentas consegue agir, mas não consegue explicar uma política que nunca lhe foi dada. A maioria dos agents bem construídos precisa das três, dimensionadas conforme o que cada parte da tarefa realmente exige.
Key Facts
- O RAG fundamenta as respostas e ações de um AI agent em documentos e dados reais, em vez do conhecimento de treinamento congelado de um modelo, recuperando trechos relevantes antes de gerar uma resposta.
- Dentro de um agent, a recuperação costuma ser uma chamada de ferramenta feita na etapa de perceber, e um agent capaz pode recuperar, avaliar o que voltou e recuperar de novo antes de agir.
- O conhecimento em documentos pede RAG, os dados estruturados ao vivo pedem uma chamada de ferramenta ou API, e o histórico de tarefas do próprio agent pede memória. A maioria dos agents reais combina as três.
- A falha de RAG mais perigosa é a citação alucinada: uma resposta confiante com uma fonte anexada que não sustenta de fato a afirmação, e é por isso que um responsável nomeado pelo conteúdo e uma cadência de revisão importam tanto quanto a própria tecnologia de recuperação.
Perguntas Frequentes sobre RAG para AI Agents
O que é RAG no contexto de um AI agent?
RAG (retrieval-augmented generation, ou geração aumentada por recuperação) é a forma como um AI agent fundamenta suas respostas e ações em documentos e dados reais. Em vez de depender do que um modelo aprendeu durante o treinamento, o agent pesquisa uma base de conhecimento, recupera o material mais relevante e gera o próximo passo a partir desse conteúdo recuperado, citando a fonte.
RAG é a mesma coisa que um AI agent?
Não. O RAG é uma técnica de fundamentação, não um agent por si só. Um assistente RAG independente recupera uma vez e responde a uma pergunta. Um AI agent pode usar o RAG como uma de várias ferramentas, recuperando, raciocinando sobre o que encontrou, às vezes recuperando de novo e então executando uma ação, o que é um ciclo mais amplo do que a recuperação sozinha cobre.
Quando um agent precisa de RAG em vez de uma chamada de ferramenta ou API comum?
Use RAG para conhecimento não estruturado que vive em documentos: políticas, wikis, contratos, documentação de produto. Use uma chamada de ferramenta ou API para dados estruturados e em tempo real, como o saldo de uma conta, um horário de agenda ou o status de um pedido. A maioria dos agents precisa dos dois, voltados a tipos diferentes de informação.
Como o RAG para um agent difere do padrão RAG Assistant?
O padrão RAG Assistant descreve um chatbot independente que recupera e responde, nada além disso. O RAG para um agent descreve a recuperação como uma entrada dentro de um ciclo maior, que também raciocina, chama outras ferramentas, lembra de etapas anteriores e executa ações. A mecânica de recuperação é a mesma. O que a cerca, não.
Qual é o maior risco de usar RAG dentro de um agent autônomo?
Uma citação alucinada, em que o agent gera uma resposta confiante e cita uma fonte que na verdade não contém aquela afirmação, e depois age com base nela. Como um agent pode executar ações reais, e não apenas exibir uma resposta, esse modo de falha pode levá-lo a agir com base em informação que nunca existiu. Verificações por amostragem regulares, com um responsável nomeado pela base de conhecimento, detectam isso antes que o problema se acumule.
Para Onde Ir Agora
A recuperação é uma de três formas pelas quais um agent se ancora na realidade, ao lado de ferramentas e memória. Se o problema de conhecimento do seu agent é na verdade um problema de "lembrar o que já aconteceu" e não de "encontrar um documento", a memória de AI agents aborda esse lado diretamente. E, depois que a recuperação estiver conectada, como avaliar e testar AI agents mostra como detectar uma recuperação ruim ou uma citação alucinada antes que ela chegue a um cliente.

On this page
- RAG em Uma Frase, para um Agent
- Por Que um Agent Precisa de Recuperação, e Não Apenas de um Prompt Maior
- Onde a Recuperação Fica no Ciclo do Agent
- RAG vs. Ferramentas vs. Memória: Escolhendo a Fundamentação Certa
- Agents Fundamentados em RAG na Prática
- A Mecânica, em Resumo
- Onde o RAG Falha para um Agent
- Quando o RAG É a Ferramenta Errada para o Trabalho
- Key Facts
- Para Onde Ir Agora