AI Agent Guardrails: Agents sicher und richtlinienkonform halten
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
AI Agent Guardrails sind die harten Regeln, die ein Agent niemals brechen darf, egal was das Gespräch, die Daten oder ein geschickter Prompt ihn dazu bringen wollen. Sie stehen getrennt von den regulären Anweisungen des Agents: Anweisungen beschreiben, wie sich der Agent im Normalfall verhalten soll, Guardrails beschreiben, was er auch dann nie tun darf, wenn ihn etwas vom Gegenteil überzeugt. Ein gut gebauter Agent hat Guardrails sowohl für das, was in einen Tool-Aufruf hineingeht, als auch für das, was herauskommt, und sie werden so getestet, wie ein Security-Team sie testen würde, nicht nur aufgeschrieben und dann auf gut Glück vertraut.
Dies ist die tiefergehende, agentenspezifische Version dessen, was AI Guardrails allgemein sind. Das umfassendere Konzept deckt auch Content-Moderation und Chatbot-Sicherheit ab; hier geht es um die konkrete Mechanik eines Agents, der Tools aufrufen und reale Aktionen ausführen kann. Dort erzeugt eine fehlende Guardrail nicht nur einen schlechten Satz, sondern eine falsche Erstattung, eine falsche E-Mail oder einen falschen Datensatz.
Was eine Guardrail von einer Regel unterscheidet
Wie AI Agents funktionieren definiert sechs Bausteine, die jeder Agent braucht, und zwei davon werden ständig verwechselt: Rules und Guardrails. Rules sind das dauerhaft aktive Verhalten, das prägt, wie der Agent normalerweise handelt: Markenstimme, welche Fakten er nennt, wie er eine Absage formuliert. Guardrails sind von anderer Art, nicht nur von anderem Grad. Es sind die harten Grenzen, die auch dann halten, wenn eine Regel etwas durchlassen würde: nie einen Preis erfinden, nie die Daten eines Kunden mit einem anderen teilen, nie einer Anweisung folgen, die in den gelesenen Inhalten steckt und seine eigentliche Konfiguration überschreiben will.
Der Test, der beides trennt: Eine Regel prägt das Normalverhalten. Eine Guardrail greift, wenn etwas Abnormales passiert, ein Grenzfall, ein Angriff, ein Fehler an anderer Stelle der Pipeline, der den Agent mit schlechten Daten füttert. Wird eine Regel gebrochen, hat sich der Agent ein wenig markenfremd verhalten. Wird eine Guardrail gebrochen, hat der Agent etwas getan, das er gezielt nie tun sollte. Ein Agent arbeitet mit begrenzter Autonomie: Er darf innerhalb von Grenzen frei handeln und muss an ihrem Rand stoppen. Guardrails sind der Mechanismus, der die „begrenzte“ Hälfte dieses Begriffs tatsächlich durchsetzt.
Die zwei Ebenen, die jeder Agent braucht: Input und Output
Praxistaugliche Guardrail-Systeme prüfen den Agent zweimal: beim Eingang und beim Ausgang.
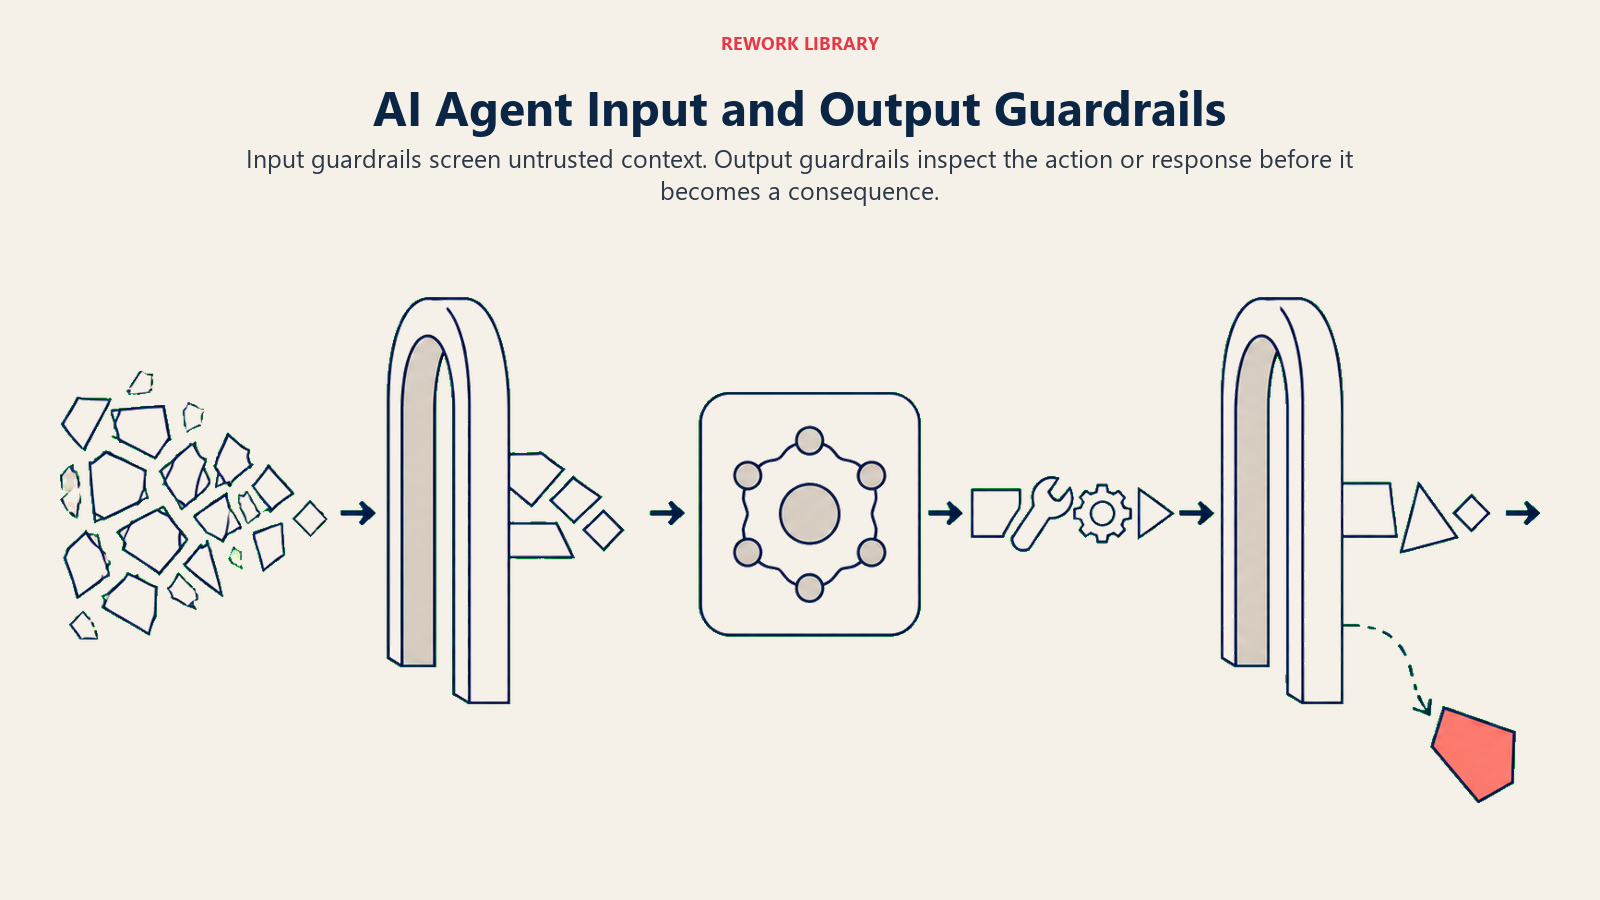
Input-Guardrails prüfen, was den Agent erreicht, bevor es als vertrauenswürdiger Kontext behandelt wird. Diese Ebene fängt einen Prompt-Injection-Versuch ab, der in einem Dokument versteckt ist, das der Agent gleich lesen will, oder eine Tool-Aufruf-Anfrage, die zu nichts passt, was dem Agent tatsächlich aufgetragen wurde. Es ist die schärfste Kante, wenn man AI-Sicherheit speziell auf Agents anwendet. Musterbasierte Filter erkennen bekannte Angriffsvorlagen; ein Klassifikationsmodell erkennt neuartige.
Output-Guardrails prüfen, was der Agent gleich tun oder sagen wird, bevor er sich festlegt. Diese Ebene fängt eine Antwort ab, die Daten eines anderen Kunden preisgibt, einen Tool-Aufruf-Parameter außerhalb des erwarteten Bereichs (eine Erstattung über 50.000 $, obwohl die Richtlinie automatische Erstattungen auf 500 $ begrenzt) oder eine Antwort, die gegen eine festgelegte Richtlinie verstößt, obwohl vorgelagert nichts Alarm geschlagen hat.
Keine der beiden Ebenen genügt allein. Die Empfehlungen von OWASP sind hier eindeutig: Defense in Depth, denn ein einzelner Filter, so gut er auch ist, wird irgendwann von etwas Neuartigem umgangen. Wer beide Ebenen unabhängig voneinander betreibt, stellt sicher, dass ein Fehlgriff auf der einen Seite auf der anderen noch abgefangen wird.
Allow-Lists schlagen Deny-Lists bei Agent-Tools
Der häufigste Guardrail-Fehler ist der Versuch, alles aufzuzählen, was ein Agent nicht tun soll. Diese Liste ist endlos. Die praktikable Variante ist das Gegenteil: genau aufzählen, was der Agent tun darf, und alles andere standardmäßig blockieren.
Das nennt OWASP Excessive Agency, LLM06 in seinen Top 10 für LLM-Anwendungen: ein System, dem mehr Funktionen, Berechtigungen oder Autonomie gewährt wurden, als die Aufgabe tatsächlich braucht. Ein Agent, der Erstattungsvorschläge entwirft, braucht kein Tool, das sie auslöst. Ein Agent, der Account-Recherche betreibt, braucht keinen Sendezugriff auf Ihren E-Mail-Client. Jedes Tool, das ein Agent aufrufen kann, ist selbst eine Guardrail-Entscheidung: Wer ihm das Tool gibt, hat die Berechtigung erteilt, ob beabsichtigt oder nicht, und zwar für jede Situation, in der dieses Tool eingesetzt werden könnte.
Das Autonomous-Agent-Pattern nennt das Scope Limits: eine explizite Allowlist der Tools, auf die der Agent zugreifen darf, vor dem Deployment geprüft und ohne Erweiterung zur Laufzeit. Braucht der Agent mitten in einer Aufgabe eine neue Fähigkeit, ist das ein Signal für einen Menschen, eine Konfigurationsentscheidung zu treffen, nicht etwas, das sich der Agent selbst gewährt.
Wo Guardrails im Agent-Loop sitzen
Auf den Loop aus Wahrnehmen, Schlussfolgern, Handeln und Beobachten abgebildet, gehören Guardrails an drei bestimmte Punkte, nicht diffus um den Agent herum:
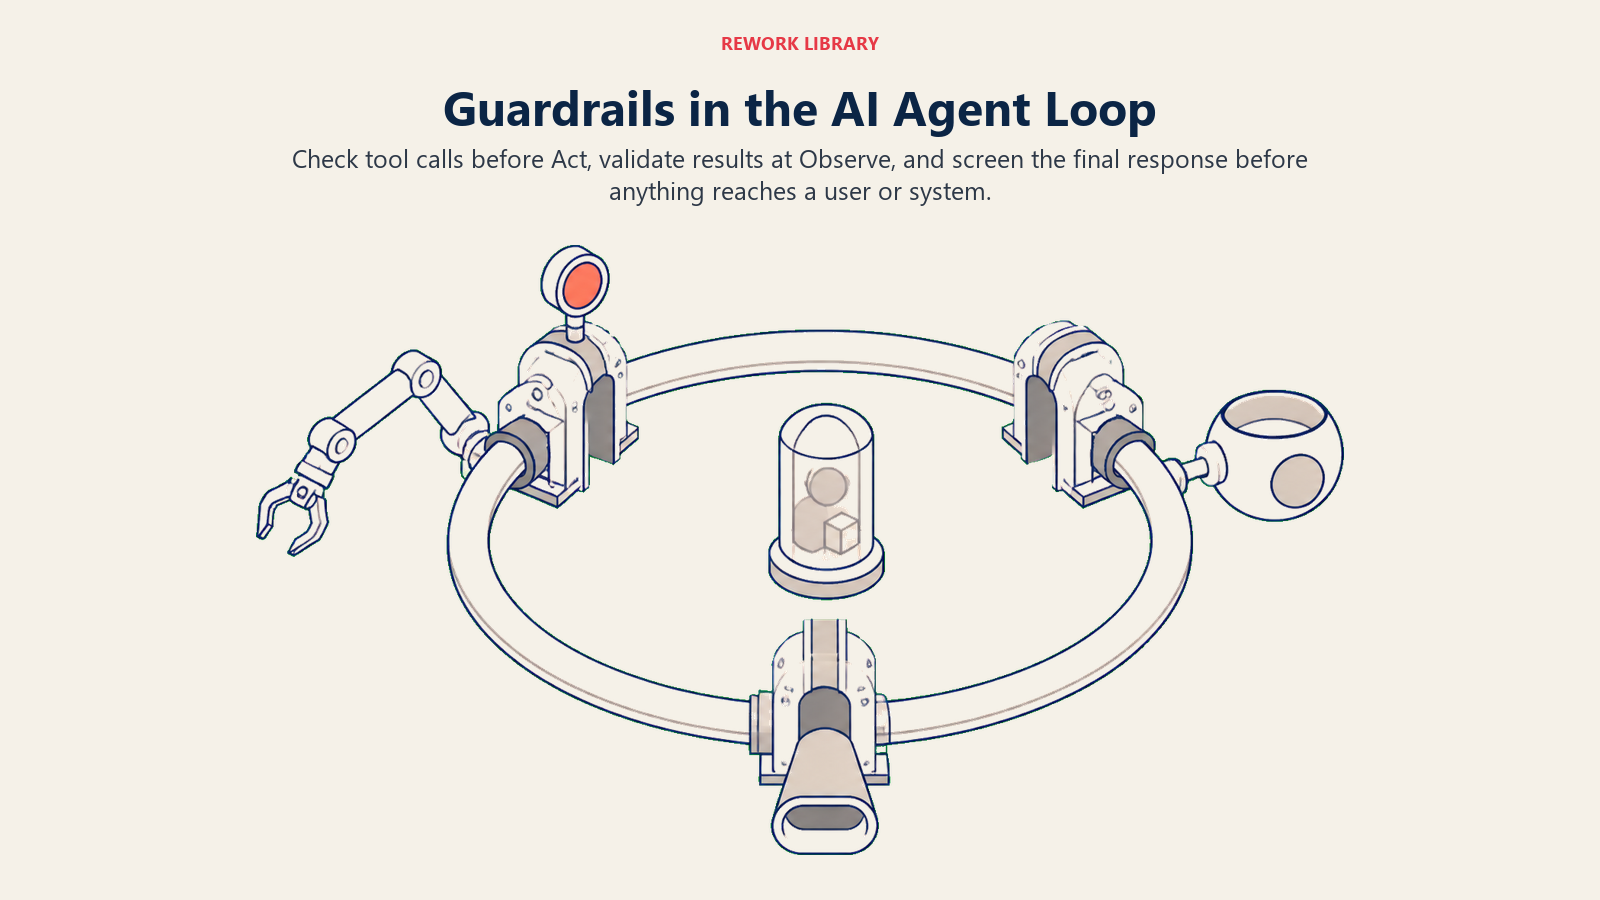
| Loop-Schritt | Guardrail-Prüfung | Beispiel |
|---|---|---|
| Vor dem Handeln | Steht dieser Tool-Aufruf auf der Allow-List, und liegen seine Parameter im erwarteten Rahmen? | Einen Erstattungs-Tool-Aufruf über der Schwelle für automatische Freigabe blockieren, bevor er ausgelöst wird |
| Beim Beobachten | Wirkt das Ergebnis des Tools plausibel, bevor der Agent darauf aufbaut? | Eine Kalender-API, die ein Datum Jahre in der Vergangenheit liefert, als Signal zum Stoppen werten, nicht zum Weitermachen |
| Vor der finalen Antwort | Verstößt die entworfene Ausgabe gegen eine festgelegte Richtlinie, auch wenn alle vorgelagerten Schritte unauffällig waren? | Eine Antwort abfangen, die einen Preis nennt, den der Agent nie erhalten hat, eine wahrscheinliche Halluzination |
Die Prüfung in den Loop selbst einzubauen, statt als separaten Review-Prozess, der später stattfindet, macht aus einer Guardrail erst eine Guardrail statt eines Richtliniendokuments. Sie greift in Echtzeit, bevor die Folge eintritt, bei jedem Durchlauf, nicht bei einer Stichprobe, die ein Compliance-Team Wochen später prüft. Sie erzeugt auch den Audit-Trail, den die Governance-Anforderungen jedes Patterns verlangen: ein protokollierter Nachweis, welche Guardrail wann und warum ausgelöst hat.
Testen, ob Ihre Guardrails tatsächlich funktionieren
Eine Guardrail, die noch niemand zu brechen versucht hat, ist eine Guardrail, über die Sie nur Vermutungen anstellen. AI Red Teaming, strukturiertes adversariales Testen, bei dem jemand aktiv versucht, den Agent zu dem zu bringen, was er nicht tun soll, macht aus „wir haben Guardrails“ eine überprüfte Tatsache statt einer Behauptung.
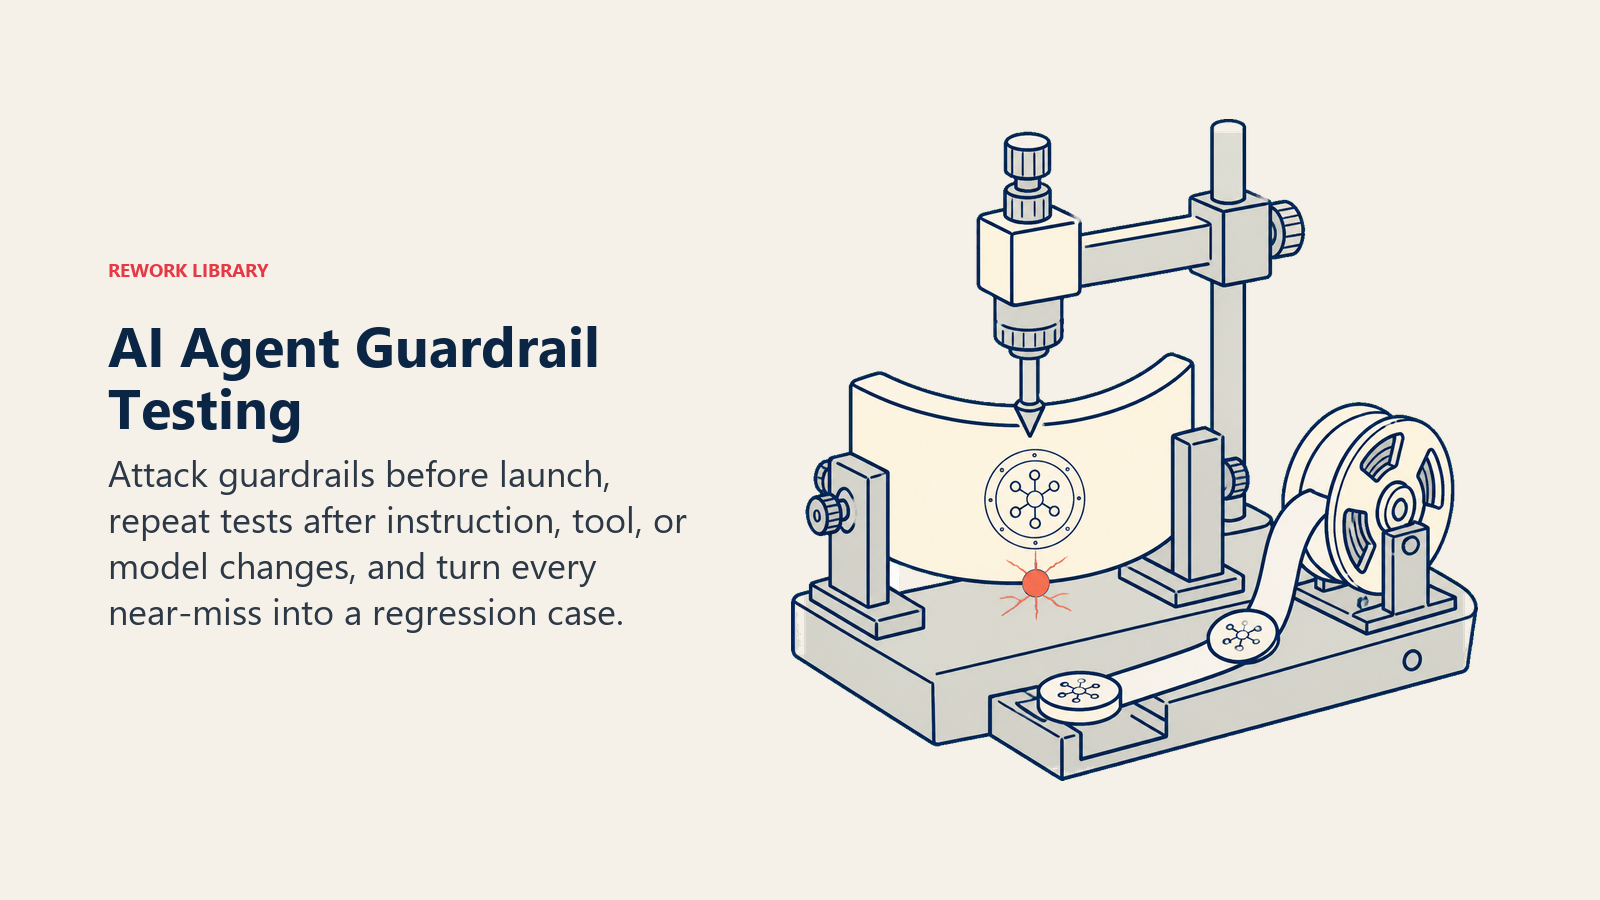
Führen Sie es selbstverständlich vor dem Launch durch. Führen Sie es nach jeder Änderung am Prompt, an der Tool-Liste oder am zugrunde liegenden Modell erneut durch, denn eine Guardrail, die beim Modell des letzten Quartals gehalten hat, kann beim Modell dieses Quartals unbemerkt versagen. Behandeln Sie jeden echten Beinahe-Vorfall, also einen Fall, in dem der Agent fast das Falsche getan hätte, eine Guardrail aber eingegriffen hat, als kostenlose Testdaten: Er zeigt Ihnen genau, was Sie beim nächsten Mal härter testen sollten.
Das Generative AI Profile NIST AI 600-1 ordnet das seiner MEASURE-Funktion zu: Risikomanagement ist erst vollständig, wenn Sie getestet haben, ob Ihre Kontrollen unter adversarialen Bedingungen halten, nicht nur, ob sie auf dem Papier existieren. Die meisten Organisationen sind bei AI Governance allgemein noch nicht so weit. Eine Umfrage von 2026 unter 193 Compliance-, Risiko- und Audit-Verantwortlichen ergab, dass 83 % der Organisationen AI-Tools nutzen, aber nur rund 25 % ein starkes Governance-Framework umgesetzt haben. Das heißt, die meisten AI Agents im Produktivbetrieb laufen heute mit Guardrails, die einmal geschrieben und seither nie adversarial getestet wurden.
Guardrails vs. Human-in-the-Loop: Verschiedene Aufgaben
Guardrails und Human-in-the-Loop-Checkpoints werden ständig in einen Topf geworfen, lösen aber unterschiedliche Probleme, und ein ausgereifter Agent braucht beides.
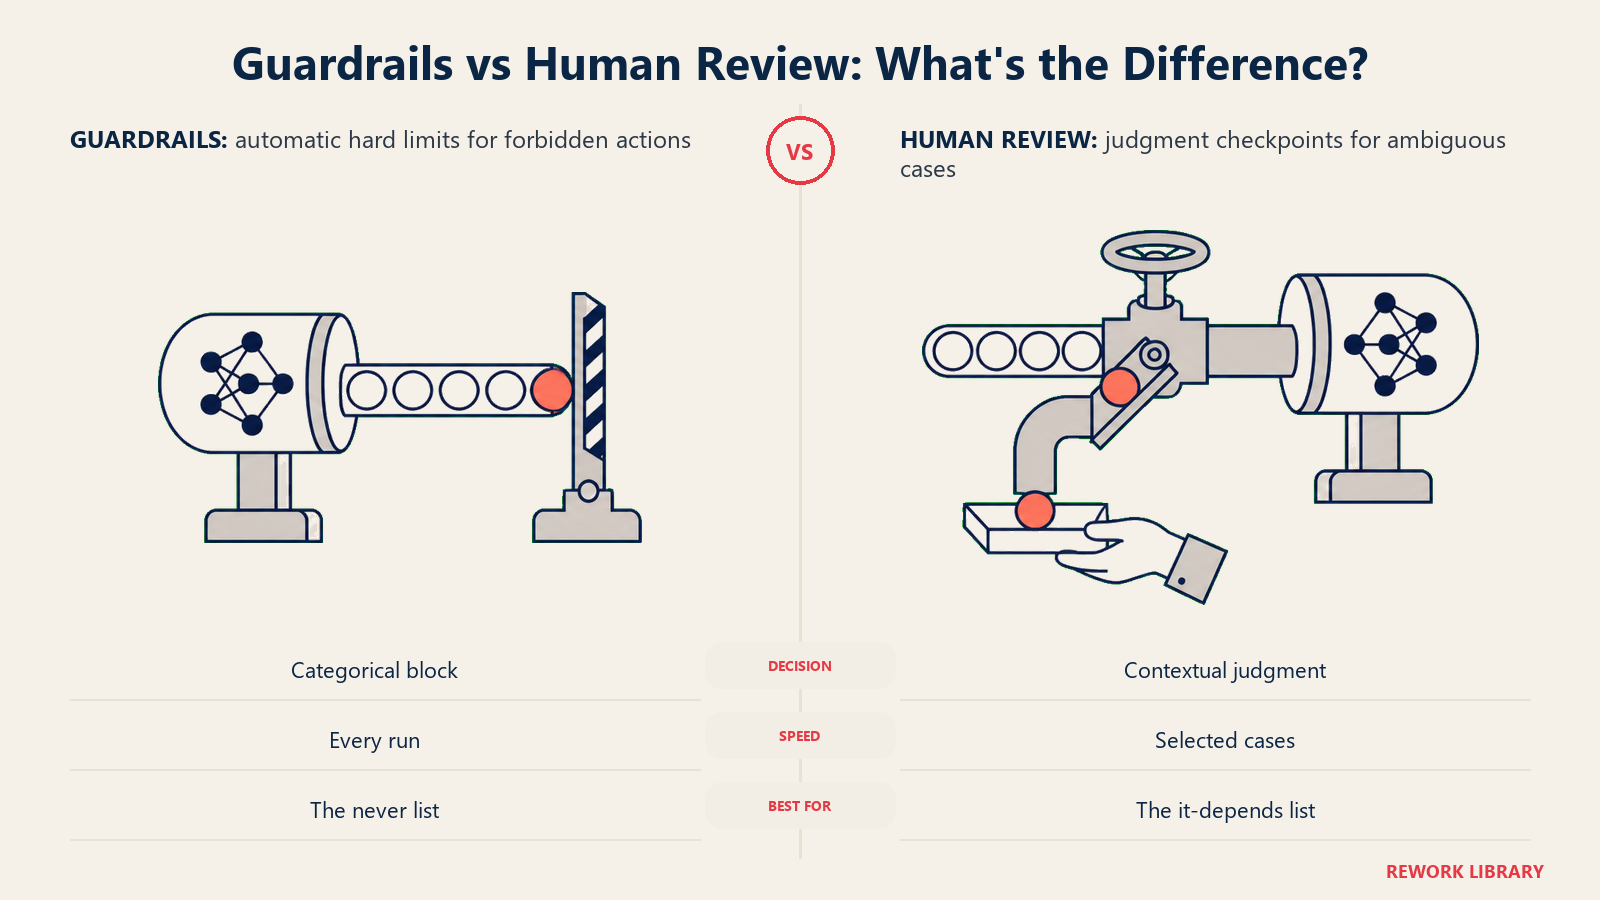
Eine Guardrail ist automatisch und kategorisch. Sie bittet nicht um Erlaubnis, sie setzt eine Grenze durch: nie X tun, unabhängig vom Kontext. Sie läuft bei jedem Durchlauf des Loops, in Maschinengeschwindigkeit, ohne dass jemand in Echtzeit zusieht.
Ein Human-in-the-Loop-Checkpoint ist eine Pause, keine Sperre. Er ist für Fälle da, in denen die richtige Antwort von einem Urteil abhängt, das eine Richtlinie vorab nicht vollständig abbilden kann: eine Preisausnahme, die für diesen konkreten Account sinnvoll ist, eine grenzwertige Vertragsklausel, die ein Jurist lesen muss. Der Agent weiß nicht, dass die Antwort falsch ist; er weiß, dass die Situation von der Art ist, die eine zweite Meinung braucht.
Zusammengefasst: Guardrails übernehmen die „Nie“-Liste, menschliche Checkpoints die „Es kommt darauf an“-Liste. Ein Agent nur mit Guardrails ist starr und wird trotzdem von allem ausmanövriert, was der Regelautor nicht vorhergesehen hat. Ein Agent nur mit menschlichen Checkpoints ist langsam und verfehlt den Zweck, die Arbeit überhaupt zu automatisieren. Sie brauchen den harten Boden und das Urteilsventil, nicht nur eines von beiden.
Ein Starter-Guardrail-Set nach Funktion
Einige konkrete Beispiele aus den Blueprints dieser Library, wie eine Guardrail aussieht, wenn sie spezifisch genug ist, um tatsächlich durchgesetzt zu werden:
| Agent | Guardrail |
|---|---|
| Invoice AP Agent | Nie eine Rechnung bezahlen, die nicht zu einer genehmigten Bestellung passt, egal wie sicher der Match-Score ist |
| Expense Approval Agent | Nie oberhalb einer festen Betragsgrenze automatisch genehmigen, ohne Ausnahmelogik, die sie überschreiben kann |
| AI Contract Review Agent | Nie ein Redline oder eine Antwort an die Gegenpartei senden, ohne dass ein Mensch die konkrete Änderung freigegeben hat |
| AI Security Monitoring Agent | Nie einen Alert mit kritischem Schweregrad automatisch schließen; unabhängig von der eigenen Sicherheit des Agents ans SOC weiterleiten |
| AI Access Provisioning Agent | Nie erhöhte oder Admin-Rechte ohne einen dokumentierten, namentlich benannten Genehmiger vergeben |
Jede davon ist bewusst eng gefasst und binär. Eine Guardrail der Form „bei Zahlungen gutes Urteilsvermögen walten lassen“ ist keine Guardrail, sondern ein Wunsch. „Nie ohne passende Bestellung zahlen“ lässt sich bauen, testen und beweisen.
Wenn Sie Guardrail- und Zugriffsrichtlinien speziell für IT-nahe Agents standardisieren, behandeln die Kategorie Dev- und IT-Tools und der Leitfaden Wie Sie ITSM-Software auswählen die Policy-Engines und Genehmigungs-Workflows, auf denen die meisten dieser Guardrails am Ende laufen.
Key Facts
- Eine Guardrail ist eine harte Grenze, die auch dann hält, wenn alles an einer Situation versucht, sie zu umgehen; eine Regel prägt das Normalverhalten, eine Guardrail stoppt abnormales Verhalten.
- Wirksame Guardrails laufen in zwei Ebenen: Input-Filterung, bevor Inhalte zu vertrauenswürdigem Kontext werden, und Output-Filterung, bevor sich eine Aktion oder Antwort festlegt.
- Allow-Listing von Tools (Least Privilege) schlägt den Versuch, jede schlechte Aktion per Deny-List auszuschließen; OWASP nennt das Versäumnis Excessive Agency, LLM06 in seinen Top 10 für LLM-Anwendungen.
- Eine Guardrail ist nur so gut wie das adversariale Testen dahinter. Eine Umfrage von 2026 ergab, dass 83 % der Organisationen AI-Tools nutzen, aber nur rund 25 % ein starkes Governance-Framework haben.
- Guardrails und Human-in-the-Loop-Checkpoints erfüllen unterschiedliche Aufgaben: Guardrails setzen die „Nie“-Liste automatisch durch, Checkpoints behandeln die „Es kommt darauf an“-Fälle, die ein Urteil erfordern.
Häufig gestellte Fragen zu AI Agent Guardrails
Was ist eine AI-Agent-Guardrail?
Eine Guardrail ist eine in einen Agent eingebaute harte Grenze, die unabhängig vom Kontext gilt: nie einen Preis erfinden, nie die Daten eines Kunden mit einem anderen teilen, nie eine E-Mail ohne Freigabe senden. Sie unterscheidet sich von einer normalen Anweisung dadurch, dass sie auch dann halten soll, wenn aktiv etwas versucht, sie zu umgehen, sei es ein Angreifer, ein Fehler oder ein Grenzfall, an den niemand gedacht hat.
Was ist der Unterschied zwischen einer Guardrail und einer Regel?
Regeln beschreiben, wie sich ein Agent normalerweise verhalten soll: Tonalität, Formulierungen, welche Fakten er nennt. Guardrails beschreiben, was er nie tun darf, auch in Situationen, die eine Regel nicht vorhergesehen hat. Wird eine Regel gebrochen, hat der Agent sich ein wenig markenfremd verhalten. Wird eine Guardrail gebrochen, hat der Agent etwas getan, das er gezielt nicht tun sollte.
Sollten Guardrails für Tools eine Allow-List oder eine Deny-List verwenden?
Eine Allow-List. Jede Aktion aufzuzählen, die ein Agent nicht ausführen soll, ergibt eine endlose Liste; genau aufzuzählen, was er tun darf, und alles andere standardmäßig zu blockieren, ist endlich und prüfbar. OWASP nennt es Excessive Agency, wenn ein Agent mehr Berechtigungen hat, als seine Aufgabe braucht, eines seiner Top-10-Risiken für LLM-Anwendungen.
Woran erkenne ich, ob die Guardrails meines Agents tatsächlich funktionieren?
Testen Sie sie adversarial, so wie ein Security-Team es täte, vor dem Launch und erneut nach jeder Änderung an Prompt, Tools oder Modell. Eine Guardrail, die im Test nie aktiv angegriffen wurde, ist eine Guardrail, über die Sie Vermutungen anstellen, keine, die Sie überprüft haben.
Ersetzen Guardrails die Notwendigkeit von Human-in-the-Loop-Checkpoints?
Nein, sie decken unterschiedliche Fehlerarten ab. Guardrails sind automatisch und kategorisch, gebaut für die „Nie“-Liste. Human-in-the-Loop-Checkpoints sind für Urteilsentscheidungen, die eine Guardrail vorab nicht vollständig abbilden kann. Ein ausgereifter Agent braucht beides: den harten Boden und das Urteilsventil.
Wie es weitergeht
Guardrails, menschliche Checkpoints und Abwehr gegen Injection sind drei Teile desselben Systems, nicht drei getrennte Projekte. Beginnen Sie mit Prompt-Injection, um den Angriff zu verstehen, den diese Guardrails überstehen sollen, und lesen Sie dann Human-in-the-Loop für AI Agents für die Urteilsebene, die daneben steht. Wie alle sechs Bausteine überhaupt zusammenspielen, erklärt Wie AI Agents funktionieren.

On this page
- Was eine Guardrail von einer Regel unterscheidet
- Die zwei Ebenen, die jeder Agent braucht: Input und Output
- Allow-Lists schlagen Deny-Lists bei Agent-Tools
- Wo Guardrails im Agent-Loop sitzen
- Testen, ob Ihre Guardrails tatsächlich funktionieren
- Guardrails vs. Human-in-the-Loop: Verschiedene Aufgaben
- Ein Starter-Guardrail-Set nach Funktion
- Key Facts
- Wie es weitergeht