Barreiras de Proteção para AI Agents: Como Manter os Agents Seguros e Alinhados às Políticas
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
As barreiras de proteção (guardrails) de um AI agent são as regras rígidas que ele jamais pode quebrar, não importa o que a conversa, os dados ou um prompt engenhoso tentem fazê-lo fazer. Elas ficam separadas das instruções normais do agent: as instruções descrevem como o agent deve se comportar no dia a dia, e as barreiras descrevem o que ele nunca deve fazer, mesmo que algo o convença do contrário. Um agent bem construído tem barreiras tanto sobre o que entra numa chamada de ferramenta quanto sobre o que sai dela, testadas do mesmo jeito que uma equipe de segurança as testaria, e não apenas escritas no papel na esperança de que funcionem.
Esta é a versão mais profunda, específica para agents, de o que são guardrails de AI em geral. O conceito mais amplo abrange também moderação de conteúdo e segurança de chatbots; aqui o foco é a mecânica de um agent que chama ferramentas e executa ações reais, em que uma barreira que falha não produz apenas uma frase ruim, mas um reembolso errado, um e-mail errado ou um registro errado.
O Que Diferencia uma Barreira de Proteção de uma Regra
Como os AI agents funcionam define seis blocos de construção de que todo agent precisa, e dois deles são confundidos o tempo todo: Regras e Barreiras de Proteção. As regras são o comportamento sempre ativo que molda como o agent age normalmente: voz da marca, quais fatos ele afirma, como formula uma recusa. As barreiras são diferentes em natureza, não apenas em grau. São os limites rígidos que valem mesmo quando uma regra deixaria algo passar: nunca inventar um preço, nunca compartilhar os dados de um cliente com outro, nunca seguir uma instrução embutida no conteúdo que está lendo e que tenta sobrescrever a configuração real do agent.
O teste que as separa: uma regra molda o comportamento normal. Uma barreira é o que dispara quando algo anormal está acontecendo, um caso-limite, um ataque, um bug em outra parte do pipeline que alimenta o agent com dados ruins. Se uma regra é quebrada, o agent agiu de forma um pouco fora da marca. Se uma barreira é quebrada, o agent fez algo que foi construído especificamente para nunca fazer. Um agent opera com autonomia limitada, livre para agir dentro dos limites e obrigado a parar na borda deles, e as barreiras de proteção são o mecanismo que realmente impõe a metade "limitada" dessa expressão.
As Duas Camadas de que Todo Agent Precisa: Entrada e Saída
Os sistemas práticos de barreiras verificam o agent duas vezes: na entrada e na saída.
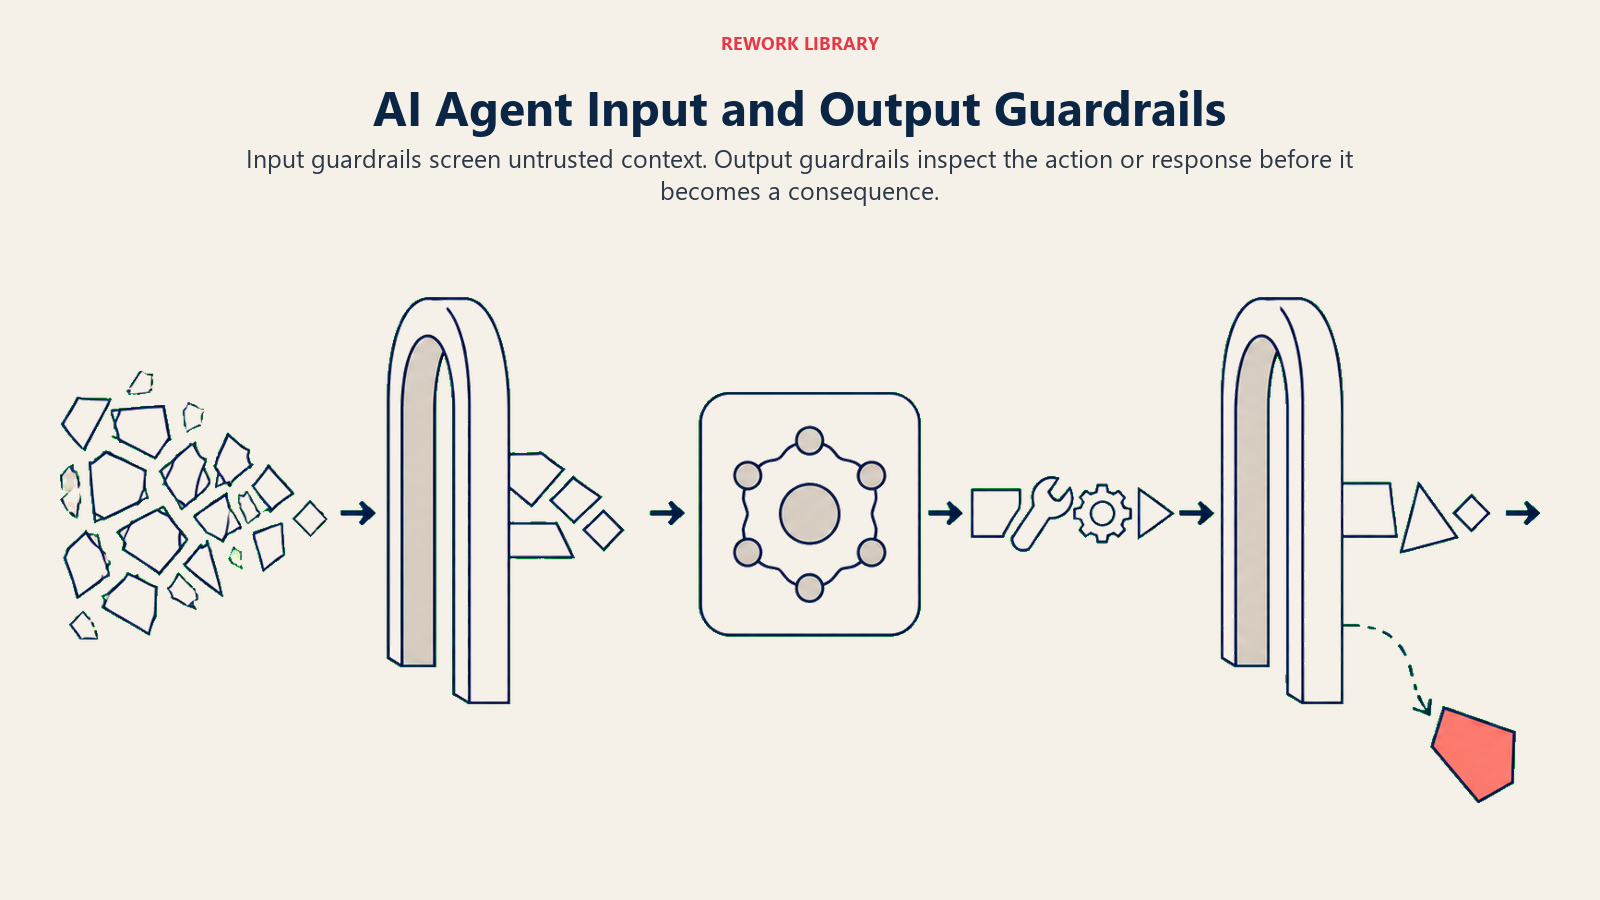
As barreiras de entrada filtram o que chega ao agent antes de ser tratado como contexto confiável. É a camada que pega uma tentativa de prompt injection escondida num documento que o agent está prestes a ler, ou um pedido de chamada de ferramenta que não corresponde a nada que o agent de fato foi solicitado a fazer. É a ponta mais afiada da aplicação de segurança de AI a agents em particular. Filtros baseados em padrões pegam modelos de ataque conhecidos; um modelo classificador pega os novos.
As barreiras de saída filtram o que o agent está prestes a fazer ou dizer antes de ele se comprometer. É a camada que pega uma resposta redigida que vaza dados de outro cliente, um parâmetro de chamada de ferramenta fora da faixa esperada (um reembolso de US$ 50.000 quando a política limita os reembolsos automáticos a US$ 500) ou uma resposta que viola uma política declarada mesmo que nada anterior tenha sinalizado problema.
Nenhuma das camadas basta sozinha. A orientação da OWASP sobre isso é direta: defesa em profundidade, porque um filtro isolado, por melhor que seja, acaba sendo contornado por algo novo. Rodar as duas camadas de forma independente significa que uma falha de um lado ainda é pega do outro.
Listas de Permissão Vencem Listas de Bloqueio nas Ferramentas do Agent
O erro mais comum com barreiras é tentar enumerar tudo o que um agent não deveria fazer. Essa lista é infinita. A versão que funciona é o oposto: enumerar exatamente o que o agent tem permissão para fazer e bloquear todo o resto por padrão.
É o que a OWASP chama de Excessive Agency, o item LLM06 do seu Top 10 para aplicações de LLM: um sistema que recebe mais funcionalidade, permissões ou autonomia do que o trabalho realmente exige. Um agent criado para redigir sugestões de reembolso não precisa de uma ferramenta que as emita. Um agent que pesquisa contas não precisa de acesso de envio ao seu cliente de e-mail. Cada ferramenta que um agent pode chamar já é, por si só, uma decisão de barreira: ao dar a ferramenta, você concede a permissão, quer tenha pretendido concedê-la para todas as situações em que ela poderia ser usada, quer não.
O padrão Autonomous Agent chama isso de limites de escopo: uma lista de permissão explícita das ferramentas a que o agent pode ter acesso, revisada antes da implantação, sem expansão em tempo de execução. Se o agent precisa de uma nova capacidade no meio de uma tarefa, isso é um sinal para um humano tomar uma decisão de configuração, e não algo que o agent concede a si mesmo.
Onde as Barreiras Ficam no Ciclo do Agent
Mapeadas sobre o ciclo de perceber, raciocinar, agir e observar, as barreiras pertencem a três pontos específicos, e não flutuando de forma genérica ao redor do agent:
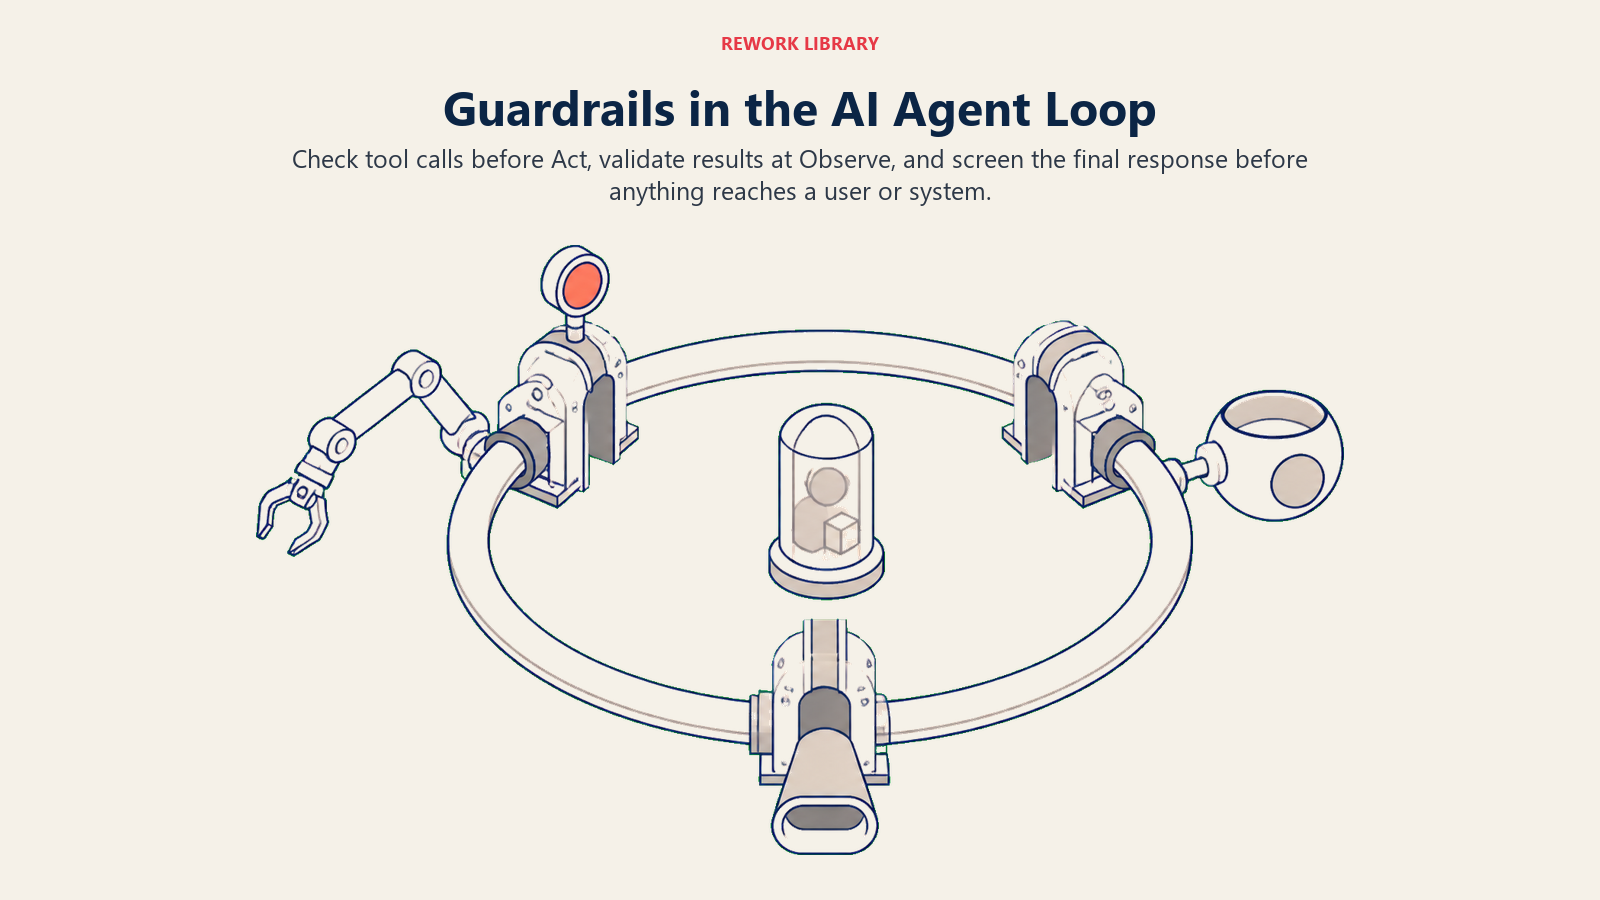
| Etapa do ciclo | Verificação da barreira | Exemplo |
|---|---|---|
| Antes de Agir | Esta chamada de ferramenta está na lista de permissão e seus parâmetros estão dentro dos limites esperados? | Bloquear uma chamada da ferramenta de reembolso acima do limite de aprovação automática antes que ela dispare |
| Na Observação | O resultado da ferramenta parece coerente antes de o agent raciocinar a partir dele? | Tratar uma API de calendário que devolve uma data de anos atrás como sinal para parar, e não para prosseguir |
| Antes da resposta final | O texto redigido viola uma política declarada, mesmo que todas as etapas anteriores parecessem corretas? | Pegar uma resposta que cita um preço que o agent nunca recebeu, uma provável alucinação |
Embutir a verificação no próprio ciclo, em vez de deixá-la como um processo de revisão separado que acontece depois, é o que faz de uma barreira uma barreira e não um documento de política. Ela dispara em tempo real, antes que a consequência se concretize, a cada execução, e não numa amostra de execuções que uma equipe de compliance revisa semanas depois. É também o que gera a trilha de auditoria exigida pelos requisitos de governança de cada padrão: um registro de exatamente qual barreira disparou, quando e por quê.
Testando se as Suas Barreiras Realmente Funcionam
Uma barreira que ninguém tentou quebrar é uma barreira sobre a qual você está apenas supondo. O red teaming de AI, um teste adversarial estruturado em que alguém tenta ativamente fazer o agent fazer o que ele não deveria, é o que transforma "temos barreiras" de uma afirmação em um fato verificado.
Faça isso antes do lançamento, é claro. Faça de novo após qualquer mudança no prompt, na lista de ferramentas ou no modelo subjacente, porque uma barreira que resistiu ao modelo do trimestre passado pode falhar em silêncio com o modelo deste trimestre. Trate cada quase-acidente real, um caso em que o agent quase fez a coisa errada mas uma barreira o impediu, como dado de teste gratuito: ele mostra exatamente o que testar com mais rigor na próxima vez.
O AI 600-1 Generative AI Profile do NIST enquadra isso na sua função MEASURE: a gestão de riscos não está completa até que você tenha testado se os seus controles aguentam condições adversariais, e não apenas se eles existem no papel. A maioria das organizações ainda não chegou lá em governança de AI de modo geral. Uma pesquisa de 2026 com 193 líderes de compliance, risco e auditoria constatou que 83% das organizações dizem usar ferramentas de AI, mas apenas cerca de 25% implementaram uma estrutura de governança sólida, o que significa que a maioria dos AI agents em produção hoje roda com barreiras que foram escritas uma vez e nunca mais testadas de forma adversarial.
Barreiras vs Human-in-the-Loop: Funções Diferentes
As barreiras e os pontos de controle com intervenção humana são constantemente confundidos, mas resolvem problemas diferentes, e um agent maduro precisa dos dois.
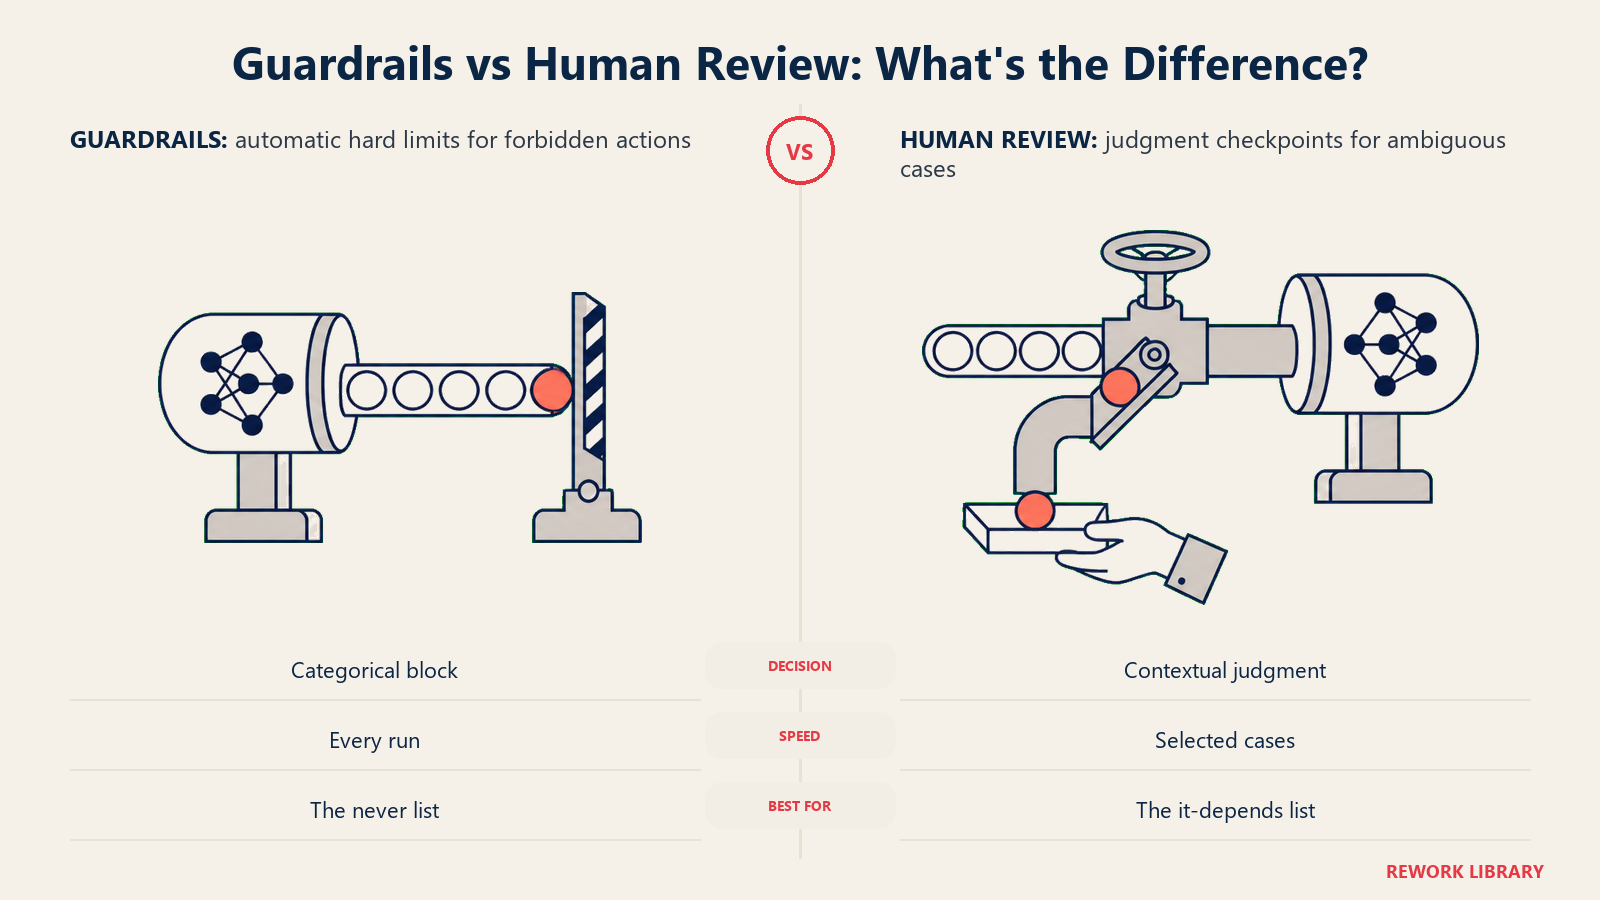
Uma barreira é automática e categórica. Ela não pede permissão, ela impõe uma linha: nunca fazer X, seja qual for o contexto. Roda a cada passagem pelo ciclo, na velocidade da máquina, sem ninguém acompanhando em tempo real.
Um ponto de controle com intervenção humana é uma pausa, não um bloqueio. Serve para os casos em que a resposta certa depende genuinamente de um julgamento que uma política não consegue codificar por completo de antemão: uma exceção de preço que faz sentido para esta conta específica, uma cláusula contratual limítrofe que precisa da leitura de um advogado. O agent não sabe que a resposta está errada; ele sabe que a situação é do tipo que pede uma segunda opinião.
Juntando tudo: as barreiras cuidam da lista do "nunca", e os pontos de controle humanos cuidam da lista do "depende". Um agent só com barreiras é rígido e ainda é driblado por qualquer coisa que quem escreveu as regras não previu. Um agent só com pontos de controle humanos é lento e anula o propósito de automatizar o trabalho. Você precisa do piso rígido e da válvula de julgamento, e não de um ou outro.
Um Conjunto Inicial de Barreiras por Função
Alguns exemplos concretos, tirados dos blueprints desta biblioteca, de como é uma barreira quando ela é específica o bastante para ser imposta de verdade:
| Agent | Barreira |
|---|---|
| Invoice AP Agent | Nunca pagar uma fatura que não corresponda a um pedido de compra aprovado, não importa quão confiante seja a pontuação de correspondência |
| Expense Approval Agent | Nunca aprovar automaticamente acima de um limite fixo em dinheiro, sem nenhuma lógica de exceções capaz de sobrepô-lo |
| AI Contract Review Agent | Nunca enviar uma revisão (redline) ou resposta à contraparte sem a aprovação de um humano sobre a alteração específica |
| AI Security Monitoring Agent | Nunca encerrar automaticamente um alerta de severidade crítica; encaminhá-lo ao SOC, qualquer que seja a confiança do próprio agent |
| AI Access Provisioning Agent | Nunca conceder acesso elevado ou de administrador sem um aprovador nomeado registrado |
Cada uma dessas barreiras é deliberadamente estreita e binária. Uma barreira formulada como "use bom senso em relação a pagamentos" não é uma barreira, é um desejo. "Nunca pagar sem um pedido de compra correspondente" é algo que você pode construir, testar e provar.
Se você está padronizando barreiras e políticas de acesso para agents voltados a TI em particular, a categoria de ferramentas de dev e TI e o guia como escolher um software de ITSM cobrem os motores de políticas e os workflows de aprovação sobre os quais a maioria dessas barreiras acaba rodando.
Key Facts
- Uma barreira é um limite rígido que se mantém mesmo quando tudo na situação tenta contorná-lo; uma regra molda o comportamento normal, uma barreira impede o comportamento anormal.
- As barreiras eficazes rodam em duas camadas: filtragem de entrada antes de o conteúdo virar contexto confiável e filtragem de saída antes de uma ação ou resposta se concretizar.
- Usar listas de permissão para as ferramentas (privilégio mínimo) vence tentar bloquear cada ação ruim; a OWASP chama a falha em fazer isso de Excessive Agency, o item LLM06 do seu Top 10 para aplicações de LLM.
- Uma barreira só é tão boa quanto o teste adversarial por trás dela. Uma pesquisa de 2026 constatou que 83% das organizações usam ferramentas de AI, mas apenas cerca de 25% têm uma estrutura de governança sólida.
- As barreiras e os pontos de controle human-in-the-loop têm funções diferentes: as barreiras impõem a lista do "nunca" de forma automática, e os pontos de controle cuidam dos casos de "depende" que exigem julgamento.
Perguntas Frequentes sobre Barreiras de Proteção para AI Agents
O que é uma barreira de proteção de AI agent?
Uma barreira é um limite rígido embutido no agent que vale seja qual for o contexto: nunca inventar um preço, nunca compartilhar os dados de um cliente com outro, nunca enviar um e-mail sem aprovação. Ela se diferencia de uma instrução comum porque foi projetada para se manter mesmo quando algo tenta ativamente contorná-la, seja um atacante, um bug ou um caso-limite que ninguém previu.
Qual é a diferença entre uma barreira e uma regra?
As regras descrevem como um agent deve se comportar normalmente: tom, formulação, quais fatos ele afirma. As barreiras descrevem o que ele nunca deve fazer, mesmo em situações que uma regra não previu. Se uma regra é quebrada, o agent agiu de forma um pouco fora da marca. Se uma barreira é quebrada, o agent fez algo que foi construído especificamente para evitar.
As barreiras devem usar uma lista de permissão ou uma lista de bloqueio para as ferramentas?
Lista de permissão. Tentar enumerar cada ação que um agent não deveria tomar é uma lista sem fim; enumerar exatamente o que ele pode fazer e bloquear todo o resto por padrão é finito e auditável. A OWASP chama de Excessive Agency o ato de dar a um agent mais permissão do que o trabalho dele exige, um dos seus 10 principais riscos para aplicações de LLM.
Como sei se as barreiras do meu agent realmente funcionam?
Teste-as de forma adversarial, do mesmo jeito que uma equipe de segurança faria, antes do lançamento e de novo após qualquer mudança no prompt, nas ferramentas ou no modelo. Uma barreira que nunca foi atacada de verdade em testes é uma barreira sobre a qual você está supondo, e não uma que você verificou.
As barreiras substituem a necessidade de pontos de controle human-in-the-loop?
Não, elas cobrem modos de falha diferentes. As barreiras são automáticas e categóricas, feitas para a lista do "nunca". Os pontos de controle human-in-the-loop servem para os julgamentos que uma barreira não consegue codificar por completo de antemão. Um agent maduro precisa dos dois: o piso rígido e a válvula de julgamento.
Para Onde Ir Agora
As barreiras de proteção, os pontos de controle humanos e as defesas contra injection são três partes do mesmo sistema, e não três projetos separados. Comece por prompt injection para entender o ataque que essas barreiras foram feitas para resistir, depois vá para human-in-the-loop para AI agents para a camada de julgamento que fica ao lado delas. Para ver como os seis blocos de construção se encaixam desde o início, como os AI agents funcionam é o ponto de partida.

On this page
- O Que Diferencia uma Barreira de Proteção de uma Regra
- As Duas Camadas de que Todo Agent Precisa: Entrada e Saída
- Listas de Permissão Vencem Listas de Bloqueio nas Ferramentas do Agent
- Onde as Barreiras Ficam no Ciclo do Agent
- Testando se as Suas Barreiras Realmente Funcionam
- Barreiras vs Human-in-the-Loop: Funções Diferentes
- Um Conjunto Inicial de Barreiras por Função
- Key Facts
- Para Onde Ir Agora