Bahasa Indonesia
Manajemen Konteks AI Agent: Penganggaran, Kompaksi, dan Retrieval
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Manajemen konteks AI agent adalah praktik menentukan apa yang masuk ke context window model pada setiap langkah sebuah proses: instruksi mana, hasil tool mana, dokumen hasil retrieval mana, dan giliran sebelumnya mana yang benar-benar layak mendapat tempat, serta apa yang diringkas, dibuang, atau diambil nanti saja. Hal ini penting karena agent tidak hanya mendapat satu kesempatan untuk satu prompt. Agent berjalan dalam loop, dan setiap putaran loop bersaing memperebutkan ruang yang terbatas dan semakin penuh. Jika konteks diperlakukan sebagai ruang coretan gratis, agent menjadi makin lambat, makin mahal, dan makin tidak akurat seiring lamanya tugas berjalan. Jika diperlakukan sebagai anggaran, agent tetap tajam.
Mengapa Ini Masalah Agent, Bukan Masalah Chat
Satu pertanyaan ke chatbot hanya mengisi potongan kecil context window yang mudah diprediksi: system prompt, pertanyaan, jawaban. Agent berbeda. Cara kerja AI agent menggambarkan loop yang dijalankannya: mengamati, bernalar, bertindak, memeriksa hasil, ulangi, dan setiap putaran dapat menambah beban yang harus dipegang model. Tugas sepuluh langkah sudah membaca sepuluh batch output tool, membuat sepuluh keputusan, dan mungkin mengambil beberapa dokumen pada saat selesai. Tidak satu pun dari itu hilang otomatis. Semuanya tetap berada di context window kecuali ada yang sengaja mengelolanya.
Tim engineering Anthropic membingkai masalah dasarnya dengan baik dalam panduannya tentang context engineering untuk AI agent: konteks adalah sumber daya terbatas dengan imbal hasil marginal yang menurun. Setiap token tambahan di luar kebutuhan sebuah langkah tidak hanya menambah biaya, tetapi dapat secara aktif merugikan kinerja, karena attention pada transformer harus tersebar ke semua isi window, dan makin tipis seiring window terisi. Itu mode kegagalan yang berbeda dari kehabisan ruang. Kualitas menurun diam-diam padahal ruang masih tersisa, dinamika yang didokumentasikan langsung oleh riset Chroma tentang kinerja long-context, yang menguji 18 model terkemuka dan menemukan bahwa akurasi bisa mulai turun jauh sebelum window secara teknis penuh. AI Agent Memory membahas riset itu lebih dalam dari sisi penyimpanan; halaman ini melanjutkan dari sana, tentang apa yang sebenarnya harus dilakukan.
Apa yang Sebenarnya Memenuhi Konteks Agent
Sebelum dapat menganggarkan context window, Anda perlu tahu apa saja yang bersaing memperebutkan ruangnya. Pada proses agent yang tipikal, lima kategori memperebutkan token yang sama:
| Isi konteks | Fungsinya | Mengapa membesar |
|---|---|---|
| System prompt dan aturan | Peran, nada, dan perilaku agent yang selalu aktif | Jarang membesar setelah ditulis, tetapi sering dijejali kasus tepi seiring waktu |
| Skema tool | Definisi setiap tool yang dapat dipanggil agent | Membesar dengan setiap tool yang ditambahkan ke perangkat agent |
| Hasil panggilan tool | Output mentah dari setiap panggilan API, pencarian, atau lookup sejauh ini | Membesar paling cepat, terutama dengan respons API yang bertele-tele |
| Riwayat percakapan dan langkah | Apa yang telah ditanyakan, diputuskan, dan dilakukan sejauh ini dalam proses | Membesar di setiap langkah pada tugas multi-langkah |
| Dokumen hasil retrieval atau memori | Pengetahuan yang ditarik untuk menjawab atau memutuskan | Membesar jika retrieval tidak dibatasi dengan ketat |
Hasil panggilan tool biasanya pelanggar terbesar dalam praktik. Cara AI agent menggunakan tool membahas bagaimana panggilan tool mengembalikan hasil mentah yang dibaca model sebelum memutuskan langkah berikutnya, dan banyak API mengembalikan jauh lebih banyak daripada yang dibutuhkan agent: seluruh record pelanggan padahal hanya butuh satu field, seluruh respons pencarian padahal hanya butuh tiga hasil teratas. AI Research Agent menunjukkan apa yang terjadi bila hal ini dibiarkan: brief yang menarik sepuluh sumber penuh ke konteks alih-alih tiga kutipan terfokus tidak hanya lebih lambat dibuat, tetapi juga mengencerkan perhatian model ke materi yang sebagian besar toh tidak masuk ke sintesis akhir.
Penganggaran: Tentukan Apa yang Layak Mendapat Tempat Sebelum Penuh
Anggaran konteks adalah ide sederhana yang diterapkan dengan sengaja, bukan secara kebetulan: tentukan, sebelum proses dimulai, kira-kira seberapa banyak window yang boleh dipakai tiap kategori di atas, lalu tegakkan selama proses berjalan. Kerangka Anthropic untuk ini adalah mencari set token berkualitas tinggi sekecil mungkin yang mengantar model ke hasil yang benar, bukan set terbesar yang mungkin relevan.
Dalam praktik, artinya beberapa kebiasaan konkret:
- Pangkas hasil tool sebelum masuk ke konteks, bukan sesudahnya. Ambil dua atau tiga field yang benar-benar dibutuhkan sebuah langkah dari respons API, alih-alih meneruskan seluruh payload.
- Jaga system prompt tetap ringkas. System prompt yang dijejali setiap kasus tepi yang pernah terjadi adalah pajak permanen pada setiap proses, baik kasus itu muncul maupun tidak.
- Batasi riwayat, jangan biarkan terbuka tanpa batas. Tentukan berapa banyak langkah sebelumnya dari tugas panjang yang tetap utuh dibanding yang dipadatkan (dibahas di bawah).
- Batasi cakupan retrieval secara sempit. Ambil beberapa chunk yang benar-benar dibutuhkan sebuah pertanyaan, bukan seluruh dokumen, pelajaran yang dibahas RAG untuk AI agent dari sisi grounding; ini juga keputusan anggaran konteks, bukan hanya soal akurasi.
Kompaksi: Ringkas Sebelum Meluap, Bukan Sesudahnya
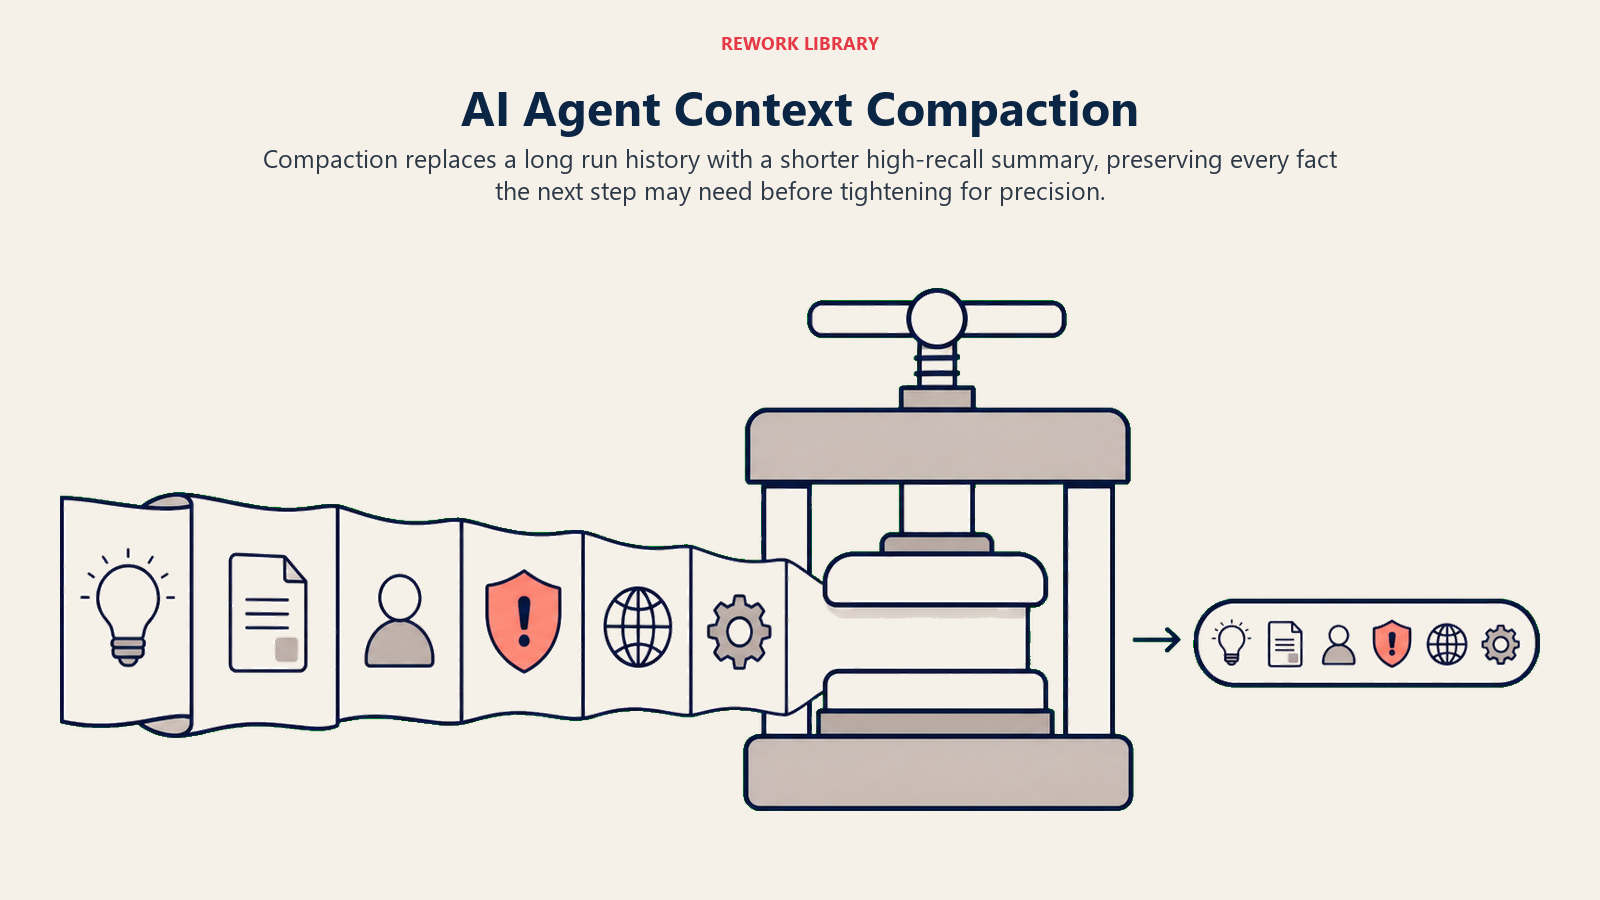
Kompaksi adalah tindakan ketika sebuah proses sudah mengumpulkan riwayat lebih banyak daripada yang perlu dipertahankan utuh: ringkas apa yang telah terjadi menjadi bentuk padat, lalu lanjutkan tugas dari ringkasan itu, bukan dari seluruh transkrip. Panduan Anthropic spesifik tentang cara melakukannya dengan baik: utamakan recall tinggi terlebih dahulu, pastikan langkah kompaksi menangkap setiap informasi yang mungkin dibutuhkan langkah berikutnya, lalu perketat untuk presisi setelah memastikan tidak ada yang penting yang hilang. Membalik urutan itu, mengoptimalkan ringkasan yang pendek sebelum memastikan ringkasan itu lengkap, adalah cara agent yang telah dipadatkan diam-diam mulai melupakan hal-hal yang penting.
Ide lama yang terkait dan layak diketahui adalah MemGPT, usulan yang meminjam memori berjenjang dari sistem operasi: simpan sedikit informasi "panas" di konteks langsung model, dan pindahkan sisanya ke penyimpanan yang lebih lambat dan lebih besar, lalu tarik kembali hanya ketika sebuah langkah benar-benar membutuhkannya. Kompaksi dan retrieval just-in-time, yang dibahas berikutnya, keduanya adalah versi praktis dari ide paging yang sama.
Retrieval Just-in-Time Mengalahkan Memuat Semuanya di Awal
Naluri ketika agent mungkin membutuhkan sebuah informasi adalah memuatnya ke konteks di depan, untuk berjaga-jaga. Pola yang lebih baik, dan yang sangat diandalkan panduan Anthropic, adalah retrieval just-in-time: beri agent referensi ringan, seperti path file, ID record, atau tool pencarian, dan biarkan agent menarik konten sebenarnya hanya pada langkah yang membutuhkannya. Ini mencerminkan cara seseorang mengerjakan tugas. Tidak ada yang menghafal seluruh manual kebijakan sebelum menjawab satu pertanyaan tentang cuti melahirkan; orang mencari bagian yang relevan ketika pertanyaan datang.
Inilah mekanisme yang dijelaskan RAG untuk AI agent: retrieval, di dalam agent, sebenarnya adalah panggilan tool seperti lainnya, berada di langkah mengamati dalam loop, dipicu ketika langkah tertentu membutuhkan informasi tertentu, bukan dimuat sekaligus di awal. Manfaat manajemen konteksnya terpisah dari manfaat grounding. Bahkan jika model secara teknis dapat memuat seluruh knowledge base ke window-nya, melakukan itu tetap langkah yang salah, karena setiap token di dalamnya di luar kebutuhan langkah saat ini mengencerkan perhatian model pada token yang benar-benar penting sekarang.
Mendelegasikan ke Sub-Agent: Window Bersih untuk Pekerjaan Terfokus
Ketika satu langkah dalam tugas yang lebih besar perlu banyak membaca, meneliti, atau menjelajah untuk mencapai sesuatu yang sempit, salah satu langkah manajemen konteks yang paling efektif adalah menyerahkan langkah itu ke sub-agent terpisah alih-alih mengerjakannya secara inline. Sub-agent mendapat context window bersihnya sendiri, mengerjakan pekerjaan berat di sana, dan mengembalikan hasil yang dipadatkan, sering kali dalam kisaran 1.000 hingga 2.000 token menurut contoh Anthropic sendiri, ke agent utama, alih-alih menyeret seluruh proses kerjanya kembali.
Sistem multi-agent membahas sisi orkestrasi dari pola ini secara mendalam: kapan membagi pekerjaan ke beberapa agent sepadan dengan kompleksitasnya, dibanding kapan itu rekayasa berlebihan untuk pekerjaan yang masih bisa ditangani satu agent. Dari sudut pandang manajemen konteks semata, alasan untuk sub-agent lebih sempit dan lebih mekanis: langkah yang kalau tidak akan membanjiri window agent utama dengan detail eksploratif yang tidak perlu dibawa ke depan adalah kandidat yang baik untuk diisolasi, diringkas, dan diserahkan kembali.
Memantau Kesehatan Konteks Setelah Rilis
Strategi konteks yang berhasil saat pengujian tetap bisa menyimpang setelah terkena traffic nyata: output tool menjadi bertele-tele setelah pembaruan API, knowledge base bertambah, kasus tepi ditanam langsung di system prompt dan tidak pernah dihapus. Observabilitas AI agent sudah menyebutkan metrik yang layak dilacak di sini: iterasi loop per proses yang meningkat dan biaya per tugas selesai yang meningkat sama-sama merupakan tanda dini bahwa konteks membengkak secara diam-diam, sering sebelum akurasi terlihat turun. Optimasi biaya AI agent membahas sisi caching dari koin yang sama, membuat konteks yang dipakai ulang jauh lebih murah untuk dikirim ulang, yang penting berdampingan dengan kompaksi, bukan sebagai penggantinya, karena konteks yang sudah di-cache pun tetap harus diperhatikan model pada setiap panggilan.
Jika Anda mengevaluasi platform yang menangani codebase besar atau sesi panjang dengan baik, perbandingan developer tools kami dan panduan membeli AI coding assistant sama-sama membahas penanganan context window sebagai pembeda yang nyata, bukan catatan kaki, karena itu salah satu tempat paling jelas yang menunjukkan kualitas coding assistant pada proyek besar.
Key Facts
- Anthropic membingkai konteks sebagai sumber daya terbatas dengan imbal hasil marginal yang menurun: token tambahan di luar kebutuhan sebuah langkah tidak hanya menambah biaya, tetapi dapat mengencerkan perhatian model pada hal yang benar-benar penting.
- Hasil panggilan tool, bukan riwayat percakapan, biasanya bagian konteks agent yang tumbuh paling cepat, karena banyak API mengembalikan jauh lebih banyak daripada yang dibutuhkan satu langkah.
- Kompaksi harus mengoptimalkan recall terlebih dahulu (tangkap semua yang mungkin penting) dan presisi kemudian (perketat ringkasan), bukan sebaliknya.
- Sub-agent yang menangani langkah sempit dan padat eksplorasi biasanya mengembalikan hasil padat sekitar 1.000 hingga 2.000 token ke agent utama, alih-alih membawa seluruh konteks kerjanya ke depan.
- Iterasi loop yang meningkat dan biaya per tugas selesai yang meningkat adalah tanda peringatan dini pembengkakan konteks, sering terlihat sebelum akurasi turun.
Langkah Selanjutnya
Manajemen konteks adalah disiplin harian yang menjaga agent tetap cepat, akurat, dan terjangkau seiring tugas makin panjang. AI Agent Memory membahas sisi penyimpanan lebih dalam, RAG untuk AI agent membahas retrieval sebagai teknik grounding secara khusus, dan observabilitas AI agent membahas cara menangkap pembengkakan konteks setelah peluncuran, sebelum muncul sebagai lonjakan biaya atau penurunan akurasi yang diam-diam.

On this page
- Mengapa Ini Masalah Agent, Bukan Masalah Chat
- Apa yang Sebenarnya Memenuhi Konteks Agent
- Penganggaran: Tentukan Apa yang Layak Mendapat Tempat Sebelum Penuh
- Kompaksi: Ringkas Sebelum Meluap, Bukan Sesudahnya
- Retrieval Just-in-Time Mengalahkan Memuat Semuanya di Awal
- Mendelegasikan ke Sub-Agent: Window Bersih untuk Pekerjaan Terfokus
- Memantau Kesehatan Konteks Setelah Rilis
- Key Facts
- Langkah Selanjutnya