Gerenciamento de Contexto de AI Agents: Orçamento, Compactação e Recuperação
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
O gerenciamento de contexto de AI agents é a prática de decidir o que entra na janela de contexto de um modelo a cada passo de uma execução: quais instruções, quais resultados de ferramentas, quais documentos recuperados e quais turnos anteriores realmente merecem um lugar, e o que é resumido, descartado ou buscado só mais tarde. Isso importa porque um agent não tem uma única chance com um prompt: ele opera em loop, e cada passagem por esse loop disputa o mesmo espaço limitado e cada vez mais cheio. Trate o contexto como um rascunho gratuito e o agent fica mais lento, mais caro e menos preciso quanto mais a tarefa se estende. Trate-o como um orçamento e ele se mantém afiado.
Por que Este É um Problema de Agent, Não de Chat
Uma única pergunta a um chatbot ocupa uma fatia pequena e previsível de uma janela de contexto: um system prompt, a pergunta, uma resposta. Um agent é diferente. Como os AI agents funcionam descreve o loop que ele executa, perceber, raciocinar, agir, observar e repetir, e cada uma dessas passagens pode acrescentar mais ao que o modelo precisa manter em mente. Uma tarefa de dez passos já leu dez lotes de saída de ferramentas, tomou dez decisões e possivelmente recuperou vários documentos quando termina. Nada disso desaparece automaticamente. Fica na janela de contexto, a menos que algo o gerencie de forma deliberada.
A equipe de engenharia da Anthropic enquadra bem o problema de fundo em seu guia sobre context engineering para AI agents: o contexto é um recurso finito com retornos marginais decrescentes. Cada token adicional além do que um passo realmente precisa não custa apenas dinheiro, pode prejudicar ativamente o desempenho, porque a atenção de um transformer precisa se distribuir por tudo que está na janela, e se distribui de forma mais rarefeita à medida que ela enche. Esse é um modo de falha diferente de ficar sem espaço. É uma degradação silenciosa enquanto ainda sobra espaço, uma dinâmica que a pesquisa da Chroma sobre desempenho em contexto longo documentou diretamente, testando 18 modelos de ponta e constatando que a precisão pode começar a cair bem antes de a janela estar tecnicamente cheia. A memória de AI agents aborda essa pesquisa com mais profundidade do lado do armazenamento; esta página continua de onde ela para, no que fazer de fato a respeito.
O que Realmente Enche o Contexto de um Agent
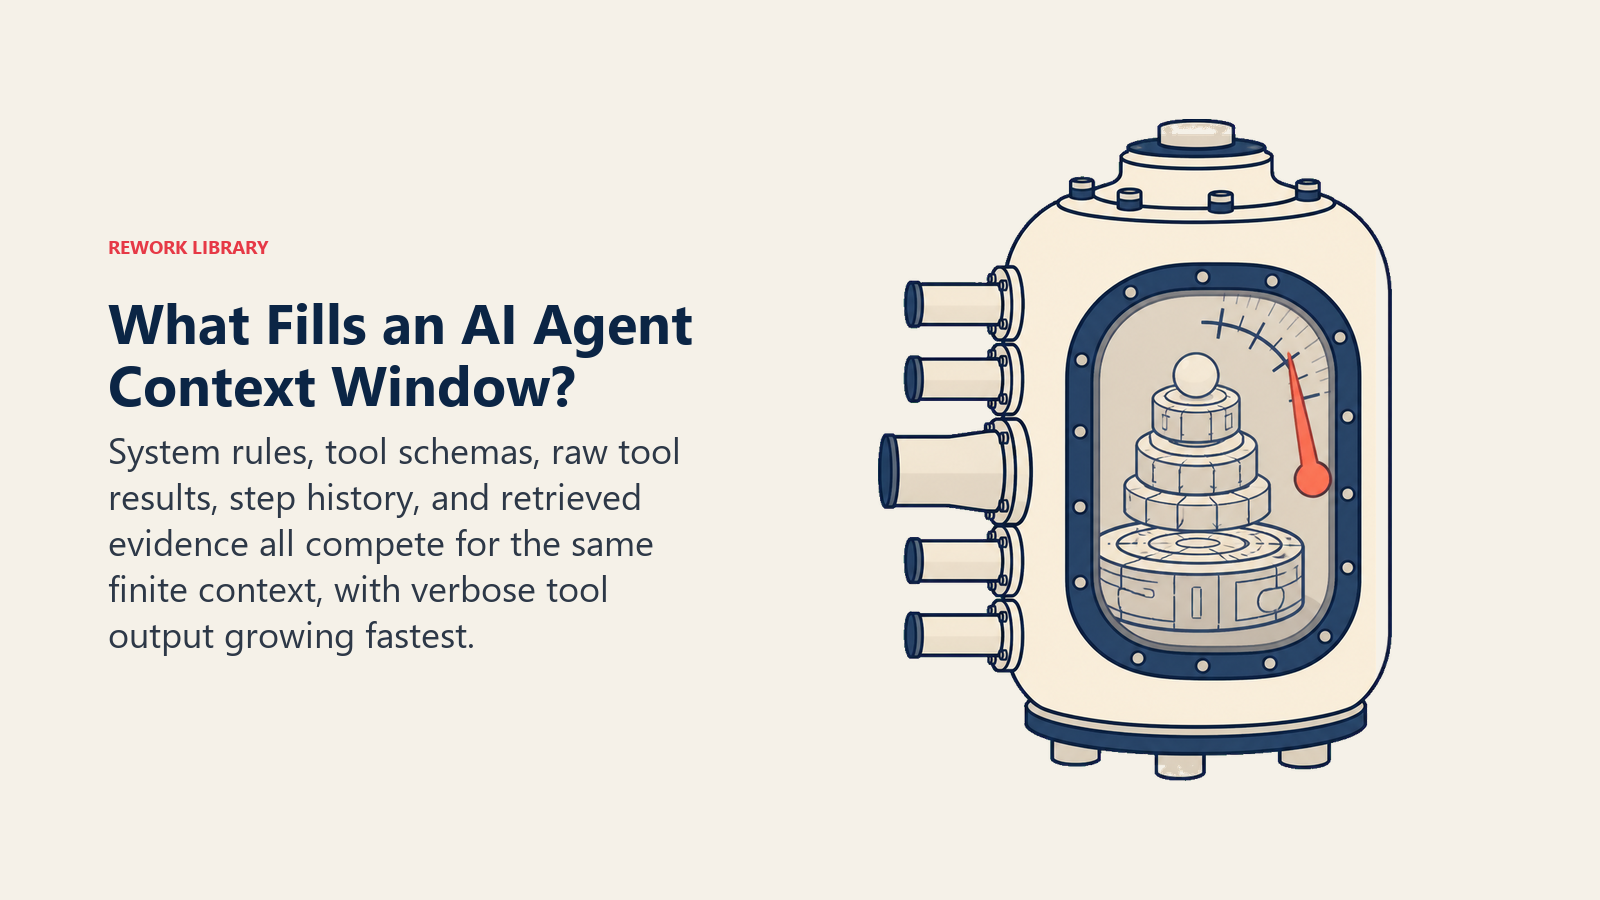
Antes de orçar uma janela de contexto, é preciso saber o que disputa espaço dentro dela. Em uma execução típica de agent, cinco categorias brigam pelos mesmos tokens:
| O que está no contexto | Para que serve | Por que cresce |
|---|---|---|
| System prompt e regras | O papel, o tom e o comportamento permanente do agent | Raramente cresce depois de escrito, mas costuma ser inflado com casos de borda ao longo do tempo |
| Schemas de ferramentas | Definições de cada ferramenta que o agent pode chamar | Cresce a cada ferramenta adicionada ao kit do agent |
| Resultados de chamadas de ferramentas | Saída bruta de cada chamada de API, busca ou consulta até o momento | Cresce mais rápido, principalmente com respostas de API verbosas |
| Histórico da conversa e dos passos | O que foi perguntado, decidido e feito até agora nesta execução | Cresce a cada passo de uma tarefa com várias etapas |
| Documentos recuperados ou memória | Conhecimento trazido para responder ou decidir | Cresce se a recuperação não for bem delimitada |
Na prática, os resultados de chamadas de ferramentas costumam ser o maior vilão. Como os AI agents usam ferramentas mostra como uma chamada de ferramenta devolve um resultado bruto que o modelo lê antes de decidir o próximo passo, e muitas APIs retornam bem mais do que um agent precisa: um registro completo do cliente quando ele precisava de um campo, uma resposta de busca inteira quando precisava dos três principais resultados. O AI Research Agent mostra o que acontece quando isso não é gerenciado: um briefing que puxa dez fontes completas para o contexto em vez de três trechos focados não só demora mais para ser gerado, como dilui a atenção do modelo em um material que, em sua maior parte, nem chegará à síntese final.
Orçamento: Decida o que Merece um Lugar Antes de Encher
Um orçamento de contexto é uma ideia simples aplicada de forma deliberada, e não por acidente: decidir, antes de uma execução começar, mais ou menos quanto da janela cada categoria acima pode consumir e fazer isso valer ao longo da execução. O enquadramento da Anthropic para isso é buscar o menor conjunto possível de tokens de alto sinal que leve o modelo ao resultado certo, e não o maior conjunto que talvez seja relevante.
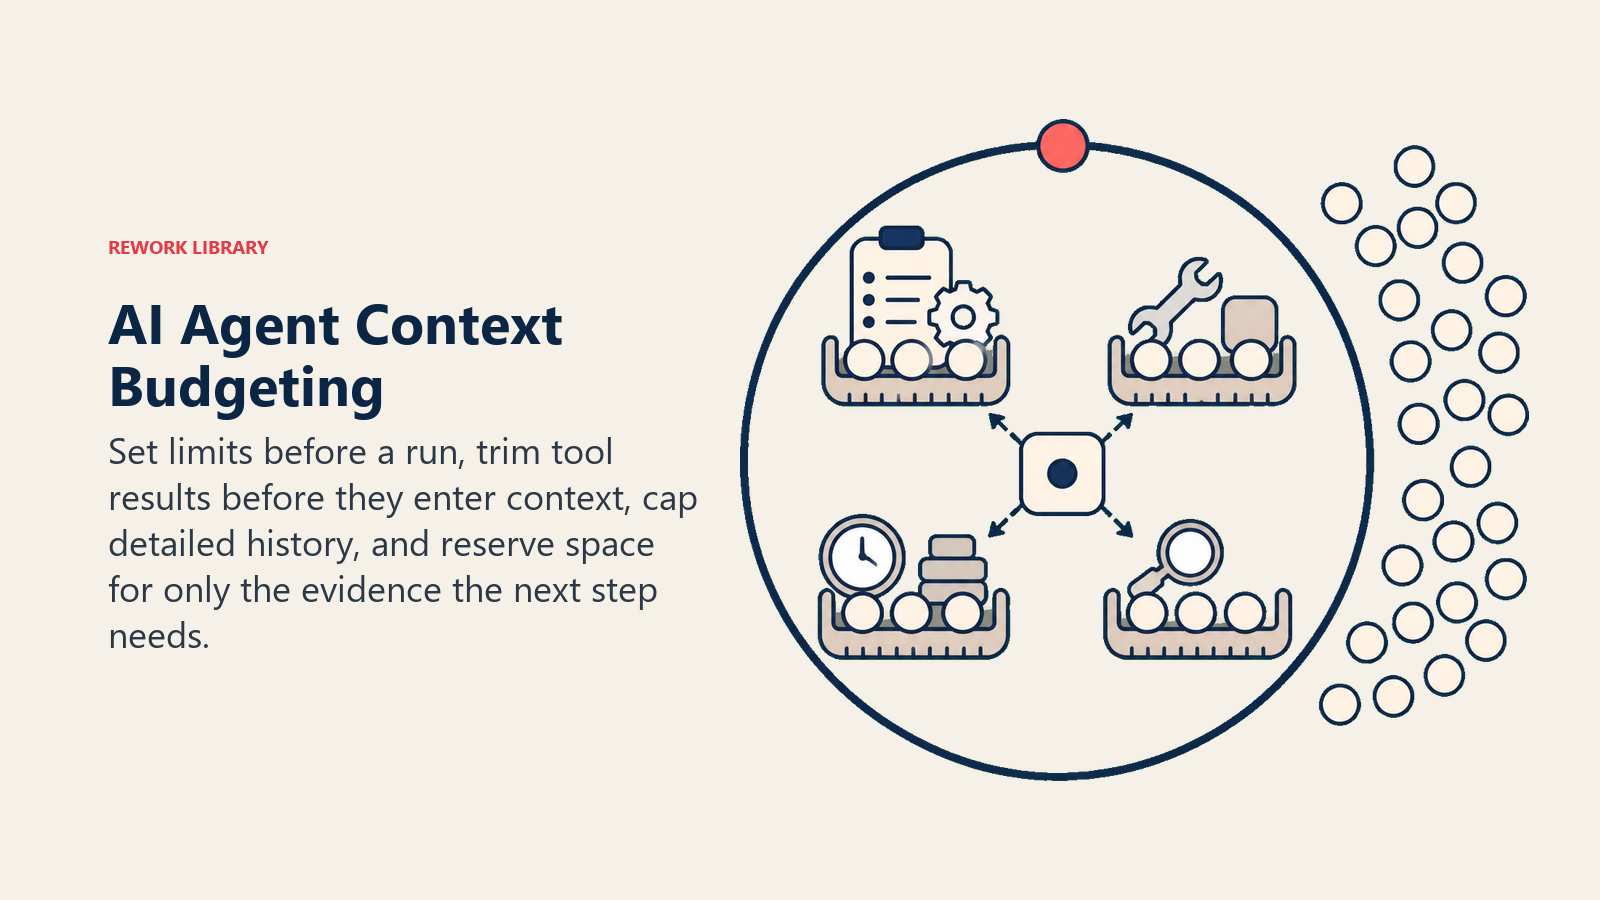
Na prática, isso significa alguns hábitos concretos:
- Reduza os resultados das ferramentas antes que entrem no contexto, e não depois. Extraia os dois ou três campos de que um passo realmente precisa de uma resposta de API, em vez de passar adiante todo o payload.
- Mantenha o system prompt enxuto. Um system prompt inflado com todo caso de borda que alguém já encontrou é um imposto permanente sobre cada execução, quer esse caso apareça ou não.
- Limite o histórico, não o deixe crescer sem fim. Decida quantos passos anteriores de uma tarefa longa permanecem em detalhe completo e quantos são compactados (mais sobre isso abaixo).
- Delimite a recuperação com precisão. Traga o punhado de trechos de que uma pergunta realmente precisa em vez de um documento inteiro, uma lição que o RAG para AI agents aborda do ponto de vista do grounding; é também uma decisão de orçamento de contexto, e não apenas de precisão.
Compactação: Resuma Antes de Estourar, Não Depois
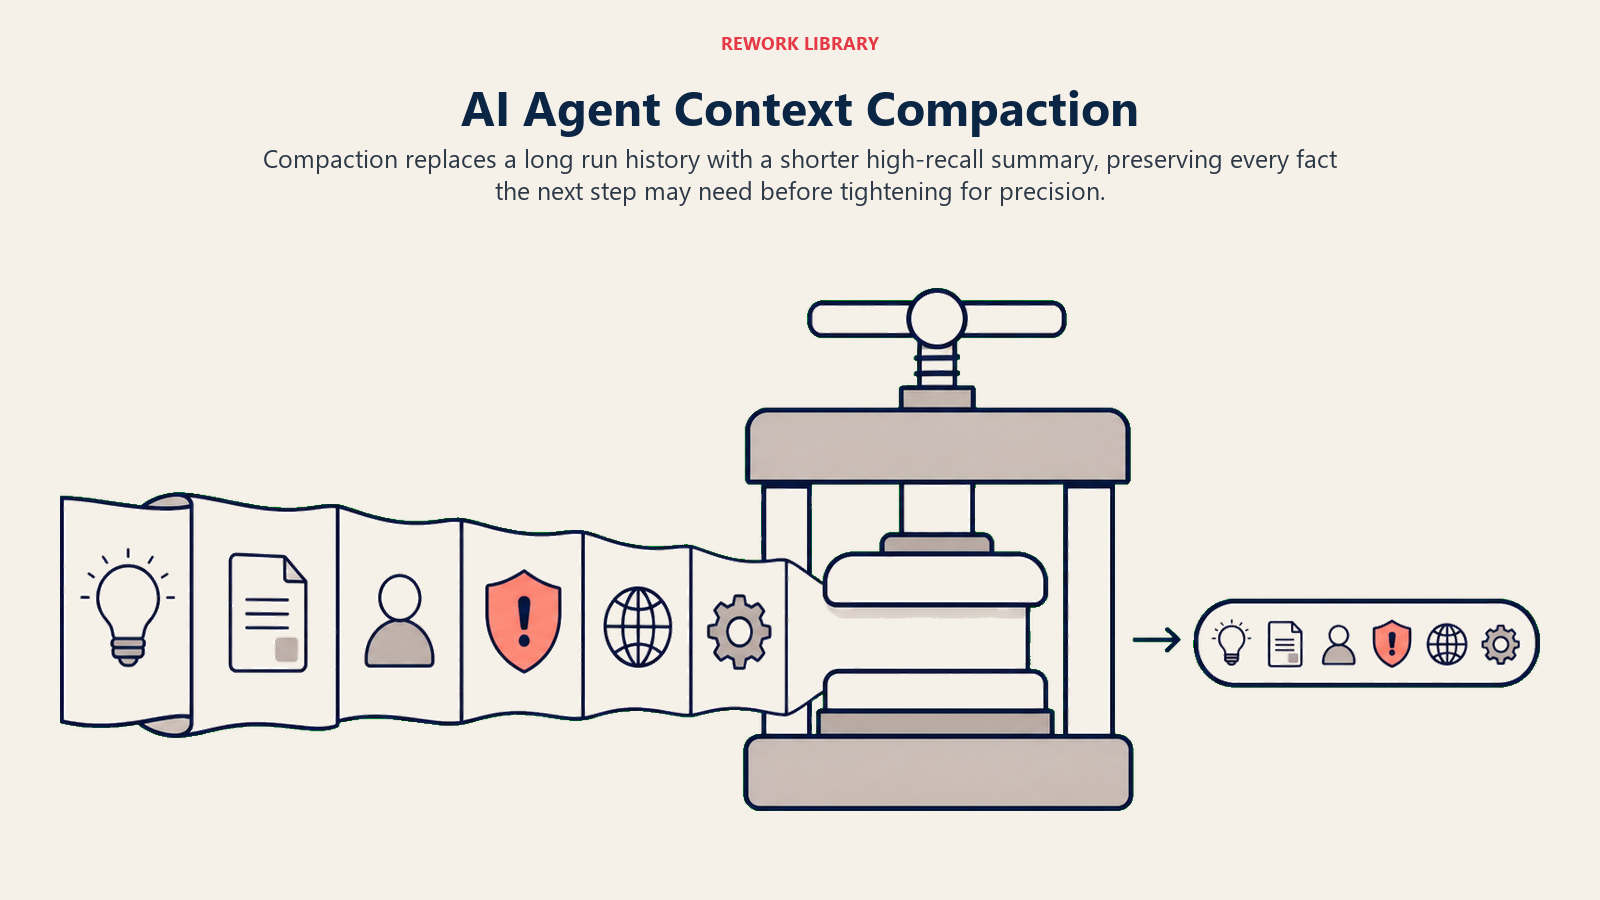
Compactação é o que você faz quando uma execução já acumulou mais histórico do que precisa manter por inteiro: resumir tudo o que aconteceu até agora em uma forma comprimida e continuar a tarefa a partir desse resumo, em vez de toda a transcrição. A orientação da Anthropic é específica sobre como fazer isso bem: busque primeiro um recall alto, garantindo que a etapa de compactação capture cada informação de que o próximo passo possa realmente precisar, e só depois refine para precisão, quando tiver confirmado que nada importante se perde. Inverter essa ordem, otimizando para um resumo curto antes de confirmar que ele é completo, é como um agent compactado começa a esquecer, em silêncio, coisas que importavam.
Uma ideia relacionada e mais antiga, que vale conhecer, é o MemGPT, uma proposta que toma emprestada dos sistemas operacionais a memória em camadas: manter uma pequena quantidade de informação "quente" no contexto imediato do modelo e transferir todo o resto para um armazenamento maior e mais lento, trazendo-o de volta apenas quando um passo realmente precisar. A compactação e a recuperação just-in-time, tratada a seguir, são ambas versões práticas dessa mesma ideia de paginação.
A Recuperação Just-in-Time Vence o Carregamento Antecipado de Tudo
O instinto, quando um agent pode precisar de uma informação, é carregá-la no contexto logo de início, por precaução. O padrão melhor, e aquele em que a orientação da Anthropic mais se apoia, é a recuperação just-in-time: dar ao agent uma referência leve, um caminho de arquivo, um ID de registro, uma ferramenta de busca, e deixar que ele traga o conteúdo real apenas no passo em que for necessário. Isso espelha como uma pessoa trabalha em uma tarefa. Ninguém memoriza um manual de políticas inteiro antes de responder a uma pergunta sobre licença parental; a pessoa consulta a seção relevante quando a pergunta chega.
Essa é exatamente a mecânica que o RAG para AI agents descreve: a recuperação, dentro de um agent, é na verdade uma chamada de ferramenta como qualquer outra, situada na etapa de percepção do loop, disparada quando um passo específico precisa de uma informação específica, e não carregada por atacado no início. O ganho para o gerenciamento de contexto é distinto do ganho de grounding. Mesmo que um modelo pudesse tecnicamente caber uma base de conhecimento inteira em sua janela, fazer isso continuaria sendo o movimento errado, porque cada token ali além do que o passo atual precisa dilui a atenção do modelo nos tokens que realmente importam agora.
Delegar a Sub-Agents: Uma Janela Limpa para um Trabalho Focado
Quando um único passo dentro de uma tarefa maior precisa fazer muita leitura, pesquisa ou exploração para cumprir algo estreito, uma das jogadas mais eficazes de gerenciamento de contexto é entregar esse passo a um sub-agent separado em vez de executá-lo no mesmo fluxo. O sub-agent recebe a própria janela de contexto limpa, faz o trabalho pesado ali e devolve ao agent principal um resultado condensado, em geral na faixa de 1.000 a 2.000 tokens, segundo os próprios exemplos da Anthropic, em vez de arrastar de volta todo o seu processo de trabalho.
Os sistemas multi-agent abordam em profundidade o lado de orquestração desse padrão: quando dividir um trabalho entre agents compensa a complexidade e quando é excesso de engenharia para um trabalho que um único agent ainda daria conta. Do ponto de vista puro do gerenciamento de contexto, o argumento a favor de um sub-agent é mais restrito e mais mecânico: um passo que, de outra forma, inundaria a janela do agent principal com detalhes exploratórios que ele não precisa levar adiante é um bom candidato para ser isolado, resumido e devolvido.
Acompanhando a Saúde do Contexto Depois do Lançamento
Uma estratégia de contexto que funciona em testes ainda pode se desviar quando o tráfego real chega: as saídas das ferramentas ficam verbosas após uma atualização de API, uma base de conhecimento cresce, um caso de borda é fixado no system prompt e nunca é removido. A observabilidade de AI agents já indica as métricas que vale acompanhar aqui: o aumento de iterações do loop por execução e o aumento do custo por tarefa concluída são ambos sinais precoces de que o contexto está inchando em silêncio, muitas vezes antes de a precisão cair de forma visível. A otimização de custos de AI agents trata do lado do cache da mesma moeda, tornando muito mais barato reenviar contexto reutilizado, o que importa junto com a compactação, e não no lugar dela, já que mesmo um contexto bem armazenado em cache ainda precisa ser processado pela atenção a cada chamada.
Se você está avaliando plataformas que lidam bem com grandes bases de código ou sessões de longa duração, nossas comparações de ferramentas para desenvolvedores e o guia de compra de AI coding assistants tratam o manejo da janela de contexto como um diferencial real, e não uma nota de rodapé, já que é um dos lugares mais claros em que a qualidade de um assistente de código aparece em um projeto grande.
Key Facts
- A Anthropic enquadra o contexto como um recurso finito com retornos marginais decrescentes: tokens extras além do que um passo precisa não só custam mais, como podem diluir a atenção do modelo no que realmente importa.
- Os resultados de chamadas de ferramentas, e não o histórico da conversa, costumam ser a parte do contexto de um agent que mais cresce, já que muitas APIs retornam bem mais do que um único passo precisa.
- A compactação deve otimizar primeiro para recall (capturar tudo o que pode importar) e depois para precisão (refinar o resumo), e não o contrário.
- Sub-agents que cuidam de um passo estreito e de muita exploração costumam devolver ao agent principal um resultado condensado de cerca de 1.000 a 2.000 tokens, em vez de levar adiante todo o seu contexto de trabalho.
- O aumento de iterações do loop e do custo por tarefa concluída são sinais de alerta precoces de inchaço de contexto, muitas vezes visíveis antes de a precisão cair.
Para Onde Ir Agora
O gerenciamento de contexto é a disciplina diária que mantém um agent rápido, preciso e acessível à medida que as tarefas se alongam. A memória de AI agents aborda o lado do armazenamento com mais profundidade, o RAG para AI agents trata a recuperação especificamente como técnica de grounding, e a observabilidade de AI agents mostra como detectar o inchaço de contexto depois do lançamento, antes que ele apareça como um pico de custo ou uma queda silenciosa de precisão.

On this page
- Por que Este É um Problema de Agent, Não de Chat
- O que Realmente Enche o Contexto de um Agent
- Orçamento: Decida o que Merece um Lugar Antes de Encher
- Compactação: Resuma Antes de Estourar, Não Depois
- A Recuperação Just-in-Time Vence o Carregamento Antecipado de Tudo
- Delegar a Sub-Agents: Uma Janela Limpa para um Trabalho Focado
- Acompanhando a Saúde do Contexto Depois do Lançamento
- Key Facts
- Para Onde Ir Agora