Pengurusan Konteks AI Agent: Belanjawan, Pemadatan, dan Perolehan Semula
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Pengurusan konteks AI agent ialah amalan memutuskan apa yang masuk ke dalam tetingkap konteks model pada setiap langkah satu larian: arahan mana, hasil alat mana, dokumen yang diambil semula mana, dan giliran terdahulu mana yang benar-benar layak mendapat tempat, serta apa yang diringkaskan, dibuang, atau diambil kemudian. Ia penting kerana agent tidak mendapat satu peluang sahaja pada prompt, ia berulang, dan setiap pusingan melalui gelung itu bersaing untuk ruang terhad yang sama dan semakin sesak. Jika konteks dianggap ruang conteng percuma, agent menjadi lebih perlahan, lebih mahal, dan kurang tepat semakin lama tugas berjalan. Jika dianggap belanjawan, ia kekal tajam.
Mengapa Ini Masalah Agent, Bukan Masalah Sembang
Satu soalan kepada chatbot mengisi bahagian kecil dan boleh diramal pada tetingkap konteks: system prompt, soalan, jawapan. Agent berbeza. Cara AI agent berfungsi menghuraikan gelung yang dijalankannya, mengamati, menaakul, bertindak, memerhati, ulang, dan setiap pusingan itu boleh menambah lebih banyak kepada apa yang perlu dipegang oleh model. Tugas sepuluh langkah telah membaca sepuluh kelompok output alat, membuat sepuluh keputusan, dan mungkin mengambil semula beberapa dokumen menjelang ia selesai. Tiada satu pun yang hilang secara automatik. Semuanya kekal dalam tetingkap konteks melainkan ada sesuatu yang menguruskannya dengan sengaja.
Pasukan kejuruteraan Anthropic membingkaikan masalah asas itu dengan baik dalam panduannya tentang kejuruteraan konteks untuk AI agent: konteks ialah sumber terhad dengan pulangan marginal yang semakin berkurang. Setiap token tambahan melebihi apa yang diperlukan sesuatu langkah bukan sahaja menambah kos, malah boleh menjejaskan prestasi secara aktif, kerana perhatian transformer perlu merebak merentasi segala-galanya dalam tetingkap, dan ia merebak semakin nipis apabila tetingkap itu penuh. Itu mod kegagalan yang berbeza daripada kehabisan ruang. Ia merosot secara senyap sementara ruang masih ada, satu dinamik yang didokumenkan secara langsung oleh penyelidikan Chroma tentang prestasi konteks panjang, yang menguji 18 model terkemuka dan mendapati ketepatan boleh mula menurun jauh sebelum tetingkap penuh secara teknikal. AI Agent Memory membincangkan penyelidikan itu dengan lebih mendalam dari sisi storan; halaman ini menyambung daripada tempat ia berhenti, tentang apa yang sebenarnya perlu dilakukan.
Apa yang Sebenarnya Memenuhi Konteks Agent
Sebelum anda boleh membelanjawankan tetingkap konteks, anda perlu tahu apa yang bersaing untuk ruang di dalamnya. Pada larian agent biasa, lima kategori berebut token yang sama:
| Apa yang ada dalam konteks | Fungsinya | Mengapa ia membesar |
|---|---|---|
| System prompt dan peraturan | Peranan, nada, dan tingkah laku sentiasa aktif agent | Jarang membesar selepas ditulis, tetapi sering ditambah kes pinggir dari semasa ke semasa |
| Skema alat | Takrifan setiap alat yang boleh dipanggil agent | Membesar dengan setiap alat yang ditambah ke dalam kit agent |
| Hasil panggilan alat | Output mentah daripada setiap panggilan API, carian, atau semakan setakat ini | Membesar paling pantas, terutamanya dengan respons API yang memeleret |
| Sejarah perbualan dan langkah | Apa yang telah ditanya, diputuskan, dan dilakukan setakat ini dalam larian ini | Membesar dengan setiap langkah dalam tugas berbilang langkah |
| Dokumen atau memori yang diambil semula | Pengetahuan yang ditarik masuk untuk menjawab atau membuat keputusan | Membesar jika perolehan semula tidak diskopkan dengan ketat |
Hasil panggilan alat biasanya pesalah terbesar dalam praktik. Cara AI agent menggunakan alat menerangkan bagaimana panggilan alat memulangkan hasil mentah yang dibaca model sebelum memutuskan langkah seterusnya, dan banyak API memulangkan jauh lebih daripada yang diperlukan agent: rekod pelanggan penuh apabila ia hanya perlukan satu medan, respons carian penuh apabila ia hanya perlukan tiga hasil teratas. AI Research Agent menunjukkan apa yang berlaku apabila ini tidak diurus: ringkasan yang menarik sepuluh sumber penuh ke dalam konteks dan bukan tiga petikan yang tertumpu bukan sahaja lebih perlahan dijana, ia mencairkan perhatian model merentasi bahan yang kebanyakannya tidak akan sampai ke sintesis akhir pun.
Belanjawan: Putuskan Apa yang Layak Mendapat Tempat Sebelum Ia Penuh
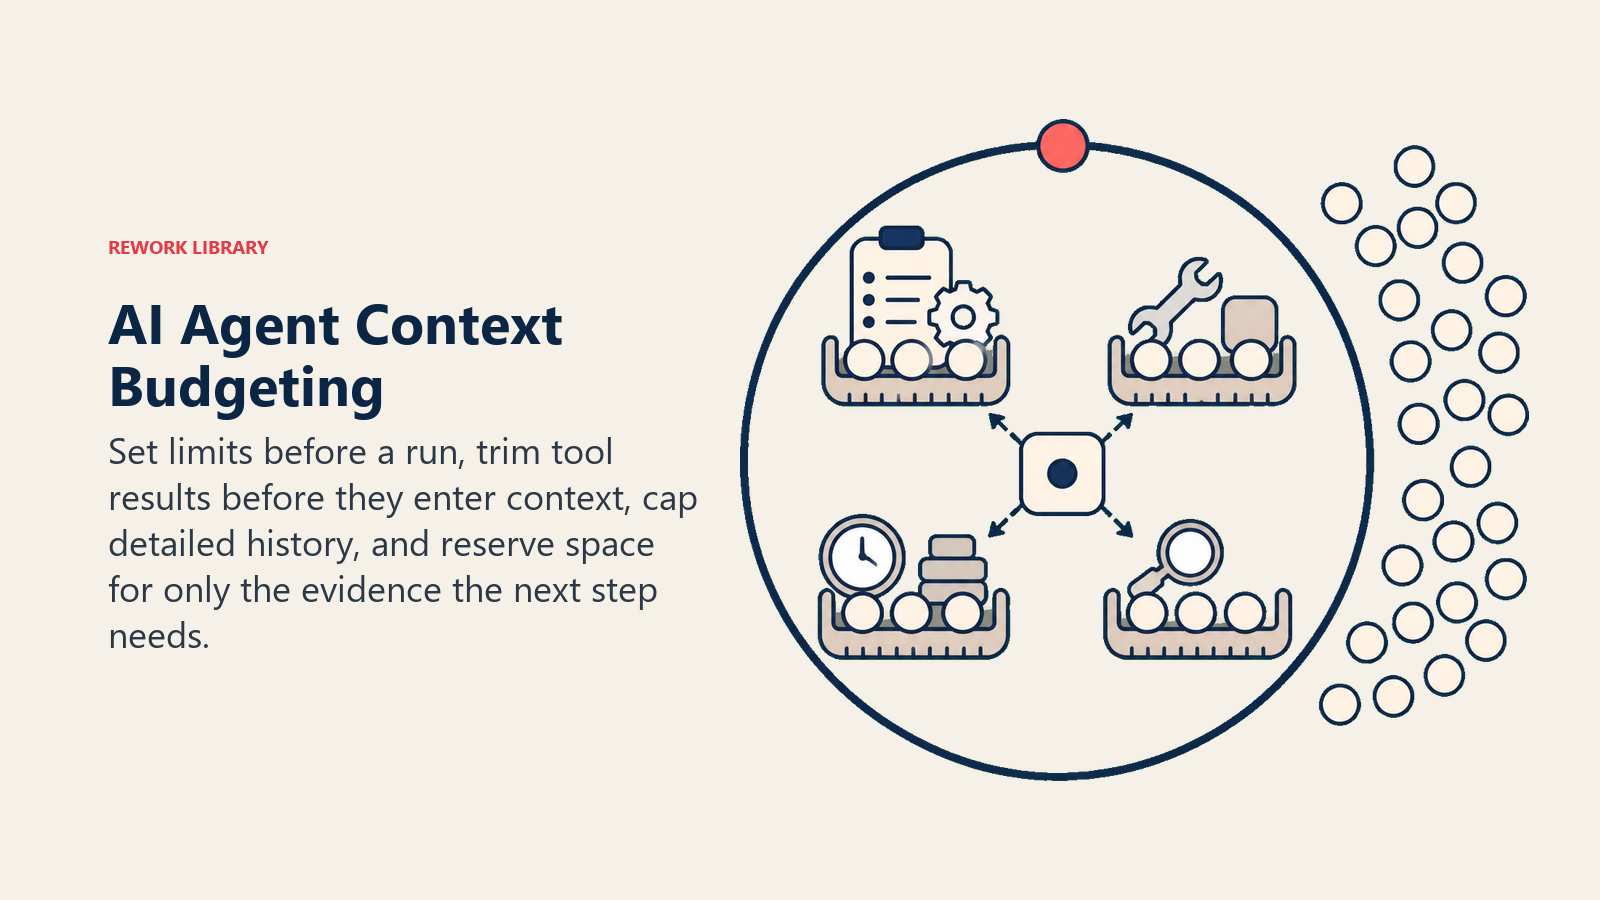
Belanjawan konteks ialah idea mudah yang dilaksanakan dengan sengaja dan bukan secara tidak sengaja: putuskan, sebelum larian bermula, kira-kira berapa banyak tetingkap yang dibenarkan digunakan oleh setiap kategori di atas, dan kuatkuasakannya semasa larian berjalan. Pendekatan Anthropic untuk ini ialah mencari set token isyarat tinggi yang paling kecil yang membawa model kepada hasil yang betul, bukan set terbesar yang mungkin relevan.
Dalam praktik, itu bermakna beberapa tabiat konkrit:
- Pangkas hasil alat sebelum ia masuk ke dalam konteks, bukan selepasnya. Ekstrak dua atau tiga medan yang benar-benar diperlukan sesuatu langkah daripada respons API dan bukan menghantar seluruh muatan ke hadapan.
- Pastikan system prompt ringkas. System prompt yang dipenuhi setiap kes pinggir yang pernah ditemui sesiapa ialah cukai tetap pada setiap larian, sama ada kes pinggir itu muncul atau tidak.
- Hadkan sejarah, jangan biarkan ia terbuka tanpa had. Putuskan berapa banyak langkah terdahulu bagi tugas jangka panjang kekal dalam perincian penuh berbanding dipadatkan (lebih lanjut di bawah).
- Skopkan perolehan semula secara sempit. Ambil beberapa serpihan yang benar-benar diperlukan soalan dan bukan keseluruhan dokumen, satu pengajaran yang dibincangkan oleh RAG untuk AI agent dari sisi pengasasan; ia juga keputusan belanjawan konteks, bukan sekadar soal ketepatan.
Pemadatan: Ringkaskan Sebelum Melimpah, Bukan Selepas
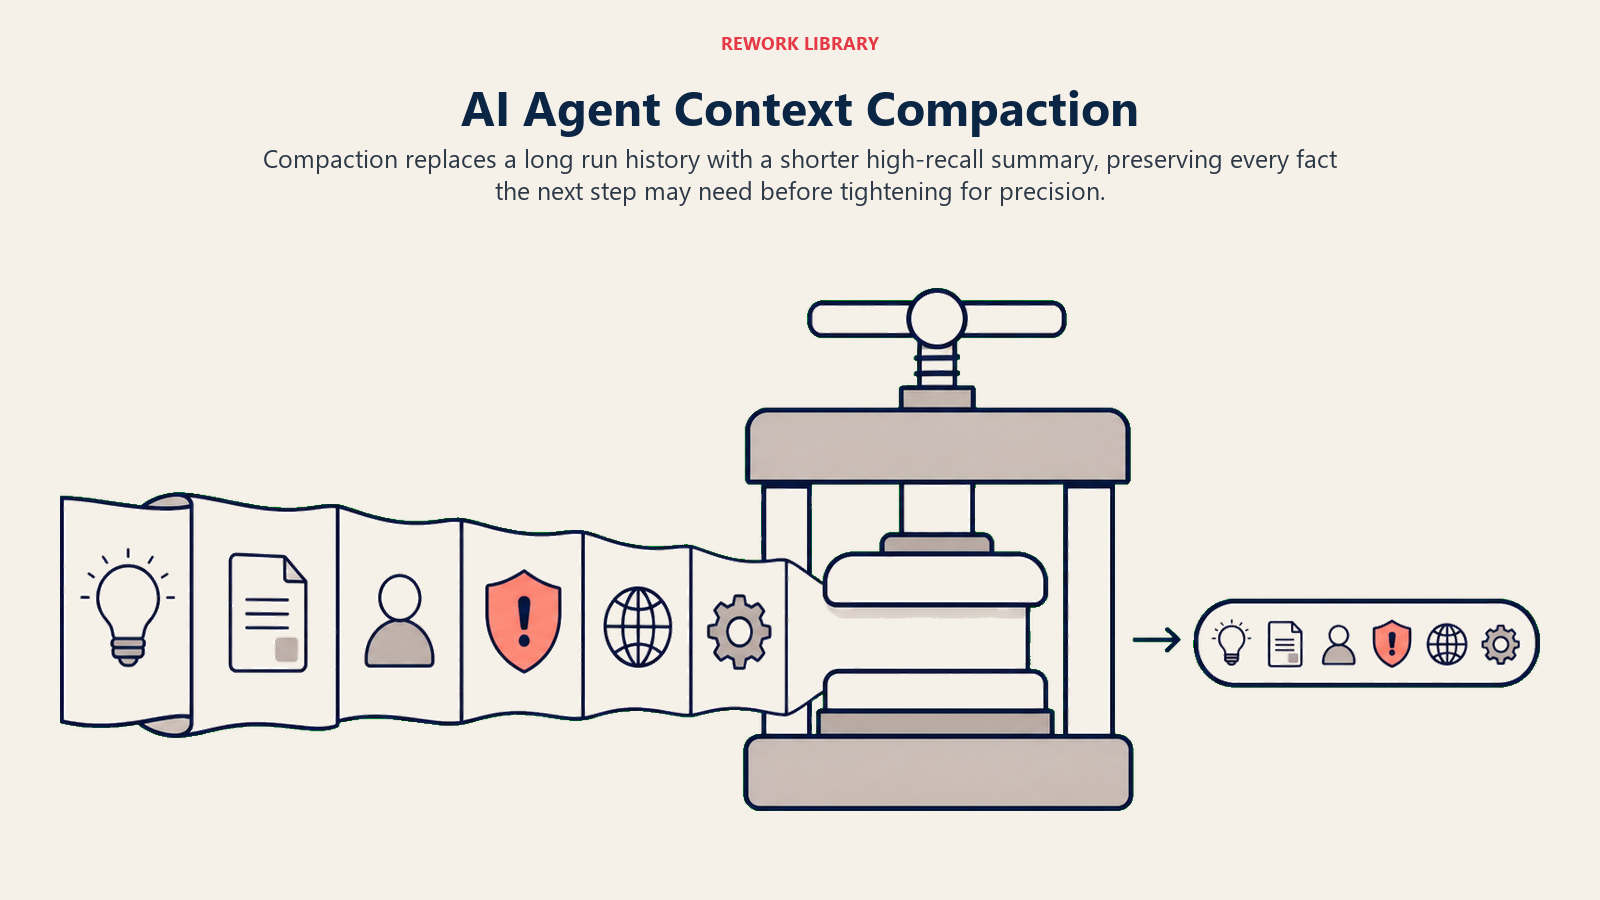
Pemadatan ialah apa yang anda lakukan apabila larian telah mengumpul lebih banyak sejarah daripada yang perlu dikekalkan sepenuhnya: ringkaskan apa yang telah berlaku setakat ini ke dalam bentuk termampat, kemudian teruskan tugas daripada ringkasan itu dan bukan keseluruhan transkrip. Panduan Anthropic khusus tentang cara melakukannya dengan baik: sasarkan ingatan semula (recall) tinggi dahulu, pastikan langkah pemadatan menangkap setiap maklumat yang mungkin diperlukan langkah seterusnya, kemudian ketatkan untuk ketepatan setelah anda mengesahkan tiada perkara penting yang tercicir. Jika urutan ini terbalik, mengoptimumkan ringkasan pendek sebelum mengesahkan ia lengkap, itulah cara agent yang dipadatkan mula melupakan perkara penting secara senyap.
Satu idea berkaitan yang lebih lama dan wajar diketahui ialah MemGPT, cadangan yang meminjam memori berperingkat daripada sistem pengendalian: simpan sedikit maklumat "panas" dalam konteks segera model, dan alihkan segala yang lain ke storan yang lebih perlahan dan lebih besar, menariknya semula hanya apabila sesuatu langkah benar-benar memerlukannya. Pemadatan dan perolehan semula tepat pada masanya, yang dibincangkan seterusnya, kedua-duanya versi praktikal bagi idea pemindahan halaman yang sama.
Perolehan Semula Tepat pada Masanya Mengatasi Memuatkan Segalanya di Awal
Naluri apabila agent mungkin memerlukan sesuatu maklumat ialah memuatkannya ke dalam konteks di awal, sekadar berjaga-jaga. Corak yang lebih baik, dan yang banyak disandarkan oleh panduan Anthropic, ialah perolehan semula tepat pada masanya: beri agent rujukan ringan, laluan fail, ID rekod, alat carian, dan biarkan ia menarik kandungan sebenar hanya pada langkah yang memerlukannya. Itu mencerminkan cara seseorang menyelesaikan tugas. Tiada sesiapa menghafal seluruh manual dasar sebelum menjawab satu soalan tentang cuti ibu bapa; mereka merujuk bahagian yang relevan apabila soalan itu tiba.
Inilah mekanik tepat yang diterangkan oleh RAG untuk AI agent: perolehan semula, di dalam agent, sebenarnya panggilan alat seperti yang lain, terletak dalam langkah mengamati bagi gelung, dicetuskan apabila langkah tertentu memerlukan maklumat tertentu dan bukan dimuatkan secara pukal di awal. Manfaat pengurusan konteks berasingan daripada manfaat pengasasan. Walaupun model secara teknikalnya boleh memuatkan seluruh pangkalan pengetahuan ke dalam tetingkapnya, berbuat demikian tetap langkah yang salah, kerana setiap token di dalamnya melebihi apa yang diperlukan langkah semasa mencairkan perhatian model pada token yang benar-benar penting sekarang.
Memunggah kepada Sub-Agent: Tetingkap Bersih untuk Tugas yang Tertumpu
Apabila satu langkah dalam tugas yang lebih besar perlu banyak membaca, menyelidik, atau meneroka untuk mencapai sesuatu yang sempit, salah satu langkah pengurusan konteks yang lebih berkesan ialah menyerahkan langkah itu kepada sub-agent yang berasingan dan bukan melakukannya sebaris. Sub-agent mendapat tetingkap konteks bersihnya sendiri, melakukan kerja berat di situ, dan memulangkan hasil yang dipadatkan, selalunya dalam lingkungan 1,000 hingga 2,000 token mengikut contoh Anthropic sendiri, kepada agent utama dan bukan menyeret seluruh proses kerjanya bersama.
Sistem berbilang agent membincangkan sisi orkestrasi corak ini dengan mendalam: bila memecahkan tugas merentasi beberapa agent berbaloi dengan kerumitannya berbanding bila ia terlalu kejuruteraan untuk tugas yang masih boleh dikendalikan satu agent. Dari sudut pengurusan konteks semata-mata, kes untuk sub-agent lebih sempit dan lebih mekanikal: langkah yang sebaliknya akan membanjiri tetingkap agent utama dengan butiran penerokaan yang tidak perlu dibawa ke hadapan ialah calon yang baik untuk diasingkan, diringkaskan, dan diserahkan semula.
Memantau Kesihatan Konteks Selepas Pelancaran
Strategi konteks yang berfungsi semasa ujian masih boleh hanyut apabila trafik sebenar tiba: output alat menjadi meleret selepas kemas kini API, pangkalan pengetahuan membesar, satu kes pinggir dikodkan keras ke dalam system prompt dan tidak pernah dibuang. Kebolehperhatian AI agent sudah menamakan metrik yang wajar dijejaki di sini: lelaran gelung per larian yang meningkat dan kos per tugas selesai yang meningkat kedua-duanya tanda awal bahawa konteks mengembung secara senyap, selalunya sebelum ketepatan jelas menurun. Pengoptimuman kos AI agent membincangkan sisi pencache bagi syiling yang sama, menjadikan konteks yang digunakan semula jauh lebih murah untuk dihantar semula, yang penting bersama pemadatan dan bukan sebagai gantinya, kerana konteks yang dicache dengan baik pun tetap perlu diberi perhatian pada setiap panggilan.
Jika anda menilai platform yang mengendalikan pangkalan kod besar atau sesi berjangka panjang dengan baik, perbandingan alat pembangun kami dan panduan pembelian pembantu pengekodan AI kedua-duanya membincangkan pengendalian tetingkap konteks sebagai pembeza sebenar, bukan nota kaki, kerana ia salah satu tempat paling jelas kualiti pembantu pengekodan ditunjukkan pada projek besar.
Fakta Utama
- Anthropic membingkaikan konteks sebagai sumber terhad dengan pulangan marginal yang semakin berkurang: token tambahan melebihi apa yang diperlukan sesuatu langkah bukan sahaja menambah kos, malah boleh mencairkan perhatian model pada apa yang benar-benar penting.
- Hasil panggilan alat, bukan sejarah perbualan, biasanya bahagian konteks agent yang membesar paling pantas, kerana banyak API memulangkan jauh lebih daripada yang diperlukan satu langkah.
- Pemadatan patut mengoptimumkan recall dahulu (tangkap segala yang mungkin penting) dan ketepatan kedua (ketatkan ringkasan), bukan sebaliknya.
- Sub-agent yang mengendalikan langkah sempit yang berat penerokaan lazimnya memulangkan hasil dipadatkan sekitar 1,000 hingga 2,000 token kepada agent utama dan bukan membawa seluruh konteks kerjanya ke hadapan.
- Lelaran gelung dan kos per tugas selesai yang meningkat ialah tanda amaran awal pengembungan konteks, selalunya kelihatan sebelum ketepatan menurun.
Langkah Seterusnya
Pengurusan konteks ialah disiplin harian yang memastikan agent kekal pantas, tepat, dan mampu milik apabila tugas menjadi lebih panjang. AI Agent Memory membincangkan sisi storan dengan lebih mendalam, RAG untuk AI agent membincangkan perolehan semula sebagai teknik pengasasan secara khusus, dan kebolehperhatian AI agent membincangkan cara mengesan pengembungan konteks selepas pelancaran, sebelum ia muncul sebagai lonjakan kos atau penurunan ketepatan yang senyap.

On this page
- Mengapa Ini Masalah Agent, Bukan Masalah Sembang
- Apa yang Sebenarnya Memenuhi Konteks Agent
- Belanjawan: Putuskan Apa yang Layak Mendapat Tempat Sebelum Ia Penuh
- Pemadatan: Ringkaskan Sebelum Melimpah, Bukan Selepas
- Perolehan Semula Tepat pada Masanya Mengatasi Memuatkan Segalanya di Awal
- Memunggah kepada Sub-Agent: Tetingkap Bersih untuk Tugas yang Tertumpu
- Memantau Kesihatan Konteks Selepas Pelancaran
- Fakta Utama
- Langkah Seterusnya