AI Agent Context Management: Budgetierung, Compaction und Retrieval
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
AI Agent Context Management ist die Praxis, bei jedem Schritt eines Laufs zu entscheiden, was in das Kontextfenster eines Modells kommt: welche Anweisungen, welche Tool-Ergebnisse, welche abgerufenen Dokumente und welche früheren Runden sich tatsächlich einen Platz verdienen, und was stattdessen zusammengefasst, verworfen oder erst später abgerufen wird. Das ist wichtig, weil ein Agent nicht nur einen Versuch mit einem Prompt hat, sondern in einer Schleife läuft, und jeder Durchlauf konkurriert um denselben begrenzten, zunehmend überfüllten Raum. Wer Kontext als kostenlosen Notizplatz behandelt, erhält einen Agent, der mit jeder Laufzeit der Aufgabe langsamer, teurer und ungenauer wird. Wer ihn als Budget behandelt, bleibt scharf.
Warum das ein Agent-Problem ist und kein Chat-Problem
Eine einzelne Frage an einen Chatbot füllt einen kleinen, vorhersehbaren Ausschnitt eines Kontextfensters: einen System Prompt, die Frage, eine Antwort. Bei einem Agent ist das anders. Wie AI Agents funktionieren beschreibt die Schleife, die er durchläuft: wahrnehmen, schlussfolgern, handeln, beobachten, wiederholen. Jeder dieser Durchläufe kann dem, was das Modell im Kopf behalten muss, mehr hinzufügen. Eine Aufgabe mit zehn Schritten hat bis zu ihrem Ende zehn Stapel Tool-Ausgaben gelesen, zehn Entscheidungen getroffen und womöglich mehrere Dokumente abgerufen. Nichts davon verschwindet automatisch. Es bleibt im Kontextfenster, solange nichts es gezielt verwaltet.
Das Engineering-Team von Anthropic beschreibt das zugrunde liegende Problem in seinem Leitfaden zu Context Engineering für AI Agents treffend: Kontext ist eine begrenzte Ressource mit abnehmendem Grenznutzen. Jedes zusätzliche Token über das hinaus, was ein Schritt tatsächlich braucht, kostet nicht nur Geld, sondern kann die Leistung aktiv verschlechtern, weil sich die Aufmerksamkeit eines Transformers auf alles im Fenster verteilen muss und dünner wird, je voller das Fenster ist. Das ist ein anderer Fehlermodus, als dass der Platz ausgeht. Die Qualität lässt unbemerkt nach, während noch Platz übrig ist. Diese Dynamik hat die Forschung von Chroma zur Long-Context-Leistung direkt dokumentiert: Getestet wurden 18 führende Modelle, und die Genauigkeit kann demnach schon sinken, lange bevor ein Fenster technisch voll ist. AI Agent Memory behandelt diese Forschung ausführlicher von der Speicherseite; diese Seite setzt dort an, wo sie aufhört, bei der Frage, was Sie tatsächlich dagegen tun können.
Was den Kontext eines Agents tatsächlich füllt
Bevor Sie ein Kontextfenster budgetieren können, müssen Sie wissen, was darin um Platz konkurriert. In einem typischen Agent-Lauf kämpfen fünf Kategorien um dieselben Tokens:
| Was im Kontext liegt | Wofür es dient | Warum es wächst |
|---|---|---|
| System Prompt und Regeln | Rolle, Ton und dauerhaftes Verhalten des Agents | Wächst nach dem Schreiben selten, wird aber mit der Zeit oft mit Sonderfällen aufgebläht |
| Tool-Schemas | Definitionen jedes Tools, das der Agent aufrufen kann | Wächst mit jedem Tool, das dem Agent-Werkzeugkasten hinzugefügt wird |
| Ergebnisse von Tool-Aufrufen | Rohausgabe jedes bisherigen API-Aufrufs, jeder Suche und jedes Lookups | Wächst am schnellsten, besonders bei ausführlichen API-Antworten |
| Konversations- und Schrittverlauf | Was in diesem Lauf bisher gefragt, entschieden und getan wurde | Wächst mit jedem Schritt einer mehrstufigen Aufgabe |
| Abgerufene Dokumente oder Memory | Wissen, das zum Antworten oder Entscheiden hereingeholt wird | Wächst, wenn das Retrieval nicht eng eingegrenzt ist |
Die Ergebnisse von Tool-Aufrufen sind in der Praxis meist der größte Übeltäter. Wie AI Agents Tools nutzen erklärt, wie ein Tool-Aufruf ein Rohergebnis zurückliefert, das das Modell liest, bevor es entscheidet, was als Nächstes kommt, und viele APIs liefern weit mehr zurück, als ein Agent braucht: einen vollständigen Kundendatensatz, obwohl ein Feld genügt hätte, eine vollständige Suchantwort, obwohl die Top drei Ergebnisse reichten. Der AI Research Agent zeigt, was passiert, wenn das ungesteuert bleibt: Ein Briefing, das zehn vollständige Quellen in den Kontext zieht statt drei fokussierter Auszüge, ist nicht nur langsamer zu erzeugen, es verwässert auch die Aufmerksamkeit des Modells über Material, das ohnehin größtenteils nicht in die finale Synthese eingeht.
Budgetierung: Entscheiden, was sich einen Platz verdient, bevor es voll ist
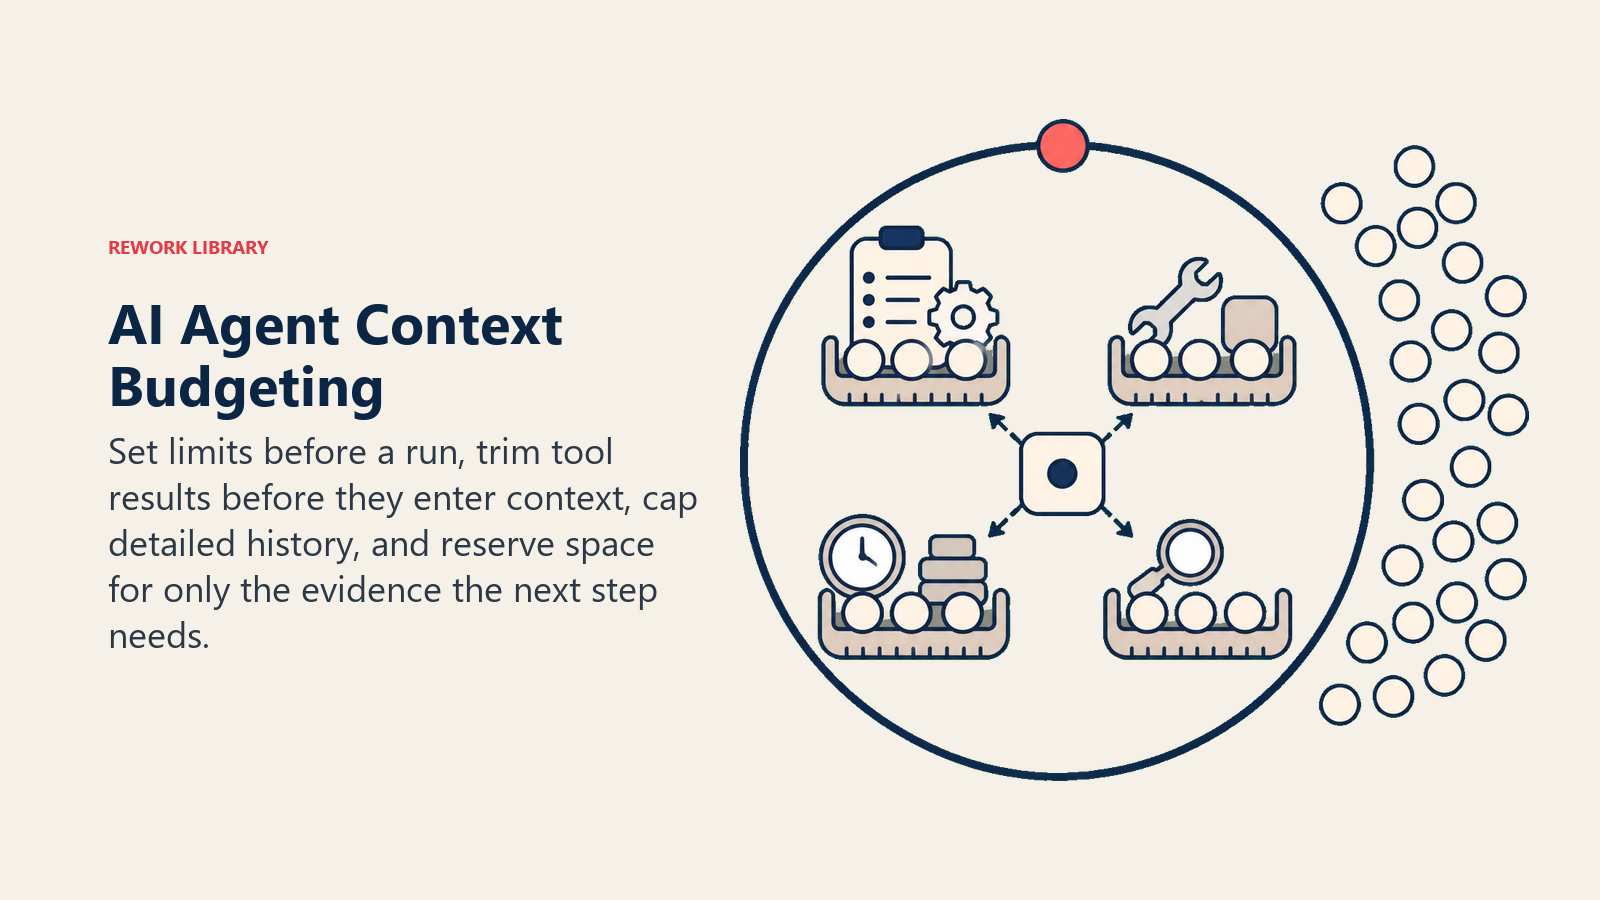
Ein Kontextbudget ist eine einfache Idee, die gezielt statt zufällig angewendet wird: Entscheiden Sie vor Beginn eines Laufs ungefähr, wie viel vom Fenster jede der obigen Kategorien verbrauchen darf, und setzen Sie das im Laufe des Durchlaufs durch. Anthropic empfiehlt dafür, nach der kleinstmöglichen Menge hochwertiger Tokens zu suchen, die das Modell zum richtigen Ergebnis bringt, nicht nach der größten Menge, die relevant sein könnte.
In der Praxis bedeutet das einige konkrete Gewohnheiten:
- Kürzen Sie Tool-Ergebnisse, bevor sie in den Kontext gelangen, nicht danach. Extrahieren Sie aus einer API-Antwort die zwei oder drei Felder, die ein Schritt tatsächlich braucht, statt die gesamte Nutzlast weiterzureichen.
- Halten Sie den System Prompt knapp. Ein System Prompt, der mit jedem Sonderfall aufgebläht ist, auf den jemals jemand gestoßen ist, ist eine dauerhafte Steuer auf jeden einzelnen Lauf, ob dieser Sonderfall auftritt oder nicht.
- Begrenzen Sie den Verlauf, lassen Sie ihn nicht endlos wachsen. Legen Sie fest, wie viele frühere Schritte einer langlaufenden Aufgabe in voller Detailtiefe bleiben und wie viele verdichtet werden (dazu unten mehr).
- Grenzen Sie das Retrieval eng ein. Holen Sie die Handvoll Abschnitte, die eine Frage tatsächlich braucht, statt eines ganzen Dokuments. Diese Lektion behandelt RAG für AI Agents von der Grounding-Seite; es ist aber auch eine Entscheidung zum Kontextbudget und nicht nur eine zur Genauigkeit.
Compaction: Zusammenfassen, bevor es überläuft, nicht danach
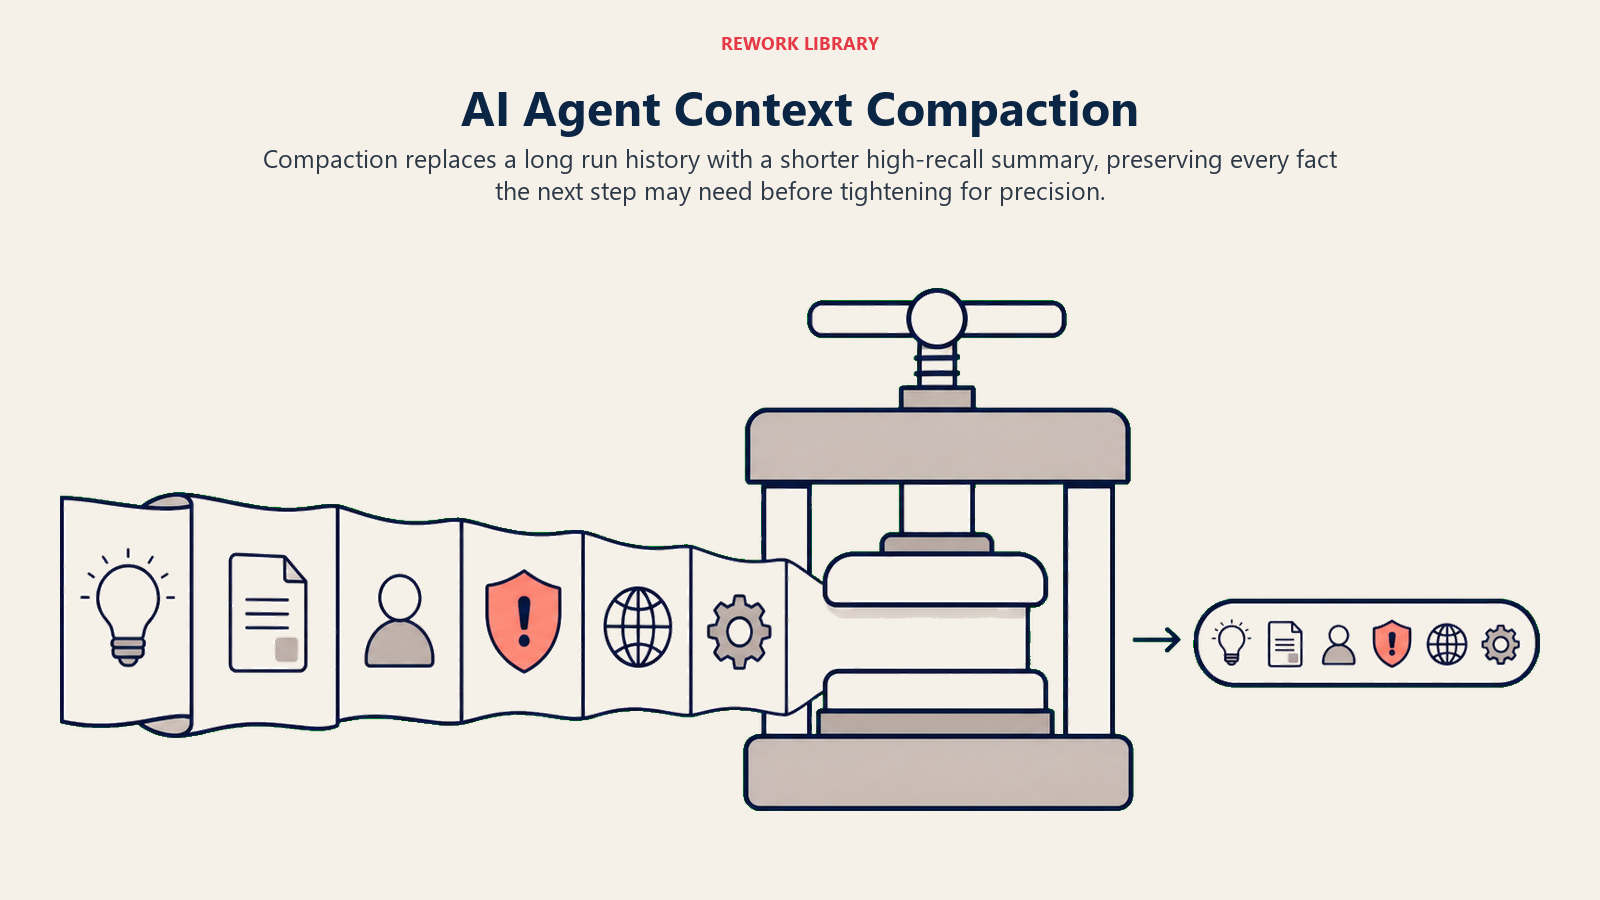
Compaction ist das, was Sie tun, wenn ein Lauf bereits mehr Verlauf angesammelt hat, als er in voller Länge behalten muss: Fassen Sie zusammen, was bisher geschehen ist, in komprimierter Form, und setzen Sie die Aufgabe dann von dieser Zusammenfassung aus fort, statt vom gesamten Protokoll. Die Empfehlung von Anthropic ist konkret, wie das gut gelingt: Zielen Sie zuerst auf hohen Recall, stellen Sie also sicher, dass der Compaction-Schritt jede Information erfasst, die der nächste Schritt tatsächlich brauchen könnte, und straffen Sie erst dann auf Präzision, wenn Sie bestätigt haben, dass nichts Wichtiges verloren geht. Die Reihenfolge umzudrehen, also auf eine kurze Zusammenfassung zu optimieren, bevor bestätigt ist, dass sie vollständig ist, führt dazu, dass ein verdichteter Agent unbemerkt anfängt, Wichtiges zu vergessen.
Eine verwandte, ältere Idee, die man kennen sollte, ist MemGPT, ein Vorschlag, der gestuften Speicher aus Betriebssystemen entlehnt: Eine kleine Menge „heißer“ Informationen bleibt im unmittelbaren Kontext des Modells, alles andere wird in langsameren, größeren Speicher ausgelagert und nur zurückgeholt, wenn ein Schritt es tatsächlich braucht. Compaction und das als Nächstes behandelte Just-in-Time-Retrieval sind beides praktische Varianten derselben Auslagerungsidee.
Just-in-Time-Retrieval schlägt alles vorab laden
Der Instinkt, wenn ein Agent eine Information womöglich braucht, ist, sie vorsorglich gleich in den Kontext zu laden. Das bessere Muster, auf das sich auch die Empfehlungen von Anthropic stark stützen, ist Just-in-Time-Retrieval: Geben Sie dem Agent eine leichtgewichtige Referenz, einen Dateipfad, eine Datensatz-ID, ein Suchtool, und lassen Sie ihn den eigentlichen Inhalt erst in dem Schritt abrufen, in dem er gebraucht wird. Das entspricht der Arbeitsweise eines Menschen. Niemand lernt ein ganzes Richtlinienhandbuch auswendig, bevor er eine Frage zur Elternzeit beantwortet; man schlägt den relevanten Abschnitt nach, wenn die Frage kommt.
Genau diese Mechanik beschreibt RAG für AI Agents: Retrieval innerhalb eines Agents ist im Grunde ein Tool-Aufruf wie jeder andere, sitzt im Wahrnehmungsschritt der Schleife und wird ausgelöst, wenn ein bestimmter Schritt bestimmte Informationen braucht, statt zu Beginn pauschal geladen zu werden. Der Gewinn für das Context Management ist vom Grounding-Gewinn getrennt. Selbst wenn ein Modell technisch eine ganze Wissensbasis in sein Fenster bekäme, wäre das trotzdem der falsche Schritt, denn jedes Token darin über das hinaus, was der aktuelle Schritt braucht, verwässert die Aufmerksamkeit des Modells für die Tokens, auf die es gerade ankommt.
Auslagern an Sub-Agents: Ein sauberes Fenster für eine fokussierte Aufgabe
Wenn ein einzelner Schritt innerhalb einer größeren Aufgabe viel lesen, recherchieren oder erkunden muss, um etwas Eng-umrissenes zu erreichen, ist eine der wirksameren Maßnahmen im Context Management, diesen Schritt an einen separaten Sub-Agent zu übergeben, statt ihn inline auszuführen. Der Sub-Agent bekommt sein eigenes sauberes Kontextfenster, erledigt dort die schwere Arbeit und gibt ein verdichtetes Ergebnis an den Haupt-Agent zurück, laut Anthropics eigenen Beispielen oft im Bereich von 1.000 bis 2.000 Tokens, statt seinen gesamten Arbeitsprozess mitzuschleppen.
Multi-Agent-Systeme behandelt die Orchestrierungsseite dieses Musters ausführlich: wann sich die Aufteilung einer Aufgabe auf mehrere Agents die zusätzliche Komplexität verdient und wann es Over-Engineering für eine Aufgabe ist, die ein einzelner Agent noch bewältigen könnte. Aus rein kontextbezogener Sicht ist das Argument für einen Sub-Agent enger und mechanischer: Ein Schritt, der das Fenster des Haupt-Agents sonst mit Erkundungsdetails überfluten würde, die er nicht weitertragen muss, ist ein guter Kandidat, um ihn zu isolieren, zusammenzufassen und zurückzugeben.
Die Kontextgesundheit nach dem Go-live beobachten
Eine Kontextstrategie, die im Test funktioniert, kann driften, sobald echter Traffic darauf trifft: Tool-Ausgaben werden nach einem API-Update ausführlicher, eine Wissensbasis wächst, ein Sonderfall wird fest in den System Prompt geschrieben und nie wieder entfernt. AI Agent Observability nennt bereits die Kennzahlen, die sich hier zu verfolgen lohnen: Steigende Schleifendurchläufe pro Lauf und steigende Kosten pro abgeschlossener Aufgabe sind beide frühe Zeichen, dass der Kontext unbemerkt aufbläht, oft bevor die Genauigkeit sichtbar sinkt. AI Agent Cost Optimization behandelt die Caching-Seite derselben Medaille: wiederverwendeten Kontext beim erneuten Senden drastisch günstiger zu machen. Das ist neben der Compaction wichtig, nicht statt ihrer, denn auch gut gecachter Kontext muss bei jedem Aufruf weiterhin beachtet werden.
Wenn Sie Plattformen bewerten, die große Codebasen oder langlaufende Sessions gut handhaben, behandeln sowohl unsere Vergleiche von Entwickler-Tools als auch der Kaufleitfaden für AI-Coding-Assistenten den Umgang mit dem Kontextfenster als echtes Unterscheidungsmerkmal und nicht als Randnotiz, denn hier zeigt sich die Qualität eines Coding-Assistenten bei einem großen Projekt am deutlichsten.
Key Facts
- Anthropic beschreibt Kontext als begrenzte Ressource mit abnehmendem Grenznutzen: Zusätzliche Tokens über den Bedarf eines Schritts hinaus kosten nicht nur mehr, sie können die Aufmerksamkeit des Modells für das wirklich Wichtige verwässern.
- Ergebnisse von Tool-Aufrufen, nicht der Konversationsverlauf, sind meist der am schnellsten wachsende Teil des Kontexts eines Agents, da viele APIs weit mehr zurückliefern, als ein einzelner Schritt braucht.
- Compaction sollte zuerst auf Recall optimieren (alles erfassen, was wichtig sein könnte) und erst danach auf Präzision (die Zusammenfassung straffen), nicht umgekehrt.
- Sub-Agents, die einen engen, erkundungsintensiven Schritt übernehmen, geben typischerweise ein verdichtetes Ergebnis von etwa 1.000 bis 2.000 Tokens an den Haupt-Agent zurück, statt ihren gesamten Arbeitskontext weiterzutragen.
- Steigende Schleifendurchläufe und steigende Kosten pro abgeschlossener Aufgabe sind Frühwarnzeichen für aufgeblähten Kontext, oft sichtbar, bevor die Genauigkeit sinkt.
Wie es weitergeht
Context Management ist die tägliche Disziplin, die einen Agent schnell, genau und bezahlbar hält, wenn die Aufgaben länger werden. AI Agent Memory behandelt die Speicherseite ausführlicher, RAG für AI Agents behandelt Retrieval speziell als Grounding-Technik, und AI Agent Observability zeigt, wie Sie aufgeblähten Kontext nach dem Start erkennen, bevor er sich als Kostenspitze oder stiller Genauigkeitsverlust zeigt.

On this page
- Warum das ein Agent-Problem ist und kein Chat-Problem
- Was den Kontext eines Agents tatsächlich füllt
- Budgetierung: Entscheiden, was sich einen Platz verdient, bevor es voll ist
- Compaction: Zusammenfassen, bevor es überläuft, nicht danach
- Just-in-Time-Retrieval schlägt alles vorab laden
- Auslagern an Sub-Agents: Ein sauberes Fenster für eine fokussierte Aufgabe
- Die Kontextgesundheit nach dem Go-live beobachten
- Key Facts
- Wie es weitergeht