Wie AI Agents schlussfolgern: ReAct, Planung und Reflexion
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Ein AI Agent schlussfolgert, indem er zwischen Denken und Handeln wechselt: Er formuliert einen kurzen Gedanken dazu, was als Nächstes zu tun ist, führt eine Aktion aus, meist einen Tool-Aufruf, liest, was passiert ist, und denkt erneut nach, bevor er den nächsten Zug macht. Dieses verschränkte Muster heißt ReAct und ist die Grundlage, auf der die meisten Agents aufbauen. Zwei Techniken erweitern es: Planung, bei der der Agent mehrere Schritte skizziert, bevor er einen davon ausführt, und Reflexion, bei der er seinen eigenen Versuch kritisch prüft und es erneut versucht, wenn der erste Durchgang nicht genügt.
Reasoning ist der „Reason“-Schritt der Schleife, sichtbar gemacht
Wie AI Agents funktionieren beschreibt den Agent-Loop als wahrnehmen, schlussfolgern, handeln, beobachten, wiederholen. Dieser Artikel handelt davon, was innerhalb des Schlussfolgerungsschritts geschieht, und das ist weniger geheimnisvoll, als es klingt. „Reasoning“ bedeutet hier, dass das Modell vor einer Aktion Zwischentext über seinen eigenen nächsten Zug erzeugt, in derselben Konversation, wo Sie ihn lesen können. Es ist kein verborgener Prozess irgendwo anders. Ein Support-Agent, der entscheidet, wie er ein Ticket bearbeitet, erzeugt vielleicht Folgendes, noch bevor er ein Tool aufruft: „Diese Nachricht erwähnt eine fehlgeschlagene Zahlung und einen verärgerten Ton, also sollte ich den Transaktionsverlauf prüfen, bevor ich eine Antwort entwerfe.“
Diese Gewohnheit, Zwischenschritte des Schlussfolgerns auszuschreiben, heißt Chain-of-Thought und ist der Baustein unter allem in diesem Artikel. Was Chain-of-Thought ist behandelt die Technik für sich. Hier geht es speziell darum, wie dieses Schlussfolgern in eine Schleife eingebunden wird, die auch echte Aktionen ausführt. Das ist ein anderes Problem, als eine statische Frage durchzudenken.
ReAct: Schlussfolgern und Handeln in derselben Schleife
ReAct steht für „Reasoning and Acting“ und stammt aus einem Paper von Yao und Kollegen aus dem Jahr 2022. Es zeigte, dass Sprachmodelle besser abschneiden, wenn sie kurze Denkschritte mit Aktionen verschränken, statt bis zu einer endgültigen Antwort durchzudenken und erst dann zu handeln, oder ganz ohne Reasoning zu handeln. Das Muster ist einfach: Thought, dann Action, dann Observation, wiederholt, bis die Aufgabe erledigt ist. Der Gedanke erklärt, was der Agent als Nächstes herausfinden will, die Aktion ist meist ein Tool-Aufruf, und die Beobachtung ist das, was zurückkam.
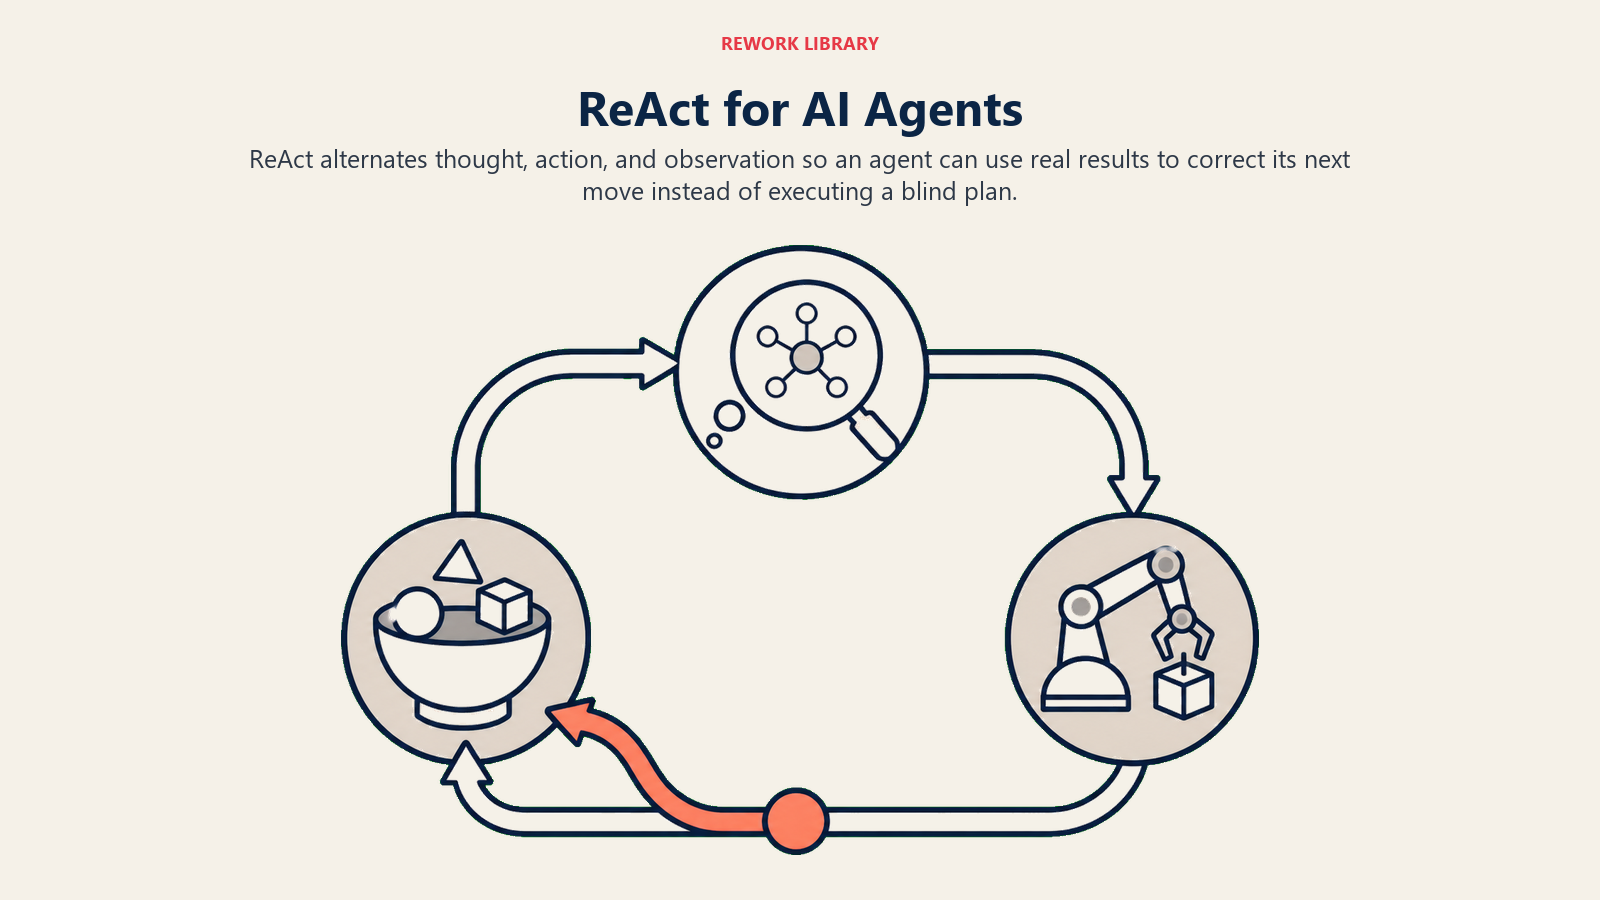
Die Ergebnisse der ursprünglichen Forschung waren beachtlich. Auf zwei Benchmarks für interaktive Entscheidungsfindung, ALFWorld und WebShop, übertraf ReAct Baselines aus Imitation Learning und Reinforcement Learning um 34 Prozentpunkte (71 % gegenüber 37 %) beziehungsweise rund 11 Prozentpunkte (40 % gegenüber 29,1 %), und das mit nur einem oder zwei Beispielen, um das Muster vorzuführen. Der Grund, warum Verschränkung besser funktioniert, als alles im Voraus zu planen und dann blind auszuführen, ist naheliegend: Der Agent kann den Kurs anhand dessen korrigieren, was tatsächlich passiert ist, nicht dessen, was er angenommen hat. Liefert eine Suche nichts Brauchbares, kann der nächste Gedanke das feststellen und eine andere Anfrage versuchen, statt mit einem aus einer Vermutung gebauten Plan weiterzupreschen.
Das ist derselbe Mechanismus hinter der Schleife, die das Autonomous-Agent-Muster beschreibt: den aktuellen Zustand aufnehmen, analysieren, was bekannt ist und was fehlt, die nächstbeste Aktion vorhersagen, sie erzeugen, ausführen und wiederholen. ReAct ist die konkrete Umsetzung der Reasoning-Hälfte dieses Zyklus.
Planung: Mehrere Schritte vorausdenken
Reines ReAct improvisiert Schritt für Schritt. Das funktioniert gut bei Aufgaben, bei denen der richtige nächste Zug erst nach dem letzten Ergebnis klar wird. Manche Aufgaben profitieren von mehr Struktur. Bei der Planung zerlegt der Agent ein Ziel in eine geordnete Reihe von Teilschritten, bevor er einen davon ausführt, eher wie das Schreiben einer Gliederung vor dem Entwurf, als sich Satz für Satz etwas auszudenken.
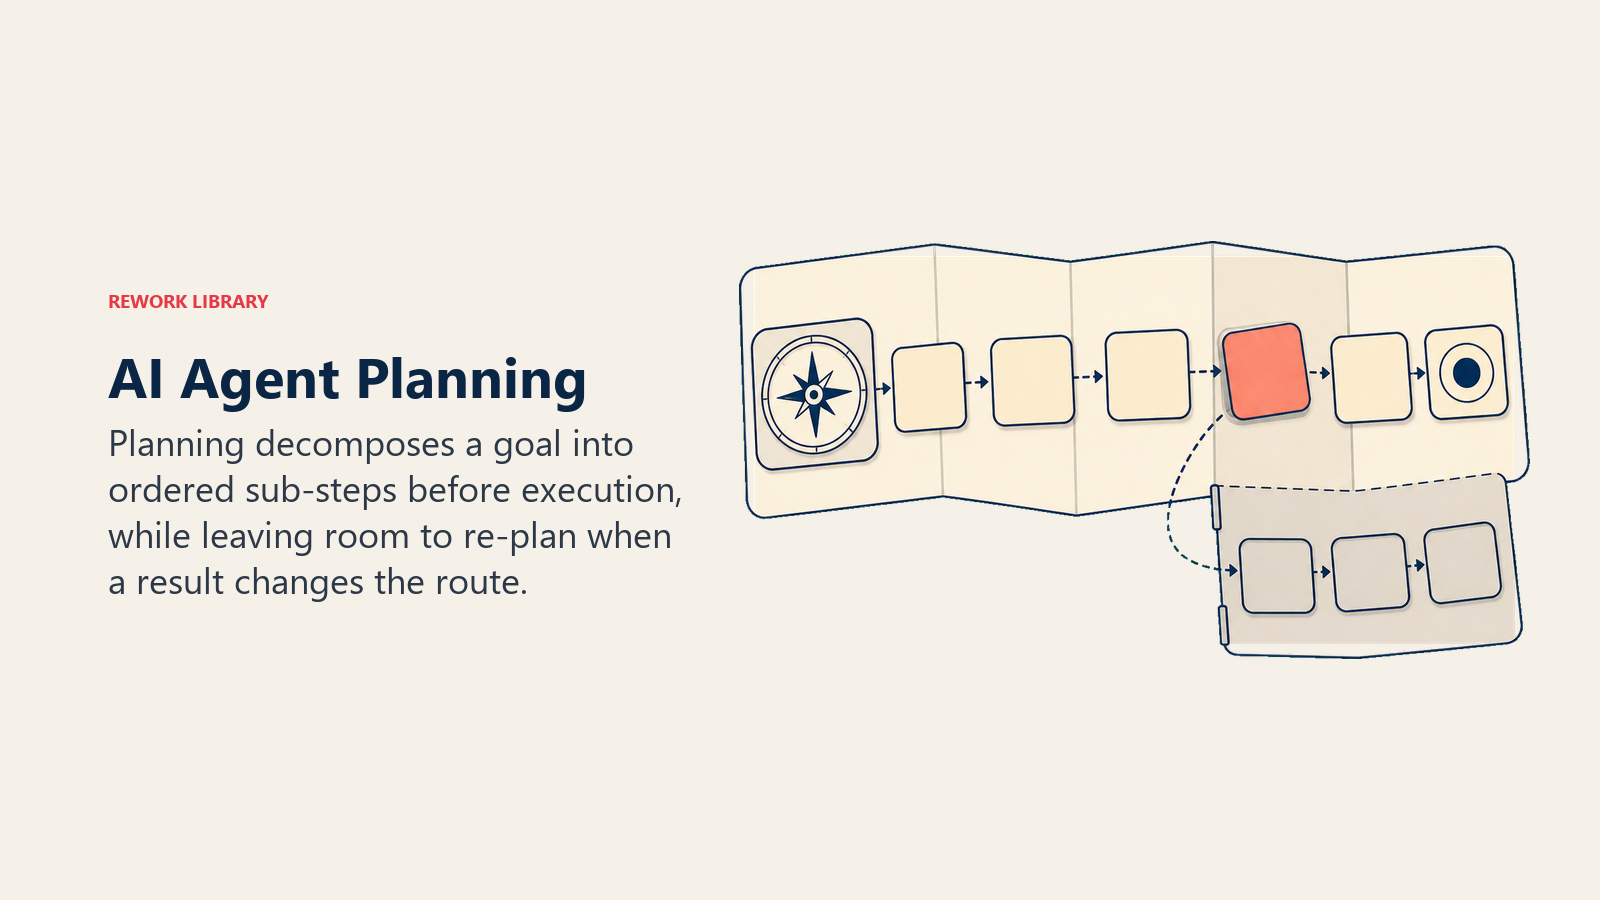
Eine Umsatzprognose ist ein gutes Beispiel. Statt eine Abfrage nach der anderen zu improvisieren, profitiert ein Agent, der auf dem AI Forecasting Agent-Blueprint aufbaut, davon, seinen Ansatz zuerst zu planen: historische Abschlussquoten nach Segment ziehen, die aktuelle Pipeline-Abdeckung prüfen, offene Deals nach Phase gewichten und daraus eine Spanne bilden. Jeder dieser Teilschritte kann intern weiterhin seine eigene ReAct-Schleife durchlaufen, aber die Gesamtform wurde vorab festgelegt, statt Schritt für Schritt entdeckt zu werden.
Planung ist keine einmalige Festlegung. Wenn ein Schritt scheitert oder neue Informationen das Bild verändern, plant ein gut gebauter Agent neu, statt den ursprünglichen Plan trotzdem durchzudrücken. Eine erwähnenswerte Erweiterung ist Tree-of-Thought-Reasoning, bei dem der Agent mehr als einen Planungskandidaten erkundet und vergleicht, bevor er sich festlegt. Das ist nützlich, wenn es wirklich mehr als einen vernünftigen Ansatz gibt. Was Reasoning-Modelle sind behandelt dieses Terrain ausführlicher, einschließlich der breiteren Entwicklung hin zu Modellen, die vor der Antwort mehr Rechenaufwand ins Abwägen stecken.
Reflexion: Eigene Fehler erkennen
Reflexion fügt eine andere Fähigkeit hinzu: Nach einem Versuch bewertet der Agent seine eigene Ausgabe am Ziel und überarbeitet sie, wenn sie nicht genügt, statt den ersten Entwurf als endgültig zu behandeln.
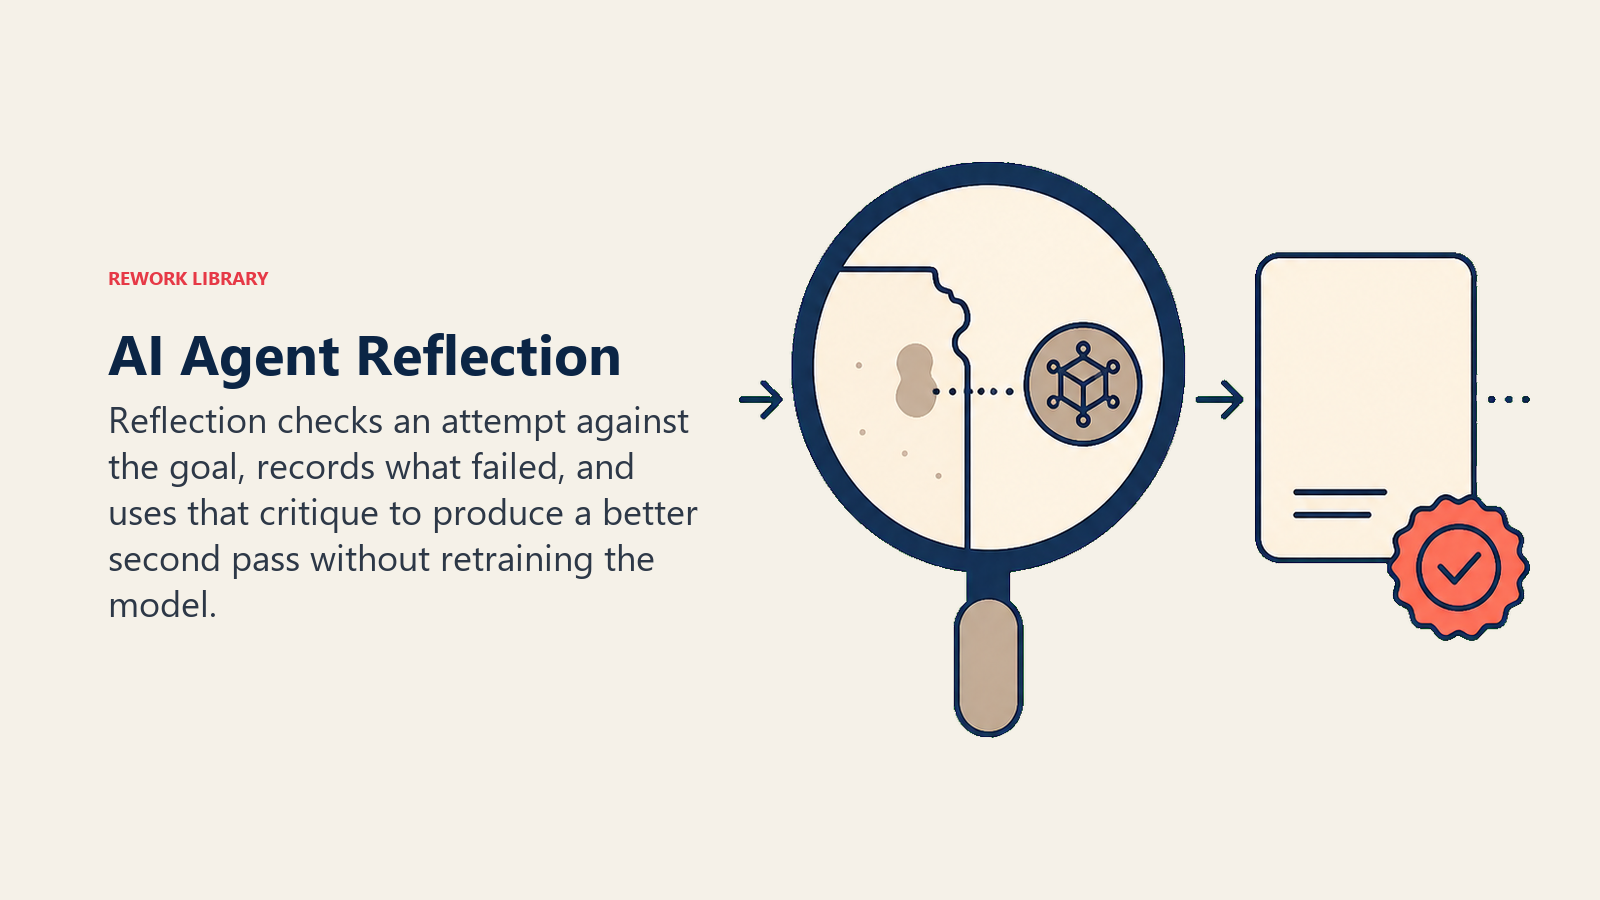
Zur Forschung dahinter, einem Paper von Shinn und Kollegen aus dem Jahr 2023 zu Reflexion, lohnt es sich, die tatsächlichen Zahlen zu kennen. Ihr Ansatz erreichte 91 % pass@1-Genauigkeit auf dem Coding-Benchmark HumanEval, gegenüber 80 % für die damalige GPT-4-Standard-Baseline, und nutzte dafür lediglich eine verbale Selbstkritik-Schleife, die zwischen den Versuchen im Gedächtnis gespeichert wurde. Kein Re-Training, keine neuen Modellgewichte, nur der Agent, der seinen eigenen gescheiterten Versuch liest, in einfacher Sprache aufschreibt, was schiefgelaufen ist, und es mit dieser Notiz im Kontext erneut versucht. Diese gespeicherte Selbstkritik ist eine Form des Arbeitsgedächtnisses, das Wie AI Agents funktionieren behandelt. Wenn Sie ein vollständigeres Bild davon wollen, wie Agents solche Informationen über Schritte und Durchläufe hinweg festhalten, ist AI Memory die vertiefende Referenz.
Geschäftlich nutzt der Content Drafting Agent-Blueprint eine verwandte Idee: entwerfen, den Entwurf mit Markenrichtlinien und erforderlichen Elementen abgleichen und überarbeiten, bevor er zur finalen Prüfung an einen Menschen geht. Die Selbstprüfung ersetzt die menschliche Prüfung nicht. Sie reduziert, wie viele Entwürfe mit einem vermeidbaren, offensichtlichen Fehler ankommen.
Alles zusammen: Ein Reasoning-Trace im Durchgang
So sehen alle drei Techniken kombiniert an einer realen Aufgabe aus. Der AI Research Agent-Blueprint soll vor einem Sales-Call ein Briefing über ein Zielunternehmen erstellen.
- Planen. Der Agent zerlegt das Ziel in Teilaufgaben: aktuelle Finanzierungsaktivitäten, Wechsel in der Führung und alle Neuigkeiten des letzten Quartals.
- ReAct-Schleife, Teilaufgabe eins. Thought: „Ich brauche aktuelle Finanzierungsnachrichten.“ Action: Suche. Observation: drei Treffer, einer von einer glaubwürdigen Quelle. Thought: „Das wirkt aktuell und relevant, ich lese es.“ Action: Seite abrufen. Observation: Finanzierungsrunde bestätigt, mit Datum und Betrag.
- ReAct-Schleife, Teilaufgaben zwei und drei. Derselbe Zyklus aus Gedanke, Aktion und Beobachtung wiederholt sich für Führungswechsel und aktuelle Neuigkeiten. Jede Schleife endet, sobald der Agent glaubt, genug Signal zu haben.
- Reflektieren. Vor dem Abschluss prüft der Agent seinen eigenen Entwurf am ursprünglichen Ziel: Deckt er alle drei Teilaufgaben ab, ist etwas veraltet oder unbestätigt, fehlt für eine Aussage eine Quelle? Zeigt sich eine Lücke, wird daraus eine weitere gezielte Suche, statt das Briefing mit einem Loch auszuliefern.
Drei Techniken, ein stimmiges Ergebnis und bei jedem Schritt ein Trace, den ein Mensch nachlesen und verstehen kann, was ebenso wichtig ist wie die endgültige Antwort.
Warum Reasoning-Tiefe ein Kosten- und Vertrauens-Tradeoff ist
Nichts davon ist umsonst. Jeder Gedanke, den der Agent ausschreibt, sind Tokens, und jeder zusätzliche ReAct-Zyklus oder Reflexionsdurchgang erhöht die Latenz. Eine einfache Abfrage braucht keine mehrstufige Planung und keinen Selbstkritik-Durchgang, sondern eine schnelle, direkte Antwort. Was Reasoning-Modelle sind behandelt die breitere Frage, wann ausgedehntes, bewusstes Schlussfolgern die Mehrkosten wert ist und wann eine schnelle Standardantwort die bessere Wahl ist. Diese Unterscheidung gilt für die interne Reasoning-Tiefe eines Agents genauso wie für die Modellwahl.
Die andere Seite des Tradeoffs ist Vertrauen, nicht nur Kosten. Ein Modell kann sich ebenso flüssig und selbstsicher zu einer falschen Aktion durchdenken wie zu einer richtigen. Die Leitlinien Building Effective Agents von Anthropic, abgeleitet aus Produktiveinsätzen, plädieren dafür, Agent-Schleifen so einfach zu halten, wie die Aufgabe es zulässt, statt standardmäßig nach maximaler Autonomie zu greifen, gerade weil mehr Reasoning-Schritte mehr Stellen bedeuten, an denen sich ein Fehler unbemerkt einschleichen kann. Deshalb sollte jeder Reasoning-Trace protokolliert und prüfbar sein, nicht nur die endgültige Aktion. AI-Agent-Observability behandelt, was diese Protokollierungs- und Monitoring-Ebene enthalten muss.
Key Facts
- Reasoning in einem Agent bedeutet, dass das Modell vor dem Handeln sichtbaren Zwischentext über seinen nächsten Zug erzeugt, meist über einen Prozess im Stil von Chain-of-Thought.
- ReAct verschränkt Schlussfolgern und Handeln in derselben Schleife. In der ursprünglichen Forschung übertraf es Baselines aus Imitation Learning und Reinforcement Learning um 34 Punkte auf ALFWorld und rund 11 Punkte auf WebShop.
- Planung zerlegt ein Ziel vor der Ausführung in geordnete Teilschritte, und ein gut gebauter Agent plant neu, wenn ein Schritt scheitert oder neue Informationen das Bild verändern.
- Bei der Reflexion kritisiert der Agent seinen eigenen Versuch und überarbeitet ihn. Die Reflexion-Forschung erreichte 91 % pass@1 auf HumanEval gegenüber einer Baseline von 80 % mit einer verbalen Selbstkritik-Schleife, ganz ohne Re-Training.
- Tieferes Reasoning kostet mehr Tokens, Zeit und Geld und verringert nicht das Risiko einer selbstsicher falschen Aktion. Deshalb müssen Reasoning-Traces protokolliert und prüfbar sein, statt ihnen einfach zu vertrauen.
Häufig gestellte Fragen zu: Wie AI Agents schlussfolgern
Was ist ReAct bei AI Agents?
ReAct steht für Reasoning and Acting. Es ist ein Muster, bei dem ein AI Agent kurze Denkschritte (Thoughts) mit echten Aktionen (meist Tool-Aufrufen) verschränkt und das Ergebnis (eine Observation) liest, bevor er den nächsten Gedanken fasst. Er denkt also nicht erst bis zu einer endgültigen Antwort durch, bevor er handelt, und handelt auch nicht ganz ohne Reasoning.
Was ist der Unterschied zwischen Planung und Reflexion bei AI Agents?
Planung geschieht vor der Ausführung: Der Agent zerlegt ein Ziel vorab in geordnete Teilschritte. Reflexion geschieht nach einem Versuch: Der Agent bewertet seine eigene Ausgabe am Ziel und überarbeitet sie, wenn sie nicht genügt. Viele produktive Agents nutzen beides, dazu ReAct-artiges schrittweises Schlussfolgern innerhalb jeder geplanten Teilaufgabe.
Macht mehr Reasoning einen AI Agent genauer?
Oft, aber nicht automatisch und nicht kostenlos. Forschung zu ReAct und zu reflexionsbasierten Ansätzen zeigt echte Genauigkeitsgewinne bei mehrstufigen Aufgaben. Aber jeder zusätzliche Reasoning-Schritt kostet Tokens und Zeit, und ein längerer Reasoning-Trace kann trotzdem zu einem selbstsicher falschen Schluss führen. Deshalb muss der Trace protokolliert und geprüft werden, statt ihm nur zu vertrauen, weil er länger ist.
Kann ein AI Agent seine eigenen Fehler korrigieren?
Ja, mit Grenzen. Reflexion lässt einen Agent bestimmte Arten von Fehlern erkennen und korrigieren, etwa einen fehlgeschlagenen Test oder einen unvollständigen Entwurf, indem er seine eigene Ausgabe kritisiert und es erneut versucht. Fehler, die sich aus den ihm verfügbaren Informationen nicht erkennen lassen, kann er nicht finden. Deshalb bleibt die menschliche Prüfung bei folgenreichen Entscheidungen wichtig.
Wie hängt Agent-Reasoning mit Reasoning-Modellen wie OpenAI o1 zusammen?
Sie sind verwandt, aber verschieden. Reasoning-Modelle werden darauf trainiert, vor der Antwort auf eine einzelne Frage zusätzlichen Rechenaufwand ins Abwägen zu stecken. Agent-Reasoning-Techniken wie ReAct, Planung und Reflexion sind Muster, um dieses Abwägen über eine mehrstufige Aufgabe zu strukturieren, die auch echte Aktionen umfasst. Ein Agent kann auf einem Standardmodell oder einem Reasoning-Modell aufbauen. Die Wahl hängt davon ab, wie anspruchsvoll das Schlussfolgern der Aufgabe ist.
Ist Chain-of-Thought dasselbe wie Agent-Reasoning?
Chain-of-Thought ist die zugrunde liegende Technik: ein Modell dazu zu bringen, Zwischenschritte des Schlussfolgerns auszuschreiben, statt direkt zur Antwort zu springen. Agent-Reasoning baut auf derselben Gewohnheit auf, bindet sie aber in eine Schleife ein, die auch Aktionen ausführt und echte Ergebnisse zurückliest. Das ist ein anderes und aufwendigeres Problem, als eine einzelne statische Frage durchzudenken.
Wie es weitergeht
Reasoning entscheidet, was ein Agent als Nächstes tut. Wie AI Agents Tools nutzen behandelt, was passiert, sobald diese Entscheidung zur Aktion wird. Wie sich die Reasoning-Schleife eines einzelnen Agents verändert, wenn die Arbeit stattdessen auf mehrere Agents verteilt wird, zeigen Multi-Agent-Systeme. Und wenn Sie das in einen eigenen Agent umsetzen wollen, führt Wie Sie einen AI Agent bauen den Bauprozess von Anfang bis Ende durch. Die Übersicht zu Productivity-Tools und der Leitfaden Wie Sie einen AI-Coding-Assistenten auswählen sind nützliche nächste Stationen, falls Sie ein Reasoning-lastiges Coding-Agent-Tool evaluieren.

On this page
- Reasoning ist der „Reason“-Schritt der Schleife, sichtbar gemacht
- ReAct: Schlussfolgern und Handeln in derselben Schleife
- Planung: Mehrere Schritte vorausdenken
- Reflexion: Eigene Fehler erkennen
- Alles zusammen: Ein Reasoning-Trace im Durchgang
- Warum Reasoning-Tiefe ein Kosten- und Vertrauens-Tradeoff ist
- Key Facts
- Wie es weitergeht