AI Agents in Produktion bringen: Testing, Rollout und Rollback
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Einen AI Agent in Produktion zu bringen ist ein gestaffelter Prozess, kein einzelner „Einschalt“-Moment: Sie testen ihn an realen historischen Fällen, rollen ihn schrittweise hinter Gates wie Shadow Mode und menschlicher Freigabe aus, überwachen die wenigen Kennzahlen, die ein Scheitern tatsächlich vorhersagen, und halten einen schnellen Rollback-Pfad bereit, bevor Sie ihn brauchen. Überspringen Sie eine Stufe, wird der Agent, der im Demo perfekt lief, nach drei Wochen echtem Traffic zum Agent, dem niemand mehr traut. Dieser Leitfaden behandelt alle vier Stufen, unabhängig davon, auf welcher Plattform oder in welchem Framework Sie den Agent gebaut haben.
Warum „Im Demo hat es funktioniert“ nicht reicht
In der Lücke zwischen einem funktionierenden Prototyp und einem Produktionssystem, das den Kontakt mit echtem, unordentlichem und feindlichem Input übersteht, sterben die meisten Agent-Projekte tatsächlich. Die NANDA-Initiative des MIT stellte 2025 fest, dass 95 % der generativen AI-Pilotprojekte in Unternehmen keinen messbaren finanziellen Ertrag lieferten, trotz geschätzter 30 bis 40 Milliarden $ an Unternehmensinvestitionen. Die Einordnung des Berichts selbst ist hier wichtig: Das Scheitern lag nicht an der Qualität des zugrunde liegenden Modells, sondern an Piloten, denen die operative Disziplin fehlte, um zu etwas zu werden, auf das sich ein Unternehmen tatsächlich verlassen kann.
Gartner beziffert die agentenspezifische Version desselben Problems und prognostiziert, dass über 40 % der Agentic-AI-Projekte bis Ende 2027 eingestellt werden. Als Hauptursachen nennt Gartner steigende Kosten, unklaren Geschäftsnutzen und unzureichende Risikokontrollen, nicht gescheiterte Technologie. Alle drei sind Deployment-Probleme, keine Modellprobleme, und genau das behebt dieser Leitfaden.
Wenn Sie den Agent noch nicht gebaut haben: Wie man einen AI Agent baut behandelt die sechs Bausteine, die all dem vorausgehen, und einen AI Agent mit CrewAI bauen sowie No-Code- vs. Code-AI-Agents behandeln den Bau selbst. Dieser Leitfaden setzt ein, sobald Sie eine Version haben, die im Test funktioniert, und entscheiden, wie Sie sie sicher vor echtes Volumen bringen.
Stufe 1: An realen Fällen testen, nicht an erfundenen
Bevor irgendetwas live geht, lassen Sie den Agent gegen ein Testset laufen, das aus realen historischen Fällen gebaut ist, nicht aus hypothetischen, die Sie sich beim Bauen ausgedacht haben. Wie man AI Agents evaluiert und testet behandelt das ausführlich: das Testset aufbauen, definieren, was Erfolg für genau diese Aufgabe bedeutet, und Ergebnisse mit Regeln, menschlicher Prüfung oder einem LLM-as-Judge bewerten. Behandeln Sie diese Evaluierungspraxis als Voraussetzung für alles Weitere, nicht als Schritt, den Sie abkürzen können, sobald das Demo gut aussieht.
Stufe 2: Schrittweise ausrollen
Niemand sollte einen Agent in einem Schritt von null auf 100 % des Volumens schalten. Ein gestaffelter Rollout fängt Probleme ab, solange der Schadensradius noch klein ist.
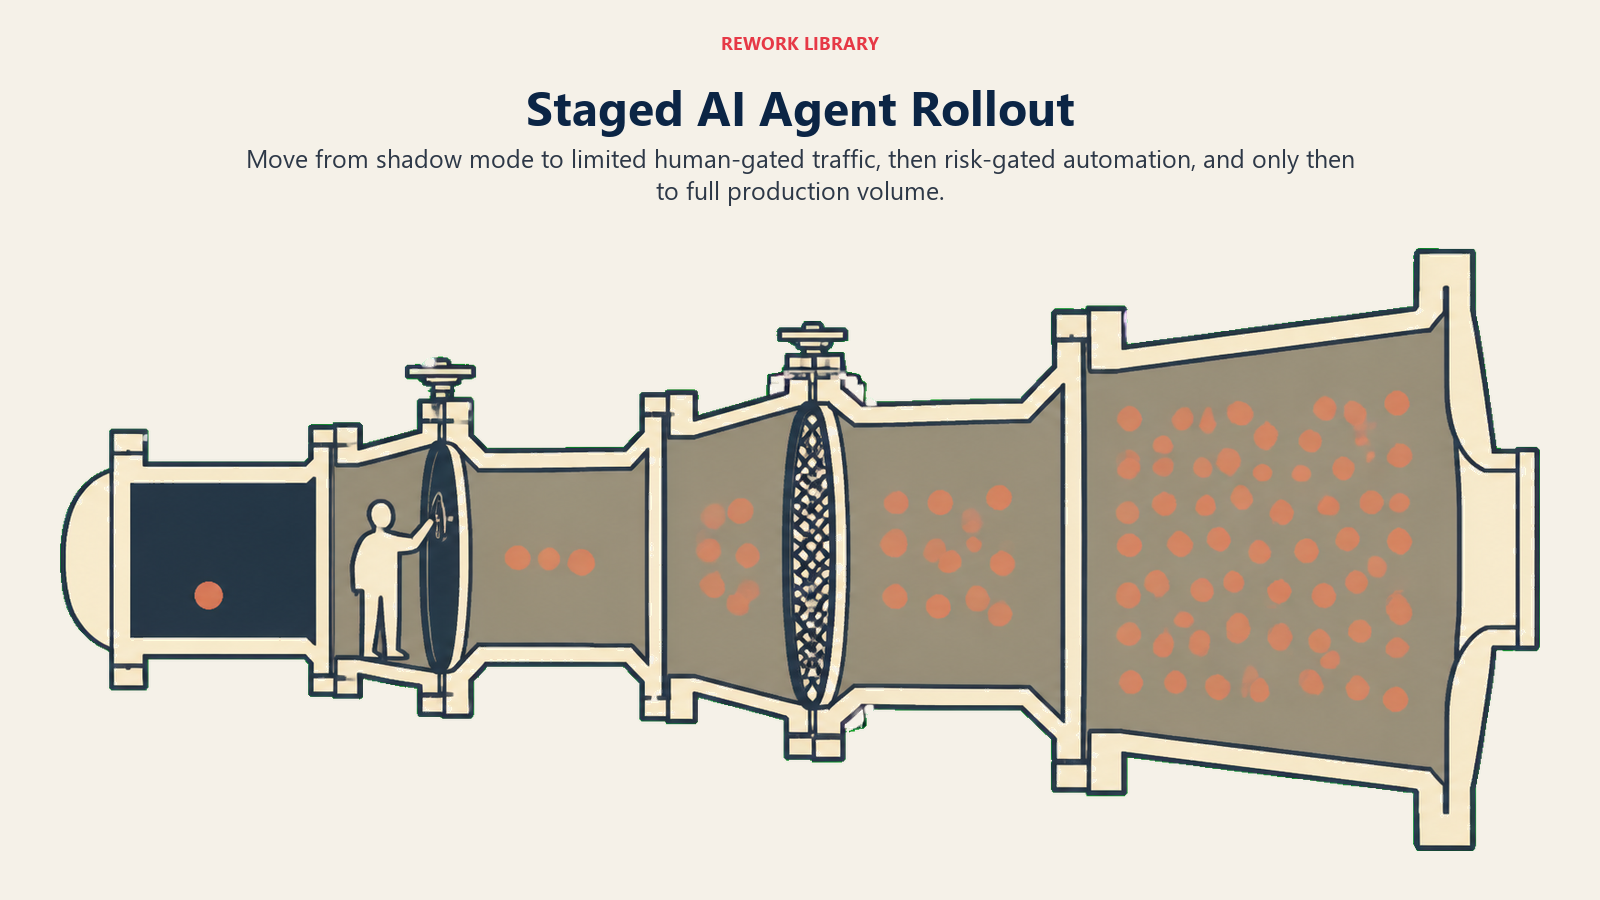
| Stufe | Was passiert | Was sie abfängt |
|---|---|---|
| Shadow Mode | Der Agent läuft auf Live-Input, aber seine Ausgabe wird nicht umgesetzt; ein Mensch oder der alte Prozess erledigt weiterhin alles | Ob seine Entscheidungen mit dem übereinstimmen, was tatsächlich geschah, ohne Risiko für Kunden |
| Begrenzter Traffic, menschlich freigegeben | Der Agent handelt bei einem kleinen Prozentsatz des Volumens, und ein Mensch gibt frei, bevor etwas rausgeht | Reale Sonderfälle, mit weiterhin vorhandenem Sicherheitsnetz |
| Voller Traffic, nach Risiko abgesichert | Der Agent handelt bei Fällen mit geringem Risiko automatisch und übergibt alles mit hohem Einsatz weiterhin | Ob die Entscheidungslogik (handeln, nachfragen oder übergeben) richtig abgestimmt ist |
| Voller Rollout | Der Agent läuft mit vollem Volumen, nur mit Guardrails und Monitoring | Laufenden Drift und Sonderfälle, die erst im echten Maßstab auftauchen |
Wo Sie die Gates setzen, sollte sich an den Kosten eines Fehlers orientieren. Ein Agent wie der AI CRM Hygiene Agent, der einen doppelten Datensatz korrigiert, kann diese Stufen schnell durchlaufen. Ein Agent wie der AI Collections and AR Agent, der einen Kunden um geschuldetes Geld mahnt, oder der AI Invoice and AP Agent, der eine Zahlung freigibt, verdient einen längeren Aufenthalt in der menschlich freigegebenen Stufe, denn eine falsche autonome Aktion kostet echtes Geld und eine echte Kundenbeziehung, nicht nur Unannehmlichkeiten. Human-in-the-Loop für AI Agents behandelt genau, wie Sie diese Freigabe-Gates so gestalten, dass sie echtes Risiko abfangen, ohne zum Durchwinken zu werden.
Stufe 3: Überwachen, was ein Scheitern tatsächlich vorhersagt
Ist ein Agent live, ist das Beobachten eine andere Disziplin als das Testen. AI Agent Observability behandelt den vollständigen Stack aus Tracing und Kennzahlen im Detail; die Kurzfassung lautet, dass Sie in jedem Schritt sehen müssen, welches Tool er mit welchem Ergebnis aufgerufen hat, nicht nur, ob die finale Ausgabe vernünftig aussah.
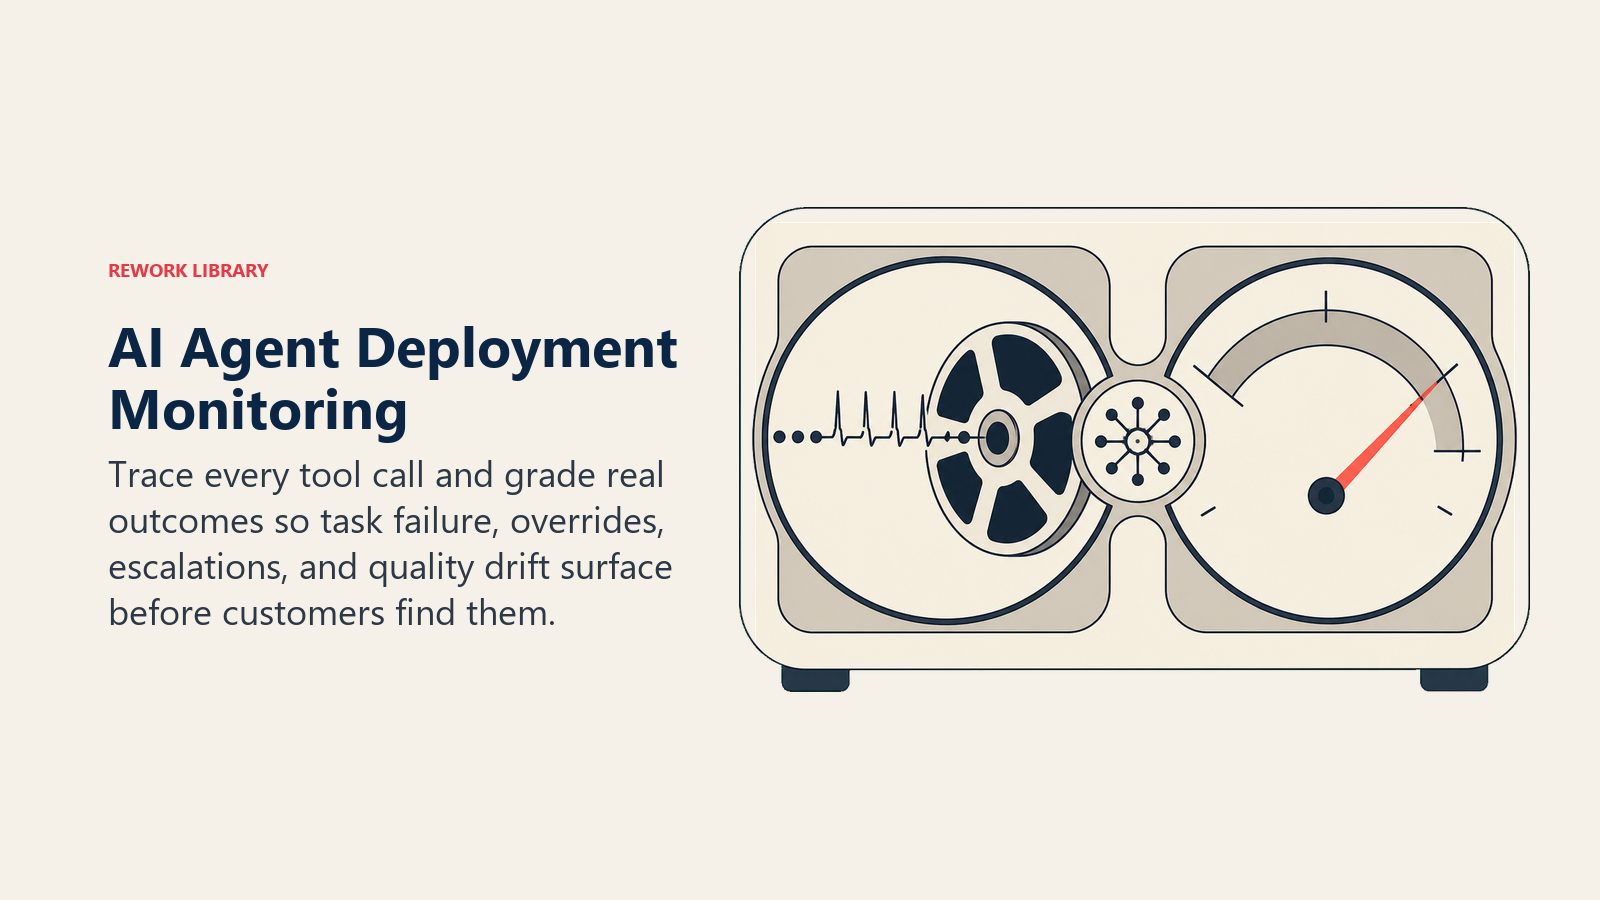
Es gibt eine echte Lücke zwischen der Zahl der Teams, die Agents überwachen, und der Zahl der Teams, die sie fortlaufend ordentlich evaluieren. Die Umfrage von LangChain unter Agent-Entwicklern 2025 ergab, dass 89 % der Organisationen irgendeine Form von Observability eingeführt haben, aber nur 52,4 % regelmäßig Offline-Evaluierungen und 37,3 % regelmäßig Online-Evaluierungen durchführen. Einen Agent zu beobachten und sorgfältig zu bewerten, was er tut, ist nicht dasselbe, und Letzteres fängt Qualitätsdrift ab, bevor ein Kunde sie bemerkt. Dieselbe Umfrage ergab, dass die Ausgabequalität mit 33 % der Nennungen die größte einzelne Hürde beim Deployment ist, vor Sicherheit mit 24,9 % und Latenz mit 20 %. Das ist ein nützlicher Realitätscheck gegen den Impuls, zu früh in Infrastruktur zu investieren, bevor die eigentlichen Entscheidungen des Agents vertrauenswürdig sind.
Hier werden auch MLOps und Model Monitoring unmittelbar relevant: Das Deployment eines Agents erbt dieselbe Produktionsdisziplin wie jedes Live-Modell, dazu die zusätzliche Komplexität eines mehrstufigen Loops mit Tool-Aufrufen statt einer einzelnen Vorhersage.
Stufe 4: Einen Rollback-Pfad haben, bevor Sie ihn brauchen
Legen Sie Ihre Rollback-Auslöser vor dem Launch fest, nicht mitten in einem Incident. Wählen Sie die zwei oder drei Zahlen, die Ihnen sagen würden, dass etwas nicht stimmt, etwa ein Rückgang der Task-Erfolgsquote, ein Anstieg der Quote menschlicher Eingriffe oder ein Sprung bei den Eskalationen. Entscheiden Sie im Voraus, was passiert, wenn eine davon eine Schwelle überschreitet: Geht der Traffic auf die vorherige Agent-Version zurück, fällt er auf rein menschliche Bearbeitung zurück oder pausiert alles, bis jemand es prüft?
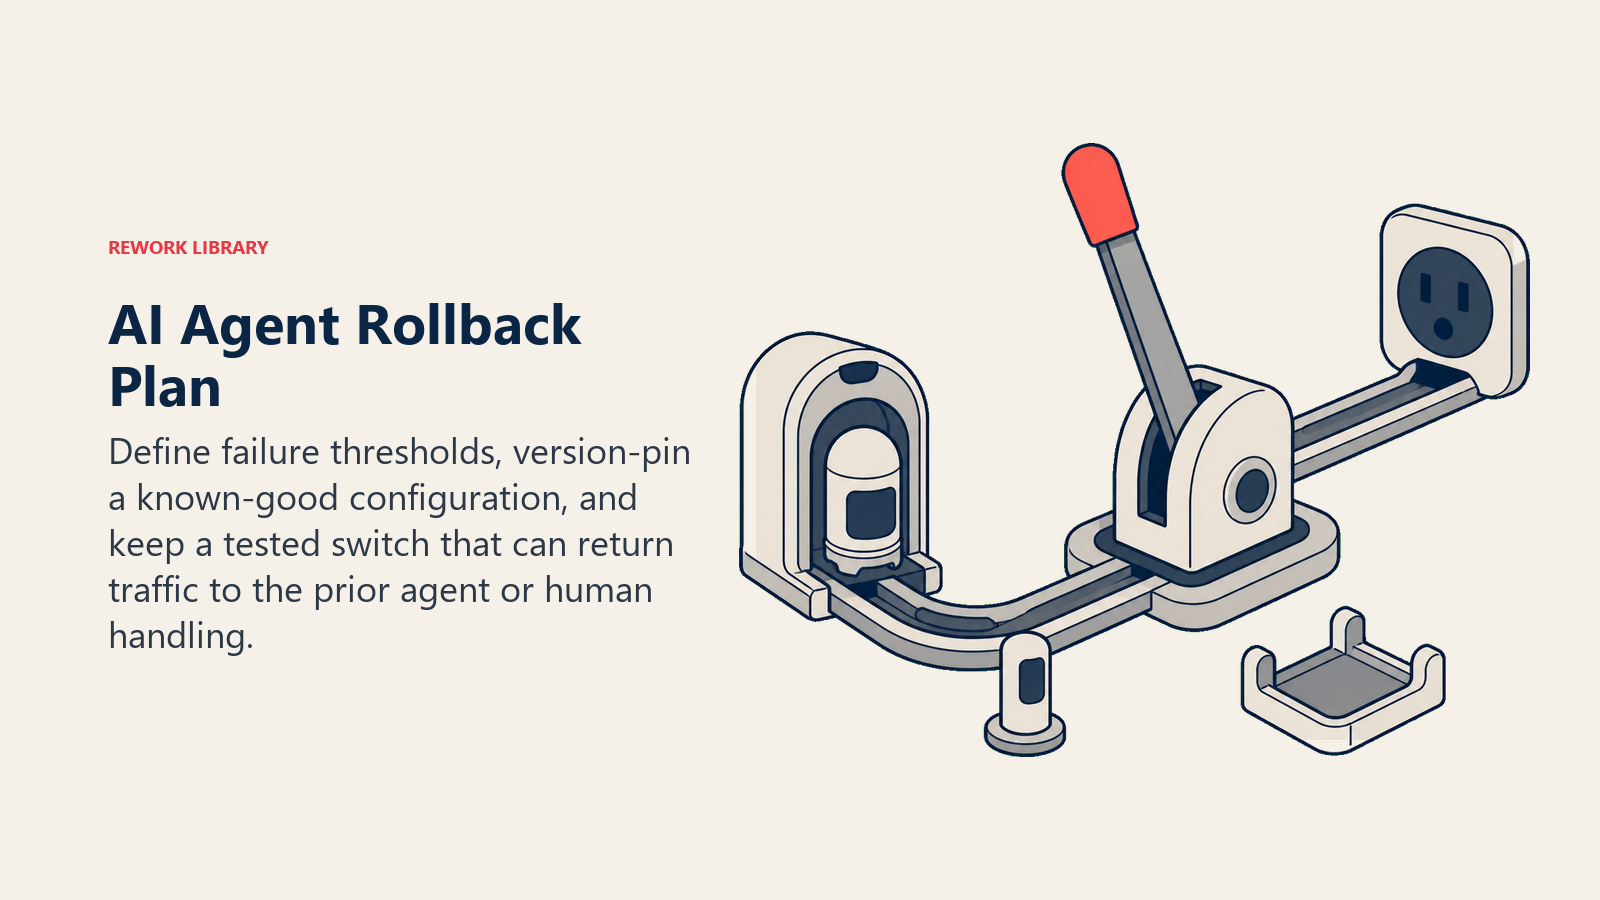
Praktisch heißt das, Prompts, Tools und Konfiguration des Agents genauso zu versionieren und festzuschreiben wie Anwendungscode, sodass „Rollback“ bedeutet, auf eine bewährte Konfiguration umzuschalten, statt sich zu erinnern, was sich geändert hat. Ein Feature Flag oder ein einfacher Mechanismus zur Traffic-Aufteilung, der Volumen sofort vom Agent abziehen kann, sollte vor dem Launch gebaut werden, nicht erst, nachdem der erste schlimme Incident die Notwendigkeit beweist. Dieses Stadium zu überstürzen ist genau die Abkürzung, die später als AI Technical Debt auftaucht: Die Kosten fehlender Rollback-Planung verschwinden nicht, sie verlagern sich nur nach hinten und werden teurer.
Guardrails, behandelt in AI Agent Guardrails, und die harten Grenzen aus AI Agent Security leisten die laufende Arbeit, einzelne schlechte Aktionen abzufangen. Rollback ist der getrennte, gröbere Hebel für den Fall, dass das ganze Deployment stoppen muss, nicht nur ein einzelner Aufruf.
Eine Rollout-Checkliste, bevor Sie den Schalter umlegen
- Ein Testset aus realen historischen Fällen, mit definierter Kennzahl für den Task-Erfolg
- Eine abgeschlossene Phase im Shadow Mode oder mit begrenztem Traffic, deren Ergebnisse ein Mensch geprüft hat
- Menschliche Freigabe-Gates bei jeder Aktion, die finanziell, unumkehrbar oder im großen Maßstab kundenwirksam ist
- Tracing und Logging für jeden Tool-Aufruf, nicht nur für die finale Ausgabe
- Ein definierter Rollback-Auslöser und ein schneller, getesteter Weg, ihn auszuführen
- Eine verantwortliche Person, die den Agent nach dem Launch beobachtet, nicht nur ihn baut
Wer den Rollout freigibt
Ein Produktions-Agent, der echte Entscheidungen trifft, braucht einen Verantwortlichen über die Person hinaus, die ihn gebaut hat: jemanden, der für den Rollout-Plan, das Monitoring und die Entscheidung über den Rollback geradesteht. Das ist ebenso eine Governance-Frage wie eine technische, und es lohnt sich, sie ausdrücklich zu klären statt per Voreinstellung. AI Change Management behandelt die Akzeptanzseite davon, nämlich dass die Menschen, die neben dem Agent arbeiten, ihm tatsächlich vertrauen und ihn richtig nutzen, und Governance nach Muster behandelt, wie sich Governance-Anforderungen je nach zugrunde liegendem AI-Muster des Agents verschieben.
Key Facts
- Die NANDA-Initiative des MIT stellte fest, dass 95 % der generativen AI-Pilotprojekte in Unternehmen 2025 keinen messbaren ROI lieferten, eine Lücke, die der Bericht fehlender operativer Disziplin zuschreibt, nicht der Modellqualität.
- Gartner prognostiziert, dass über 40 % der Agentic-AI-Projekte bis Ende 2027 eingestellt werden, getrieben von steigenden Kosten, unklarem Geschäftsnutzen und unzureichenden Risikokontrollen, allesamt Deployment-Probleme statt Modellprobleme.
- Ein gestaffelter Rollout (Shadow Mode, begrenzter und menschlich freigegebener Traffic, risikoabgesicherter voller Traffic, voller Rollout) fängt Probleme ab, solange der Schadensradius noch klein ist.
- Die Umfrage von LangChain 2025 ergab, dass 89 % der Organisationen irgendeine Observability eingeführt haben, aber nur 52,4 % regelmäßig Offline-Evaluierungen und 37,3 % regelmäßig Online-Evaluierungen durchführen, eine echte Lücke zwischen dem Beobachten eines Agents und seiner sorgfältigen Bewertung.
- Legen Sie Rollback-Auslöser und -Mechanismen vor dem Launch fest. Schreiben Sie die Konfiguration des Agents versioniert fest, sodass ein Zurückgehen bedeutet, auf einen bewährten Zustand umzuschalten, statt während eines Incidents zu rekonstruieren, was sich geändert hat.
Wie es weitergeht
Ein Produktions-Agent ist kein abgeschlossenes Projekt, sondern ein System, das dieselbe laufende Aufmerksamkeit braucht wie jede andere Live-Infrastruktur. AI Agent Observability geht tiefer darauf ein, was Sie nach dem Go-live tracen und messen sollten, und AI Agent Guardrails behandelt die harten Grenzen, die unabhängig von der Sorgfalt Ihres Rollouts halten sollten. Wenn Sie Plattformen mit eingebautem Produktions-Tooling mit solchen vergleichen, die Sie selbst instrumentieren müssen, sind die Übersicht Dev- und IT-Tools und der Kaufleitfaden für DevOps-Plattformen sinnvolle nächste Stationen.

On this page
- Warum „Im Demo hat es funktioniert“ nicht reicht
- Stufe 1: An realen Fällen testen, nicht an erfundenen
- Stufe 2: Schrittweise ausrollen
- Stufe 3: Überwachen, was ein Scheitern tatsächlich vorhersagt
- Stufe 4: Einen Rollback-Pfad haben, bevor Sie ihn brauchen
- Eine Rollout-Checkliste, bevor Sie den Schalter umlegen
- Wer den Rollout freigibt
- Key Facts
- Wie es weitergeht