Descrição de Cargo de MLOps Engineer (Modelo + Habilidades)
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Uma descrição de cargo de MLOps Engineer bem elaborada é a diferença entre atrair candidatos que realmente conseguem colocar sistemas de ML em produção e aqueles que só treinaram modelos em notebooks Jupyter. MLOps é uma disciplina que fica na interseção entre machine learning, engenharia de software e operações de infraestrutura, e ainda é jovem o suficiente para que muitas equipes de contratação escrevam descrições vagas que atraem os candidatos errados.
Este guia traz um modelo completo, uma divisão clara de habilidades, referências salariais e uma comparação de cargos relacionados para que sua equipe contrate a pessoa certa logo na primeira vez.
O que um MLOps Engineer faz?
Um MLOps Engineer é responsável pelo lado operacional do machine learning. Enquanto os cientistas de dados se concentram em construir e aprimorar modelos, os MLOps Engineers garantem que esses modelos realmente funcionem de forma confiável em produção: são implantados no prazo, têm desempenho consistente, escalam sob carga e podem ser atualizados ou revertidos sem incidentes.
A disciplina toma emprestado tanto da engenharia DevOps quanto da engenharia de ML tradicional. Do DevOps, ela aproveita pipelines de CI/CD, infrastructure-as-code e práticas de observability. Do ML, ela aproveita o entendimento de fluxos de treinamento, feature engineering, versionamento de modelos e as peculiaridades estatísticas (como o data drift) que fazem os sistemas de ML falharem de maneiras que o software comum não falha.
Um MLOps Engineer sênior costuma cuidar de todo o ciclo de vida do modelo: desde o momento em que um cientista de dados entrega um modelo treinado, passando por containerização, testes automatizados, implantação em estágios, monitoramento em produção, gatilhos de retreinamento, até a eventual descontinuação. Em equipes menores, ele também pode construir e manter o feature store e a infraestrutura de rastreamento de experimentos que os cientistas de dados usam a montante.
Principais Dados
- MLOps está entre as especializações que mais crescem na engenharia de IA, com as vagas praticamente triplicando entre 2021 e 2024, à medida que as empresas migraram da experimentação com ML para a implantação em produção em grande escala (LinkedIn Workforce Report, 2024).
- A maioria dos projetos de ML corporativos não chega à produção, e as lacunas de infraestrutura e operacionalização são apontadas como a principal causa. Os cargos de MLOps existem justamente para fechar essa lacuna (Gartner, 2023).
- A remuneração total mediana para MLOps Engineers de nível pleno nos EUA varia de aproximadamente $145.000 a $185.000, dependendo da localização e do stack, com cargos seniores em grandes empresas de tecnologia ultrapassando bem os $200.000 (Levels.fyi, 2025).
Responsabilidades do MLOps Engineer
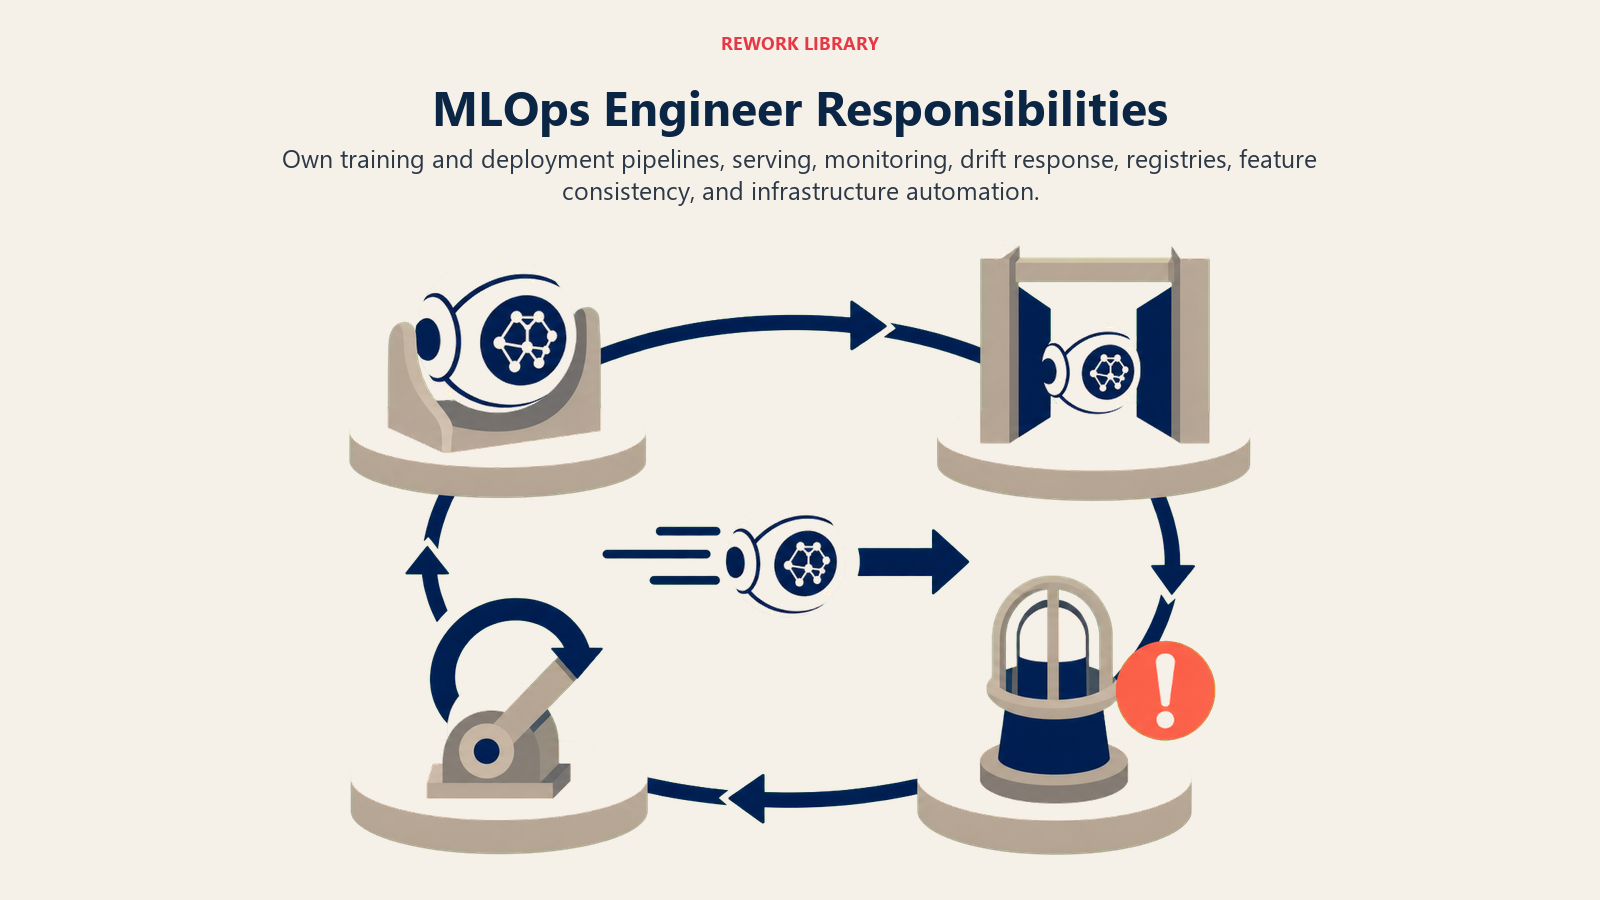
Responsável pelos pipelines de treinamento e implantação, serving, monitoramento, resposta a drift, registries, consistência de features e automação de infraestrutura.
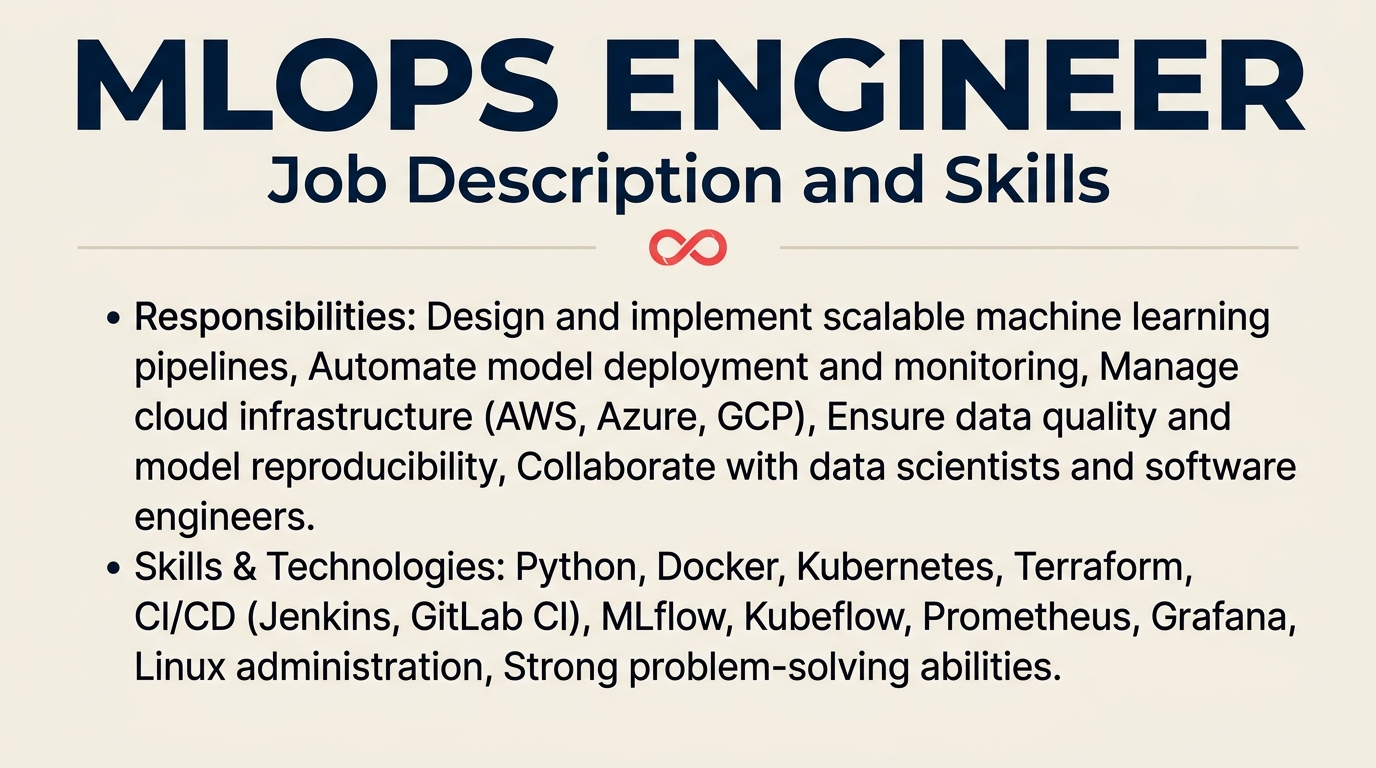
- Construir e manter pipelines de CI/CD projetados especificamente para fluxos de trabalho de ML, incluindo treinamento automatizado de modelos, gates de avaliação e rollouts em estágios.
- Implantar modelos em produção usando containerização (Docker) e orquestração (Kubernetes), e gerenciar a infraestrutura de serving tanto para inferência em batch quanto em tempo real.
- Monitorar modelos em produção quanto à degradação de acurácia, data drift e concept drift. Configurar alertas e pipelines de retreinamento automatizado quando o desempenho cair abaixo dos limites definidos.
- Projetar e operar feature stores para garantir o cálculo consistente e reproduzível de features entre os ambientes de treinamento e serving.
- Gerenciar registries de modelos e sistemas de versionamento (MLflow, Weights and Biases, ou equivalente) para que as equipes possam reproduzir qualquer estado anterior de um modelo e comparar resultados de experimentos.
- Escrever infrastructure-as-code (Terraform, Pulumi ou IaC nativo de nuvem) para provisionar e gerenciar clusters de treinamento de ML, endpoints de serving e pipelines de dados.
- Colaborar com cientistas de dados para revisar o código do modelo quanto à prontidão para produção: consumo de memória, perfil de latência, tratamento de erros e logging.
- Trabalhar em conjunto com data engineers para garantir que os pipelines de dados de treinamento sejam confiáveis, versionados e auditáveis.
- Definir e fazer cumprir SLAs para o serving de modelos: uptime, percentis de latência e metas de throughput.
- Liderar a resposta a incidentes em problemas de produção relacionados a ML, incluindo rollbacks, shadow deployments e configurações de testes A/B.
Requisitos e qualificações
Procure por Python em produção, orquestração de ML, containers, infraestrutura de nuvem, CI/CD, observability e depuração colaborativa.
Habilidades e experiência obrigatórias
- 3 ou mais anos de experiência em engenharia de software, com pelo menos 2 anos trabalhando com sistemas de ML em produção.
- Fortes habilidades em Python. Você vai escrever código de produção, não apenas scripts.
- Experiência prática com pelo menos uma grande ferramenta de orquestração de ML: Kubeflow, MLflow, Metaflow, Airflow para fluxos de ML, ou Vertex AI Pipelines.
- Proficiência em containers e orquestração: Docker para empacotamento, Kubernetes para implantação e escalonamento.
- Experiência com plataformas de nuvem: AWS (SageMaker, EKS, S3), Google Cloud (Vertex AI, GKE) ou Azure (Azure ML, AKS). Experiência multi-cloud é um diferencial.
- Entendimento dos princípios de CI/CD e experiência em adaptá-los a fluxos de trabalho específicos de ML (versionamento de datasets, avaliação de modelos como gate de pipeline, etc.).
- Familiaridade com ferramentas de observability: Prometheus, Grafana ou equivalentes nativos de nuvem para acompanhar métricas de desempenho de modelos junto com métricas de infraestrutura.
- Bom domínio de conceitos de sistemas distribuídos relevantes para o serving de ML: load balancing, escalonamento horizontal, caching e orçamentos de latência.
Diferenciais
- Experiência com gerenciamento de clusters de GPU para cargas de trabalho de treinamento.
- Conhecimento de plataformas de feature store (Feast, Tecton ou equivalentes nativos de nuvem).
- Experiência com data engineering: Spark, dbt ou pipelines de streaming (Kafka, Pub/Sub).
- Familiaridade com práticas de IA responsável: model cards, auditoria de vieses, ferramentas de explicabilidade.
- Experiência anterior com implantação e serving de LLM (vLLM, TGI ou frameworks de inferência similares).
- Contribuições para ferramentas de MLOps open-source.
Formação
A maioria das equipes aceita graduação em Ciência da Computação, Engenharia de Software ou área correlata. Experiência prática equivalente trabalhando com sistemas de ML em produção é igualmente valorizada. Ainda não existe um caminho de certificação padrão para MLOps, embora certificações de ML em nuvem (AWS ML Specialty, Google Professional ML Engineer) sejam sinais úteis.
Modelo de descrição de cargo de MLOps Engineer
Resumo do cargo
A [nome da empresa] está contratando um MLOps Engineer para levar nossos modelos de machine learning da experimentação a sistemas de produção confiáveis. Você vai trabalhar ao lado de cientistas de dados e engenheiros de plataforma para construir os pipelines, a infraestrutura e as ferramentas que mantêm nossos modelos funcionando com precisão em escala. Este é um cargo técnico prático, com responsabilidade real sobre sistemas em produção.
Principais responsabilidades
- Projetar, construir e manter pipelines de CI/CD para treinamento, avaliação e implantação de modelos de ML.
- Implantar e disponibilizar modelos usando Docker, Kubernetes e infraestrutura de serving gerenciada em nuvem.
- Monitorar modelos em produção quanto a data drift, prediction drift e degradação no serving. Automatizar fluxos de retreinamento e alertas.
- Gerenciar o registry de modelos e o sistema de rastreamento de experimentos para que as equipes possam reproduzir, comparar e auditar versões de modelos.
- Desenvolver e manter a infraestrutura de feature store para o cálculo consistente de features entre treinamento e serving.
- Escrever infrastructure-as-code para os ambientes de treinamento e serving de ML.
- Apoiar os cientistas de dados na produtização de modelos de pesquisa: revisando código, definindo interfaces e configurando logging.
- Responder e liderar a resolução de incidentes de produção relacionados a ML.
Qualificações necessárias
- 3 ou mais anos de experiência em engenharia de software, incluindo 2 ou mais anos com sistemas de ML em produção.
- Proficiência em Python para código de nível de produção.
- Experiência com orquestração de ML: Kubeflow, MLflow, Metaflow, Airflow ou equivalente.
- Experiência com containers: Docker e Kubernetes.
- Experiência com plataformas de nuvem: AWS, GCP ou serviços de ML da Azure.
- Fundamentos de CI/CD aplicados a fluxos de trabalho de ML.
- Experiência com ferramentas de observability e monitoramento.
Qualificações desejáveis
- Experiência com clusters de GPU ou treinamento distribuído.
- Experiência com plataformas de feature store (Feast, Tecton).
- Experiência com data engineering (Spark, dbt, streaming).
- Experiência com serving de LLM (vLLM, TGI ou similar).
- Certificação de ML em nuvem.
O que oferecemos
- [Faixa salarial: $X a $Y dependendo da experiência e da localização]
- Participação em equity
- Modelos de trabalho remoto/híbrido
- Orçamento de aprendizado e desenvolvimento para certificações e conferências
- Acesso a infraestrutura de ML de ponta e parcerias de pesquisa
Salário e perspectivas de carreira
O mercado de MLOps ainda está amadurecendo, então as faixas salariais variam bastante de acordo com o tamanho da empresa, a localização, a complexidade do stack e o quanto o cargo se sobrepõe à engenharia de plataforma.
| Nível | Faixa típica (EUA, 2025) |
|---|---|
| Júnior (0-2 anos) | $110.000 a $140.000 |
| Pleno (2-4 anos) | $145.000 a $185.000 |
| Sênior (5+ anos) | $185.000 a $230.000 |
| Staff / Principal | $220.000 a $280.000+ |
| As faixas incluem salário-base e excluem equity. Fonte: Levels.fyi e pesquisas de mercado, 2025. |
A progressão de carreira a partir de um cargo de MLOps costuma se ramificar em duas direções. Um caminho leva à engenharia de machine learning propriamente dita, onde o foco muda para pesquisa e arquitetura de modelos. O outro caminho leva à engenharia de plataforma de ML ou à liderança de infraestrutura, mais próximo de um perfil de site reliability engineer ou cloud engineer, mas especializado em cargas de trabalho de ML. Um pequeno número de profissionais experientes migra para cargos de ML architect, desenhando a estratégia de ML de ponta a ponta para uma organização.
A demanda continua crescendo à medida que mais empresas avançam além da prova de conceito em ML e passam a precisar de rigor operacional. O cargo é especialmente procurado em empresas que rodam vários modelos em produção simultaneamente, onde a implantação e o monitoramento manuais se tornam insustentáveis.
Cargos relacionados e como eles se diferenciam
Gestores de contratação costumam confundir MLOps com cargos adjacentes. Aqui está uma comparação direta para ajudar você a decidir de qual cargo sua equipe realmente precisa.
| Cargo | Foco principal | Contrate quando |
|---|---|---|
| MLOps Engineer | Operações do ciclo de vida de ML: CI/CD para modelos, implantação, monitoramento, detecção de drift, pipelines de retreinamento | Você tem modelos em produção (ou quase lá) e precisa de serving confiável e escalável + saúde contínua do modelo |
| Machine Learning Engineer | Construir e aprimorar modelos de ML; produtizar pesquisa em sistemas reutilizáveis | Você precisa de alguém que consiga tanto construir modelos quanto integrá-los a aplicações, mas ainda não tem infraestrutura de ML dedicada |
| DevOps Engineer | CI/CD de software, automação de infraestrutura, provisionamento de nuvem, próximo de SRE | Você precisa de implantação geral e automação de infraestrutura sem necessidades específicas de ML |
| Data Engineer | Pipelines de dados, armazenamento, transformação e confiabilidade dos dados que alimentam o treinamento de ML | Seu gargalo de ML é a qualidade dos dados e a confiabilidade dos pipelines antes do treinamento do modelo, não a implantação do modelo |
Uma regra prática: se a sua equipe está perguntando "como colocamos esse modelo em produção de forma confiável?", contrate um MLOps Engineer. Se estiver perguntando "como construímos um modelo melhor?", contrate um AI engineer ou machine learning engineer.
FAQ da Descrição de Cargo de MLOps Engineer
Qual é a diferença entre MLOps e DevOps?
DevOps se concentra em pipelines de entrega de software: construir, testar e implantar código. MLOps aplica a mesma lógica a sistemas de machine learning, mas acrescenta preocupações específicas de ML que o CI/CD de software não cobre. Os modelos degradam de maneiras que o código não degrada (data drift, concept drift). O "teste" de modelos exige avaliação estatística, não apenas testes unitários. O retreinamento é uma operação rotineira sem equivalente no software. Um DevOps Engineer pode construir uma infraestrutura excelente, mas normalmente vai precisar de orientação de alguém com conhecimento de ML para lidar corretamente com essas questões.
Os MLOps Engineers precisam saber construir modelos de ML?
Eles não precisam ser pesquisadores de ML, mas precisam ter conhecimento suficiente de ML para trabalhar de forma eficaz com cientistas de dados. Isso significa entender como os modelos são treinados, quais hiperparâmetros importam, como funcionam as métricas de avaliação e o que pode dar errado em produção (mudança na distribuição dos dados, label drift, serving skew). Os melhores MLOps Engineers conseguem revisar o código de um cientista de dados e identificar riscos de produção antes da implantação.
MLOps é o mesmo que engenharia de plataforma de ML?
Eles se sobrepõem de forma significativa, mas não são idênticos. A engenharia de plataforma de ML tende a se concentrar na infraestrutura interna compartilhada: o feature store, o sistema de rastreamento de experimentos, o cluster de treinamento, o registry de modelos. MLOps é mais amplo e costuma incluir a implantação, o monitoramento e os processos operacionais por modelo. Em empresas grandes, são equipes separadas; em empresas menores, uma única pessoa faz os dois.
Quais certificações de nuvem são relevantes para cargos de MLOps?
As mais relevantes são a AWS Certified Machine Learning Specialty, a Google Cloud Professional Machine Learning Engineer e a Azure AI Engineer Associate. Elas cobrem ferramentas de ML específicas de cada nuvem e fluxos de trabalho de MLOps em cada plataforma. São sinais úteis, mas não obrigatórios. A experiência prática com sistemas de ML em produção importa mais para a maioria das equipes de contratação.
Como avaliar candidatos a MLOps durante as entrevistas?
Concentre-se na experiência com produção, não apenas no conhecimento de ML. Peça que descrevam um modelo que implantaram, incluindo como configuraram o monitoramento, o que deu errado depois do lançamento e como lidaram com isso. Perguntas de system design sobre pipelines de serving de modelos, design de feature store e gatilhos de retreinamento revelam como os candidatos pensam operacionalmente. Perguntar sobre a abordagem deles para CI/CD em ML, incluindo como fazem o gate das implantações com base em métricas de desempenho do modelo, é outro sinal confiável.
À medida que os sistemas de ML se tornam centrais para a operação das empresas, as equipes que constroem uma infraestrutura de modelos confiável e escalável terão uma vantagem operacional significativa. Uma descrição de cargo bem escrita é onde essa vantagem começa: ela define quem se candidata, quem é selecionado e se a pessoa contratada realmente consegue fazer o que o cargo exige. Use este modelo como ponto de partida e depois ajuste as especificidades do stack e os marcadores de senioridade para o seu ambiente real.
Para outros recursos de contratação relacionados, veja nossos guias de descrição de cargo para DevOps engineers, data engineers e AI engineers.