Bahasa Indonesia
Deskripsi Pekerjaan MLOps Engineer (Template + Keterampilan)
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Deskripsi pekerjaan MLOps Engineer yang disusun dengan baik adalah pembeda antara menarik kandidat yang benar-benar bisa menghadirkan sistem ML ke produksi dan mereka yang hanya pernah melatih model di Jupyter notebook. MLOps adalah disiplin yang berada di persimpangan antara machine learning, software engineering, dan operasi infrastruktur, dan disiplin ini masih cukup muda sehingga banyak tim perekrutan menulis deskripsi yang samar dan menarik kandidat yang salah.
Panduan ini memberi Anda template lengkap, rincian keterampilan yang jelas, tolok ukur gaji, dan perbandingan peran terkait agar tim Anda bisa merekrut orang yang tepat sejak awal.
Apa yang dilakukan MLOps Engineer?
MLOps Engineer memegang tanggung jawab atas sisi operasional machine learning. Sementara data scientist berfokus pada membangun dan meningkatkan model, MLOps Engineer memastikan model-model tersebut benar-benar bekerja dengan andal di produksi: model di-deploy tepat waktu, berkinerja konsisten, dapat diskalakan di bawah beban, dan bisa diperbarui atau di-rollback tanpa insiden.
Disiplin ini mengambil unsur dari DevOps engineering maupun ML engineering tradisional. Dari DevOps, MLOps mengambil pipeline CI/CD, infrastructure-as-code, dan praktik observability. Dari ML, MLOps mengambil pemahaman tentang alur kerja training, feature engineering, versioning model, dan keunikan statistik (seperti data drift) yang membuat sistem ML gagal dengan cara yang tidak dialami software biasa.
MLOps Engineer senior biasanya menangani seluruh siklus hidup model: mulai dari saat data scientist menyerahkan model yang sudah dilatih, melalui containerization, pengujian otomatis, deployment bertahap, pemantauan produksi, pemicu retraining, hingga akhirnya deprecation. Di tim yang lebih kecil, mereka juga bisa membangun dan memelihara feature store serta infrastruktur experiment tracking yang digunakan data scientist di tahap awal.
Fakta Kunci
- MLOps termasuk salah satu spesialisasi dengan pertumbuhan tercepat dalam AI engineering, dengan lowongan pekerjaan yang kira-kira bertiga lipat antara 2021 dan 2024 seiring perusahaan beralih dari eksperimentasi ML ke deployment produksi berskala besar (LinkedIn Workforce Report, 2024).
- Sebagian besar proyek ML di perusahaan gagal mencapai tahap produksi, dengan kesenjangan infrastruktur dan operasionalisasi disebut sebagai penyebab utama. Peran MLOps ada khusus untuk menutup kesenjangan ini (Gartner, 2023).
- Median kompensasi total untuk MLOps Engineer level menengah di AS berkisar antara $145.000 hingga $185.000 tergantung lokasi dan stack teknologi, dengan peran senior di perusahaan teknologi besar mencapai lebih dari $200.000 (Levels.fyi, 2025).
Tanggung jawab MLOps Engineer
Bertanggung jawab atas pipeline training dan deployment, serving, pemantauan, respons drift, registry, konsistensi feature, dan otomatisasi infrastruktur.
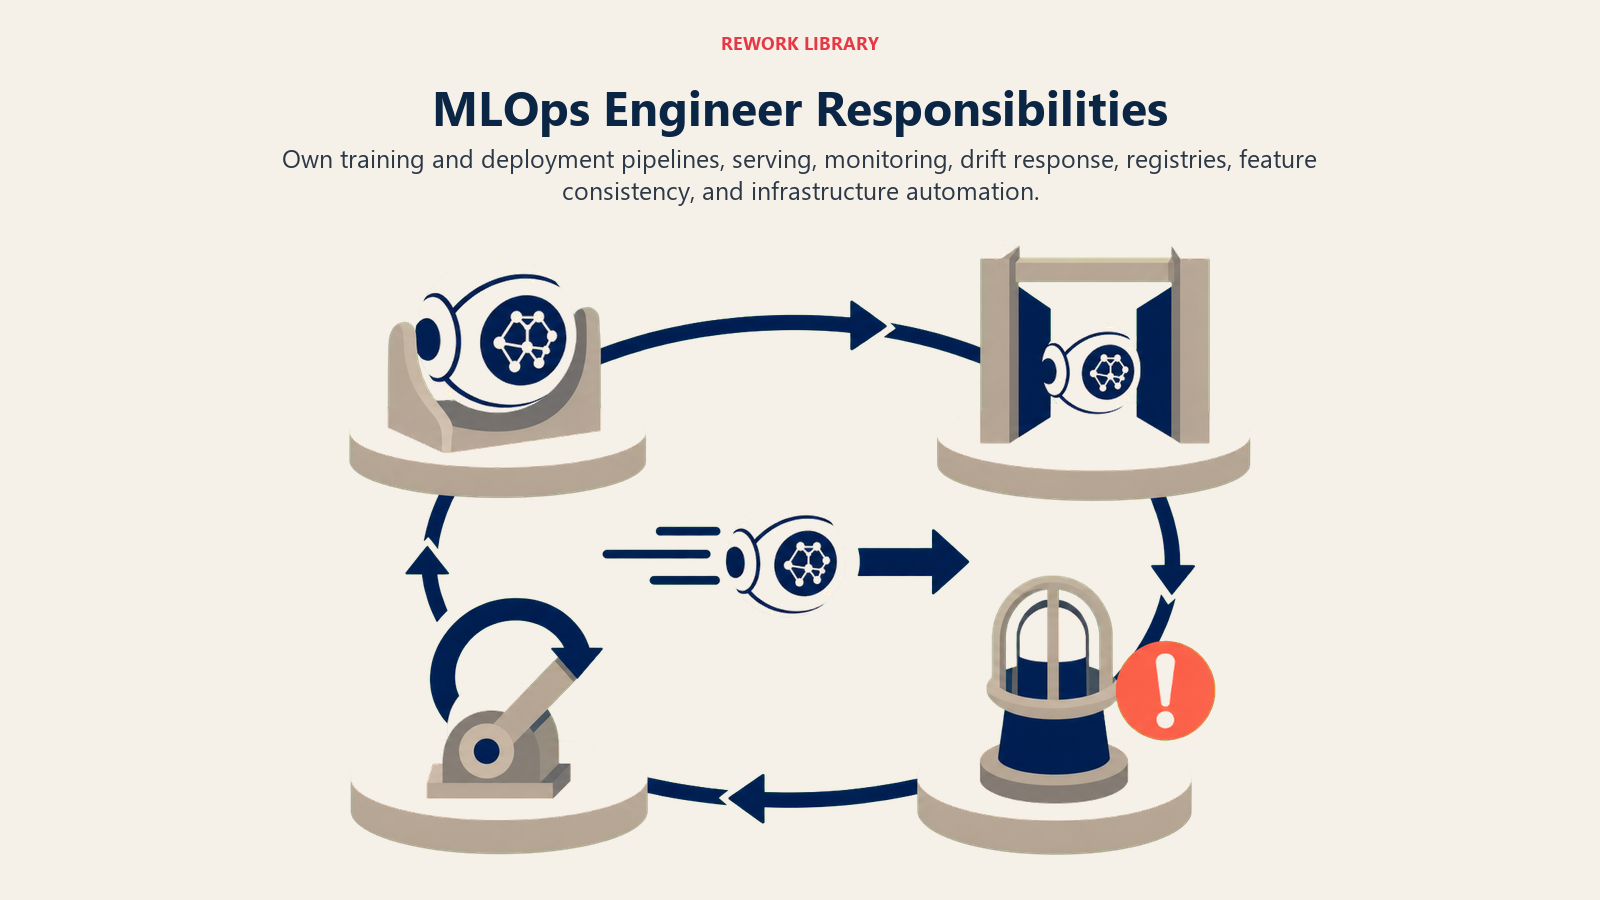
- Membangun dan memelihara pipeline CI/CD yang dirancang khusus untuk alur kerja ML, termasuk training model otomatis, evaluation gate, dan staged rollout.
- Melakukan deploy model ke produksi menggunakan containerization (Docker) dan orchestration (Kubernetes), serta mengelola infrastruktur serving untuk inference batch maupun real-time.
- Memantau model yang berjalan untuk mendeteksi penurunan akurasi, data drift, dan concept drift. Menyiapkan alerting dan pipeline retraining otomatis saat performa turun di bawah ambang batas yang ditentukan.
- Merancang dan mengoperasikan feature store untuk memastikan komputasi feature yang konsisten dan dapat direproduksi antara lingkungan training dan serving.
- Mengelola model registry dan sistem versioning (MLflow, Weights and Biases, atau setara) sehingga tim bisa mereproduksi kondisi model di masa lalu dan membandingkan hasil eksperimen.
- Menulis infrastructure-as-code (Terraform, Pulumi, atau IaC cloud-native) untuk menyediakan dan mengelola cluster training ML, endpoint serving, dan pipeline data.
- Berkolaborasi dengan data scientist untuk meninjau kode model demi kesiapan produksi: memory footprint, profil latensi, error handling, dan logging.
- Bermitra dengan data engineer untuk memastikan pipeline data training andal, memiliki versioning, dan dapat diaudit.
- Menentukan dan menegakkan SLA untuk serving model: uptime, persentil latensi, dan target throughput.
- Memimpin respons insiden untuk masalah produksi terkait ML, termasuk rollback, shadow deployment, dan penyiapan A/B testing.
Persyaratan dan kualifikasi
Carilah kandidat dengan kemampuan Python tingkat produksi, ML orchestration, container, infrastruktur cloud, CI/CD, observability, dan debugging kolaboratif.
Keterampilan dan pengalaman wajib
- 3+ tahun pengalaman software engineering, dengan minimal 2 tahun bekerja pada sistem ML di produksi.
- Kemampuan Python yang kuat. Anda akan menulis kode tingkat produksi, bukan sekadar skrip.
- Pengalaman langsung dengan minimal satu tool ML orchestration utama: Kubeflow, MLflow, Metaflow, Airflow untuk alur kerja ML, atau Vertex AI Pipelines.
- Kemahiran container dan orchestration: Docker untuk packaging, Kubernetes untuk deployment dan scaling.
- Pengalaman platform cloud: AWS (SageMaker, EKS, S3), Google Cloud (Vertex AI, GKE), atau Azure (Azure ML, AKS). Pengalaman multi-cloud menjadi nilai tambah.
- Pemahaman tentang prinsip CI/CD dan pengalaman mengadaptasinya ke alur kerja spesifik ML (versioning dataset, evaluasi model sebagai pipeline gate, dan lain-lain).
- Familiar dengan tooling observability: Prometheus, Grafana, atau setara cloud-native untuk melacak metrik performa model bersamaan dengan metrik infrastruktur.
- Pemahaman kuat tentang konsep distributed systems yang relevan untuk ML serving: load balancing, horizontal scaling, caching, dan latency budget.
Nilai tambah
- Pengalaman mengelola GPU cluster untuk beban kerja training.
- Pengetahuan tentang platform feature store (Feast, Tecton, atau setara cloud-native).
- Latar belakang data engineering: Spark, dbt, atau pipeline streaming (Kafka, Pub/Sub).
- Familiar dengan praktik responsible AI: model card, audit bias, tool explainability.
- Pengalaman sebelumnya dengan deployment dan serving LLM (vLLM, TGI, atau framework inference serupa).
- Kontribusi pada tooling MLOps open-source.
Pendidikan
Sebagian besar tim menerima gelar Sarjana di bidang Computer Science, Software Engineering, atau bidang terkait. Pengalaman praktis yang setara dalam bekerja pada sistem ML produksi juga sama dihargainya. Belum ada jalur sertifikasi standar untuk MLOps, meski sertifikasi ML cloud (AWS ML Specialty, Google Professional ML Engineer) menjadi sinyal yang berguna.
Template deskripsi pekerjaan MLOps Engineer
Ringkasan peran
[Nama perusahaan] sedang mencari MLOps Engineer untuk membawa model machine learning kami dari tahap eksperimen menjadi sistem produksi yang andal. Anda akan bekerja bersama data scientist dan platform engineer untuk membangun pipeline, infrastruktur, dan tooling yang membuat model kami tetap berjalan akurat dalam skala besar. Ini adalah peran teknis yang hands-on dengan kepemilikan nyata atas sistem produksi.
Tanggung jawab utama
- Merancang, membangun, dan memelihara pipeline CI/CD untuk training, evaluasi, dan deployment model ML.
- Melakukan deploy dan serving model menggunakan Docker, Kubernetes, dan infrastruktur serving yang dikelola cloud.
- Memantau model produksi untuk data drift, prediction drift, dan penurunan serving. Mengotomatiskan alur kerja retraining dan alert.
- Mengelola model registry dan sistem experiment tracking sehingga tim bisa mereproduksi, membandingkan, dan mengaudit versi model.
- Mengembangkan dan memelihara infrastruktur feature store untuk komputasi feature yang konsisten di training dan serving.
- Menulis infrastructure-as-code untuk lingkungan training dan serving ML.
- Mendukung data scientist dalam melakukan productionizing model riset: meninjau kode, mendefinisikan interface, dan menyiapkan logging.
- Merespons dan memimpin penyelesaian insiden produksi ML.
Kualifikasi yang dibutuhkan
- 3+ tahun pengalaman software engineering, termasuk 2+ tahun dengan sistem ML produksi.
- Mahir Python untuk kode tingkat produksi.
- Pengalaman dengan ML orchestration: Kubeflow, MLflow, Metaflow, Airflow, atau setara.
- Pengalaman container: Docker dan Kubernetes.
- Pengalaman platform cloud: AWS, GCP, atau layanan Azure ML.
- Dasar-dasar CI/CD yang diterapkan pada alur kerja ML.
- Pengalaman tooling observability dan monitoring.
Kualifikasi yang diutamakan
- Pengalaman GPU cluster atau distributed training.
- Pengalaman platform feature store (Feast, Tecton).
- Latar belakang data engineering (Spark, dbt, streaming).
- Pengalaman serving LLM (vLLM, TGI, atau serupa).
- Sertifikasi ML cloud.
Yang kami tawarkan
- [Kisaran gaji: $X hingga $Y tergantung pengalaman dan lokasi]
- Partisipasi ekuitas
- Pengaturan kerja remote/hybrid
- Anggaran pembelajaran dan pengembangan untuk sertifikasi dan konferensi
- Akses ke infrastruktur ML mutakhir dan kemitraan riset
Gaji dan prospek karier
Pasar MLOps masih dalam tahap pematangan, sehingga kisaran gaji bervariasi luas berdasarkan ukuran perusahaan, lokasi, kompleksitas stack, dan seberapa besar peran ini bertumpang tindih dengan platform engineering.
| Level | Kisaran umum (AS, 2025) |
|---|---|
| Junior (0-2 tahun) | $110.000 hingga $140.000 |
| Menengah (2-4 tahun) | $145.000 hingga $185.000 |
| Senior (5+ tahun) | $185.000 hingga $230.000 |
| Staff / Principal | $220.000 hingga $280.000+ |
| Kisaran mencakup gaji pokok dan tidak termasuk ekuitas. Sumber: Levels.fyi dan survei industri, 2025. |
Perkembangan karier dari peran MLOps biasanya bercabang ke dua arah. Satu jalur menuju ke machine learning engineering yang sesungguhnya, di mana fokusnya bergeser ke riset dan arsitektur model. Jalur lainnya menuju ke ML platform engineering atau kepemimpinan infrastruktur, lebih dekat dengan latar belakang site reliability engineer atau cloud engineer tetapi terspesialisasi untuk beban kerja ML. Sejumlah kecil praktisi berpengalaman beralih ke peran ML architect, merancang strategi ML end-to-end untuk sebuah organisasi.
Permintaan terus tumbuh seiring semakin banyak perusahaan yang melewati tahap proof-of-concept ML dan membutuhkan kedisiplinan operasional. Peran ini sangat dicari di perusahaan yang menjalankan banyak model secara bersamaan di produksi, di mana deployment dan pemantauan manual menjadi tidak berkelanjutan.
Peran terkait dan perbedaannya
Hiring manager sering keliru membedakan MLOps dengan peran-peran yang berdekatan. Berikut perbandingan langsung untuk membantu Anda memutuskan peran mana yang benar-benar dibutuhkan tim Anda.
| Role | Fokus utama | Rekrut saat |
|---|---|---|
| MLOps Engineer | Operasi siklus hidup ML: CI/CD untuk model, deployment, pemantauan, deteksi drift, pipeline retraining | Anda sudah memiliki model di produksi (atau hampir) dan butuh serving yang andal, dapat diskalakan, plus kesehatan model yang berkelanjutan |
| Machine Learning Engineer | Membangun dan meningkatkan model ML; melakukan productionizing riset menjadi sistem yang dapat digunakan kembali | Anda butuh seseorang yang bisa membangun model sekaligus mengintegrasikannya ke aplikasi, tetapi belum punya infrastruktur ML khusus |
| DevOps Engineer | CI/CD software, otomatisasi infrastruktur, provisioning cloud, berdekatan dengan SRE | Anda butuh deployment umum dan otomatisasi infrastruktur tanpa kebutuhan spesifik ML |
| Data Engineer | Pipeline data, penyimpanan, transformasi, dan keandalan data yang mengalir ke training ML | Bottleneck ML Anda ada pada kualitas data dan keandalan pipeline di hulu training model, bukan pada deployment model |
Satu aturan praktis: jika tim Anda bertanya "bagaimana cara membawa model ini ke produksi secara andal?", rekrutlah MLOps Engineer. Jika mereka bertanya "bagaimana cara membangun model yang lebih baik?", rekrutlah AI engineer atau machine learning engineer.
Pertanyaan yang Sering Diajukan tentang Deskripsi Pekerjaan MLOps Engineer
Apa perbedaan antara MLOps dan DevOps?
DevOps berfokus pada pipeline pengiriman software: membangun, menguji, dan men-deploy kode. MLOps menerapkan pemikiran yang sama pada sistem machine learning, tetapi menambahkan perhatian khusus ML yang tidak dicakup oleh CI/CD software biasa. Model mengalami degradasi dengan cara yang tidak dialami kode (data drift, concept drift). "Pengujian" model membutuhkan evaluasi statistik, bukan sekadar unit test. Retraining adalah operasi rutin yang tidak memiliki padanan di dunia software. Seorang DevOps Engineer bisa membangun infrastruktur yang sangat baik, tetapi biasanya mereka butuh arahan dari seseorang dengan pengetahuan ML untuk menangani perhatian-perhatian ini dengan benar.
Apakah MLOps Engineer perlu tahu cara membangun model ML?
Mereka tidak perlu menjadi peneliti ML, tetapi mereka butuh pengetahuan ML yang cukup untuk bekerja secara efektif dengan data scientist. Artinya memahami bagaimana model dilatih, hyperparameter apa yang penting, bagaimana metrik evaluasi bekerja, dan apa yang bisa salah di produksi (pergeseran distribusi data, label drift, serving skew). MLOps Engineer terbaik bisa meninjau kode data scientist dan menemukan risiko produksi sebelum deployment.
Apakah MLOps sama dengan ML platform engineering?
Keduanya bertumpang tindih secara signifikan tetapi tidak identik. ML platform engineering cenderung berfokus pada infrastruktur internal bersama: feature store, sistem experiment tracking, cluster training, dan model registry. MLOps lebih luas dan sering mencakup deployment per model, pemantauan, dan proses operasional di sekitar model-model tertentu. Di perusahaan besar, keduanya adalah tim yang terpisah; di perusahaan yang lebih kecil, satu orang mengerjakan keduanya.
Sertifikasi cloud apa yang relevan untuk peran MLOps?
Yang paling relevan adalah AWS Certified Machine Learning Specialty, Google Cloud Professional Machine Learning Engineer, dan Azure AI Engineer Associate. Sertifikasi ini mencakup tooling ML dan alur kerja MLOps khusus untuk masing-masing platform cloud. Sertifikasi ini menjadi sinyal yang berguna tetapi bukan keharusan. Pengalaman praktis dengan sistem ML produksi lebih penting bagi sebagian besar tim perekrutan.
Bagaimana cara mengevaluasi kandidat MLOps saat wawancara?
Fokuslah pada pengalaman produksi, bukan hanya pengetahuan ML. Minta mereka menjelaskan sebuah model yang pernah mereka deploy, termasuk bagaimana mereka menyiapkan pemantauan, apa yang salah setelah peluncuran, dan bagaimana mereka menanganinya. Pertanyaan system design seputar pipeline serving model, desain feature store, dan pemicu retraining mengungkap bagaimana kandidat berpikir secara operasional. Menanyakan pendekatan mereka terhadap CI/CD untuk ML, termasuk bagaimana mereka menerapkan gate deployment berdasarkan metrik performa model, adalah sinyal andal lainnya.
Seiring sistem ML menjadi inti dari cara perusahaan beroperasi, tim yang membangun infrastruktur model yang andal dan dapat diskalakan akan memiliki keunggulan operasional yang signifikan. Deskripsi pekerjaan yang ditulis dengan baik adalah titik awal dari keunggulan itu: deskripsi ini membentuk siapa yang melamar, siapa yang lolos penyaringan, dan apakah orang yang Anda rekrut benar-benar bisa melakukan apa yang dibutuhkan peran tersebut. Gunakan template ini sebagai titik awal, lalu sesuaikan detail stack dan penanda senioritas dengan lingkungan Anda yang sebenarnya.
Untuk sumber daya perekrutan terkait, lihat panduan deskripsi pekerjaan kami untuk DevOps engineer, data engineer, dan AI engineer.
Senior Operations & Growth Strategist