Descripción del Puesto de MLOps Engineer (Plantilla + Habilidades)
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Una descripción del puesto de MLOps Engineer bien elaborada marca la diferencia entre atraer candidatos que realmente pueden poner en producción sistemas de ML y aquellos que solo han entrenado modelos en notebooks de Jupyter. MLOps es una disciplina que se sitúa en la intersección entre machine learning, ingeniería de software y operaciones de infraestructura, y todavía es lo bastante joven como para que muchos equipos de contratación escriban descripciones vagas que atraen a los candidatos equivocados.
Esta guía le ofrece una plantilla completa, un desglose claro de habilidades, referencias salariales y una comparación de roles relacionados para que su equipo contrate a la persona correcta desde el primer intento.
¿Qué hace un MLOps engineer?
Un MLOps engineer es responsable del lado operativo del machine learning. Mientras los data scientists se centran en construir y mejorar modelos, los MLOps engineers se aseguran de que esos modelos funcionen de forma confiable en producción: que se implementen a tiempo, rindan de manera consistente, escalen bajo carga y puedan actualizarse o revertirse sin incidentes.
La disciplina toma prestado tanto de DevOps engineering como de la ingeniería de ML tradicional. De DevOps, toma los pipelines de CI/CD, la infraestructura como código y las prácticas de observabilidad. De ML, toma la comprensión de los flujos de entrenamiento, la ingeniería de features, el versionado de modelos y las particularidades estadísticas (como el data drift) que hacen que los sistemas de ML fallen de formas que el software convencional no experimenta.
Un MLOps engineer senior suele encargarse del ciclo de vida completo del modelo: desde el momento en que un data scientist entrega un modelo entrenado, pasando por la containerización, las pruebas automatizadas, el despliegue por etapas, el monitoreo en producción, los disparadores de reentrenamiento y, finalmente, la desactivación. En equipos más pequeños, también puede construir y mantener el feature store y la infraestructura de seguimiento de experimentos que los data scientists utilizan aguas arriba.
Datos Clave
- MLOps es una de las especializaciones de más rápido crecimiento dentro de la ingeniería de IA: las publicaciones de empleo casi se triplicaron entre 2021 y 2024 a medida que las empresas pasaron de la experimentación con ML al despliegue en producción a gran escala (LinkedIn Workforce Report, 2024).
- La mayoría de los proyectos empresariales de ML no llegan a producción, y las brechas de infraestructura y operacionalización se citan como la causa principal. Los roles de MLOps existen precisamente para cerrar esta brecha (Gartner, 2023).
- La compensación total mediana para MLOps engineers de nivel medio en EE. UU. va desde aproximadamente $145,000 hasta $185,000 según la ubicación y el stack, y los roles senior en grandes empresas tecnológicas superan ampliamente los $200,000 (Levels.fyi, 2025).
Responsabilidades del MLOps engineer
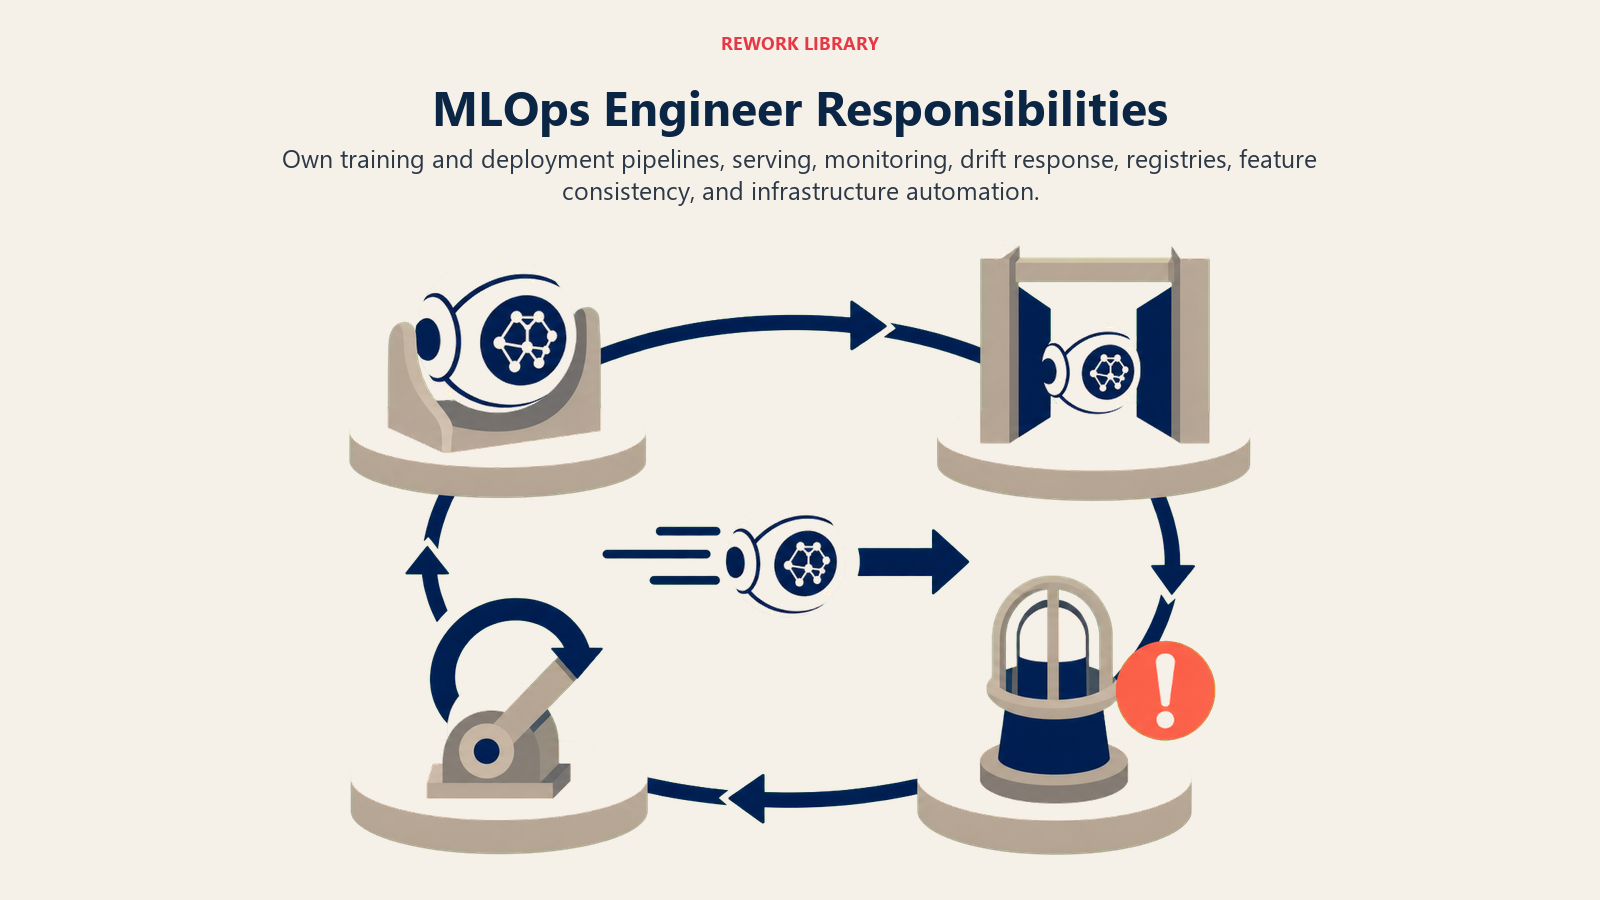
Responsable de los pipelines de entrenamiento y despliegue, el serving, el monitoreo, la respuesta al drift, los registries, la consistencia de features y la automatización de infraestructura.
- Construir y mantener pipelines de CI/CD diseñados específicamente para flujos de trabajo de ML, incluyendo entrenamiento automatizado de modelos, gates de evaluación y despliegues por etapas.
- Implementar modelos en producción usando containerización (Docker) y orquestación (Kubernetes), y gestionar la infraestructura de serving tanto para inferencia por lotes como en tiempo real.
- Monitorear los modelos en producción para detectar degradación de precisión, data drift y concept drift. Configurar alertas y pipelines de reentrenamiento automatizado cuando el rendimiento caiga por debajo de los umbrales definidos.
- Diseñar y operar feature stores para garantizar un cálculo de features consistente y reproducible entre los entornos de entrenamiento y serving.
- Gestionar registries de modelos y sistemas de versionado (MLflow, Weights and Biases, o equivalente) para que los equipos puedan reproducir cualquier estado anterior del modelo y comparar resultados de experimentos.
- Escribir infraestructura como código (Terraform, Pulumi, o IaC nativo de la nube) para aprovisionar y gestionar clusters de entrenamiento de ML, endpoints de serving y pipelines de datos.
- Colaborar con los data scientists para revisar el código de los modelos y evaluar su preparación para producción: huella de memoria, perfil de latencia, manejo de errores y logging.
- Trabajar junto a los data engineers para garantizar que los pipelines de datos de entrenamiento sean confiables, versionados y auditables.
- Definir y hacer cumplir los SLAs para el serving de modelos: uptime, percentiles de latencia y objetivos de throughput.
- Liderar la respuesta a incidentes relacionados con problemas de producción de ML, incluyendo rollbacks, shadow deployments y configuraciones de A/B testing.
Requisitos y calificaciones
Busque experiencia en Python de producción, orquestación de ML, contenedores, infraestructura en la nube, CI/CD, observabilidad y debugging colaborativo.
Habilidades y experiencia indispensables
- Más de 3 años de experiencia en ingeniería de software, con al menos 2 años trabajando en sistemas de ML en producción.
- Sólidas habilidades en Python. Escribirá código de producción, no solo scripts.
- Experiencia práctica con al menos una herramienta importante de orquestación de ML: Kubeflow, MLflow, Metaflow, Airflow para flujos de trabajo de ML, o Vertex AI Pipelines.
- Dominio de contenedores y orquestación: Docker para empaquetado, Kubernetes para despliegue y escalado.
- Experiencia en plataformas cloud: AWS (SageMaker, EKS, S3), Google Cloud (Vertex AI, GKE), o Azure (Azure ML, AKS). La experiencia multi-cloud es un plus.
- Comprensión de los principios de CI/CD y experiencia adaptándolos a flujos de trabajo específicos de ML (versionado de datasets, evaluación de modelos como gate del pipeline, etc.).
- Familiaridad con herramientas de observabilidad: Prometheus, Grafana, o equivalentes nativos de la nube para hacer seguimiento de las métricas de rendimiento del modelo junto con las métricas de infraestructura.
- Sólido entendimiento de los conceptos de sistemas distribuidos relevantes para el serving de ML: balanceo de carga, escalado horizontal, caching y presupuestos de latencia.
Deseable
- Experiencia en la gestión de clusters de GPU para cargas de trabajo de entrenamiento.
- Conocimiento de plataformas de feature store (Feast, Tecton, o equivalentes nativos de la nube).
- Experiencia previa en data engineering: Spark, dbt, o pipelines de streaming (Kafka, Pub/Sub).
- Familiaridad con prácticas de IA responsable: model cards, auditoría de sesgos, herramientas de explicabilidad.
- Experiencia previa con el despliegue y serving de LLMs (vLLM, TGI, u otros frameworks de inferencia similares).
- Contribuciones a herramientas de MLOps de código abierto.
Formación académica
La mayoría de los equipos acepta un título universitario en Ciencias de la Computación, Ingeniería de Software o un campo relacionado. La experiencia práctica equivalente trabajando en sistemas de ML en producción se valora igual de bien. Todavía no existe una ruta de certificación estándar para MLOps, aunque las certificaciones cloud de ML (AWS ML Specialty, Google Professional ML Engineer) son señales útiles.
Plantilla de descripción del puesto de MLOps engineer
Resumen del puesto
[Nombre de la empresa] está contratando a un MLOps Engineer para llevar nuestros modelos de machine learning de la experimentación a sistemas de producción confiables. Trabajará junto a data scientists e ingenieros de plataforma para construir los pipelines, la infraestructura y las herramientas que mantienen nuestros modelos funcionando con precisión a gran escala. Este es un rol técnico práctico con responsabilidad real sobre sistemas de producción.
Responsabilidades clave
- Diseñar, construir y mantener pipelines de CI/CD para el entrenamiento, evaluación y despliegue de modelos de ML.
- Implementar y hacer serving de modelos usando Docker, Kubernetes e infraestructura de serving administrada en la nube.
- Monitorear los modelos en producción para detectar data drift, prediction drift y degradación del serving. Automatizar los flujos de reentrenamiento y alertas.
- Gestionar el model registry y el sistema de seguimiento de experimentos para que los equipos puedan reproducir, comparar y auditar versiones de modelos.
- Desarrollar y mantener la infraestructura del feature store para un cálculo de features consistente entre entrenamiento y serving.
- Escribir infraestructura como código para los entornos de entrenamiento y serving de ML.
- Apoyar a los data scientists en la puesta en producción de modelos de investigación: revisando código, definiendo interfaces y configurando logging.
- Responder y liderar la resolución de incidentes de producción relacionados con ML.
Calificaciones requeridas
- Más de 3 años de experiencia en ingeniería de software, incluyendo más de 2 años con sistemas de ML en producción.
- Dominio de Python para código de nivel de producción.
- Experiencia con orquestación de ML: Kubeflow, MLflow, Metaflow, Airflow, o equivalente.
- Experiencia con contenedores: Docker y Kubernetes.
- Experiencia en plataformas cloud: AWS, GCP, o servicios de Azure ML.
- Fundamentos de CI/CD aplicados a flujos de trabajo de ML.
- Experiencia con herramientas de observabilidad y monitoreo.
Calificaciones preferidas
- Experiencia con clusters de GPU o entrenamiento distribuido.
- Experiencia con plataformas de feature store (Feast, Tecton).
- Experiencia en data engineering (Spark, dbt, streaming).
- Experiencia en serving de LLMs (vLLM, TGI, o similar).
- Certificación cloud de ML.
Qué ofrecemos
- [Rango salarial: $X a $Y según experiencia y ubicación]
- Participación accionaria
- Modalidades de trabajo remoto/híbrido
- Presupuesto de aprendizaje y desarrollo para certificaciones y conferencias
- Acceso a infraestructura de ML de vanguardia y alianzas de investigación
Salario y perspectivas de carrera
El mercado de MLOps todavía está madurando, por lo que los rangos salariales varían ampliamente según el tamaño de la empresa, la ubicación, la complejidad del stack y cuánto se superpone el rol con la ingeniería de plataforma.
| Nivel | Rango típico (EE. UU., 2025) |
|---|---|
| Junior (0-2 años) | $110,000 a $140,000 |
| Nivel medio (2-4 años) | $145,000 a $185,000 |
| Senior (5+ años) | $185,000 a $230,000 |
| Staff / Principal | $220,000 a $280,000+ |
| Los rangos incluyen salario base y excluyen equity. Fuente: Levels.fyi y encuestas de la industria, 2025. |
La progresión de carrera desde un rol de MLOps normalmente se ramifica en dos direcciones. Un camino lleva hacia machine learning engineering propiamente dicho, donde el foco se desplaza hacia la investigación y arquitectura de modelos. El otro camino lleva hacia la ingeniería de plataforma de ML o el liderazgo de infraestructura, más cercano a un perfil de site reliability engineer o cloud engineer pero especializado en cargas de trabajo de ML. Un pequeño número de profesionales experimentados pasa a roles de ML architect, diseñando la estrategia de ML de extremo a extremo para una organización.
La demanda sigue creciendo a medida que más empresas superan la etapa de prueba de concepto en ML y necesitan rigor operativo. El rol tiene especial demanda en empresas que ejecutan múltiples modelos en producción simultáneamente, donde el despliegue y monitoreo manual se vuelve insostenible.
Roles relacionados y en qué se diferencian
Los hiring managers a menudo confunden MLOps con roles adyacentes. Aquí tiene una comparación directa que le ayudará a decidir qué rol necesita realmente su equipo.
| Rol | Enfoque principal | Contrate cuando |
|---|---|---|
| MLOps Engineer | Operaciones del ciclo de vida de ML: CI/CD para modelos, despliegue, monitoreo, detección de drift, pipelines de reentrenamiento | Tiene modelos en producción (o casi) y necesita serving confiable y escalable, además de salud continua del modelo |
| Machine Learning Engineer | Construir y mejorar modelos de ML; poner en producción la investigación convirtiéndola en sistemas reutilizables | Necesita a alguien que pueda tanto construir modelos como integrarlos en aplicaciones, pero todavía no cuenta con infraestructura de ML dedicada |
| DevOps Engineer | CI/CD de software, automatización de infraestructura, aprovisionamiento en la nube, cercano a SRE | Necesita automatización general de despliegue e infraestructura sin necesidades específicas de ML |
| Data Engineer | Pipelines de datos, almacenamiento, transformación y confiabilidad de los datos que alimentan el entrenamiento de ML | Su cuello de botella en ML es la calidad de los datos y la confiabilidad de los pipelines aguas arriba del entrenamiento del modelo, no el despliegue del modelo |
Una regla práctica: si su equipo se pregunta "¿cómo llevamos este modelo a producción de forma confiable?", contrate a un MLOps engineer. Si se pregunta "¿cómo construimos un mejor modelo?", contrate a un AI engineer o a un machine learning engineer.
Preguntas Frecuentes sobre la Descripción del Puesto de MLOps Engineer
¿Cuál es la diferencia entre MLOps y DevOps?
DevOps se enfoca en los pipelines de entrega de software: construir, probar y desplegar código. MLOps aplica el mismo enfoque a los sistemas de machine learning, pero añade consideraciones específicas de ML que el CI/CD de software no cubre. Los modelos se degradan de formas que el código no (data drift, concept drift). El "testing" de modelos requiere evaluación estadística, no solo pruebas unitarias. El reentrenamiento es una operación rutinaria sin equivalente en el software. Un DevOps engineer puede construir una infraestructura excelente, pero normalmente necesitará orientación de alguien con conocimiento de ML para manejar correctamente estas consideraciones.
¿Los MLOps engineers necesitan saber construir modelos de ML?
No necesitan ser investigadores de ML, pero sí necesitan suficiente conocimiento de ML para trabajar de forma efectiva con los data scientists. Eso significa entender cómo se entrenan los modelos, qué hiperparámetros importan, cómo funcionan las métricas de evaluación y qué puede salir mal en producción (cambio en la distribución de datos, label drift, serving skew). Los mejores MLOps engineers pueden revisar el código de un data scientist y detectar riesgos de producción antes del despliegue.
¿MLOps es lo mismo que ML platform engineering?
Se superponen de forma significativa, pero no son idénticos. ML platform engineering tiende a enfocarse en la infraestructura interna compartida: el feature store, el sistema de seguimiento de experimentos, el cluster de entrenamiento, el model registry. MLOps es más amplio y a menudo incluye el despliegue por modelo, el monitoreo y los procesos operativos alrededor de modelos específicos. En empresas grandes, son equipos separados; en empresas más pequeñas, una sola persona hace ambas cosas.
¿Qué certificaciones cloud son relevantes para los roles de MLOps?
Las más relevantes son AWS Certified Machine Learning Specialty, Google Cloud Professional Machine Learning Engineer y Azure AI Engineer Associate. Estas cubren herramientas de ML específicas de cada nube y los flujos de trabajo de MLOps en cada plataforma. Son señales útiles, pero no obligatorias. La experiencia práctica con sistemas de ML en producción importa más para la mayoría de los equipos de contratación.
¿Cómo se evalúa a los candidatos de MLOps durante las entrevistas?
Enfóquese en la experiencia de producción, no solo en el conocimiento de ML. Pídales que describan un modelo que hayan desplegado, incluyendo cómo configuraron el monitoreo, qué salió mal después del lanzamiento y cómo lo resolvieron. Las preguntas de diseño de sistemas sobre pipelines de serving de modelos, diseño de feature stores y disparadores de reentrenamiento revelan cómo piensan los candidatos de forma operativa. Preguntar sobre su enfoque de CI/CD para ML, incluyendo cómo condicionan los despliegues a las métricas de rendimiento del modelo, es otra señal confiable.
A medida que los sistemas de ML se vuelven centrales para el funcionamiento de las empresas, los equipos que construyen infraestructura de modelos confiable y escalable tendrán una ventaja operativa significativa. Una descripción del puesto bien redactada es donde comienza esa ventaja: determina quién aplica, quién pasa el filtro y si la persona que contrata puede realmente hacer lo que el rol requiere. Use esta plantilla como punto de partida y luego ajuste los detalles del stack y los marcadores de seniority a su entorno real.
Para recursos de contratación relacionados, consulte nuestras guías de descripción de puestos para DevOps engineers, data engineers, y AI engineers.