MLOpsエンジニアの職務記述書(テンプレートとスキル)
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
優れたMLOpsエンジニアの職務記述書は、本番環境で実際にMLシステムを稼働させられる候補者を惹きつけられるか、それともJupyterノートブック上でモデルを訓練しただけの候補者しか集まらないかを分ける決め手になります。MLOpsは機械学習、ソフトウェアエンジニアリング、インフラ運用の交差点に位置する専門分野であり、まだ発展途上であるため、多くの採用チームが曖昧な職務記述書を書いてしまい、求める人材とは違う候補者を引き寄せてしまっています。
このガイドでは、完全なテンプレート、明確なスキルの内訳、給与ベンチマーク、関連職種との比較を提供し、チームが最初から適切な人材を採用できるようにします。
MLOpsエンジニアの仕事内容とは?
MLOpsエンジニアは、機械学習の運用面を担う存在です。データサイエンティストがモデルの構築と改善に注力する一方、MLOpsエンジニアはそれらのモデルが本番環境で実際に確実に機能するようにします。すなわち、予定通りにデプロイされ、安定したパフォーマンスを発揮し、負荷に応じてスケールし、問題なく更新やロールバックができる状態を保つことです。
この専門分野は、DevOpsエンジニアリングと従来のMLエンジニアリングの両方から要素を取り入れています。DevOpsからはCI/CDパイプライン、Infrastructure as Code、可観測性の実践を取り入れ、MLからは学習ワークフロー、特徴量エンジニアリング、モデルのバージョン管理、そして通常のソフトウェアにはない形でMLシステムを故障させる統計的な癖(データドリフトなど)への理解を取り入れています。
シニアのMLOpsエンジニアは通常、モデルのライフサイクル全体を担当します。データサイエンティストから学習済みモデルを引き継いだ瞬間から、コンテナ化、自動テスト、段階的デプロイ、本番監視、再学習トリガー、そして最終的な廃止に至るまでです。小規模なチームでは、データサイエンティストが上流で利用するフィーチャーストアや実験管理基盤の構築・保守も担うことがあります。
主要な事実
- MLOpsはAIエンジニアリングの中でも最も急成長している専門分野の一つで、企業がML実験から大規模な本番デプロイへと移行するにつれ、求人数は2021年から2024年にかけておよそ3倍に増加しました(LinkedIn Workforce Report、2024年)。
- エンタープライズのMLプロジェクトの大半は本番環境に到達できておらず、その主な原因としてインフラと運用面のギャップが挙げられています。MLOpsという職種は、まさにこのギャップを埋めるために存在しています(Gartner、2023年)。
- 米国のミドルレベルMLOpsエンジニアの総報酬の中央値は、勤務地や技術スタックによっておよそ145,000ドルから185,000ドルの範囲であり、大手テック企業のシニア職では200,000ドルを大きく上回ります(Levels.fyi、2025年)。
MLOpsエンジニアの職務内容
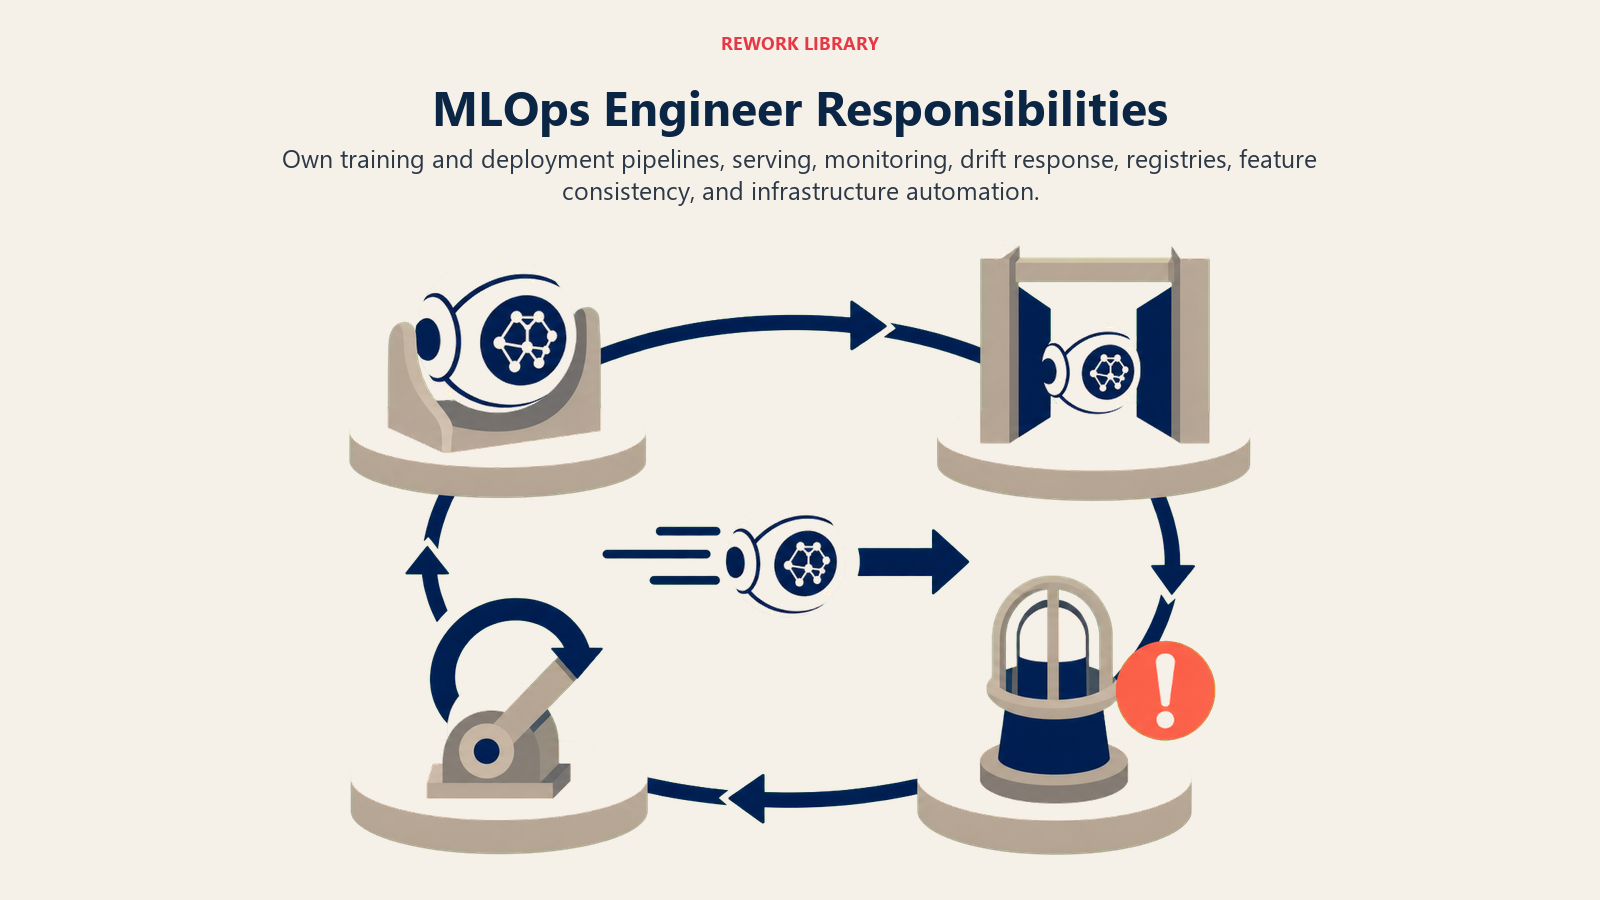
学習・デプロイパイプライン、サービング、監視、ドリフトへの対応、レジストリ、特徴量の一貫性、インフラ自動化を担当します。
- MLワークフロー専用に設計されたCI/CDパイプラインを構築・保守します。自動モデル学習、評価ゲート、段階的ロールアウトを含みます。
- コンテナ化(Docker)とオーケストレーション(Kubernetes)を使ってモデルを本番環境にデプロイし、バッチ推論とリアルタイム推論の両方に対応するサービングインフラを管理します。
- 稼働中のモデルについて精度の低下、データドリフト、コンセプトドリフトを監視します。パフォーマンスが定めた閾値を下回った際のアラートと自動再学習パイプラインを構築します。
- 学習環境とサービング環境の間で一貫性があり再現可能な特徴量計算を実現するため、フィーチャーストアを設計・運用します。
- チームが過去のあらゆるモデルの状態を再現し、実験結果を比較できるよう、モデルレジストリとバージョン管理システム(MLflow、Weights and Biasesなど)を管理します。
- ML学習クラスター、サービングエンドポイント、データパイプラインをプロビジョニング・管理するため、Infrastructure as Code(Terraform、Pulumi、クラウドネイティブのIaCなど)を記述します。
- データサイエンティストと協力し、メモリフットプリント、レイテンシプロファイル、エラーハンドリング、ロギングといった観点からモデルコードの本番対応レベルをレビューします。
- データエンジニアと連携し、学習データパイプラインの信頼性、バージョン管理、監査可能性を確保します。
- モデルサービングに関するSLA(稼働率、レイテンシパーセンタイル、スループット目標)を定義し、遵守させます。
- ロールバック、シャドーデプロイ、A/Bテストの設定を含め、ML関連の本番障害に対するインシデント対応をリードします。
要件と資格
本番運用レベルのPython、MLオーケストレーション、コンテナ、クラウドインフラ、CI/CD、可観測性、協働でのデバッグ能力を確認しましょう。
必須のスキルと経験
- 3年以上のソフトウェアエンジニアリング経験。うち2年以上は本番のMLシステムに携わった経験。
- 高いPythonスキル。単なるスクリプトではなく、本番用のコードを書くことになります。
- Kubeflow、MLflow、Metaflow、MLワークフロー向けのAirflow、Vertex AI Pipelinesなど、主要なMLオーケストレーションツールの少なくとも1つの実務経験。
- コンテナとオーケストレーションの習熟。パッケージングにはDocker、デプロイとスケーリングにはKubernetesを使用。
- クラウドプラットフォームの経験。AWS(SageMaker、EKS、S3)、Google Cloud(Vertex AI、GKE)、Azure(Azure ML、AKS)のいずれか。マルチクラウドの経験は歓迎します。
- CI/CDの原則への理解と、それをML特有のワークフロー(データセットのバージョン管理、パイプラインのゲートとしてのモデル評価など)に適応させた経験。
- 可観測性ツール(Prometheus、Grafana、または同等のクラウドネイティブツール)に精通しており、インフラのメトリクスと合わせてモデルのパフォーマンスメトリクスを追跡できること。
- MLサービングに関連する分散システムの概念(ロードバランシング、水平スケーリング、キャッシング、レイテンシバジェット)への確かな理解。
あれば尚良い
- 学習ワークロード向けのGPUクラスター管理の経験。
- フィーチャーストアプラットフォーム(Feast、Tecton、または同等のクラウドネイティブツール)の知識。
- データエンジニアリングのバックグラウンド。Spark、dbt、またはストリーミングパイプライン(Kafka、Pub/Sub)。
- 責任あるAIの実践(モデルカード、バイアス監査、説明可能性ツール)への理解。
- LLMのデプロイとサービング(vLLM、TGI、または同様の推論フレームワーク)に関する実務経験。
- オープンソースのMLOpsツールへの貢献。
学歴
ほとんどのチームは、コンピューターサイエンス、ソフトウェアエンジニアリング、またはそれに準ずる分野の学士号を受け入れています。本番のMLシステムに携わった同等の実務経験も同じく評価されます。MLOpsにはまだ標準的な資格取得のルートはありませんが、クラウドのML認定資格(AWS ML Specialty、Google Professional ML Engineer)は有用な判断材料になります。
MLOpsエンジニアの職務記述書テンプレート
職務概要
[会社名]は、機械学習モデルを実験段階から信頼性の高い本番システムへと移行させるMLOpsエンジニアを募集しています。データサイエンティストやプラットフォームエンジニアと協力し、モデルを大規模かつ正確に稼働させ続けるためのパイプライン、インフラ、ツールを構築していただきます。これは本番システムに対する真のオーナーシップを持つ、実務型の技術職です。
主な職務内容
- MLモデルの学習、評価、デプロイのためのCI/CDパイプラインを設計・構築・保守します。
- Docker、Kubernetes、クラウドマネージドのサービングインフラを使ってモデルをデプロイ・サービングします。
- 本番モデルについて、データドリフト、予測ドリフト、サービング品質の低下を監視します。再学習とアラートのワークフローを自動化します。
- チームがモデルのバージョンを再現・比較・監査できるよう、モデルレジストリと実験管理システムを管理します。
- 学習とサービングの両方で一貫した特徴量計算を実現するため、フィーチャーストアの基盤を開発・保守します。
- ML学習環境とサービング環境向けのInfrastructure as Codeを記述します。
- データサイエンティストが研究用モデルを本番化する際に、コードレビュー、インターフェースの定義、ロギングの設定を通じてサポートします。
- ML関連の本番インシデントに対応し、解決をリードします。
必須要件
- 3年以上のソフトウェアエンジニアリング経験。うち2年以上は本番のMLシステムでの経験。
- 本番品質のコードを書けるレベルのPythonスキル。
- MLオーケストレーションの経験。Kubeflow、MLflow、Metaflow、Airflow、または同等のツール。
- コンテナの経験。DockerおよびKubernetes。
- クラウドプラットフォームの経験。AWS、GCP、またはAzure MLサービス。
- MLワークフローに適用されたCI/CDの基礎知識。
- 可観測性・監視ツールの使用経験。
歓迎要件
- GPUクラスターまたは分散学習の経験。
- フィーチャーストアプラットフォーム(Feast、Tecton)の経験。
- データエンジニアリングのバックグラウンド(Spark、dbt、ストリーミング)。
- LLMサービングの経験(vLLM、TGI、または類似ツール)。
- クラウドMLの認定資格。
当社が提供するもの
- [給与レンジ:経験と勤務地に応じてXドル~Yドル]
- ストックオプションへの参加
- リモート/ハイブリッドワークの制度
- 資格取得やカンファレンス参加のための学習・能力開発予算
- 最先端のMLインフラおよび研究パートナーシップへのアクセス
給与とキャリアの展望
MLOps市場はまだ成熟の途上にあるため、給与レンジは企業規模、勤務地、技術スタックの複雑さ、そしてプラットフォームエンジニアリングとの職務の重なり具合によって大きく異なります。
| レベル | 一般的なレンジ(米国、2025年) |
|---|---|
| ジュニア(0~2年) | 110,000ドル~140,000ドル |
| ミドルレベル(2~4年) | 145,000ドル~185,000ドル |
| シニア(5年以上) | 185,000ドル~230,000ドル |
| スタッフ / プリンシパル | 220,000ドル~280,000ドル以上 |
| レンジには基本給を含み、株式報酬は含みません。出典:Levels.fyiおよび業界調査、2025年。 |
MLOpsからのキャリアは、通常2つの方向に分かれます。一つは機械学習エンジニアリングそのものへ進む道で、モデルの研究とアーキテクチャへと軸足が移ります。もう一つはMLプラットフォームエンジニアリングやインフラ部門のリーダーシップへ進む道で、サイトリライアビリティエンジニアやクラウドエンジニアに近いバックグラウンドですが、MLワークロードに特化しています。経験豊富な実務者のごく一部は、組織全体のMLの戦略をエンドツーエンドで設計するMLアーキテクトの役割に進みます。
PoC段階のMLを超えて運用面の厳密さを必要とする企業が増えるにつれ、需要は拡大を続けています。特に、複数のモデルを同時に本番稼働させており、手作業でのデプロイや監視がもはや立ち行かなくなっている企業で、この職種の需要は高まっています。
関連職種とその違い
採用担当者は、MLOpsを隣接する職種と混同してしまうことがよくあります。チームに本当に必要な職種を見極められるよう、以下で直接比較します。
| 職種 | 主な焦点 | 採用すべきタイミング |
|---|---|---|
| MLOpsエンジニア | MLライフサイクルの運用:モデルのCI/CD、デプロイ、監視、ドリフト検知、再学習パイプライン | モデルがすでに本番稼働している(あるいはその直前の)状態で、信頼性が高くスケーラブルなサービングと継続的なモデルの健全性管理が必要なとき |
| 機械学習エンジニア | MLモデルの構築と改善、研究成果を再利用可能なシステムとして本番化すること | モデルの構築とアプリケーションへの統合の両方ができる人材が必要だが、専用のMLインフラはまだないとき |
| DevOpsエンジニア | ソフトウェアのCI/CD、インフラ自動化、クラウドプロビジョニング、SREに近い業務 | ML特有のニーズがなく、一般的なデプロイとインフラ自動化が必要なとき |
| データエンジニア | データパイプライン、ストレージ、変換、ML学習に流れ込むデータの信頼性 | MLのボトルネックがモデルのデプロイではなく、モデル学習の上流にあるデータ品質とパイプラインの信頼性であるとき |
実践的な目安としては、チームが「このモデルをどう確実に本番投入するか」と問うているならMLOpsエンジニアを採用してください。「どうすればもっと良いモデルを作れるか」と問うているなら、AIエンジニアまたは機械学習エンジニアを採用してください。
MLOpsエンジニアの職務記述書に関するよくある質問
MLOpsとDevOpsの違いは何ですか?
DevOpsは、コードのビルド、テスト、デプロイといったソフトウェア配信パイプラインに焦点を当てています。MLOpsは同じ考え方を機械学習システムに適用しますが、ソフトウェアのCI/CDではカバーできないML特有の懸念事項が加わります。モデルは、コードとは異なる形で劣化します(データドリフト、コンセプトドリフトなど)。モデルの「テスト」には、単体テストだけでなく統計的な評価が必要です。再学習は日常的な作業ですが、ソフトウェア開発には相当するものがありません。DevOpsエンジニアは優れたインフラを構築できますが、こうした懸念事項を正しく扱うには、通常ML知識を持つ人からの助言が必要になります。
MLOpsエンジニアは、MLモデルの構築方法を知っている必要がありますか?
ML研究者である必要はありませんが、データサイエンティストと効果的に協働できるだけの十分なML知識は必要です。具体的には、モデルがどのように学習されるか、どのハイパーパラメータが重要か、評価指標がどう機能するか、そして本番環境で何が問題になり得るか(データ分布のシフト、ラベルドリフト、サービングスキューなど)を理解していることです。優秀なMLOpsエンジニアは、データサイエンティストのコードをレビューし、デプロイ前に本番リスクを見つけ出すことができます。
MLOpsはMLプラットフォームエンジニアリングと同じものですか?
両者は大きく重なり合っていますが、同一ではありません。MLプラットフォームエンジニアリングは、フィーチャーストア、実験管理システム、学習クラスター、モデルレジストリといった共有の社内インフラに焦点を当てる傾向があります。MLOpsはより広範で、モデルごとのデプロイ、監視、特定モデルをめぐる運用プロセスまで含むことが多くなります。大企業ではこれらは別々のチームが担当しますが、小規模な企業では一人が両方を兼任します。
MLOpsの職種に関連するクラウド認定資格には何がありますか?
最も関連性が高いのは、AWS Certified Machine Learning Specialty、Google Cloud Professional Machine Learning Engineer、Azure AI Engineer Associateです。これらは各プラットフォーム固有のMLツールとMLOpsワークフローをカバーしています。有用な判断材料ではありますが、必須ではありません。ほとんどの採用チームにとっては、本番のMLシステムでの実務経験の方が重要です。
面接でMLOpsの候補者をどのように評価すればよいですか?
ML知識だけでなく、本番運用の経験に焦点を当てましょう。デプロイしたモデルについて、どのように監視を設定したか、リリース後に何が問題になったか、それにどう対処したかを含めて説明してもらいます。モデルサービングパイプライン、フィーチャーストアの設計、再学習トリガーに関するシステム設計の質問は、候補者が運用面でどう考えるかを明らかにします。モデルのパフォーマンス指標に基づいてデプロイをゲートする方法など、MLにおけるCI/CDへのアプローチについて尋ねるのも、有効な判断材料になります。
MLシステムが企業運営の中核を担うようになるにつれ、信頼性が高くスケーラブルなモデルインフラを構築できるチームは、大きな運用上の優位性を得られます。その優位性はよく書かれた職務記述書から始まります。職務記述書は、誰が応募してくるか、誰が選考を通過するか、そして採用した人材が実際に職務を遂行できるかどうかを左右します。このテンプレートを出発点として、実際の環境に合わせて技術スタックの詳細と求める経験レベルの目安を調整してください。
関連する採用リソースとして、DevOpsエンジニア、データエンジニア、AIエンジニアの職務記述書ガイドもご覧ください。
Senior Operations & Growth Strategist