AIによるキャッシュフロー予測:手法、データ、精度
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
AIによるキャッシュフロー予測とは、統計モデルと機械学習モデルを使って、支払履歴、未決済の請求書、事業ドライバーから将来の入金、支払、残高を予測し、その予測がどれだけ外れたかを測定して改善につなげる取り組みです。 予測そのものは簡単な部分です。難しいのは、モデルに適切なデータを渡すこと、自社の資金の動きに合った手法を選ぶこと、そして精度を正直に測ることです。
本記事は、キャッシュ予測を担当し、AIで何が変わるのかを知りたい財務責任者(トレジャラー)、コントローラー(経理責任者)、CFOに向けて書いています。手法、データ入力、精度の評価方法(MAPE、バイアス、予測期間)、パイロット導入の進め方を取り上げます。システムが自動で予測を作成して更新するエージェント版については、AIキャッシュフローエージェントのブループリントをご覧ください。計画全体との関係については、AI in FP&AとAI in treasuryをお読みください。
重要なポイント
- 2026年のAFP Treasury Benchmarking Survey(財務実務者425人、2026年5月実施)では、49%がキャッシュと流動性の予測を財務(トレジャリー)で最も難しい業務に挙げ、63%が最優先事項と位置づけました(AFP、2026年9月)。
- 同調査では、AIの知識について「効果的」と自己評価した回答者は34%にとどまりました。つまり、予測を読む担当者自身が、その背後にあるモデルをまだ判断できないことが少なくありません(AFP、2026年9月)。
- 予測の教科書では、精度はモデルのあてはめに使っていないデータで評価し、テストセットは「必要な最大の予測期間と少なくとも同じ長さ」にすることが推奨されています(Hyndman and Athanasopoulos, Forecasting: Principles and Practice)。
- MAPEのような誤差率は、実績値がゼロのとき定義できず、ゼロに近いと極端な値になります。純キャッシュフローでは特に問題になります(Forecasting: Principles and Practice)。
- 複数の手法の予測を平均すると精度が上がることが多く、単純平均は複雑な重み付けより上回りにくいことが分かっています(Forecasting: Principles and Practice)。
AIがキャッシュ予測にもたらすもの
キャッシュ予測の多くは、すでにスプレッドシートで作られています。期首残高、見込みの入金、予定された支払、期末残高という構造です。この構造自体に問題はありません。うまくいかないのは入力値です。入金は期日より遅れて届きます。大口の仕入先への支払は前倒しになります。更新が面倒だという理由で、先月の前提がそのまま使われ続けます。
AIは、項目ごとの時期と金額の推定を改善し、予測全体を人よりも高い頻度で更新します。実務では次の3点が変わります。
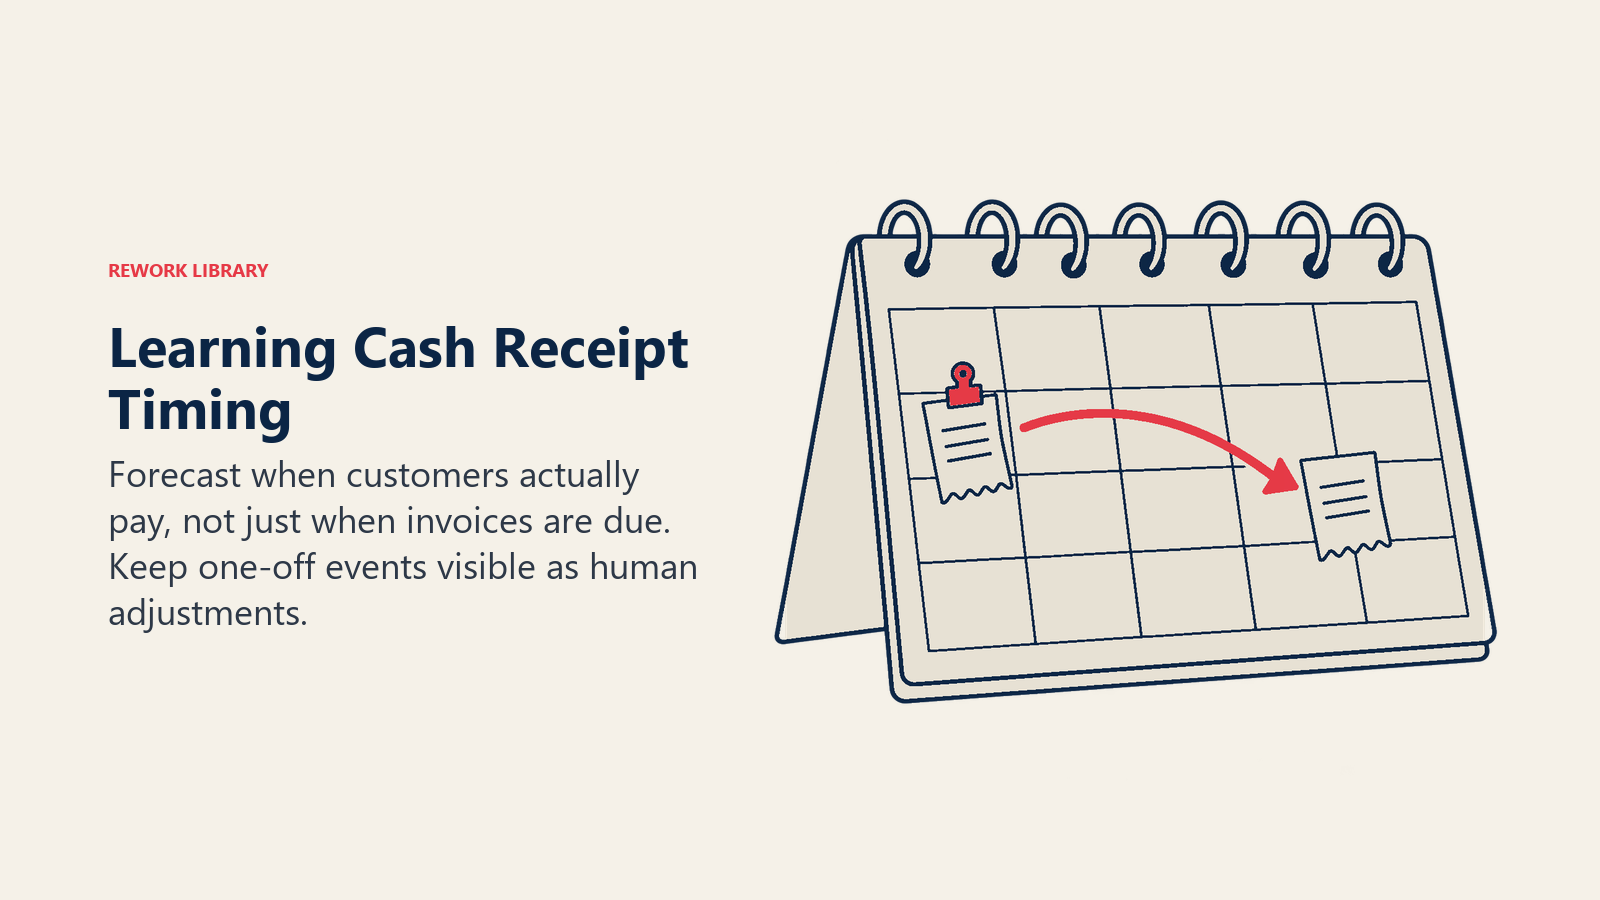
- 支払時期は仮定ではなく学習されます。 「顧客は30日で支払う」と仮定する代わりに、モデルは「この顧客は平均41日で支払い、12月はさらに遅れる」と学習します。
- 履歴からパターンが見つかります。 季節性、月末への集中、給与支払のリズムは、誰もルールを書かなくても時系列分析で浮かび上がります。
- 誤差がデータになります。 予測と実績のずれはすべて記録されるため、毎月上書きするのではなく、予測が改善されていきます。
とはいえ、判断が不要になるわけではありません。予定された買収、顧客との係争、資金調達ラウンドなどは、引き続き人が判断します。モデルはこれらを、区別してラベルを付けた調整として示すべきです。
主な手法の比較
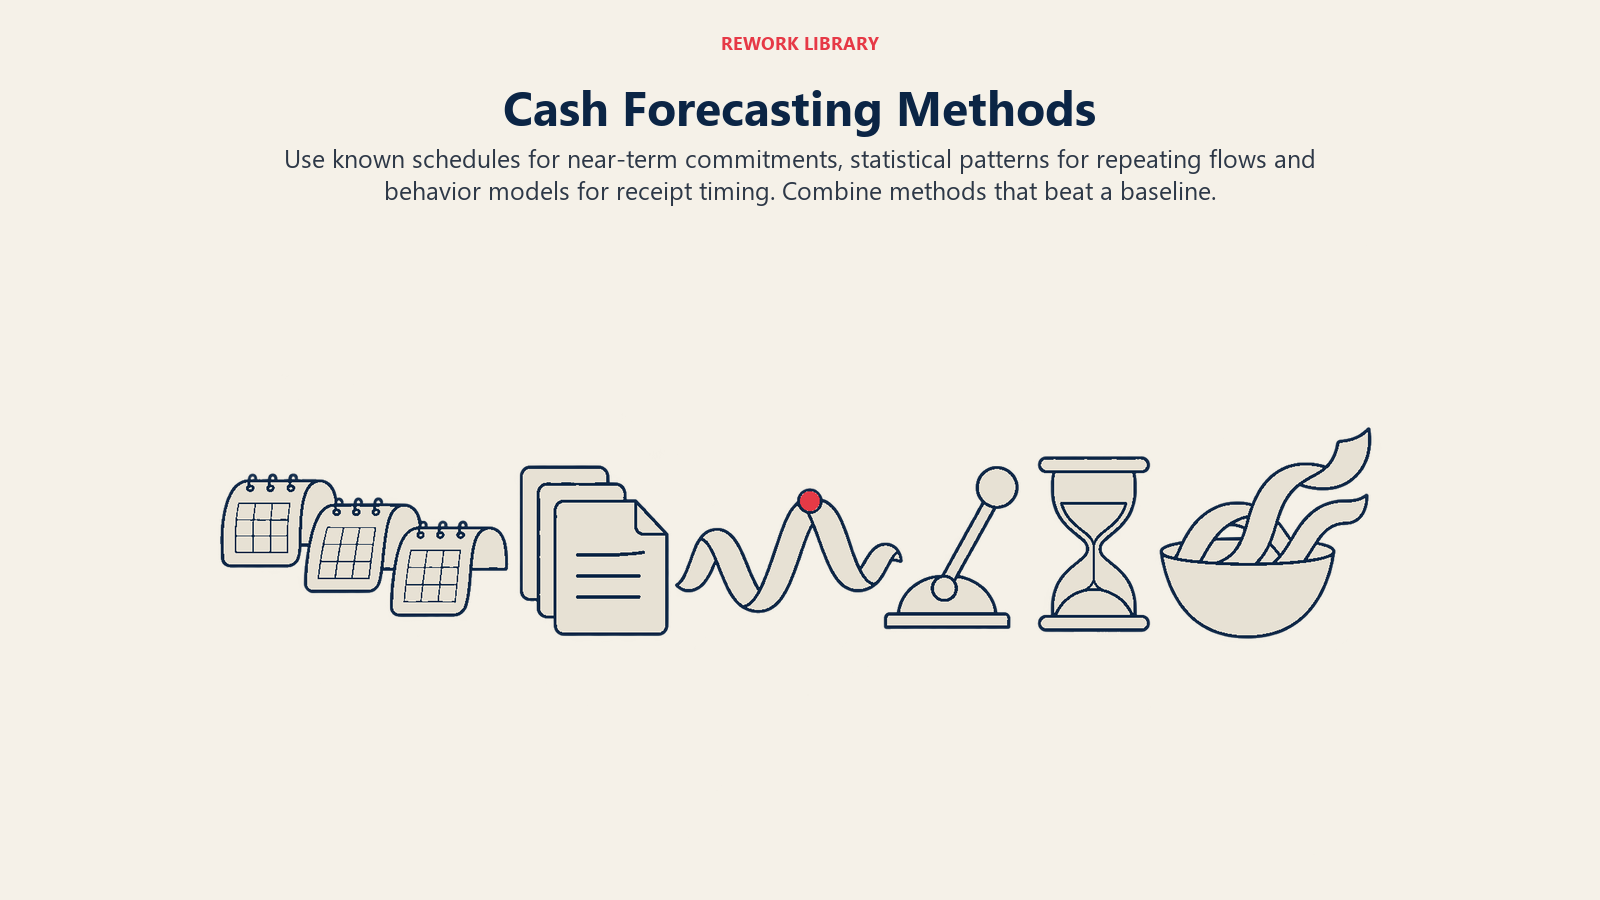
予測全体に1つの手法を選ぶ必要はありません。資金の動きは科目ごとに異なるため、複数の手法を組み合わせるのが適切なことが多いです。
| 手法 | 仕組み | 向いている用途 | 主な弱点 |
|---|---|---|---|
| ナイーブ予測、季節ナイーブ予測 | 次の期間は前の期間、または前年の同じ期間と同じとみなす | 上回るべきベースライン、安定して繰り返す資金の流れ | 変化した要素を一切反映しない |
| 直接法(スケジュールベース) | 既知の請求書、給与、家賃、債務返済を期日ごとに合計する | 項目が分かっている今後1〜4週間 | 支払の遅れや予定外の項目を捉えられない |
| 指数平滑法とARIMA | 履歴にトレンドと季節性をあてはめる | 明確なリズムのある入金・支払の合計 | 急な変化や履歴が少ない場合に弱い |
| 回帰と勾配ブースティング | 売上、人員、カレンダー要因などのドライバーを入力にする | 事業活動に連動する科目 | きれいなドライバーデータが必要で、過学習しやすい |
| 支払行動モデル | 未決済の請求書がいつ実際に支払われるかを予測する | 時期のリスクが集中する売掛金 | 顧客またはセグメントごとの請求書単位の履歴が必要 |
| 組み合わせとハイブリッド | 複数の手法を平均または加重する | 中期の予測の大半 | 保守と説明の負担が増える |
この表について、押さえておきたい点が2つあります。1つ目は、単純なベースラインは機械学習への侮辱ではなく、物差しだということです。複雑なモデルが「昨年の同じ週」に勝てないなら、そのモデルを使う理由はありません。2つ目は、手法の組み合わせには十分な裏付けがあることです。予測の研究では、複数の予測を平均すると1つを選ぶより良くなることが多く、等重みの平均は改善が難しいとされています(Forecasting: Principles and Practice)。大規模な予測コンペティションであるM4は、10万本の実際の時系列で手法を検証しており、統計的手法と機械学習の手法を比べる際の定番の参照先です。誰かの主張を受け入れる前に、自社のキャッシュ履歴で両方を試してください。
支払行動モデルは、特に触れておく価値があります。顧客からの入金は、予測の中で最も時期を読みにくい科目であることが多いためです。延滞予測の仕組みについては、AI in accounts receivableで解説しています。回収リスクを採点するモデルは、そのままキャッシュ予測の入力にできます。
データ入力:モデルに必要なもの
モデルの良さは、読み込むデータで決まります。実用的なキャッシュ予測の構成が参照するデータを、おおよそ影響の大きい順に挙げます。
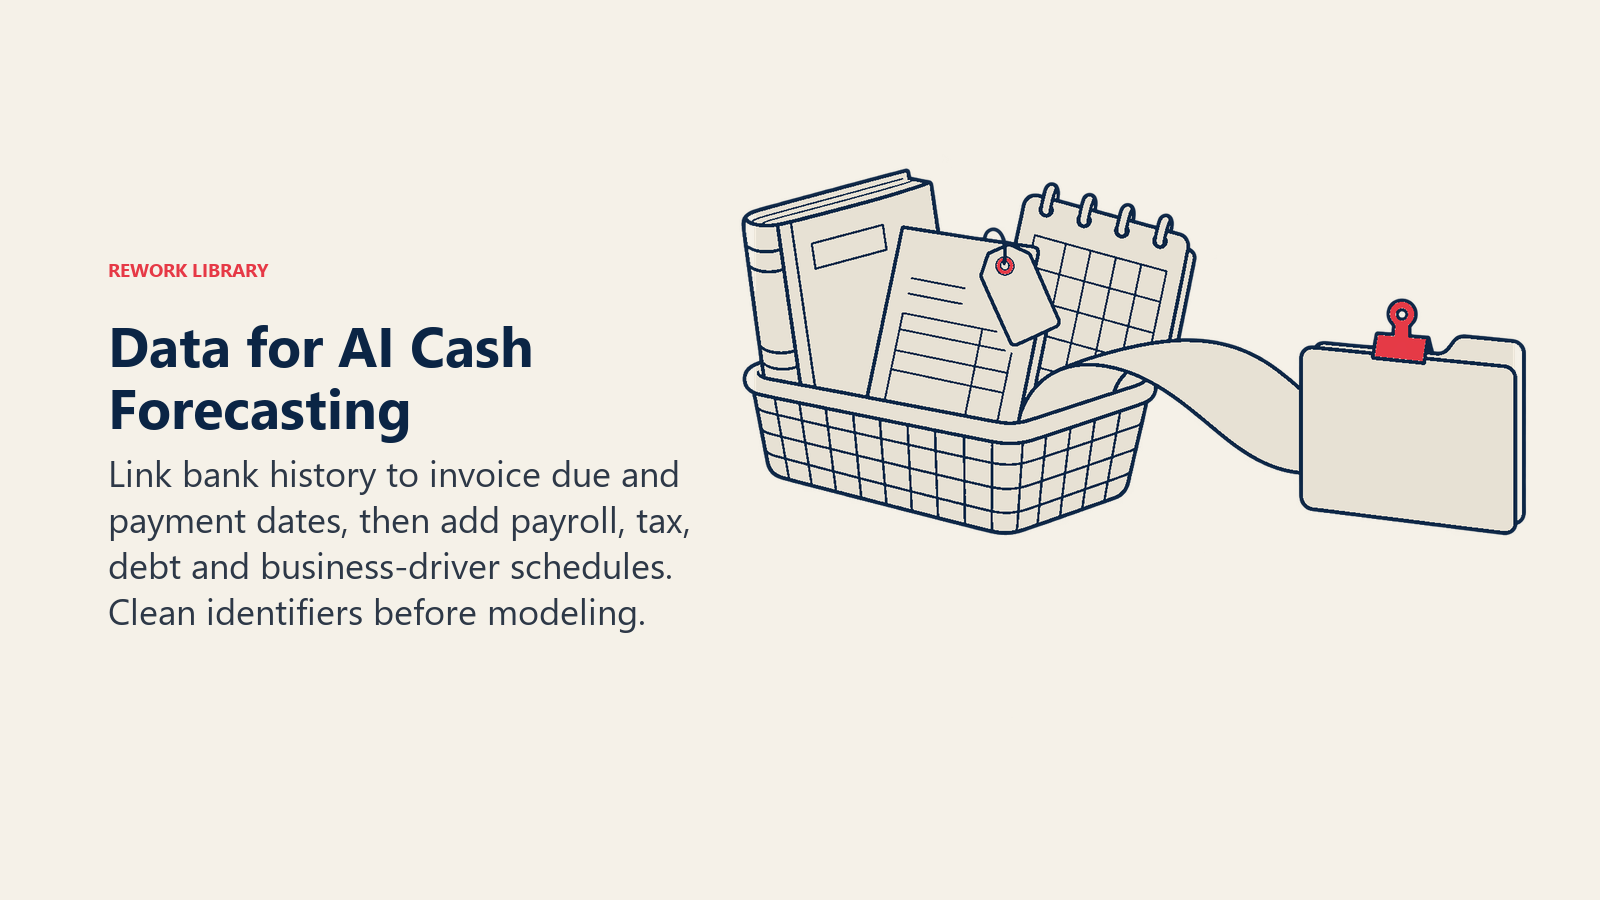
- 銀行取引の履歴は、季節性が見えるよう少なくとも2年分が必要です。日次または週次の粒度が理想です。
- 未決済および支払済みの請求書(売掛金と買掛金)は、発行日、期日、支払日、金額、顧客または仕入先、支払条件を含めて用意します。
- 予定されている支払義務には、給与の支払カレンダー、納税、借入金の返済、リース、設備投資の承認があります。
- 事業ドライバーには、営業パイプライン、受注、人員計画、生産スケジュール、販促があります。
- カレンダー要因には、祝日、給与支払日、月末と四半期末、現地の銀行休業日があります。
- 必要に応じた外部要因には、多通貨のキャッシュの場合の為替レートや、業界の季節性があります。
最もよくある失敗は、モデルではなくデータです。システム間で顧客名が一致しない、請求書への参照がない銀行明細行がある、入金から数週間遅れて支払が記録されるといったことが、モデルが学習する内容を歪めます。構築を始める前にAIのための財務データの準備をお読みください。そして、まず銀行明細行と請求書の突合を整えてください。
精度の測り方
予測がどれだけ外れているか言えなければ、AIが役立ったかどうかも言えません。4つの指標を併用してください。それぞれが、他の指標では見えないものを映すからです。
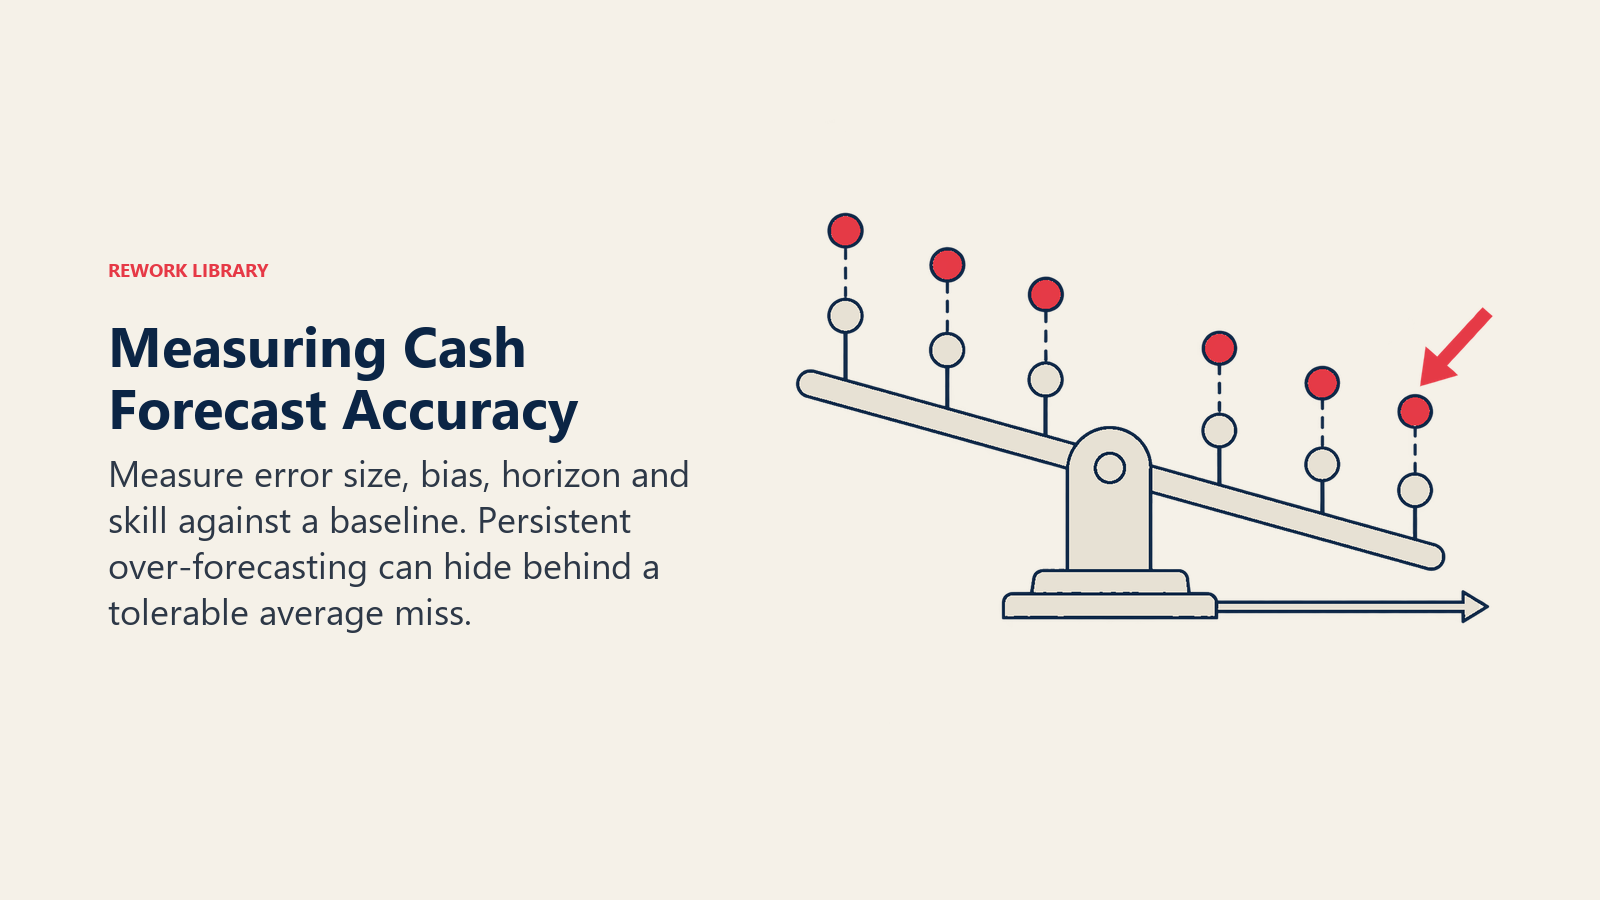
誤差の大きさ。 MAE(平均絶対誤差)は、外れた幅の平均を通貨単位で表します。「平均で12万外れています」と説明しやすい指標です。MAPE(平均絶対パーセント誤差)は、外れ幅を実績に対する割合で表すため、規模の異なる科目を比較できます。ただしMAPEには既知の弱点があります。実績がゼロのときは定義できず、ゼロに近いと極端な値になり、過大予測と過小予測を不均等に扱います(Forecasting: Principles and Practice)。週次の純キャッシュフローはゼロ付近になったりマイナスになったりするため、純キャッシュにMAPEを使うのは落とし穴です。総入金と総支払を別々に評価するか、加重指標(絶対誤差の合計を実績の合計で割る)を使ってください。
バイアス。 バイアスは符号付き誤差の平均です。つまり、予測が一貫して高すぎるのか低すぎるのかを示します。誤差の大きさが小さくても、上振れのバイアスが続く予測は、資金不足への油断を生みます。財務担当者が見落としがちな指標ですが、どちらの方向に修正すべきかを教えてくれるのはこの指標です。
予測期間。 先を見るほど精度は下がるため、精度は予測期間別(来週、来月、来四半期)に報告します。全体で1つの数字にすると、精度の高い短期予測と弱い長期予測が混ざってしまいます。目標は意思決定ごとに設定します。借入れを左右する13週間の予測では、13週目よりも1〜4週目に厳しい精度が求められます。
ベースラインに対する優位性。 ナイーブ予測と比較します。スケール化された指標であるMASEはこれを行うもので、1未満であれば、学習データ上の平均的なナイーブ予測を上回っていることを意味します(Forecasting: Principles and Practice)。
具体的な計算例
以下の数値は説明用です。ある会社が、週次の入金を千単位で予測しています。
| 週 | 実績 | 予測 | 誤差(予測マイナス実績) | 絶対誤差率 |
|---|---|---|---|---|
| 1 | 400 | 440 | +40 | 10% |
| 2 | 250 | 275 | +25 | 10% |
| 3 | 500 | 520 | +20 | 4% |
| 4 | 100 | 130 | +30 | 30% |
MAPEは4つの誤差率の平均で、(10 + 10 + 4 + 30) / 4 = 13.5%です。加重誤差は絶対誤差の合計を実績の合計で割った値で、115 / 1,250 = 9.2%です。バイアスは符号付き誤差の平均で、+115 / 4 = +28.75となり、毎週が過大予測だったことが分かります。この最後の行が肝心な発見です。誤差の大きさは許容範囲に見えますが、モデルは系統的に楽観的であり、これに頼る財務担当者は必要な流動性より少ない額しか確保しないことになります。また、4週目は、MAPEが誤解を招く理由も示しています。規模の小さい週に小さな絶対誤差が出ただけで、大きな割合になってしまうのです。
正しくテストする
モデルを、あてはめに使った履歴で評価してはいけません。実際より良く見えてしまうからです。直近のデータをテストセットとして取り分けておき、理想的には最長の予測期間と同じ長さにします。さらに良いのは、ローリングオリジン評価(時系列クロスバリデーション)を使う方法です。ある日付までのデータで学習し、先を予測して誤差を記録し、日付を進めて繰り返します。これにより、モデルは予測対象の未来を一度も見ません(Forecasting: Principles and Practice)。
職種別の実例
財務(トレジャリー)。 企業の財務責任者が、13週間のローリングフォーキャストを運用しています。1〜4週目は、既知の請求書と給与から直接法で作成します。予定外の残りの部分は統計モデルで予測し、財務責任者は毎週月曜日に実績とのずれを確認します。AFPの調査では、予測が財務で最も難しい業務の筆頭に挙がり、63%が最優先事項と答えています(AFP)。財務全体の姿については、AI in treasuryをご覧ください。
売掛金管理。 与信管理の担当者が、キャッシュのチームに、期日ではなく、未決済の請求書ごとの支払予測日を渡します。15日遅れで支払う顧客は、契約上の週から後ろの週にずらされます。債権回収チームは、さらに遅れる可能性が高いとモデルが示した請求書に優先的に対応します。
FP&A。 アナリストが、最初の12週間はモデルのベースラインを使い、その上に予定されたイベントを重ねます。このベースラインはAI in FP&Aを通じて年間計画につながり、売上が落ち込んだらどうなるかと取締役会から問われたときは、モンテカルロ・シミュレーションで結果の幅をストレステストできます。
創業者と小規模な財務チーム。 財務担当が1人のスタートアップが、バーンレートとランウェイを追跡しています。銀行履歴と既知の支払義務の短いリストに基づく単純なモデルは、誰かが外れを記録している限り、楽観的な前提だらけのスプレッドシートよりも優れています。
ステップごとの導入方法
- まず意思決定を定義します。 予測の用途は、日次の流動性、13週間の借入計画、年間予算の確認のどれでしょうか。それによって、予測期間と精度の目標が決まります。
- ベースラインを設定します。 現在の予測の誤差の大きさ、バイアス、予測期間別のプロファイルを、少なくとも8〜12週間分測定します。AIが超えるべき水準です。
- データを準備します。 銀行明細行と請求書を突合し、顧客を重複排除し、支払日の欠落を埋めます。この工程は省かないでください。
- 予測を科目ごとに分けます。 入金、給与、税金、債務返済、その他の支払を別々にモデル化します。項目が予定されている部分では直接法を使います。
- シンプルに始めます。 機械学習の前に、季節ベースラインと1〜2つの統計的手法をあてはめます。データが裏付ける範囲で、ドライバーベースや支払行動のモデルを追加します。
- ローリングオリジンでバックテストします。 すべての候補を、誤差の大きさ、バイアス、予測期間別に、ナイーブなベースラインと比較して評価します。
- 有効なものを組み合わせます。 複雑なものを作る前に、最も良い候補を平均します。
- 人による調整の層を残します。 予定されたイベントや一回限りの項目は、担当者を明記した、見える形の上書きとして入力します。これがヒューマン・イン・ザ・ループの工程です。
- **1四半期は並行して運用し、**その後、モデルの予測を従来のプロセスと科目ごとに比較します。
- 外れを毎週レビューします。 どの科目がなぜ外れたかを記録し、スケジュールに沿って再学習します。
よくある落とし穴
- あてはめに使った履歴で評価すること。 学習したデータで見事な結果が出るモデルでも、来月はうまくいかないことがあります。必ずデータを取り分けてください。
- 精度を1つの数字だけで報告すること。 予測期間や科目を混ぜると、モデルの弱点が隠れてしまいます。
- バイアスを無視すること。 誤差が小さくても、過大予測が続くのは流動性のリスクです。
- 純キャッシュにMAPEを使うこと。 実績がゼロに近い、またはマイナスだと、意味を成しません。総額の科目で評価してください。
- ベースラインを省くこと。 「昨年の同じ週」と比べなければ、AIが価値を加えたことを証明できません。
- 照合が不十分なこと。 銀行明細行が請求書に結びついていないと、モデルは誤った支払行動を学習します。
- モデルを数字の唯一の責任者にしてしまうこと。 上書きも含めて、予測には財務の担当者が責任を持つ必要があります。ここではスキルが重要です。AFPの調査では、AIの知識について効果的と自己評価した財務実務者は34%にとどまります(AFP)。
- 再学習しないこと。 顧客の行動も自社の条件も変わります。放置したモデルはドリフトします。
次に読む記事
今月1つだけ実行するなら、直近四半期の現在の予測について、誤差の大きさ、バイアス、予測期間別のプロファイルを計算してください。それにより、問題がノイズ(より良い手法が役立つ可能性)なのか、バイアス(いくつかの前提を直す方が効果的な可能性)なのかが分かります。次に、データ準備のガイドで入力データを確認し、予測が計画とどうつながるかをAI in FP&Aで読み、エージェントがスケジュールに沿って更新を実行する方法をAIキャッシュフローエージェントのブループリントでご確認ください。
Head of Finance Strategy