内部監査におけるAI:継続的モニタリングと全件テスト
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
内部監査におけるAIとは、機械学習、分析手法、言語モデルを使い、年に1度の小規模なサンプルレビューではなく、母集団全体を対象に統制と取引を継続的にテストすることです。範囲の設定、判断、結論には引き続き監査人が責任を持ちます。 変化の本質は単純です。従来の監査は「抽出した請求書60件のうち、ルール違反は何件か」を問います。AIを活用した監査は「400,000件すべての請求書のうち、ルール違反はどれか。そして、ルールを通過したのに不自然なものはどれか」を問います。
本記事は、継続的モニタリングと全件テストが実際に何を伴うのか、AIがどこで役立ち、どこで役立たないのかを知りたい内部監査部門長(CAE)、監査マネージャー、CFO、コントローラー向けです。全体像は金融・会計におけるAIから読み始めてください。監査がテストの対象とする統制環境については、AIと内部統制をご覧ください。
重要なポイント
- IIAのグローバル内部監査基準は5つのドメインと15の原則で構成され(The IIA)、2025年1月9日に発効しました(The IIAプレスリリース、2025年1月)。
- IIAは2025年9月25日、継続的監査とモニタリングに関するGlobal Technology Audit Guideの第3版を公表し、2015年版を置き換えました(The IIA)。
- 2025年版の北米内部監査パルス調査では、41%のチームが内部監査で生成AIを利用していると回答しましたが、フィールドワークで頻繁または広範に使っているのは6%、計画段階では13%にとどまりました(Internal Audit Foundationのレポートに関するOptroの要約)。
- 同じ調査で、内部監査部門長(CAE)が最も向上させたいスキルはデータ分析で、回答者の78%が選びました(Optroの要約)。
- 監査におけるサンプリングは、母集団の100%未満の項目に監査手続を適用することと正式に定義されています。サンプリングリスクとは、サンプルから導いた結論が、母集団全体から得られる結論と異なるリスクのことです(FRC、ISA(UK and Ireland)530)。
- IIAのArtificial Intelligence Auditing Frameworkは2024年9月13日に更新され、AIガバナンス、マネジメント、そして生成AIを含む内部監査機能そのものを対象としています(The IIA)。
継続的モニタリングと全件テストとは
この2つの概念は関連していますが、同じではありません。
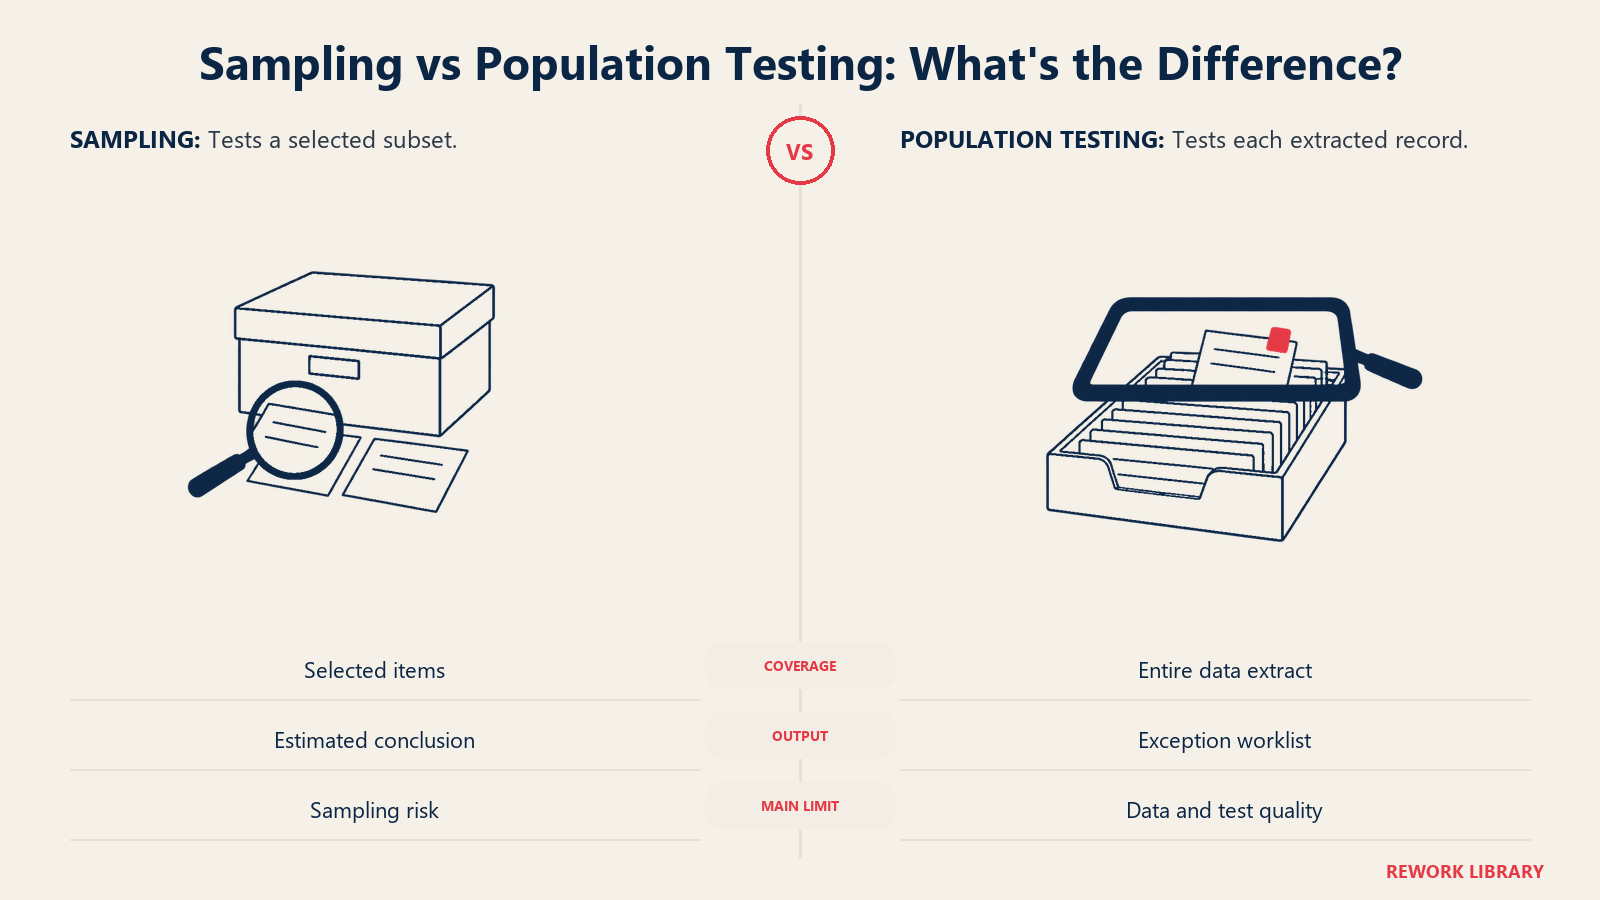
全件テストとは、選んだサンプルではなく、データセット内のすべてのレコード(全仕訳、全支払、全経費申請)に対してテストを実行することです。サンプルから得られるのは、信頼水準付きの推定値です。全件テストから得られるのは、すべての例外の一覧です。サンプリングは、すべてを確認できない場合のための手法です。データがデータウェアハウスにあり、テストがクエリで書けるなら、多くの場合は全件を確認できます。
継続的モニタリングとは、監査サイクルごとに1度ではなく、日次や週次といったスケジュールでテストを実行することです。厳密には、IIAのガイダンスは2つの役割を区別しています。継続的監査は、内部監査が継続的な保証を提供するために行うものです。継続的モニタリングは、経営陣が自らの統制を監視するために行うものです。実際にはツールを共有することが多く、優れたプログラムでは両者を調整して、2つのラインが同じテストを二重に作らないようにしています。
では、AIはどこに当てはまるのでしょうか。ルールベースの分析手法でも、すでに母集団全体をテストできます。たとえば「承認限度額を超える支払をすべて抽出する」といったものです。AIは、ルールでは難しい3つのことを加えます。
- 明文化されたルールがなくてもパターンを検出できます。 異常検知モデルは、各取引を、その仕入先、ユーザー、勘定にとっての通常の状態と照らして採点します。そのため、誰もルール化しようと考えなかった不自然な項目が浮かび上がります。
- 非構造化テキストを読み取れます。 言語モデルは、契約書、メール、経費の説明文、規程文書を読み、台帳の記載と突き合わせられます。
- 優先順位づけができます。 母集団全体を対象にすると、例外が3,000件出ることもあります。モデルは、実際の問題である可能性が高いものから順に並べられるため、監査人は優先度の高いものから着手できます。
サンプルテストと全件テストの比較
| 観点 | サンプルベースのテスト | AIによる全件テスト |
|---|---|---|
| カバー範囲 | 選択した一部、たとえば25〜60件 | データセット内のすべてのレコード |
| 結果 | サンプリングリスクを伴う結論 | 例外の一覧と、順位づけされたリスクビュー |
| タイミング | 監査サイクルごとに1回、多くは活動の数か月後 | 日次または週次、発生に近い時点 |
| 発見できるもの | たまたまサンプルに入っていた誤り | 個別の誤り、繰り返し違反する対象、部門をまたぐパターン |
| コスト構造 | データコストは低いが、1件あたりの監査人の工数は大きい | データとモデルの初期作業が必要だが、実行ごとの限界コストは低い |
| 主な弱点 | 稀な事象を設計上見逃す | 誤検知、データ品質、説明できないモデル出力 |
| 監査人の役割 | 選択、テスト、推定 | テストの定義、例外のトリアージ、調査、結論 |
この表は、変化が単なる「テスト量の増加」ではない理由を示しています。監査人の仕事は、項目を抽出することから、どの例外が重要で、なぜ重要なのかを判断することへ移ります。FRCのISA 530の本文が定義するとおり、サンプリングリスクとは、サンプルに基づく結論が、すべてをテストした場合の結果と異なる可能性のことです。全件テストはこの特定のリスクを取り除きます。ただし、別のリスクが加わります。それについては後述します。
監査領域別に見るAIの活用場面
以下の例は説明用であり、特定の組織から引用したものではありません。
買掛金管理と調達。 ルールベースのテストは、請求書番号の重複を確認します。モデルは、ほぼ重複しているものも見つけられます。たとえば、金額と仕入先が同じで数字が1桁入れ替わっているものや、承認限度額のわずか下に分割された購買です。言語モデルは、請求書の記載内容を発注書と比較できます。プロセス自体がどう自動化されるか、そしてそれによって監査がテストすべき内容がどう変わるかは、買掛金管理におけるAIをご覧ください。
仕訳と決算。 監査人は以前から、手作業の仕訳をリスク指標でテストしてきました。時間外に計上されたもの、金額が丸いもの、勘定の組み合わせが異例なもの、ほとんど仕訳を起票しないユーザーによる仕訳などです。モデルは、すべての仕訳をこうしたパターンと作成者の過去の傾向に照らして採点します。手作業の修正が最も集中するのは月次決算であるため、重点を置くのに自然な場所です。
経費とカード支出。 40件の申請を抽出する代わりに、すべての申請について、規程違反、領収書の重複、週末の支出、加盟店の不一致をテストします。検知方法の詳細はAIによる経費管理で扱っています。
アクセス権と職務分掌。 ERPと銀行システム間でユーザーのロール割り当てを比較し、仕入先の作成と支払の承認の両方ができる担当者を抽出します。これはデータ照合の問題であり、日次のスケジュールで問題なく動きます。
収益と売掛金。 すべての請求書を契約条件と出荷記録に照らしてテストし、四半期末の直後に発行されたクレジットノートを抽出します。文書レビュー型のモデルは、契約条項を読み、請求設定と比較できます。
不正の兆候。 モデルは、仕入先、従業員、取引を不正リスクの高さで順位づけし、調査につなげられます。出力は結論ではなく、手がかりとして扱ってください。関連記事の金融におけるAI不正検知で、手法とその誤り率を解説しています。
監査業務の管理。 言語モデルは、前年の監査調書を要約し、統制の説明からテスト手順を起案し、ヒアリングメモを所見のたたき台にまとめられます。IIA FoundationのPulseデータは、これが初期の利用パターンであることを示しています。利用は計画、フィールドワーク、報告にまんべんなく薄く広がっており、どれか1つの段階で頻繁に使っているチームは少数です。
継続的モニタリングの実際
実際に機能する構成には、いくつかの要素がありますが、特別なものはありません。
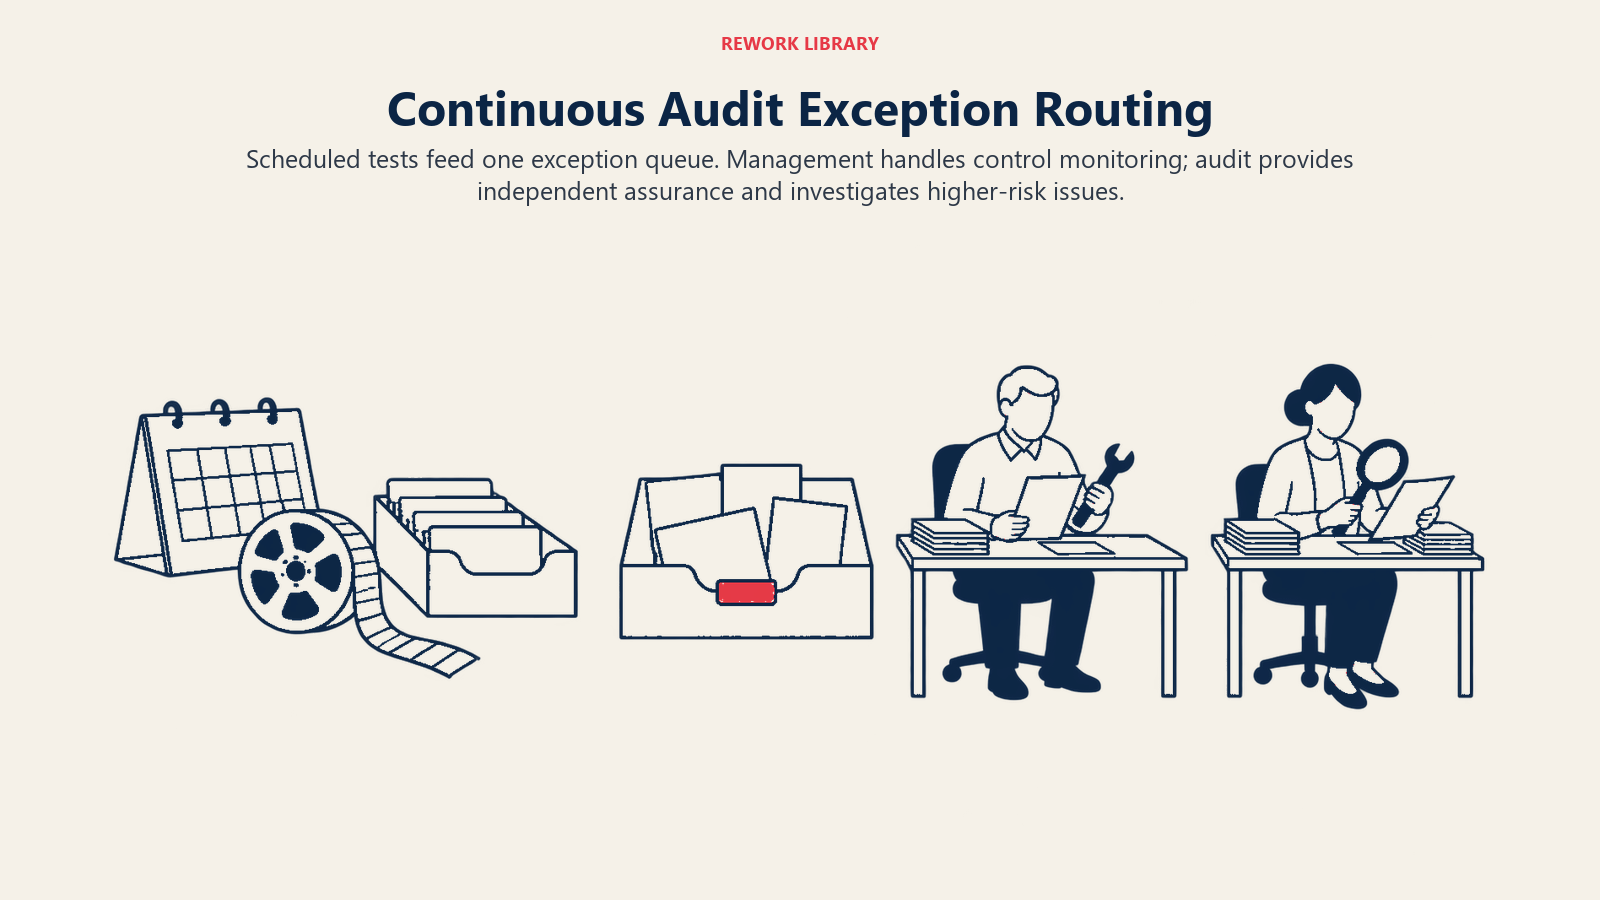
- データ層。 ERP、決済システム、HR、アクセスログからの抽出データが、スケジュールに従って管理されたストアに格納されます。監査人は読み取り専用でアクセスします。
- テストライブラリ。 各テストには、ID、関連する統制、ロジックの説明、担当者、しきい値があります。ルールで構成されるテストもあれば、モデルで構成されるものもあります。
- 例外処理キュー。 結果は1か所に集まり、ステータス(新規、レビュー中、確定、却下)と、各判断の理由コードが付きます。
- ルーティングルール。 リスクの低い例外は、第1線の統制責任者に説明を求めます。リスクの高いものは監査に回します。
- 監査委員会向けダッシュボード。 プロセスや事業体ごとの例外の推移、解決までの時間、再発した問題を示します。
プログラムの成否を分けるのは、ルーティングルールです。経営陣がモニタリングを所有し、監査がそのモニタリングをテストする形にすれば、重複なく連携できます。監査がすべてを自ら実行すると、本来は独立して評価すべき統制環境の一部になってしまうおそれがあります。
段階的な導入手順
- リスクとデータの準備状況から最初のプロセスを選びます。 データソースが整理され一元化されていて、統制が明確なものを選びます。支払、仕訳、経費はよくある出発点です。確認すべき点は財務のデータ準備状況(AI向け)にまとめています。
- まずルールから始め、ルールで足りない部分にモデルを加えます。 現在のサンプルベースのテストを、まず全件クエリとして作り直します。それだけで見えるものが変わることも多くあります。明らかなギャップがある部分に、異常スコアリングを追加します。
- 実行する前に、何を例外とするかを定義します。 統制目的、テストロジック、しきい値を文書化します。それがなければ、結果をプロセス責任者に説明できません。
- 従来の方法と比較してベースラインを作ります。 すでにサンプリングした期間で、全件テストを実行します。それぞれの方法が何を見つけたかを比べます。
- 誤検知を測定し、調整します。 フラグの90%が却下されるようなら、レビュー担当者は確認しなくなります。キューをレビューする担当者とともに、しきい値を調整します。
- 経営陣と役割を合意します。 どのテストを経営陣がモニタリングとして所有し、どのテストを監査が保証として所有するか、例外をどうルーティングするかを決め、文書化します。
- モデルガバナンスを整えます。 各モデルの目的、入力、担当者、テスト結果、変更履歴を記録します。IIAのAI Auditing Frameworkは、AI対応プロセスをどう評価するかのチェックリストとして役立ちます。自社のモデルにも同じ規律が当てはまります。
- 結論は手作業で検証します。 報告する所見はすべて、モデルのスコアだけでなく、監査人が確認した原資料までたどれるようにします。
- 報告の仕方を変えます。 「40件をテストして2件の例外を見つけました」から、「212,000件すべてをテストし、340件の例外を見つけ、そのうち19件が確認された誤りでした」へ移行します。
- 四半期ごとにプログラムを見直します。 カバー範囲、誤検知率、データフィードの途絶、そしてテストが今も統制に合っているかを確認します。
限界と落とし穴
全件テストは確実性があるように聞こえますが、そうではありません。
- 完全なデータセットは、完全な保証と同じではありません。 抽出データ内のすべてのレコードをテストしても、抽出がシステム、事業体、手作業のプロセスのいずれかを取りこぼしていたなら、母集団は完全ではありませんでした。テストを信頼する前に、レコード件数と合計を台帳と照合してください。
- データに残らない統制があります。 経営者によるレビュー、メールでの承認、現物確認は、構造化された記録がほとんど残りません。記録されていないものは、分析ではテストできません。
- 誤検知があります。 数千件の例外が、本物の問題を埋もれさせることがあります。順位づけされたキューは助けになりますが、順位づけが調整され、レビューされている場合に限ります。
- ブラックボックスの出力があります。 モデルが仕訳にフラグを立てても、その理由を誰も説明できなければ、それを根拠に所見を裏づけることはできません。理由が見える手法を優先するか、説明の層を追加して原資料で検証してください。
- 言語モデルの誤りがあります。 もっともらしい文章でも、誤っていることがあります。IIAが公表した、監査でAIを1年間使った実務者の報告は、誤りを覆い隠す洗練された出力について警告し、新人の下書きと同じようにレビューすることを勧めています(Internal Auditor、2025年12月)。モデルが起案した所見や要約は、下書きとして扱ってください。
- 独立性に注意が必要です。 本来は経営陣が所有すべきモニタリングを監査が構築・運用すると、監査が経営の役割を担うことになります。線引きを明確に保ってください。
- データのプライバシーとセキュリティが課題です。 モデルや外部ツールに入力する給与、仕入先、顧客のデータには、他の機微なシステムと同じアクセス制御と承認が必要です。
- ドリフトが起こります。 事業の変化(新しいERPモジュール、新しい仕入先登録フロー)により、通常の状態が変わります。変化前に学習したモデルは、変化後に誤ってラベルづけします。
- スキルのギャップがあります。 パルス調査の回答者は、データ分析を最も向上させたいスキルに挙げました。解釈し、疑問を投げかけられる人材がいなければ、ツールは誰も活用しないレポートを生み出すだけです。
- 主張が行き過ぎることがあります。 「すべてをテストした」が当てはまるのは、実際に実行した母集団とテストについてだけです。何をカバーしたかを明示してください。
測定すべき指標
- カバー範囲: テストした対象範囲内の取引の割合と、自動化されたテストを持つ主要統制の割合。
- 例外の質: 発生した例外、確定した例外、却下された例外の件数と、テストごとの誤検知率。
- スピード: 事象からフラグ付けまでの時間と、フラグ付けから解決までの時間。
- 再発した問題: 同じ部門で同じ統制が繰り返し不備となる件数。単発ではなく根本原因があることを示します。
- 工数のシフト: サンプルの選択と再テストから、調査へ移った監査人の工数。
- データの健全性: フィードの障害、欠落レコード、照合の不一致。
次に読む記事
今四半期に1つだけ取り組むなら、1つのプロセスを選んでサンプルテストを全件クエリとして作り直し、前年のサンプルの結果と比べてください。続いて、統制設計の観点はAIと内部統制、調査手法は金融におけるAI不正検知、財務部門全体のガバナンスの全体像は金融におけるAIをお読みください。
内部監査におけるAIに関するよくある質問
内部監査における全件テストとは何ですか?
サンプルではなく、すべての支払やすべての仕訳といったデータセット内のすべてのレコードに対して、監査テストを実行することです。得られるのは推定値ではなく、すべての例外の一覧です。サンプリングリスクはなくなりますが、完全で正確なデータ抽出に依存することに変わりはありません。
AIはサンプリングを置き換えますか?
完全には置き換えません。データがデジタルで一元化されている場合、全件テストで多くのサンプルを代替できます。現物の確認、署名、判断に依存する統制には、引き続き従来の手続が必要で、結論に責任を持つのは監査人です。
継続的監査と継続的モニタリングの違いは何ですか?
継続的監査は、内部監査がテクノロジーを使って継続的な保証を提供する方法です。継続的モニタリングは、経営陣が自らの統制を定期的に監視する方法です。両者に関するIIAの最新のガイダンスは2025年9月に公表されました。優れたプログラムでは、テストが重複しないよう両者を調整しています。
内部監査でのAI利用は、現在どの程度広がっていますか?
導入は進んでいますが、浅い段階にとどまっています。2025年版の北米内部監査パルス調査では、41%のチームが生成AIを利用していると回答しましたが、フィールドワークで頻繁または広範に使っているのは6%だけでした。多くのチームは、まだ試行の段階にあります。
監査でAIを使う際の最大のリスクは何ですか?
不完全なデータ抽出、本物の問題を埋もれさせる誤検知、誰も説明できないモデル、そして流暢でも誤っている言語モデルの出力です。監査が経営陣のモニタリングの役割を引き継ぐと、独立性もリスクになります。ガバナンス、文書化、所見の手作業による検証で、これらすべてを軽減できます。
内部監査チームはどこから始めるべきですか?
データが整っている、件数の多いプロセスから始めてください。たとえば支払、経費、仕訳です。現在のサンプルテストを全件クエリとして作り直し、前回の監査サイクルの結果と比較します。シンプルなルールでは足りない部分にだけ、異常スコアリングを追加してください。
Head of Finance Strategy