KI-Cashflow-Prognose: Methoden, Daten und Genauigkeit
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
KI-Cashflow-Prognose bedeutet, mit statistischen Modellen und Modellen des maschinellen Lernens künftige Zahlungseingänge, Zahlungsausgänge und Kontostände aus Ihrer Zahlungshistorie, den offenen Rechnungen und den Geschäftstreibern vorherzusagen und anschließend zu messen, wie stark die Vorhersagen danebenliegen, damit sie besser werden. Die Vorhersage selbst ist der leichte Teil. Schwierig ist es, die richtigen Daten ins Modell zu bekommen, eine zu Ihren Zahlungsmustern passende Methode zu wählen und die Genauigkeit ehrlich zu messen.
Dieser Leitfaden richtet sich an Treasurer, Controller und CFOs, die eine Cashflow-Prognose verantworten und wissen wollen, was KI daran verändert. Er behandelt die Methoden, die Dateninputs, die Bewertung der Genauigkeit (MAPE, Bias und Horizont) und den Ablauf eines Pilotprojekts. Wenn Sie die Agent-Variante suchen, bei der ein System die Prognose selbstständig erstellt und aktualisiert, lesen Sie den Blueprint für einen KI-Cashflow-Agenten. Für den breiteren Planungskontext lesen Sie KI in FP&A und KI im Treasury.
Wichtige Fakten
- In der AFP Treasury Benchmarking Survey 2026 (425 Treasury-Praktiker, Befragung im Mai 2026) nannten 49 % die Cashflow- und Liquiditätsprognose als die anspruchsvollste Treasury-Aufgabe, und 63 % stuften sie als wichtigste Priorität ein (AFP, September 2026).
- Dieselbe Umfrage ergab, dass sich nur 34 % der Befragten bei KI-Wissen als kompetent einstufen. Wer die Prognose liest, kann das Modell dahinter also oft noch nicht beurteilen (AFP, September 2026).
- Die Lehrbuchempfehlung zur Prognose lautet, die Genauigkeit an Daten zu messen, die das Modell bei der Anpassung nicht gesehen hat, mit einem Testdatensatz, der „mindestens so groß ist wie der maximal benötigte Prognosehorizont“ (Hyndman und Athanasopoulos, Forecasting: Principles and Practice).
- Prozentuale Fehler wie MAPE sind nicht definiert, wenn der Istwert null ist, und liefern nahe null extreme Werte, was beim Netto-Cashflow eine Rolle spielt (Forecasting: Principles and Practice).
- Der Durchschnitt der Prognosen mehrerer Methoden verbessert oft die Genauigkeit, und einfache Durchschnitte lassen sich gegenüber komplexeren Gewichtungen nur schwer schlagen (Forecasting: Principles and Practice).
Was KI an einer Cashflow-Prognose verbessert
Die meisten Cashflow-Prognosen gibt es bereits in einer Tabellenkalkulation: Anfangsbestand, erwartete Zahlungseingänge, geplante Zahlungen, Endbestand. Die Struktur ist in Ordnung. Schief geht es bei den Inputs. Zahlungseingänge kommen später als zum Fälligkeitsdatum. Eine große Lieferantenzahlung wird vorgezogen. Jemand behält die Annahme des Vormonats bei, weil das Aktualisieren mühsam ist.
KI verbessert die Schätzung von Zeitpunkt und Betrag für jeden einzelnen Posten und aktualisiert die gesamte Prognose häufiger, als ein Mensch es kann. In der Praxis ändern sich drei Dinge:
- Der Zahlungszeitpunkt wird gelernt, nicht angenommen. Statt „Kunde zahlt in 30 Tagen“ lernt ein Modell, dass dieser Kunde im Schnitt nach 41 Tagen zahlt und im Dezember noch später.
- Muster werden in der Historie gefunden. Saisonalität, Häufungen zum Monatsende und der Rhythmus der Gehaltsabrechnung zeigen sich in der Zeitreihenanalyse, ohne dass jemand eine Regel schreibt.
- Fehler werden zu Daten. Jede Abweichung zwischen Prognose und Istwert wird protokolliert, sodass sich die Prognose verbessert, statt jeden Monat überschrieben zu werden.
Nichts davon nimmt Ihnen die Ermessensentscheidungen ab: eine geplante Übernahme, einen Kundenstreit, eine Finanzierungsrunde. Sie bleiben bei Menschen, und das Modell sollte sie als getrennte, benannte Anpassungen ausweisen.
Die wichtigsten Methoden im Vergleich
Sie müssen sich nicht für die gesamte Prognose auf eine Methode festlegen. Unterschiedliche Cashflow-Positionen verhalten sich unterschiedlich, und die richtige Antwort ist oft eine Mischung.
| Methode | Funktionsweise | Am besten geeignet für | Hauptschwäche |
|---|---|---|---|
| Naive und saisonale Naive-Prognose | Die nächste Periode entspricht der letzten oder derselben Periode des Vorjahres | Eine Baseline, die es zu schlagen gilt; stabile, wiederkehrende Zahlungsströme | Ignoriert alles, was sich geändert hat |
| Direkt (plangestützt) | Summiert bekannte Rechnungen, Gehälter, Miete und Schuldendienst nach Fälligkeit | Die nächsten 1 bis 4 Wochen, in denen die Posten bekannt sind | Übersieht verspätete Zahlungen und ungeplante Posten |
| Exponentielle Glättung und ARIMA | Passt Trend und Saisonalität an eine Historie an | Aggregierte Zahlungseingänge oder -ausgänge mit klarem Rhythmus | Hat Probleme mit plötzlichen Brüchen und dünner Historie |
| Regression und Gradient Boosting | Nutzt Treiber (Umsatz, Personalbestand, Kalendereffekte) als Inputs | Positionen, die an die Geschäftstätigkeit gekoppelt sind | Braucht saubere Treiberdaten; kann überanpassen |
| Zahlungsverhaltensmodelle | Sagt voraus, wann jede offene Rechnung tatsächlich bezahlt wird | Forderungen, bei denen sich das Timing-Risiko konzentriert | Braucht Historie auf Rechnungsebene je Kunde oder Segment |
| Kombinationen und Hybride | Mittelt oder gewichtet mehrere Methoden | Die meisten mittelfristigen Prognosen | Mehr Pflegeaufwand und Erklärungsbedarf |
Zwei Dinge sind an dieser Tabelle wissenswert. Erstens ist eine einfache Baseline keine Beleidigung für maschinelles Lernen, sondern der Maßstab. Wenn ein komplexes Modell „dieselbe Woche im Vorjahr“ nicht schlägt, hat es seinen Platz nicht verdient. Zweitens ist das Kombinieren von Methoden gut belegt. Die Prognoseforschung stellt fest, dass der Durchschnitt mehrerer Prognosen oft besser ist als die Wahl einer einzigen und dass sich gleichgewichtete Durchschnitte kaum verbessern lassen (Forecasting: Principles and Practice). Der große M4-Prognosewettbewerb hat Methoden an 100.000 realen Zeitreihen getestet und ist der übliche Bezugspunkt, wenn über statistische gegenüber ML-Methoden gestritten wird. Testen Sie beides an Ihrer eigenen Cashflow-Historie, bevor Sie die Behauptung eines Anbieters akzeptieren.
Zahlungsverhaltensmodelle verdienen eine besondere Erwähnung, weil sich Kundenzahlungen oft am schwersten zeitlich einordnen lassen. KI in der Debitorenbuchhaltung behandelt, wie die Vorhersage verspäteter Zahlungen funktioniert. Dasselbe Modell, das das Einzugsrisiko bewertet, kann die Cashflow-Prognose direkt speisen.
Dateninputs: Was das Modell braucht
Ein Modell ist nur so gut wie das, was es liest. Hier ist, worauf ein praxistaugliches Setup für die Cashflow-Prognose zurückgreift, grob nach Wirkung geordnet:
- Historie der Banktransaktionen, mindestens zwei Jahre, damit die Saisonalität sichtbar wird. Tägliche oder wöchentliche Granularität ist ideal.
- Offene und bezahlte Rechnungen (Forderungen und Verbindlichkeiten) mit Ausstellungsdatum, Fälligkeitsdatum, Zahlungsdatum, Betrag, Kunde oder Lieferant und Zahlungsbedingungen.
- Geplante Verpflichtungen: Gehaltskalender, Steuerzahlungen, Darlehenstilgungen, Mieten, Freigaben für Investitionen.
- Geschäftstreiber: Sales-Pipeline, Auftragseingang, Personalplan, Produktionsplan, Aktionen.
- Kalendereffekte: Feiertage, Gehaltstage, Monats- und Quartalsende, lokale Bankschließungen.
- Externe Faktoren, wo relevant: Wechselkurse bei Cash in mehreren Währungen, Saisonalität in Ihrer Branche.
Der häufigste Fehler liegt nicht im Modell, sondern in den Daten. Kundennamen, die über Systeme hinweg nicht zusammenpassen, Bankbuchungen ohne Bezug zu einer Rechnung und Zahlungen, die Wochen nach dem Eingang verbucht werden, verzerren alle, was das Modell lernt. Lesen Sie Datenbereitschaft im Finanzwesen für KI, bevor Sie bauen, und bringen Sie zuerst die Zuordnung von Bankbuchungen zu Rechnungen in Ordnung.
So messen Sie die Genauigkeit
Wenn Sie nicht sagen können, wie stark Ihre Prognose danebenliegt, können Sie auch nicht sagen, ob KI geholfen hat. Verwenden Sie vier Maße gemeinsam, denn jedes verbirgt etwas, das die anderen zeigen.
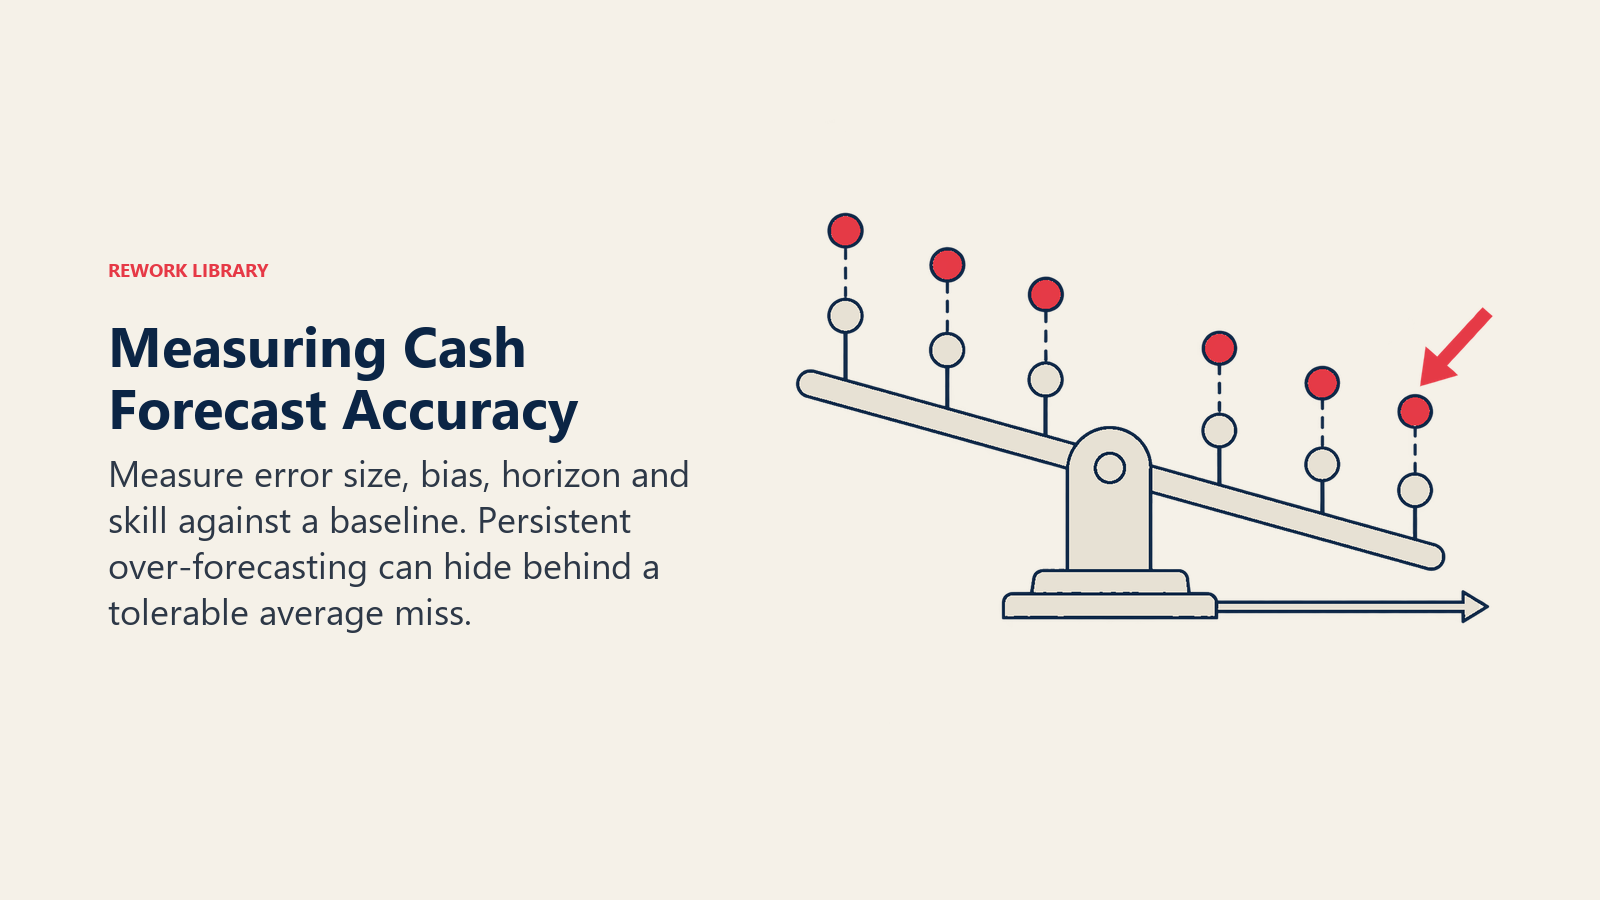
Fehlergröße. MAE (mittlerer absoluter Fehler) ist die durchschnittliche Abweichung in Währungseinheiten. Er lässt sich leicht erklären: „Wir liegen im Schnitt um 120.000 daneben.“ MAPE (mittlerer absoluter prozentualer Fehler) drückt die Abweichung als Prozentsatz des Istwerts aus, sodass Sie Positionen unterschiedlicher Größe vergleichen können. MAPE hat aber bekannte Schwächen. Er ist nicht definiert, wenn der Istwert null ist, liefert nahe null extreme Werte und bestraft Über- und Unterprognosen ungleich (Forecasting: Principles and Practice). Der wöchentliche Netto-Cashflow kann nahe null liegen oder negativ werden, daher ist MAPE auf den Netto-Cashflow eine Falle. Bewerten Sie Brutto-Zahlungseingänge und Brutto-Zahlungsausgänge getrennt oder verwenden Sie ein gewichtetes Maß (gesamter absoluter Fehler geteilt durch die Summe der Istwerte).
Bias. Bias ist der durchschnittliche vorzeichenbehaftete Fehler: Prognostizieren Sie durchgehend zu hoch oder zu niedrig? Eine Prognose mit kleiner Fehlergröße, aber stetigem Aufwärts-Bias wiegt Sie in einen Liquiditätsengpass. Bias ist das Maß, das Treasurer gern auslassen, und es ist das, das Ihnen die Richtung der Korrektur zeigt.
Horizont. Die Genauigkeit sinkt, je weiter Sie in die Zukunft schauen, deshalb berichten Sie sie nach Horizont: nächste Woche, nächster Monat, nächstes Quartal. Eine einzige Gesamtzahl vermischt eine gute kurzfristige mit einer schwachen langfristigen Prognose. Legen Sie das Ziel nach der Entscheidung fest: Eine 13-Wochen-Prognose, die Kreditaufnahmen steuert, braucht in den Wochen 1 bis 4 engere Genauigkeit als in Woche 13.
Güte gegenüber einer Baseline. Vergleichen Sie mit einer Naive-Prognose. Das skalierte Maß MASE leistet das: Ein Wert unter eins bedeutet, dass Ihre Prognose die durchschnittliche Naive-Prognose auf den Trainingsdaten schlägt (Forecasting: Principles and Practice).
Ein durchgerechnetes Beispiel
Diese Zahlen sind illustrativ. Ein Unternehmen prognostiziert wöchentliche Zahlungseingänge, in Tausend:
| Woche | Istwert | Prognose | Fehler (Prognose minus Istwert) | Absoluter prozentualer Fehler |
|---|---|---|---|---|
| 1 | 400 | 440 | +40 | 10 % |
| 2 | 250 | 275 | +25 | 10 % |
| 3 | 500 | 520 | +20 | 4 % |
| 4 | 100 | 130 | +30 | 30 % |
MAPE ist der Durchschnitt der vier prozentualen Fehler: (10 + 10 + 4 + 30) / 4 = 13,5 %. Der gewichtete Fehler ist der gesamte absolute Fehler geteilt durch die Summe der Istwerte: 115 / 1.250 = 9,2 %. Bias ist der durchschnittliche vorzeichenbehaftete Fehler: +115 / 4 = +28,75, also wurde jede Woche zu hoch prognostiziert. Diese letzte Zeile ist die eigentliche Erkenntnis. Die Fehlergröße wirkt tolerierbar, doch das Modell ist systematisch optimistisch, und ein Treasurer, der sich darauf verließe, würde weniger Liquidität vorhalten als nötig. Woche 4 zeigt zudem, warum MAPE in die Irre führt: Eine kleine absolute Abweichung in einer kleinen Woche ergibt einen großen Prozentwert.
Testen Sie es richtig
Beurteilen Sie ein Modell nicht an der Historie, an die es angepasst wurde, denn es wird besser aussehen, als es sich bewährt. Halten Sie aktuelle Daten als Testdatensatz zurück, am besten so lang wie Ihr längster Horizont. Noch besser ist die Rolling-Origin-Evaluation (Kreuzvalidierung für Zeitreihen): Trainieren Sie mit Daten bis zu einem Stichtag, prognostizieren Sie vorwärts, erfassen Sie den Fehler, schieben Sie den Stichtag weiter und wiederholen Sie das, sodass das Modell die Zukunft, die es vorhersagt, nie sieht (Forecasting: Principles and Practice).
Praxisbeispiele nach Funktion
Treasury. Ein Corporate Treasurer fährt eine rollierende 13-Wochen-Prognose. Die direkte Methode deckt die Wochen 1 bis 4 aus bekannten Rechnungen und Gehältern ab. Ein statistisches Modell projiziert den ungeplanten Rest, und der Treasurer prüft jeden Montag die Lücke zu den Istwerten. Die AFP-Umfrage setzt die Prognose an die Spitze der Schwierigkeitsliste im Treasury, und 63 % nennen sie eine Top-Priorität (AFP). Das größere Treasury-Bild finden Sie unter KI im Treasury.
Debitorenbuchhaltung. Ein Kreditcontroller gibt dem Cash-Team für jede offene Rechnung ein prognostiziertes Zahlungsdatum statt des Fälligkeitsdatums. Kunden, die 15 Tage zu spät zahlen, werden aus der Woche geschoben, die der Vertrag nahelegt. Das Inkassoteam bearbeitet die Rechnungen, bei denen das Modell ein weiteres Abrutschen erwartet.
FP&A. Ein Analyst nutzt die Baseline des Modells für die ersten 12 Wochen und legt geplante Ereignisse darüber. Die Baseline ist über KI in FP&A mit dem Jahresplan verknüpft, und die Bandbreite der Ergebnisse lässt sich mit einer Monte-Carlo-Simulation durchspielen, wenn das Board fragt, was bei rückläufigem Umsatz passiert.
Gründer und kleine Finanzteams. Ein Startup mit einer einzigen Finanzverantwortlichen verfolgt Burn Rate und Runway. Ein einfaches Modell auf Basis der Bankhistorie und einer kurzen Liste bekannter Verpflichtungen schlägt eine Tabelle mit optimistischen Annahmen, solange jemand die Abweichungen festhält.
So führen Sie es ein, Schritt für Schritt
- Legen Sie zuerst die Entscheidung fest. Dient die Prognose der täglichen Liquidität, einem 13-Wochen-Kreditplan oder einer Prüfung des Jahresbudgets? Das bestimmt Horizont und Genauigkeitsziel.
- Setzen Sie die Baseline. Messen Sie Fehlergröße, Bias und Horizontprofil Ihrer aktuellen Prognose über mindestens acht bis zwölf Wochen. Das muss die KI schlagen.
- Bereiten Sie die Daten vor. Ordnen Sie Bankbuchungen Rechnungen zu, bereinigen Sie doppelte Kunden und füllen Sie Lücken bei den Zahlungsdaten. Überspringen Sie das nicht.
- Teilen Sie die Prognose nach Positionen auf. Modellieren Sie Zahlungseingänge, Gehälter, Steuern, Schuldendienst und sonstige Zahlungen getrennt. Nutzen Sie die direkte Methode, wo Posten geplant sind.
- Fangen Sie einfach an. Passen Sie eine saisonale Baseline und ein bis zwei statistische Methoden an, bevor Sie maschinelles Lernen einsetzen. Ergänzen Sie treiberbasierte oder Zahlungsverhaltensmodelle, wo die Daten es hergeben.
- Führen Sie Backtests mit Rolling Origins durch. Bewerten Sie jeden Kandidaten nach Fehlergröße, Bias und Horizont im Vergleich zur Naive-Baseline.
- Kombinieren Sie, was funktioniert. Mitteln Sie die besten Kandidaten, bevor Sie etwas Komplexes bauen.
- Behalten Sie eine menschliche Anpassungsebene. Geplante Ereignisse und Einmalposten fließen als sichtbare, benannte Überschreibungen mit einem Verantwortlichen ein. Das ist der Human-in-the-Loop-Schritt.
- Fahren Sie ein Quartal parallel, und vergleichen Sie dann die Prognose des Modells Zeile für Zeile mit dem bisherigen Prozess.
- Prüfen Sie die Abweichungen wöchentlich. Halten Sie fest, welche Positionen danebenlagen und warum, und trainieren Sie nach Plan neu.
Häufige Fallstricke
- Beurteilung an der angepassten Historie. Ein Modell, das auf seinen Trainingsdaten glänzt, kann im nächsten Monat versagen. Halten Sie immer Daten zurück.
- Nur eine Genauigkeitszahl berichten. Das Vermischen von Horizonten und Positionen verbirgt, wo das Modell schwach ist.
- Bias ignorieren. Geringer Fehler bei dauerhafter Überprognose ist ein Liquiditätsrisiko.
- MAPE auf den Netto-Cashflow anwenden. Istwerte nahe null oder negative machen ihn bedeutungslos. Bewerten Sie Bruttopositionen.
- Die Baseline überspringen. Wenn Sie nie mit „derselben Woche im Vorjahr“ vergleichen, können Sie nicht belegen, dass KI einen Mehrwert gebracht hat.
- Unsaubere Abstimmung. Sind Bankbuchungen nicht an Rechnungen gebunden, lernt das Modell das falsche Zahlungsverhalten.
- Das Modell als alleinigen Eigentümer der Zahl behandeln. Jemand im Finanzbereich muss die Prognose verantworten, einschließlich der Überschreibungen. Kompetenzen zählen hier: Nur 34 % der Treasury-Praktiker in der AFP-Umfrage stufen sich bei KI-Wissen als kompetent ein (AFP).
- Nie neu trainieren. Kundenverhalten und Ihre eigenen Konditionen ändern sich. Ein sich selbst überlassenes Modell driftet.
Wie es weitergeht
Wenn Sie in diesem Monat nur eines tun, berechnen Sie Fehlergröße, Bias und Horizontprofil Ihrer aktuellen Prognose für das letzte Quartal. Daran sehen Sie, ob das Problem Rauschen ist (eine bessere Methode kann helfen) oder Bias (die Korrektur einiger Annahmen kann mehr bringen). Prüfen Sie dann Ihre Inputs mit dem Leitfaden zur Datenbereitschaft, lesen Sie in KI in FP&A, wie die Prognose mit der Planung zusammenhängt, und sehen Sie im Blueprint für einen KI-Cashflow-Agenten, wie ein Agent die Aktualisierung nach Zeitplan übernehmen kann.
Head of Finance Strategy
On this page
- Wichtige Fakten
- Was KI an einer Cashflow-Prognose verbessert
- Die wichtigsten Methoden im Vergleich
- Dateninputs: Was das Modell braucht
- So messen Sie die Genauigkeit
- Ein durchgerechnetes Beispiel
- Testen Sie es richtig
- Praxisbeispiele nach Funktion
- So führen Sie es ein, Schritt für Schritt
- Häufige Fallstricke
- Wie es weitergeht