財務におけるAIの精度管理:誤った数値を防ぐ方法
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
財務におけるAIの精度管理とは、AIツールの出力と帳簿、レポート、意思決定との間に置くチェックの総称です。原資料との突合、許容範囲、独立した再計算、照合、そして明確に定められた人によるレビューが含まれます。 ツールを疑うことが目的ではありません。流暢で自信に満ちた誤りは正しい数値と見分けがつかず、両者を分けるのは事前に設計されたチェックだけだからです。
このガイドは、コントローラー、FP&Aリーダー、財務マネージャー、そしてAIツールが関与した数値を承認するすべての方に向けたものです。AIをどこで使うかを検討している段階であれば、まず財務におけるAIのユースケースをご覧ください。監査やSOXの対象範囲が気になる場合は、本記事と併せてAIと内部統制をお読みください。本記事はその土台となる実務レイヤーとして、どのチェックがどの誤りを捕捉するのかを扱います。
重要なポイント
- 上場企業に関する10,231問からなる公開ベンチマークFinanceBenchでは、検索システムを併用したGPT-4-Turboが、著者らの150件のサンプルのうち81%の質問に誤答または回答拒否でした(arXiv)。
- FinanceBenchの著者らが検証した最良の構成であるロングコンテキスト版GPT-4-Turboでも、正答率は79%にとどまりました。また著者らは、単位の誤り、古い数値、誤った論理は「詳細な検査をしなければ気づけない場合がある」と警告しています(FinanceBench論文)。
- 著者らが分類した8,908問のうち66%(5,897問)は数値推論を伴います。これは財務チームが日々行っている種類の計算です(FinanceBench論文)。
- 米国の銀行規制当局のモデルリスク指針(SR 11-7に代わり2026年4月に発出されたSR 26-2)は、客観的な専門家による「有効なチャレンジ」を健全なモデルリスク管理の一部と位置づけています。また、バックテストを含む成果分析を、モデルの出力を現実の結果と比較する手段として説明しています(Federal Reserve SR 26-2)。
- 2025年、Deloitteはオーストラリア政府向けの報告書(当初の評価額は約A$440,000)に捏造された引用文と実在しない研究への言及が見つかったため、A$97,000超を返金しました(CFO Dive)。
AIが数値を間違える理由
生成AIはもっともらしい文章を予測します。スプレッドシートのように計算するわけではなく、データを渡さない限り、御社の元帳を「知っている」わけでもありません。その結果、財務チームが繰り返し目にする失敗パターンがいくつか生じます。用語についてはAIのハルシネーションをご覧ください。
- 架空の内容。 存在しない数値、引用、勘定科目が、自信満々に示されます。
- 数値は正しいが文脈が誤り。 別の期間、法人、通貨、桁(千単位と百万単位)の正しい数値が使われます。
- 誤った計算や論理。 筋道が通っているように見えて、数字が合いません。
- 黙って抜け落ちる項目。 要約や照合から1行が欠落しても、その空白を知らせるものがありません。
- ドリフト。 ベンダーのアップデート、プロンプトの修正、新しいデータソースの追加後に、挙動が変わります。
FinanceBenchの著者らは、このパターンをうまく表現しています。モデルはしばしば「一見まとまりがあり、十分な根拠があるように見える回答(ときには長大な計算と推論のステップを伴う)」を示しましたが、それでも誤っていました(FinanceBench論文)。ひと目では通ってしまうという点で、これが最も危険な種類の誤りです。検索を併用すれば改善できます。自社の文書にモデルを接続するという考え方が検索拡張生成の基本だからです。ただしベンチマークの結果は、検索だけでは出力を安心して計上できないことを示しています。
記録に残る事例:未検証の出力が招いたコスト
いずれも財務チームの決算プロセスの事例ではありませんが、AIの出力を実質的なチェックなしに外部へ出した場合に何が起きるかを示す公的な記録です。
架空の参考文献を含むコンサルティング報告書。 オーストラリアの雇用・職場関係省向けのA$440,000の報告書に、連邦裁判所の判決から捏造された引用文と、実在しない学術論文への言及が含まれていました。Deloitteは報酬の4分の1に満たないA$97,000超を返金し、省は審査の実質的な内容は維持されたと述べました(CFO Dive)。財務への教訓は、専門家が作成した成果物でもAIによる捏造がクライアントの手元に届き得ること、そしてそのコストは返金に加えて評判の毀損だということです。
裁判所提出書面の偽の引用。 Mata v. Aviancaでは、ニューヨークの連邦裁判所が、実在しない判例(ChatGPTが生成したもの)を含む準備書面を提出した弁護士らに制裁を科しました。2023年6月22日の命令は、法律事務所と弁護士らに連帯して5,000ドルの制裁金を課し、意図的な回避と誤解を招く陳述に基づいて悪意があったと認定しました。同裁判所は、信頼できるAIツールの利用自体が本質的に不適切なわけではないが、弁護士は正確性の門番として行動しなければならないとも述べています(Reed Smith)。同じ論理は、提出書類、照合、経営レポートに署名するすべての人に当てはまります。
方針を誤って説明したチャットボット。 Moffatt v. Air Canada(2024 BCCRT 149)では、ブリティッシュコロンビア州の審判所が、自社チャットボットによる誤った忌引運賃の案内(同社のウェブサイトの別ページと矛盾していました)について航空会社の責任を認めました。審判所は、ウェブサイト上のすべての情報について責任を負うことは「Air Canadaにとって自明のはず」だと述べています(McCarthy Tetrault)。財務部門のチャットボットが従業員に誤った立替精算の上限額を伝えたり、仕入先に誤った支払日を伝えたりすれば、その回答の責任を負うことになると考えるべきです。
業務そのものを対象にしたベンチマーク。 FinanceBenchは財務に最も近い事例で、上場企業の開示書類から作成した質問を用い、著者らは2,400件のモデル回答を手作業でレビューしました(arXiv)。これは質問応答のテストであり、御社が購入し得る特定の製品のテストではなく、モデルもその後変化しています。それでも、現実的な財務の質問に対する誤り率が小さくなかったことは示しています。
精度管理の5つのレイヤー
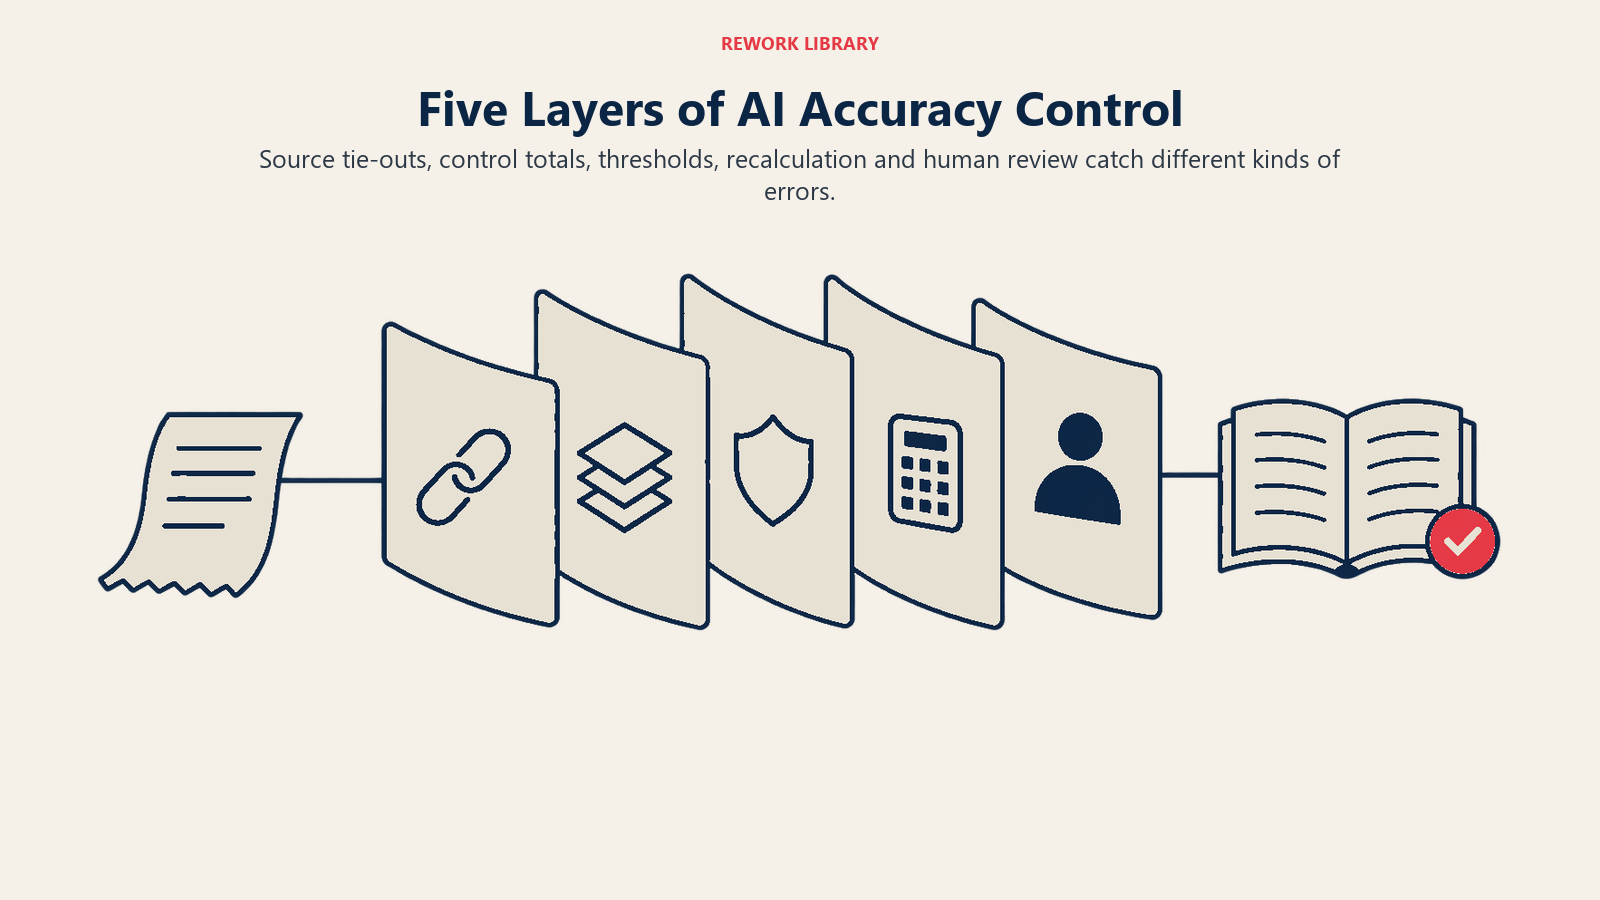
優れた統制は積み重ねて機能します。1つのチェックですべての種類の誤りを捕捉することはできないため、モデルと元帳の間に複数のレイヤーを置きます。
1. 原資料との突合
AIが出力するすべての数値を、請求書、銀行取引明細書、契約書、元帳残高といった原資料またはシステム記録まで遡って確認します。抽出ツールの場合は、サンプルを原本と照らして再実施します。要約やコメントの場合は、レビュー担当者が記載された各数値から元のレポートまでたどります。ツールが数値の出典を示せないなら、その数値は採用しません。
2. 照合とコントロールトータル
合計値は、1行ずつのチェックでは見逃す項目、特に黙って抜け落ちる項目を捕捉します。入力されたレコードと出力されたレコードの件数と合計を比較します。抽出した請求書の明細行が請求書合計と一致するか、照合済み項目と未照合項目の合計が銀行取引明細書の残高と一致するか、補助元帳が総勘定元帳と一致するかを確認します。コントロールトータルは低コストで構築でき、あらゆる種類の失敗を捕捉します。照合ツールが照合できなかった項目をどう表面化させるかは、AIによる銀行勘定調整をご覧ください。
3. しきい値と許容範囲
出力を自動で受け入れるか、レビューするか、却下するかについて、明確なルールを設けます。代表的なトリガーは次のとおりです。
- 金額が設定値を超える
- 信頼度スコアが設定レベルを下回る
- 新規の仕入先、新規の勘定科目、初めて見るパターン
- 前期または予算に対する差異が設定した割合を超える
- 記録と比べて通貨、法人、期間が一致しない
しきい値はベンダーの初期設定ではなく、自社の誤りデータから決め、四半期ごとに見直してください。緩すぎれば誤りが通り、厳しすぎればレビュー担当者が処理しきれなくなり、確認せずに承認ボタンを押し始めます。
4. 独立した再計算
数値に関わるものは、モデルの外で再計算します。スプレッドシート、データベースのクエリ、ルールエンジンのいずれかでAIが示した数値を計算し直して比較します。これは計算ミスという失敗への正しい対処です。文章の下書きと説明は言語モデルに任せ、計算は決定論的なソフトウェアに任せましょう。差異分析がよい例です。ナラティブはAIが下書きしても構いませんが、そこに含まれる各数値はクエリで取得すべきです。詳しくはAIによる差異分析で扱っています。
5. 範囲を定めた人によるレビュー
「人が確認する」だけでは、何を見るのか、何をきっかけにエスカレーションするのか、結果をどこに記録するのかを定めない限り、統制とは言えません。銀行規制当局はSR 26-2でこう述べています。有効なチャレンジとは、客観的な専門家による批判的な分析であり、適切な専門知識を持つ人が、客観性を保てるだけの独立性と、変更を実現させる地位と影響力を持って行うものです(Federal Reserve SR 26-2)。この指針は銀行のモデルを対象に書かれたものですが、基準は他にも応用できます。レビュー担当者には、誤った数値を見抜くスキル、それを指摘する独立性、計上を止める権限が必要です。
どの統制がどの誤りを捕捉するか
| 誤りの種類 | 例 | 最適な統制 |
|---|---|---|
| 架空の内容 | 存在しない勘定科目、仕入先、基準の引用 | 原資料との突合、マスタデータとの照会 |
| 桁または通貨の誤り | 千単位が百万単位として読まれる、EURがUSDとして扱われる | 前期との許容範囲チェック、単位と通貨の検証 |
| 計算ミス | 合計が合わない小計 | 独立した再計算、コントロールトータル |
| 期間または法人の誤り | 第3四半期の要約に第2四半期の数値が入る | 記録との期間および法人の一致確認 |
| 黙って抜け落ちる項目 | 照合から1行が欠落する | 入力と出力のレコード件数およびコントロールトータル |
| もっともらしいが裏づけのないコメント | 根拠のない差異の説明 | レビュー担当者が各主張を元帳までたどる |
| 時間経過によるドリフト | ベンダーのアップデート後に精度が低下する | 成果分析、オーバーライド率のモニタリング、変更管理 |
リスクに応じて統制の強度を合わせる
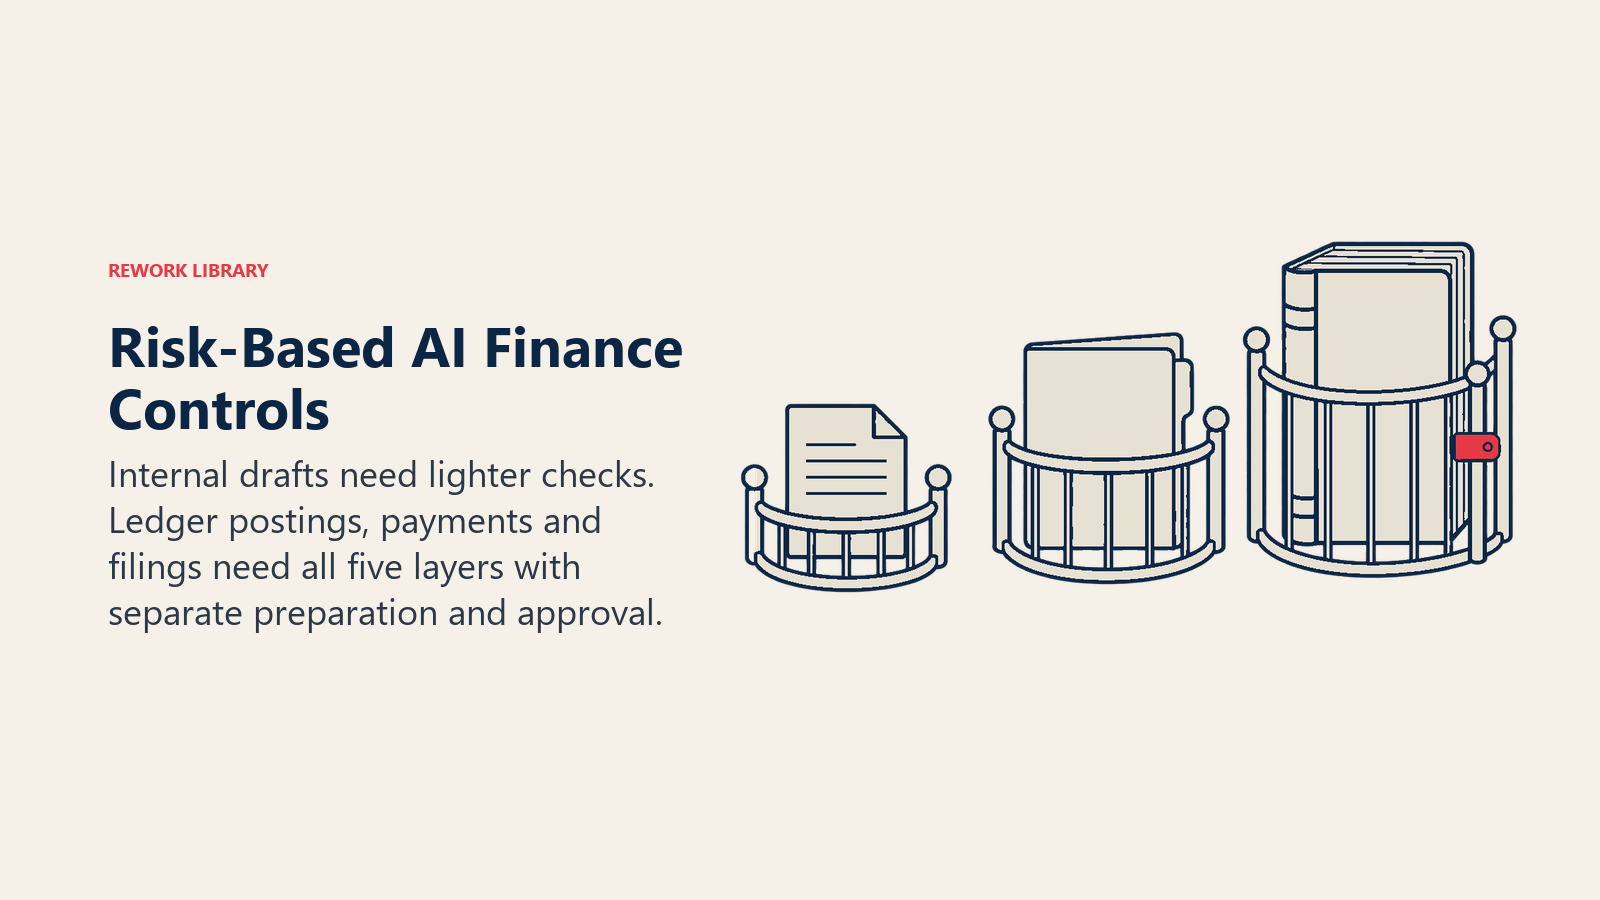
AIのすべての用途に同じ労力をかけるべきではありません。社内会議の要約を下書きするツールは、未払計上や税務上の判断を提案するツールよりも軽い管理で足ります。出力が何に影響するかで区分けしましょう。
| 区分 | 出力の用途 | 最低限の統制 |
|---|---|---|
| 低 | 社内の下書き、ブレインストーミング、調査メモ | 抜き打ちチェック、直接の計上は不可 |
| 中 | 経営報告、予測、コメント | 原資料との突合、独立した再計算、担当レビュー者の指名 |
| 高 | 元帳への計上、支払、提出書類、見積り | 5つのレイヤーすべて、作成者と承認者の分離、証跡の記録、成果テスト |
高リスクの区分では、承認権限をAIに一切持たせないでください。仕訳を準備したツールが、同時にそれを確定させてはいけません。支払など不正のリスクが高いプロセスには、買掛金管理におけるAIで扱う追加の注意が必要です。
精度管理を導入する手順
- AIが数値に触れる箇所を洗い出します。 チームメンバーが個人で導入したツールや、すでに保有しているシステム内のAI機能も含めます。SR 26-2は、包括的なモデル台帳を銀行で一般的な慣行として説明しており、この習慣は取り入れる価値があります(Federal Reserve SR 26-2)。
- 各用途を区分します。 上の表を使い、出力が何に影響するかで分けます。
- 用途ごとに「正解」を定義します。 何が真実の出典か。請求書の読み取りなら文書、照合なら銀行取引明細書、予測なら実績が確定した時点の実績です。
- 稼働前にテストセットを作ります。 実際の匿名化済み事例を数百件集めます。スキャンしたページ、珍しい通貨、分割払いなど、扱いにくいものも含めてください。既知の正解に対してツールを採点します。
- 並行稼働します。 従来のプロセスを数サイクル継続し、1行ずつ比較して、差異とその原因を記録します。
- レイヤーを追加します。 突合、コントロールトータル、しきい値、再計算を可能な限り自動チェックとして組み込み、人によるレビューの手順は確認項目とともに文書化します。
- レビュー担当者が必要とするものをすべて記録します。 入力、出力、ツールまたはプロンプトのバージョン、レビュー担当者、確認した内容、オーバーライドした内容です。
- 成果をモニタリングします。 SR 26-2は、成果分析をモデルの出力と現実の結果との比較と説明しており、これにより重大な誤りや継続的な乖離が表面化することがあります(Federal Reserve SR 26-2)。誤り率とオーバーライド率をツール別・月別に追跡してください。オーバーライド率の上昇は、ツールがドリフトした初期の兆候です。
- 変更を管理します。 モデルのアップグレード、プロンプトの修正、新しいデータソースの追加は、再テストのきっかけとなる変更として扱います。
- 停止ルールを設けます。 どの誤り率でツールを停止するか、誰にその停止権限があるかを事前に決めておきます。
2024年7月26日に公開されたNISTの生成AIプロファイル(NIST AI 600-1)は、AIリスクマネジメントフレームワークの任意利用の補完文書であり、リスク管理部門が公的に認められた参照先を求める場合には、よいチェックリストの出典になります(NIST)。
財務の職種別の例
- 買掛金管理。 請求書の読み取りで、請求書上は12,500.00の合計が1,250.00と読み取られます。突合のサンプルチェックと明細行の合計チェックで捕捉でき、支払のしきい値により資金が動く前にレビューが発動します。
- 月次決算。 下書きされた未払計上が前四半期のレートを引用しています。前期比較で急な変動が指摘され、レビュー担当者が古い入力値に気づきます。
- FP&A。 生成されたコメントが売上は12%増と述べていますが、元帳では9%です。記載するすべての数値は、モデルの文章ではなくクエリから取得するというルールにすれば、この可能性を排除できます。
- 財務(トレジャリー)とキャッシュフロー予測。 支払行動の変化に伴い予測がドリフトします。毎週、実際の現金に対してバックテストを行えば表面化します。
- 税務と収益認識。 モデルが基準を要約する際に、ある条件を省いてしまいます。統制となるのは、資格を持つ担当者が基準の本文と照らして行う技術的レビューです。ここでは速さは目的ではありません。
よくある落とし穴
- 原資料ではなく要約をレビューしてしまう。 AIの出力だけを読むレビュー担当者は、架空の数値を見抜けません。
- 信頼度スコアを信用しすぎる。 高いスコアはモデルが確信していることを意味するだけで、正しいことを意味しません。自社の結果に照らして較正してください。
- オートメーションバイアス。 クリーンな状態が数週間続くと、レビュー担当者は流し読みを始めます。サンプルを入れ替え、実際にレビュー担当者がどのくらいオーバーライドしているかを測定してください。
- 一度きりのテスト。 3月にパスしたパイロット導入の結果は、9月のモデル更新後の挙動についてほとんど何も語りません。
- AIにAIをチェックさせる。 2つ目のモデルはトリアージの助けにはなりますが、結論の責任は人または決定論的なルールが負わなければなりません。
- 誰も調整していないしきい値。 初期設定が自社の取引量やリスクに合うことはまれです。自社の誤りの履歴から設定してください。
- 停止ルールがない。 失敗しているツールを停止させる権限を誰も持たないなら、ツールは計上を続けます。
- 足元のデータが弱い。 マスタデータが乱れ、勘定科目表に一貫性がなければ、あらゆる統制が難しくなります。土台づくりについてはAIに向けた財務データの準備をご覧ください。
測定すべき指標
- 原資料または実績に対する誤り率(ツール別、ユースケース別)
- 検出率:統制で発見された誤りと、計上後に発見された誤りの割合
- オーバーライド率と、レビュー担当者が挙げる理由
- 確認せずに承認すること(ラバースタンプ)や過負荷を見つけるための、1件あたりのレビュー時間
- すり抜け:元帳やレポートに到達した誤りと、通過した経緯
- テストのカバー率:最新のテストセットと担当オーナーが定められているAI利用の割合
次に読む記事
チームで最も重要な数値に影響するAIの用途を1つ選び、今月中に3つのチェックを設けてください。突合のサンプルチェック、コントロールトータル、文書化したレビュー手順です。そのうえで成果の追跡を加えれば、ベンダーが示す数値ではなく実際の誤り率が分かります。ガバナンス全体像については、作業が人とツールの間で移っていく中で、各統制を誰が担うのかを検討してください。
財務におけるAIの精度管理に関するよくある質問
財務におけるAIの精度管理で最も重要なものは何ですか?
原資料との突合です。数値が、由来するとされる文書や元帳の記録と一致するかという最も重要な点を検証するからです。行単位のチェックでは見逃す抜け落ちを捕捉するコントロールトータルと組み合わせてください。
自社の文書から検索すれば、AIの間違いを防げますか?
減らすことはできますが、なくすことはできません。FinanceBenchの調査では、検索システムを併用したGPT-4-Turboが著者らのサンプルの81%の質問に誤答または回答拒否でした。そのため、根拠づけされた出力にもチェックが必要です。
財務でAIの出力を人がレビューする頻度はどのくらいが適切ですか?
区分によります。元帳への計上、資金移動、提出書類に使われる出力は、指名された担当者が毎回レビューすべきです。リスクの低い下書きはサンプリングで構いませんが、誤りデータやモデルの変更が必要だと示した時点でサンプル率を引き上げてください。
1つ目のAIモデルを2つ目のAIモデルにチェックさせれば十分ですか?
それだけでは不十分です。2つ目のモデルはレビュー対象の選別には役立ちますが、どちらも似た形で間違える可能性があります。結論は、決定論的な再計算か、結果にチャレンジする権限を持つ人が担うべきです。
AIの誤りが実際に結果を招いた事例はありますか?
あります。連邦裁判所はChatGPTが生成した偽の判例引用をめぐって弁護士らに制裁を科し、審判所はAir Canadaに対してチャットボットの誤った運賃案内の責任を認め、Deloitteは捏造された参考文献を含む報告書を巡って政府からの報酬の一部を返金しました。
こうした統制は小規模な財務チームにも当てはまりますか?
はい、軽い形で当てはまります。小規模なチームでも、月次の突合サンプルチェックを実施し、スプレッドシートでコントロールトータルを管理し、計上されるものには必ず2人目の承認者を求めることができます。原則は同じで、未検証のAIの数値を帳簿に載せないことです。