AIによる銀行勘定調整:自動照合の仕組み
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
AIによる銀行勘定調整とは、照合ルールと機械学習モデルを使って、各銀行取引を対応する元帳の記帳と突き合わせ、確度の高い照合を自動で消し込み、不確かなものを担当者に回す仕組みです。 勘定調整そのものを置き換えるわけではありません。作成者がレビューし、署名することに変わりはありません。変わるのは時間の使い方で、何千行もの明白な明細に印をつける作業から、判断が必要なわずかな明細の解決へと移ります。
このガイドは、照合エンジンを購入する前、設定する前、その出力を承認する前に、その内部で何が起きているのかを理解したいコントローラー、財務マネージャー、経理リーダー向けです。照合の種類、ルールベースと学習による照合の違い、信頼度のしきい値と例外処理キューの仕組み、レビュー担当者の判断からシステムが学ぶ方法、監査人が確認したがる内容を扱います。全体像については、まず財務・会計におけるAIをご覧ください。
重要なポイント
- 銀行勘定調整は、銀行取引明細書の行を元帳の記帳と突き合わせます。照合には1対1、1対多、多対1、多対多の4つの形があります。最初の1つは簡単です。残りの3つに、手作業の負担と誤りが集中します。
- The Journal of Finance and Data Scienceに掲載された2025年の研究は、3年分の実際の記帳データでグラフベースの機械学習を検証し、業界標準のツールより照合精度が有意に高かったと報告しています。最も大きな改善は、1回の支払で複数の請求書を決済する1対多の照合で見られました(Munoz, Jalili and Tafakori, 2025)。
- 送金するXML形式の支払にエンドツーエンドIDを付与すると、その識別子が銀行取引明細書に戻ってくるため、自動で消し込まれる明細の割合を高められます。同じ指針は、この効果を得るには、支払を一括ではなく個別に決済することを検討する必要があるとしています(The Global Treasurer)。
- 信頼度のしきい値を超えるものだけを自動で消し込み、それ以外はすべてキューに回し、すべての照合の理由を記録します。説明できない照合は統制上のギャップです。
銀行勘定調整が証明しようとしていること
銀行勘定調整は、元帳上の現金残高が、既知の差異を考慮したうえで、銀行が報告する残高と一致していることを証明します。差異の大半はタイミングによるものです。振り出したがまだ決済されていない小切手、未達の預入、まだ計上していない銀行手数料などです。それ以外はすべて、説明が必要な誤りまたは不正のシグナルです。
作業の中身は照合です。銀行取引明細書の各行について、対応する元帳の記帳(1件または複数件)を誰かが見つけなければなりません。複数の口座と通貨にまたがって大規模に行うと、月次決算で最も時間のかかるステップの1つになります。取引量が多く、反復的で、手順が十分に文書化されているため、財務チームが最初に自動化するプロセスの1つでもあります。
4つの照合タイプ
自動化の難しさの大半は、1つの銀行明細が元帳のいくつの項目を表し得るかに起因します。
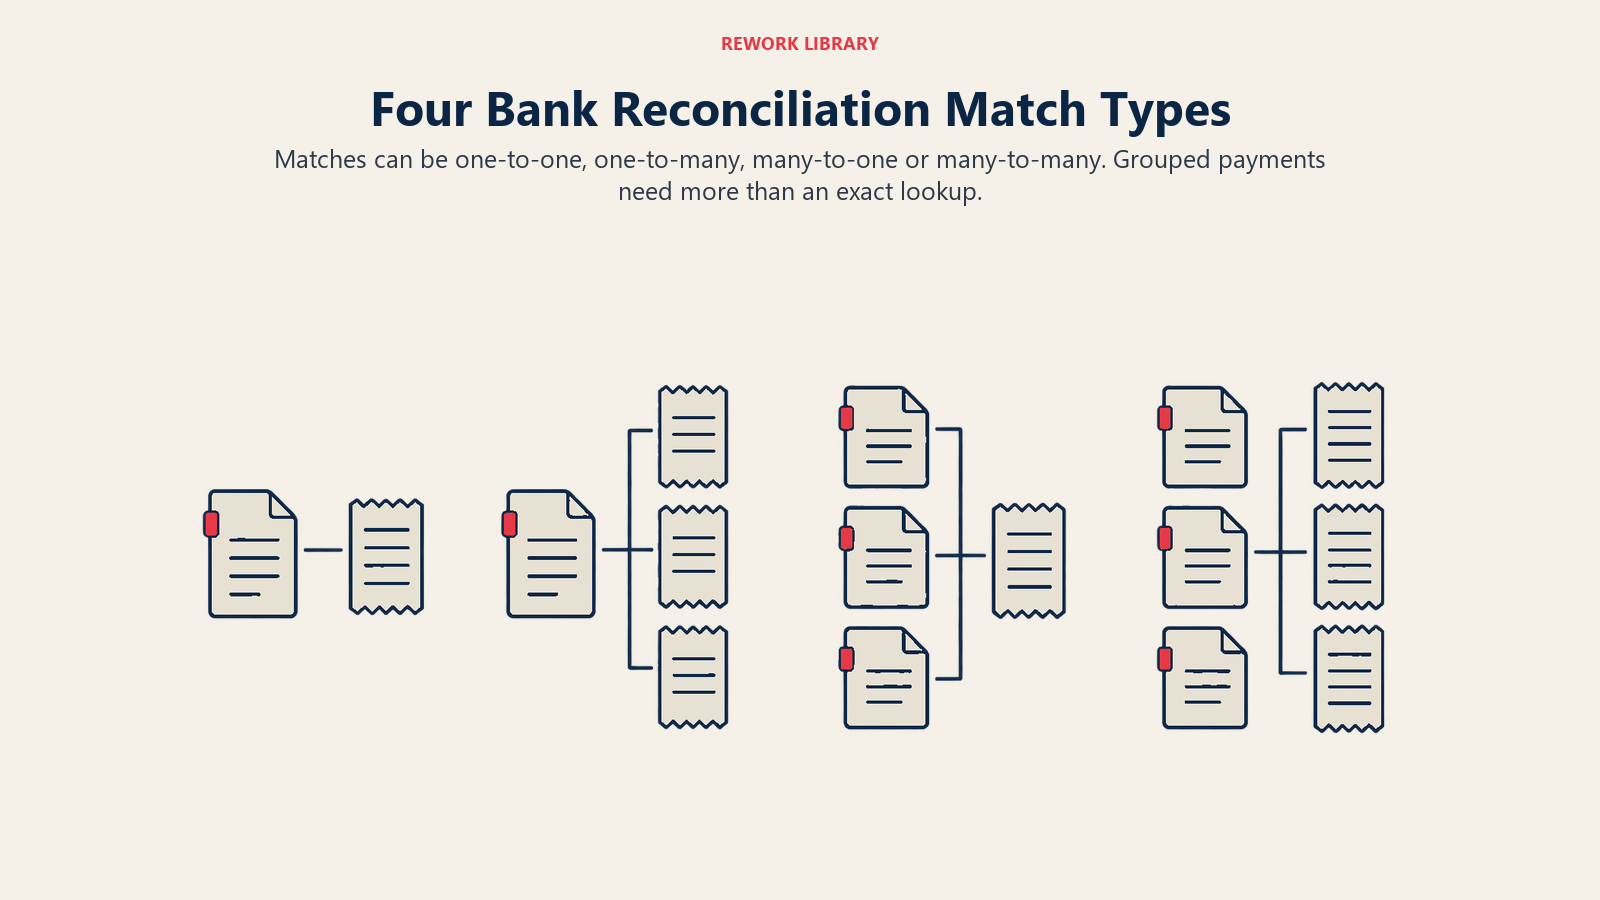
| 照合タイプ | 概要 | 例 | 難易度 |
|---|---|---|---|
| 1対1 | 銀行明細1行に元帳の記帳1件 | $2,450.00のカード入金が、計上済みの入金1件と一致する | 低 |
| 1対多 | 銀行明細1行に元帳の記帳が複数件 | 顧客が未決済の3件の請求書分として$12,400を支払う | 中から高 |
| 多対1 | 銀行明細が複数行に元帳の記帳1件 | $9,000の仕入先への支払が3回の銀行引落に分割される | 中 |
| 多対多 | 銀行明細が複数行に元帳の記帳が複数件 | 決済代行事業者が、1日の売上を手数料と返金を差し引いた純額で決済する | 高 |
1対1の照合は完全一致の検索です。それ以外は探索の問題で、どの項目の組み合わせがこの金額になるのかを探します。未決済の項目が増えるにつれ、考えられる組み合わせの数は急速に増えるため、優れたエンジンは合計をテストする前に、日付、取引先、参照情報を使って候補を絞り込みます。パイロット導入で照合ツールの挙動を見たいなら、1対多と多対多のケースをあえて投入してください。基本的なツールと優れたツールを分けるのは、そうしたケースです。
ルールベースの照合
ルールベースのエンジンは、明示的な指示を決められた順序で適用します。典型的なルールセットは次のようなものです。
- 金額と参照情報が完全に一致するものを照合します。
- 金額が完全に一致し、取引先が同じで、日付が3日以内のものを照合します。
- 金額が小さな許容範囲(たとえば銀行手数料)以内で、取引先が同じものを照合します。
- 同じ取引先の複数の元帳項目のうち、合計が銀行明細と等しくなるものをグループ化します。
ルールは透明です。作動したルールを読めば、照合された理由を説明できます。一方で脆くもあります。参照欄に「INV 4412 and 4413」と書いて支払う顧客は、そのパターンを解析するルールを書いていない限り照合されません。控除された源泉徴収税の分だけ不足した一括払いをする支払人も、誰かが想定していない限り照合されません。支払人の新しい振る舞いごとに新しいルールが必要になり、ルールセットは誰も全体を理解できなくなるまで膨らむ傾向があります。
それでも、ルールは確定的なケースには適切な道具です。合計が分かっている給与の一括処理、ローンの返済、定期的な口座引落、そして支払に信頼できる識別子が付いているものすべてがそれに当たります。
機械学習による照合
学習型(確率的)の照合エンジンは、「これはルール3を満たすか」とは問いません。金額の近さ、日付のずれ、銀行の摘要と元帳のメモの文字列の類似度、取引先の過去の行動、この組み合わせが過去にどのくらいの頻度で照合されたかといった多くのシグナルを同時に使い、各候補の組やグループが真の照合である可能性を採点します。
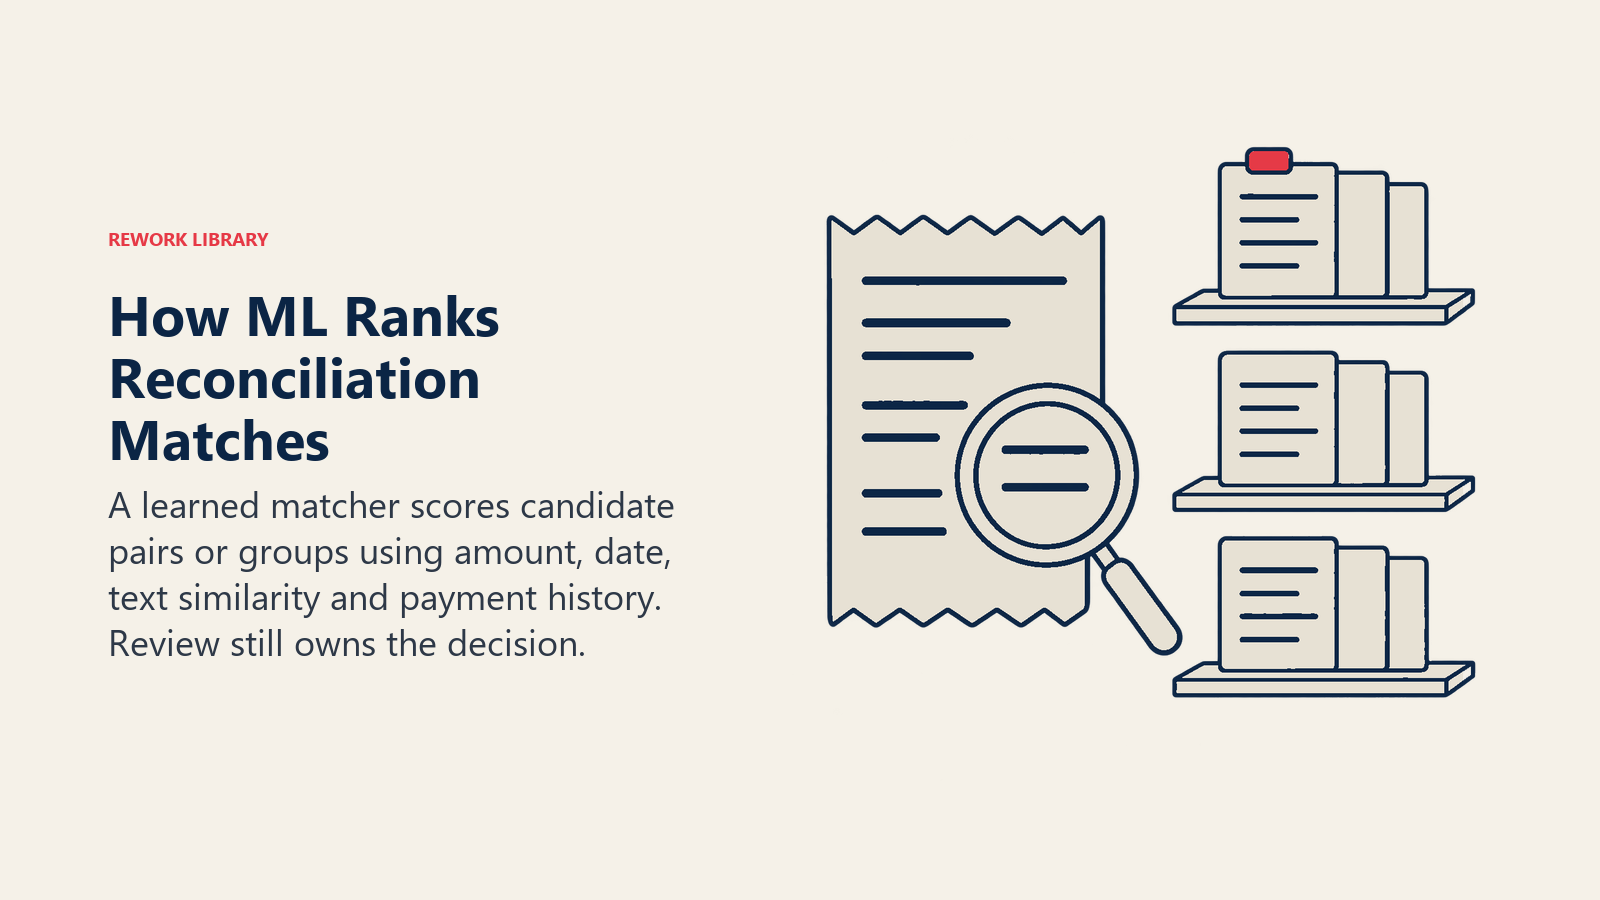
出力は、それぞれ信頼度スコアが付いた候補の順位付きリストです。これが決定的な違いです。ルールは作動するか、しないかです。モデルは「これは97%確実で、あれは62%確実です」と言い、両者を別々に扱えるようにします。
研究は最も難しいケースでさらに前進しています。前述の2025年の研究は、総勘定元帳をグラフとしてモデル化し、記録とその照合を相互に接続されたノードとして扱いました。そして、1回の支払で複数の請求書を決済する1対多の照合で最大の精度向上が見られたと報告しています。また、BERTのようなテキスト埋め込み手法に比べ、繰り返しの学習実行の間の不安定さがはるかに小さいことも報告しており、同じ入力が同じ出力を生むことを求める財務にとっては重要です。結果は自社のデータに大きく左右されるため、CFOに約束するベンチマークではなく、方向性を示すエビデンスとして扱ってください。
ルールベースと機械学習による照合の比較
| 観点 | ルールベース | 機械学習/確率的 |
|---|---|---|
| 判断の仕方 | 決められた順序の固定的なif-then条件 | 多くのシグナルから候補を採点する |
| 乱れた参照情報や略語 | そのパターン用のルールを書かない限り失敗する | ノイズや部分的な文字列を許容できる |
| 1対多と多対多 | 既知のグルーピングには有効だが限界がある | 可能性の高いグルーピングの順位づけが得意 |
| 説明可能性 | 直接的:作動したルールが分かる | 理由コードと記録された特徴量のシグナルが必要 |
| 導入の手間 | ルールを手作業で書き、調整する | 学習に使う履歴が必要で、その後に調整する |
| 時間経過での挙動 | 誰かが編集するまで変わらない | レビュー担当者のフィードバックで改善し得る |
| 典型的な用途 | 識別子が豊富で安定した流れ | 変動が大きく、自由記述が多く、取引量の多い流れ |
優れた構成の多くは両方を組み合わせています。まずルールで確定的な項目を消し込みます。低コストで、完全に説明できるからです。モデルは残りを処理します。そして第3の層である例外処理キューが、どちらも確信を持てないものを受け止めます。
信頼度のしきい値と自動照合
信頼度のしきい値は、システムで最も重要な設定です。いくつの照合が自動で消し込まれ、いくつが人に回るかを決めます。
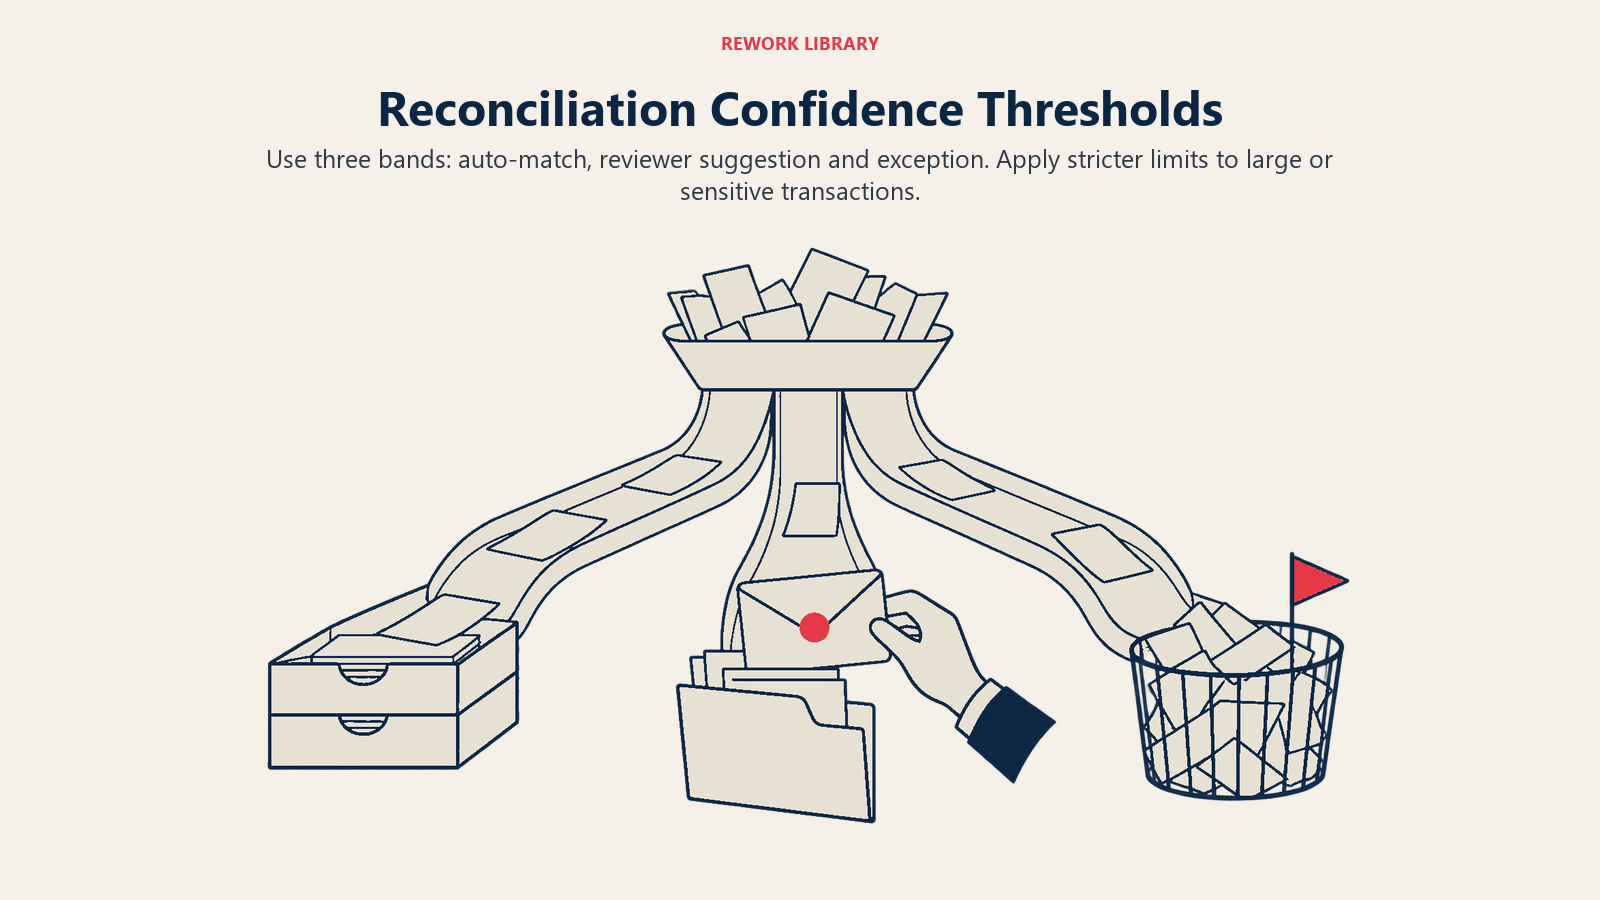
一般的な設計では、3つの帯域を使います。
- 自動照合(高い信頼度)。 システムがレビューなしで照合し、消し込みます。この帯域は最初は保守的に設定してください。
- 候補提示(中程度の信頼度)。 システムが照合を提案し、レビュー担当者がワンクリックで承認または却下します。
- 例外(低い信頼度または候補なし)。 その項目は、提案なし、または候補の短いリストとともにキューに入ります。
境界線をどこに引くかは、2種類の誤りのトレードオフです。偽陽性は、誤った照合が消し込まれてしまうことです。本当の差異を隠してしまうため、こちらが危険です。偽陰性は、正しい照合がキューに回されることです。レビュー担当者の時間はかかりますが、それ以外の損失はありません。2つの誤りは同等ではないため、自動照合のしきい値は高めに始め、毎週、自動で消し込まれた項目のサンプルをレビューし、サンプルの誤り率が裏づける場合にのみしきい値を下げてください。
すべてに単一のしきい値を使わないでください。$40のカード手数料の明細と$400,000の電信送金が、同じ基準であってはなりません。多くのチームは、金額の上限を超えるものにはより厳しいしきい値を設定し、大口の照合には2人の承認を求め、グループ会社間取引や仮勘定など特定の勘定に関わる項目は自動で消し込まないようにしています。
例外処理キュー
作業が今や存在するのは例外処理キューなので、意図して設計してください。有用なキューは4つのことをします。
理由を分類する。 「未照合」は理由ではありません。よい分類には、元帳の候補が見つからない、同程度に可能性の高い候補が複数ある、金額が許容範囲を超えて異なる、重複の可能性がある、タイミングの差異の可能性が高い、などがあります。分類ごとに対処法が異なります。
優先順位をつける。 到着順ではなく、金額と経過日数で並べ替えます。12日間未決済の大きな未照合入金は、今朝の5件の小さな手数料よりも重要です。
証拠を示す。 レビュー担当者は、他の3つの画面を開かなくても、銀行明細、上位の候補、それぞれのスコア、スコアの根拠となったシグナルを見られるべきです。
担当者と期限がある。 各例外に担当者と滞留の目標日数を設定します。設定した日数を過ぎて残る未照合項目は、コントローラーにエスカレーションされます。
例外の中には、照合の失敗ではなく、実際の会計上の事象であるものもあります。未計上の手数料、受取利息、クレジットノートが必要な顧客の差引などです。キューでは、通常の承認限度額に従ったうえで、レビュー担当者が不足している記帳を作成できるようにして、項目がチーム間を行き来しないようにしてください。
レビュー担当者の判断からの学習
レビュー担当者の判断は学習データです。担当者が提案を承認し、却下し、あるいは別の候補を選ぶたびに、自社の業務で正しい照合がどういうものかを示すラベル付きの例がシステムに蓄積されます。
うまく使えば、これがシステムが自社特有の支払人、参照情報の形式、決済パターンに強くなる仕組みです。この学習を安全に保つための実践がいくつかあります。
- 判断と判断者を記録する。 承認またはオーバーライドされた各照合には、ユーザー、時刻、却下された代替候補を紐づけます。
- 訂正と承認を区別する。 最上位の提案をオーバーライドしたレビュー担当者は、承認した担当者よりはるかに多くのシグナルを与えています。それに応じて重みづけします。
- 継続的ではなく、スケジュールに沿って再学習する。 決算期間の途中でモデルの挙動を変えると、結果を比較しにくくなります。期間の合間に更新し、過去の照合のホールドアウトセットでテストし、以前のバージョンを使える状態に保ってください。
- ドリフトに注意する。 新しい銀行、新しい決済代行事業者、顧客の支払行動の変化で、精度が低下することがあります。自動照合率とレビュー担当者のオーバーライド率を毎月追跡してください。オーバーライド率の上昇は早期警戒のサインです。
- 悪い習慣から学習させない。 急いでいたレビュー担当者が1週間すべてを「承認」したなら、モデルもそれを学習してしまいます。出力だけでなく、判断もサンプルで確認してください。
監査可能性:すべての照合が説明可能でなければならない
監査人や規制当局は、モデルが平均的に正確かどうかを気にしません。彼らが尋ねるのは、なぜこの$12,400の入金がこの3件の請求書に対して消し込まれたのか、誰が、あるいは何が判断したのか、誰かがレビューしたのかということです。答えが「アルゴリズムがそう判断したから」であれば、統制上の不備があります。
各照合について、最低限、次の項目を記録してください。
- 関係する銀行明細と元帳の記帳(識別子付き)
- 方法(ルール番号またはモデルのバージョン)と信頼度スコア
- 理由コード、または照合の根拠となった主なシグナル
- 自動で消し込まれたのか、提案されて承認されたのか、手動で照合されたのか
- オーバーライドや照合の取消を含む、人の操作のユーザーと日時
- その照合が属する勘定調整の期間
さらに3つの構造的な統制を加えます。第一に、照合を取り消せるようにし、元の照合を削除するのではなく、取消を記録します。第二に、ルール、しきい値、モデルのバージョンの履歴を、変更の承認証跡とともに保持し、期間の締めの時点でどの構成が有効だったかを示せるようにします。第三に、職務分掌を維持します。照合のしきい値を設定する人が、勘定調整を承認する人であってはなりません。
財務チームでAIガバナンスを構築する際の広範な指針としては、財務・会計におけるAIのリスクと統制のセクションがそのまま当てはまります。人によるチェックポイントを書面にし、証跡を文書化するという同じアプローチが、財務部門のあらゆるAIユースケースに引き継げます。
AIによる銀行勘定調整を導入する手順
- 現在の勘定調整を洗い出します。 すべての銀行口座、月間の取引量、受け取る形式(明細ファイル、銀行フィード、決済代行事業者のレポート)、口座ごとの勘定調整にかかる時間を一覧にします。
- 入力データを整えます。 照合の品質はデータに左右されます。仕入先と顧客のレコードの取引先名を標準化し、元帳のメモと参照情報が一貫して入力されていることを確認します。AIに向けた財務データの準備をご覧ください。
- 可能な範囲で構造化された銀行データを使います。 camt.053のようなISO 20022に基づく明細フォーマットは、変更されずに戻ってくるエンドツーエンドの参照情報を運べます。銀行がどの項目を設定しているか確認し、支払ごとの照合が必要な場合は、一括ではなく個別に決済することを検討してください。
- 確定的な流れにはまずルールを使います。 給与、ローンの返済、定期的な引落は、モデルを関与させる前にルールで消し込むようにします。
- 乱れた流れには学習型の照合エンジンを追加します。 自由記述の参照情報が付いた顧客入金や、決済代行事業者の決済が典型的な候補です。
- しきい値を保守的に設定し、レビューの経路を定義します。 3つの帯域、金額の上限、自動で消し込まない勘定を決めます。
- 少なくとも1回の決算は並行稼働します。 従来の方法と新しい方法で並べて勘定調整を行い、すべての差異を比較し、それぞれの根本原因を記録します。
- 測定してから拡大します。 自動照合率、毎週のサンプルから得た偽陽性率、レビュー担当者のオーバーライド率、例外の滞留、勘定調整1件あたりにかけた時間を追跡します。数値が維持されている場合にのみ、次の口座へ拡大します。
- 統制を文書化します。 ツールが何をするのか、誰が責任者か、しきい値をどう変更するか、誰が例外をレビューするかを書き出し、決算の文書の一部にします。決算サイクルのガイドでは、より速い決算カレンダーの中で勘定調整がどこに位置づくかを示しています。
よくある落とし穴
自動照合率を追いかける。 高い率が価値を持つのは、照合が正しい場合だけです。サンプルの誤り率を併せて報告してください。
監査証跡を壊す一括決済。 決済代行事業者が400件の売上を1つの純額で支払う場合、決済明細がなければ、どの行がどの売上に対応するのかをどんなモデルも正確には復元できません。明細レポートを入手し、それに対して照合してください。
本当の差異を隠す許容範囲。 すべての口座に適用される「1ドル以内」の許容範囲は、小さな誤りが繰り返されるのを静かに吸収します。許容範囲は、既知の銀行手数料のように、説明のつく特定のケースに限定してください。
モデルの責任者がいない。 財務の誰かが、しきい値を管理し、毎週のサンプルをレビューし、モデルの更新を承認しなければなりません。それがすべてIT部門やベンダーに任されているなら、その統制は自社のものではありません。
例外処理キューを後回しにする。 チームは90%を自動化したあと、残りの項目を積み上げたままにします。キューには、他の業務と同様にキャパシティプランニングが必要です。
データの整備を省く。 重複した顧客や一貫性のない参照情報は、ルールにもモデルにも照合の品質を下げます。より優れたモデルでも、乱れたマスタファイルは直せません。
AIロードマップにおける位置づけ
銀行勘定調整は、最初のAIプロジェクトに適しています。取引量が多く、出力を銀行が提供する残高と照らして確認でき、人によるチェックポイントが自然に生まれるからです。また、しきい値、例外処理キュー、記録された判断、レビュー担当者のフィードバックといった、今後の取り組みに必要な習慣も身につきます。範囲を広げる準備ができたら、財務AIのユースケースのガイドで他の業務領域を整理しており、売掛金管理におけるAIでは、入金を未決済の請求書に充当するという密接に関連した課題である入金消込を扱っています。勘定調整を最初から最後まで実行するエージェントを検討しているなら、どこまで自律性を与えるかを知るために、まず財務向けAIエージェントをお読みください。