Bahasa Indonesia
Cara AI Agent Bernalar: ReAct, Perencanaan, dan Refleksi
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Sebuah AI agent bernalar dengan bergantian antara berpikir dan bertindak: ia menuliskan pemikiran singkat tentang apa yang harus dilakukan berikutnya, mengambil tindakan (biasanya pemanggilan tool), membaca hasilnya, lalu berpikir lagi sebelum langkah berikutnya. Pola yang saling berselang ini disebut ReAct, dan menjadi fondasi yang dipakai kebanyakan agent. Dua teknik memperluasnya lebih jauh: perencanaan, ketika agent memetakan beberapa langkah sebelum bertindak atas salah satunya, dan refleksi, ketika agent mengkritik upayanya sendiri dan mencoba lagi bila percobaan pertama kurang memadai.
Penalaran Adalah Langkah "Reason" dalam Loop, yang Dibuat Terlihat
Cara kerja AI agent menggambarkan loop agent sebagai persepsi, penalaran, tindakan, observasi, lalu ulangi. Artikel ini membahas apa yang terjadi di dalam langkah penalaran itu, dan ternyata tidak semisterius kedengarannya. "Penalaran" di sini berarti model menghasilkan teks perantara tentang langkah berikutnya sebelum memutuskan sebuah tindakan, dalam percakapan yang sama, sehingga Anda bisa membacanya. Ini bukan proses tersembunyi yang terjadi di tempat lain. Sebuah agent dukungan yang memutuskan cara menangani tiket mungkin menghasilkan sesuatu seperti "pesan ini menyebut pembayaran gagal dan bernada marah, jadi saya sebaiknya memeriksa riwayat transaksi sebelum menyusun balasan" bahkan sebelum memanggil tool apa pun.
Kebiasaan menuliskan langkah-langkah penalaran perantara itu disebut chain-of-thought, dan menjadi blok dasar di bawah semua yang dibahas dalam artikel ini. Apa itu chain-of-thought membahas tekniknya secara tersendiri. Pembahasan di sini secara khusus tentang bagaimana penalaran itu dihubungkan ke dalam loop yang juga mengambil tindakan nyata, yang merupakan masalah berbeda dari bernalar menjawab pertanyaan statis.
ReAct: Bernalar dan Bertindak dalam Loop yang Sama
ReAct, singkatan dari "reasoning and acting", berasal dari makalah tahun 2022 oleh Yao dan rekan-rekannya yang menunjukkan bahwa model bahasa bekerja lebih baik ketika menyisipkan langkah penalaran singkat di antara tindakan, bukan bernalar sampai jawaban akhir lalu baru bertindak, atau bertindak tanpa penalaran sama sekali. Polanya sederhana: Thought, lalu Action, lalu Observation, diulang sampai tugas selesai. Thought menjelaskan apa yang sedang coba dicari tahu agent berikutnya, Action biasanya berupa pemanggilan tool, dan Observation adalah apa yang dikembalikan.
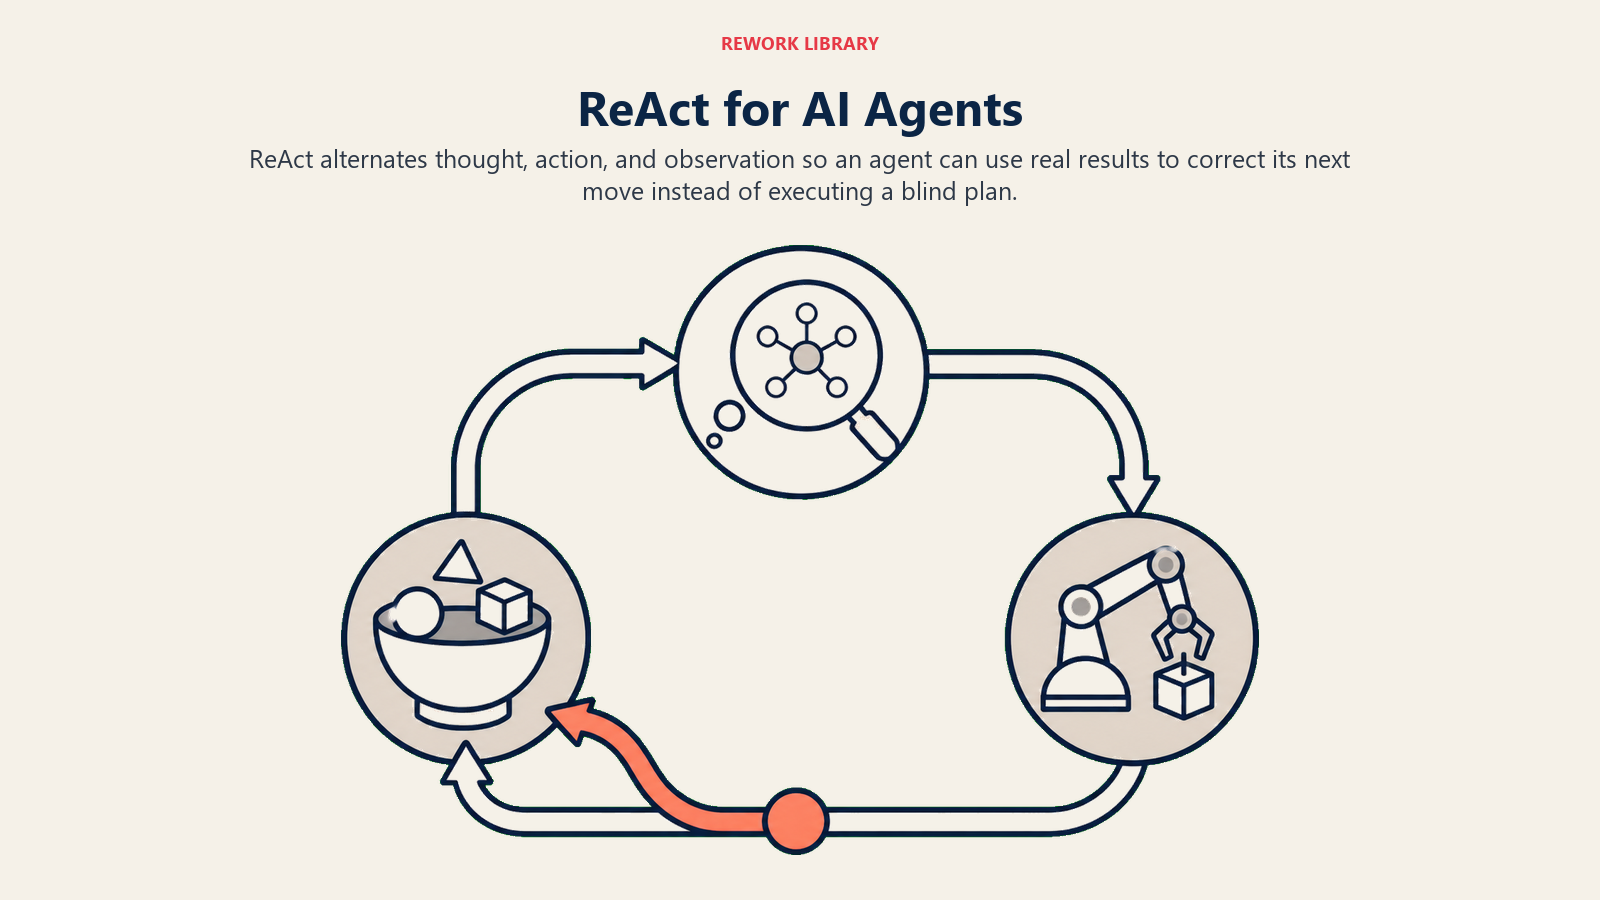
Hasil dari riset aslinya cukup besar. Pada dua benchmark yang menguji pengambilan keputusan interaktif, ALFWorld dan WebShop, ReAct mengungguli baseline imitation dan reinforcement learning sebesar 34 poin persentase (71% berbanding 37%) dan sekitar 11 poin persentase (40% berbanding 29,1%), hanya dengan satu atau dua contoh untuk mendemonstrasikan polanya. Alasan mengapa pola berselang ini lebih baik daripada merencanakan semuanya di awal lalu mengeksekusi secara buta cukup jelas: agent dapat mengoreksi arah berdasarkan apa yang benar-benar terjadi, bukan apa yang diasumsikan akan terjadi. Jika sebuah pencarian tidak mengembalikan hasil yang berguna, thought berikutnya dapat menyatakannya dan mencoba kueri lain, alih-alih terus maju dengan rencana yang dibangun dari tebakan.
Ini adalah mekanisme yang sama di balik loop yang dijelaskan dalam pola Autonomous Agent: menyerap kondisi saat ini, menganalisis apa yang diketahui dan apa yang belum, memprediksi tindakan terbaik berikutnya, menghasilkannya, mengeksekusinya, lalu mengulang. ReAct adalah separuh penalaran dari siklus itu yang dibuat konkret.
Perencanaan: Berpikir Beberapa Langkah ke Depan
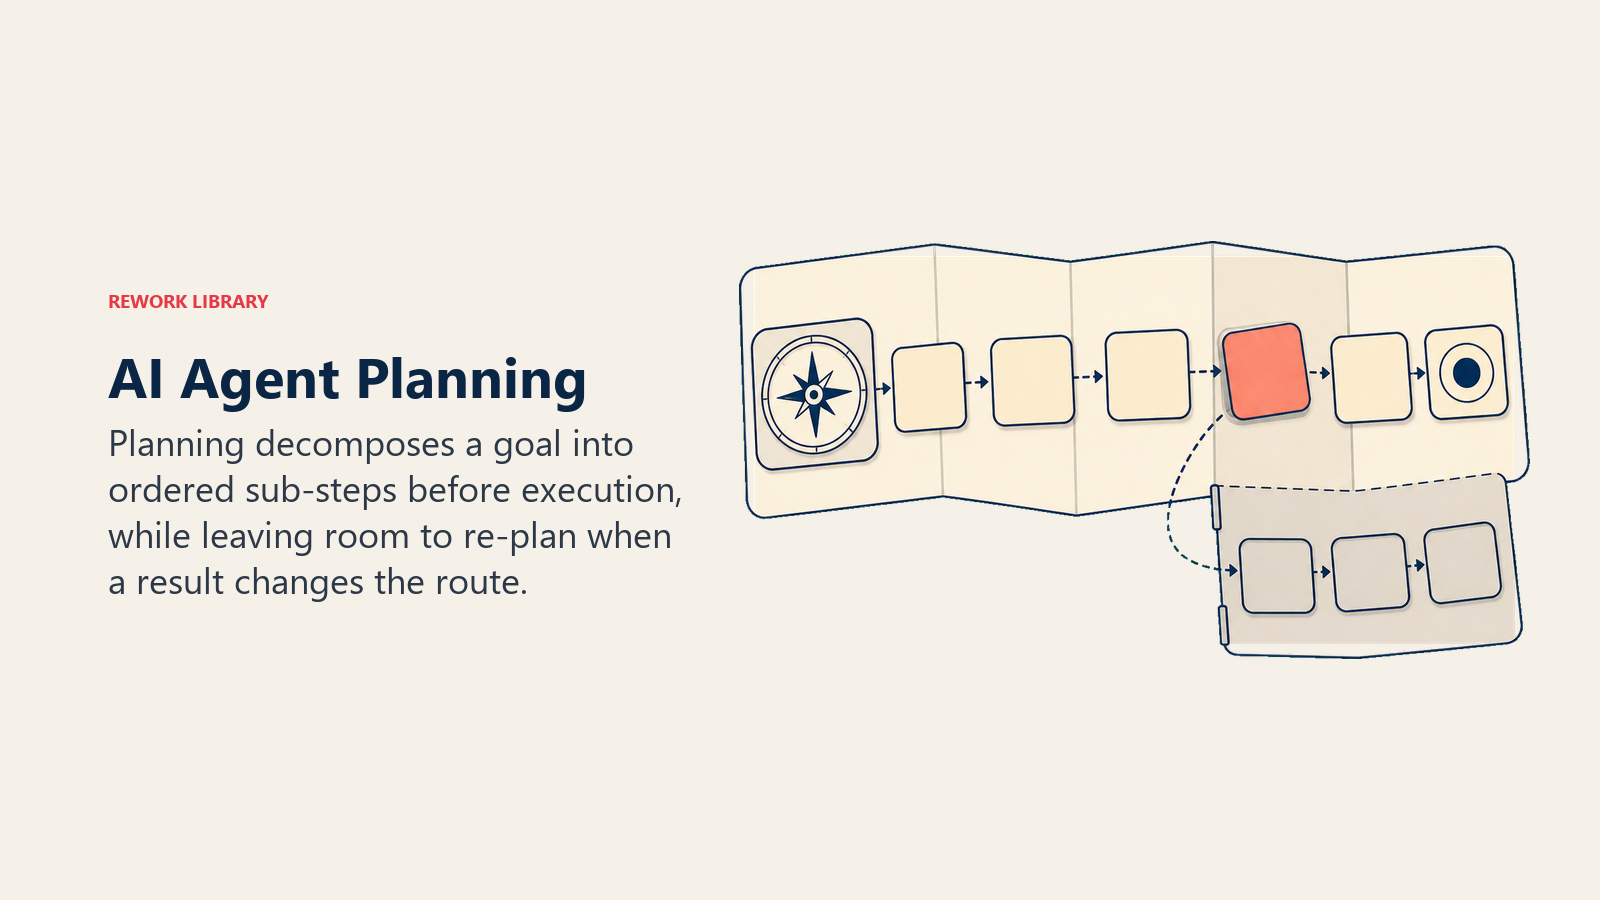
ReAct murni berimprovisasi satu langkah demi satu langkah, yang berjalan baik untuk tugas yang langkah berikutnya baru jelas setelah melihat hasil sebelumnya. Sebagian tugas membutuhkan struktur lebih dari itu. Perencanaan membuat agent menguraikan sebuah tujuan menjadi sub-langkah yang berurutan sebelum mengeksekusi satu pun, lebih mirip menulis kerangka sebelum menyusun draf daripada mengarang kalimat demi kalimat.
Tugas peramalan pendapatan adalah contoh yang baik. Alih-alih berimprovisasi satu kueri demi satu kueri, agent yang dibangun berdasarkan blueprint AI Forecasting Agent akan diuntungkan dengan merencanakan pendekatannya lebih dulu: tarik close rate historis per segmen, periksa cakupan pipeline saat ini, beri bobot deal terbuka menurut tahap, lalu gabungkan semuanya menjadi sebuah rentang. Setiap sub-langkah itu mungkin tetap menjalankan loop ReAct-nya sendiri di dalam, tetapi bentuk keseluruhannya sudah diputuskan di awal, bukan ditemukan langkah demi langkah.
Perencanaan bukan komitmen sekali jadi. Ketika sebuah langkah gagal atau informasi baru mengubah gambaran, agent yang dibangun dengan baik akan merencanakan ulang, bukan memaksakan rencana awal tetap berjalan. Perluasan yang patut diketahui adalah tree-of-thought, ketika agent menjelajahi lebih dari satu kandidat rencana dan membandingkannya sebelum berkomitmen, berguna ketika memang ada lebih dari satu pendekatan yang masuk akal. Apa itu reasoning models membahas wilayah itu, beserta pergeseran yang lebih luas menuju model yang menghabiskan lebih banyak komputasi untuk menimbang sebelum menjawab, secara lebih mendalam.
Refleksi: Menangkap Kesalahannya Sendiri
Refleksi menambahkan kemampuan yang berbeda: setelah menghasilkan sebuah upaya, agent mengevaluasi keluarannya sendiri terhadap tujuan dan merevisinya bila kurang memadai, bukan memperlakukan draf pertama sebagai final.
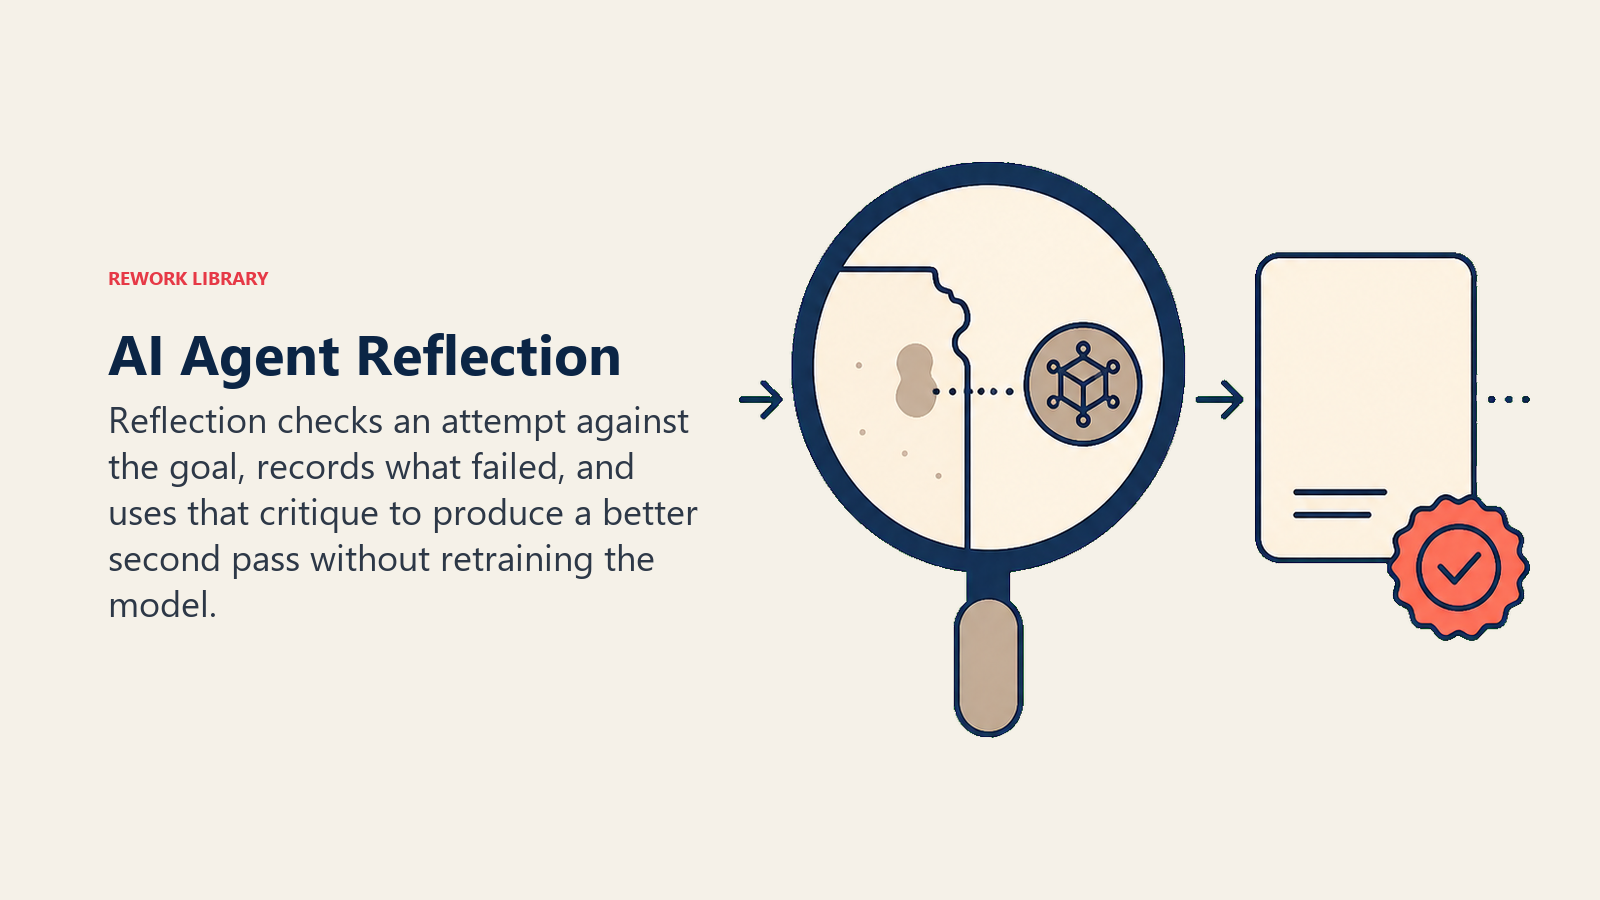
Riset di balik ini, makalah Reflexion tahun 2023 oleh Shinn dan rekan-rekannya, patut diketahui angka sebenarnya. Pendekatan mereka mencapai akurasi pass@1 sebesar 91% pada benchmark pemrograman HumanEval, dibandingkan 80% untuk baseline GPT-4 standar pada saat itu, hanya dengan loop kritik diri verbal yang disimpan dalam memori di antara percobaan. Tanpa pelatihan ulang, tanpa bobot model baru, hanya agent yang membaca upayanya yang gagal, menuliskan apa yang salah dalam bahasa biasa, lalu mencoba lagi dengan catatan itu di dalam konteks. Kritik diri yang tersimpan itu adalah salah satu bentuk memori kerja yang dibahas dalam cara kerja AI agent; jika Anda ingin gambaran lebih lengkap tentang bagaimana agent menyimpan informasi seperti ini lintas langkah dan lintas proses, AI memory adalah rujukan yang lebih mendalam.
Dalam konteks bisnis, blueprint Content Drafting Agent memakai gagasan yang berkaitan: menyusun draf, memeriksa draf terhadap pedoman merek dan elemen yang diwajibkan, lalu merevisi sebelum diserahkan kepada manusia untuk tinjauan akhir. Pemeriksaan mandiri ini tidak menggantikan tinjauan manusia. Ia mengurangi jumlah draf yang tiba dengan masalah yang sebenarnya mudah dihindari dan terlihat jelas.
Menyatukan Semuanya: Contoh Jejak Penalaran
Berikut tampilan ketiga teknik itu ketika digabungkan pada satu tugas nyata. Blueprint AI Research Agent diminta menyusun briefing tentang perusahaan target sebelum panggilan penjualan.
- Rencana. Agent memecah tujuan menjadi sub-tugas: aktivitas pendanaan terbaru, perubahan kepemimpinan, dan berita apa pun dari kuartal terakhir.
- Loop ReAct, sub-tugas pertama. Thought: "Saya perlu berita pendanaan terbaru." Action: mencari. Observation: tiga hasil, satu dari sumber kredibel. Thought: "Ini tampak terkini dan relevan, saya akan membacanya." Action: mengambil halaman. Observation: putaran pendanaan terkonfirmasi lengkap dengan tanggal dan jumlah.
- Loop ReAct, sub-tugas kedua dan ketiga. Siklus thought-action-observation yang sama berulang untuk perubahan kepemimpinan dan berita terbaru, masing-masing loop berhenti begitu agent menilai sudah memiliki sinyal yang cukup.
- Refleksi. Sebelum difinalkan, agent memeriksa drafnya sendiri terhadap tujuan awal: apakah ketiga sub-tugas tercakup, adakah yang sudah usang atau belum terkonfirmasi, adakah klaim yang kehilangan sumber. Jika ada celah, itu menjadi satu pencarian terarah lagi, bukan merilis briefing dengan bagian yang bolong.
Tiga teknik, satu keluaran yang koheren, dan jejak di setiap langkah yang dapat dibaca ulang dan dipahami manusia, yang sama pentingnya dengan jawaban akhir.
Mengapa Kedalaman Penalaran Adalah Trade-off Biaya dan Kepercayaan
Semua ini tidak gratis. Setiap thought yang ditulis agent menghabiskan token, dan setiap siklus ReAct atau putaran refleksi tambahan menambah latensi. Pencarian sederhana tidak membutuhkan perencanaan multi-langkah dan putaran kritik diri; ia membutuhkan jawaban cepat dan langsung. Apa itu reasoning models membahas pertanyaan yang lebih luas tentang kapan penalaran yang diperpanjang dan disengaja sepadan dengan biaya tambahannya dan kapan respons standar yang cepat adalah pilihan lebih baik, perbedaan yang berlaku sama untuk kedalaman penalaran internal agent seperti halnya untuk memilih model.
Sisi lain dari trade-off ini adalah kepercayaan, bukan hanya biaya. Model dapat bernalar sampai pada tindakan yang salah dengan selancar dan seyakin ketika ia bernalar sampai pada tindakan yang benar. Panduan Building Effective Agents dari Anthropic, yang diambil dari penerapan produksi, mengajukan argumen untuk menjaga loop agentic sesederhana yang diizinkan tugasnya, bukan langsung memilih otonomi maksimum, justru karena makin banyak langkah penalaran berarti makin banyak tempat bagi kesalahan untuk masuk tanpa terdeteksi. Karena itu setiap jejak penalaran harus dicatat dan dapat ditinjau, bukan hanya tindakan akhirnya; AI agent observability membahas apa saja yang perlu dicakup lapisan pencatatan dan pemantauan itu.
Key Facts
- Penalaran dalam agent berarti model menghasilkan teks perantara yang terlihat tentang langkah berikutnya sebelum bertindak, paling umum melalui proses bergaya chain-of-thought.
- ReAct menyisipkan penalaran dan tindakan dalam loop yang sama. Dalam riset aslinya, ini mengungguli baseline imitation dan reinforcement learning sebesar 34 poin di ALFWorld dan sekitar 11 poin di WebShop.
- Perencanaan menguraikan tujuan menjadi sub-langkah berurutan sebelum dieksekusi, dan agent yang dibangun dengan baik merencanakan ulang ketika sebuah langkah gagal atau informasi baru mengubah gambaran.
- Refleksi membuat agent mengkritik upayanya sendiri lalu merevisi. Riset Reflexion mencapai pass@1 91% pada HumanEval berbanding baseline 80% memakai loop kritik diri verbal, tanpa pelatihan ulang.
- Penalaran yang lebih dalam membutuhkan lebih banyak token, waktu, dan biaya, serta tidak mengurangi risiko tindakan yang salah namun diyakini benar, itulah sebabnya jejak penalaran perlu dicatat dan dapat ditinjau, bukan sekadar dipercaya.
Pertanyaan yang Sering Diajukan tentang Cara AI Agent Bernalar
Apa itu ReAct pada AI agent?
ReAct adalah singkatan dari reasoning and acting. Ini adalah pola ketika AI agent menyisipkan langkah penalaran singkat (thought) di antara tindakan nyata (biasanya pemanggilan tool) dan membaca hasilnya (observation) sebelum thought berikutnya, bukan bernalar sampai jawaban akhir sebelum bertindak atau bertindak tanpa penalaran sama sekali.
Apa perbedaan antara perencanaan dan refleksi pada AI agent?
Perencanaan terjadi sebelum eksekusi: agent menguraikan tujuan menjadi sub-langkah berurutan di awal. Refleksi terjadi setelah sebuah upaya: agent mengevaluasi keluarannya sendiri terhadap tujuan dan merevisinya bila kurang memadai. Banyak agent produksi memakai keduanya, ditambah penalaran langkah demi langkah ala ReAct di dalam setiap sub-tugas yang direncanakan.
Apakah menambah langkah penalaran membuat AI agent lebih akurat?
Sering kali, tetapi tidak otomatis, dan tidak gratis. Riset tentang pendekatan ReAct maupun berbasis refleksi menunjukkan peningkatan akurasi nyata pada tugas multi-langkah. Namun setiap langkah penalaran tambahan memakan token dan waktu, dan jejak penalaran yang lebih panjang tetap bisa sampai pada kesimpulan yang salah dengan penuh keyakinan, itulah sebabnya jejaknya perlu dicatat dan ditinjau, bukan sekadar dipercaya karena lebih panjang.
Dapatkah AI agent mengoreksi kesalahannya sendiri?
Ya, dengan batasan. Refleksi memungkinkan agent menangkap dan memperbaiki jenis kesalahan tertentu, seperti pengujian yang gagal atau draf yang belum lengkap, dengan mengkritik keluarannya sendiri lalu mencoba lagi. Agent tidak dapat menangkap kesalahan yang tidak terdeteksi dari informasi yang tersedia baginya, itulah sebabnya tinjauan manusia tetap penting untuk keputusan yang berdampak besar.
Bagaimana hubungan penalaran agent dengan reasoning models seperti o1 dari OpenAI?
Keduanya berkaitan tetapi berbeda. Reasoning models dilatih untuk menghabiskan komputasi ekstra untuk menimbang sebelum menanggapi satu pertanyaan. Teknik penalaran agent seperti ReAct, perencanaan, dan refleksi adalah pola untuk menyusun penimbangan itu di seluruh tugas multi-langkah yang juga melibatkan tindakan nyata. Agent dapat dibangun di atas model standar maupun reasoning model, dan pilihannya bergantung pada seberapa kompleks tuntutan penalaran tugasnya.
Apakah chain-of-thought sama dengan penalaran agent?
Chain-of-thought adalah teknik dasarnya: membuat model menuliskan langkah penalaran perantara alih-alih langsung melompat ke jawaban. Penalaran agent dibangun di atas kebiasaan yang sama tetapi menghubungkannya ke dalam loop yang juga mengambil tindakan dan membaca kembali hasil nyata, yang merupakan masalah berbeda dan lebih rumit daripada bernalar menjawab satu pertanyaan statis.
Langkah Selanjutnya
Penalaran menentukan apa yang dilakukan agent berikutnya; cara AI agent menggunakan tool membahas apa yang terjadi setelah keputusan itu berubah menjadi tindakan. Untuk melihat bagaimana loop penalaran satu agent berubah ketika pekerjaan dibagi ke beberapa agent, lihat multi-agent systems. Dan jika Anda siap menerapkannya pada agent Anda sendiri, cara membangun AI agent memandu proses pembangunan dari awal sampai akhir, sedangkan ulasan alat produktivitas dan panduan cara memilih asisten pemrograman AI adalah tempat singgah berikutnya yang berguna jika agent pemrograman yang berat penalaran adalah jenis alat yang sedang Anda evaluasi.

On this page
- Penalaran Adalah Langkah "Reason" dalam Loop, yang Dibuat Terlihat
- ReAct: Bernalar dan Bertindak dalam Loop yang Sama
- Perencanaan: Berpikir Beberapa Langkah ke Depan
- Refleksi: Menangkap Kesalahannya Sendiri
- Menyatukan Semuanya: Contoh Jejak Penalaran
- Mengapa Kedalaman Penalaran Adalah Trade-off Biaya dan Kepercayaan
- Key Facts
- Langkah Selanjutnya