Como os AI Agents Raciocinam: ReAct, Planejamento e Reflexão
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Um AI agent raciocina alternando entre pensar e agir: ele escreve um pensamento curto sobre o que fazer a seguir, executa uma ação, geralmente uma chamada de ferramenta, lê o que aconteceu e pensa de novo antes do próximo movimento. Esse padrão intercalado se chama ReAct, e é a base sobre a qual a maioria dos agents é construída. Duas técnicas o estendem: o planejamento, em que o agent mapeia várias etapas antes de agir em qualquer uma delas, e a reflexão, em que ele critica a própria tentativa e tenta de novo quando a primeira passada fica aquém.
O Raciocínio É a Etapa "Reason" do Loop, Tornada Visível
Como os AI agents funcionam descreve o loop do agent como perceber, raciocinar, agir, observar e repetir. Este artigo trata do que acontece dentro da etapa de raciocinar, e é menos misterioso do que parece. "Raciocínio" aqui significa que o modelo gera um texto intermediário sobre o seu próximo movimento antes de se comprometer com uma ação, na mesma conversa, onde você pode lê-lo. Não é um processo oculto acontecendo em outro lugar. Um agent de suporte decidindo como tratar um ticket pode gerar algo como "esta mensagem menciona um pagamento que falhou e um tom irritado, então devo verificar o histórico de transações antes de redigir uma resposta" antes mesmo de chamar uma ferramenta.
Esse hábito de escrever etapas intermediárias de raciocínio se chama chain-of-thought, e é o bloco de construção por baixo de tudo neste artigo. O que é chain-of-thought trata da técnica isoladamente. O que vem a seguir é especificamente sobre como esse raciocínio é ligado a um loop que também executa ações reais, o que é um problema diferente de raciocinar sobre uma pergunta estática.
ReAct: Raciocinar e Agir no Mesmo Loop
ReAct, abreviação de "reasoning and acting" (raciocinar e agir), vem de um artigo de 2022 de Yao e colegas que mostrou que os modelos de linguagem têm desempenho melhor quando intercalam etapas curtas de raciocínio com ações, em vez de raciocinar até uma resposta final e só então agir, ou agir sem nenhum raciocínio. O padrão é simples: Thought (pensamento), depois Action (ação), depois Observation (observação), repetidos até a tarefa terminar. O pensamento explica o que o agent está tentando descobrir a seguir, a ação costuma ser uma chamada de ferramenta, e a observação é o que voltou.
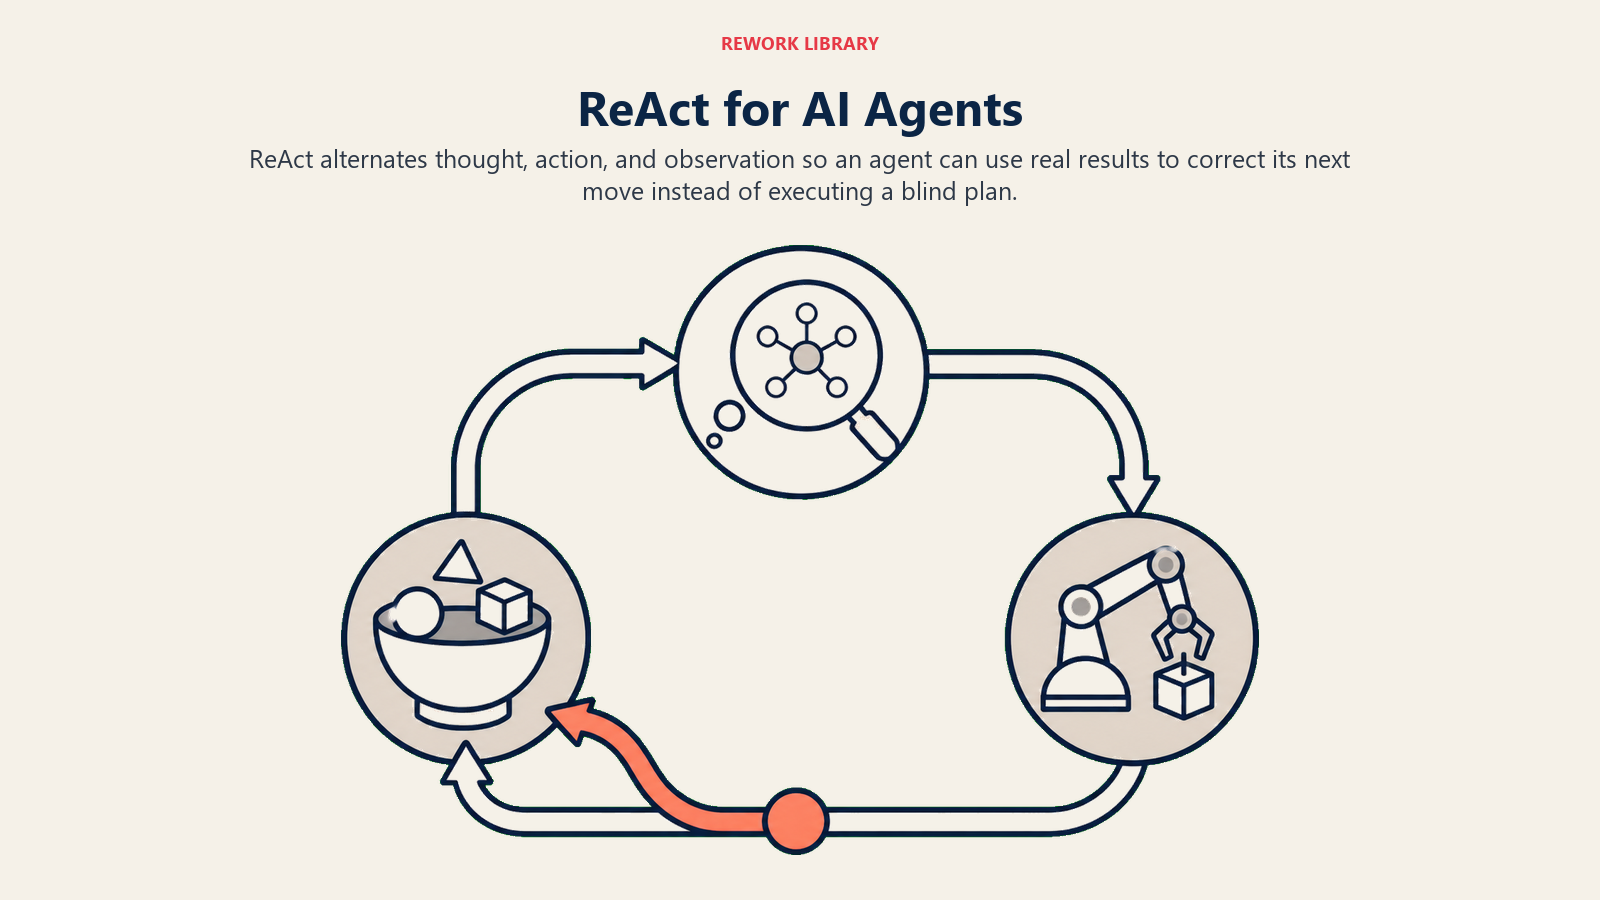
Os resultados da pesquisa original foram expressivos. Em dois benchmarks que testam a tomada de decisão interativa, ALFWorld e WebShop, o ReAct superou as linhas de base de imitação e de aprendizado por reforço em 34 pontos percentuais (71% contra 37%) e em cerca de 11 pontos percentuais (40% contra 29,1%), usando apenas um ou dois exemplos para demonstrar o padrão. O motivo de a intercalação funcionar melhor do que planejar tudo de antemão e executar às cegas é direto: o agent consegue corrigir o rumo com base no que realmente aconteceu, e não no que supôs que aconteceria. Se uma busca não retorna nada útil, o próximo pensamento pode dizer isso e tentar uma consulta diferente, em vez de seguir em frente a toda velocidade com um plano construído em cima de um palpite.
Este é o mesmo mecanismo por trás do loop descrito no padrão Autonomous Agent: ingerir o estado atual, analisar o que se sabe e o que falta, prever a melhor próxima ação, gerá-la, executá-la e repetir. O ReAct é a metade de raciocínio desse ciclo tornada concreta.
Planejamento: Pensar Vários Passos à Frente
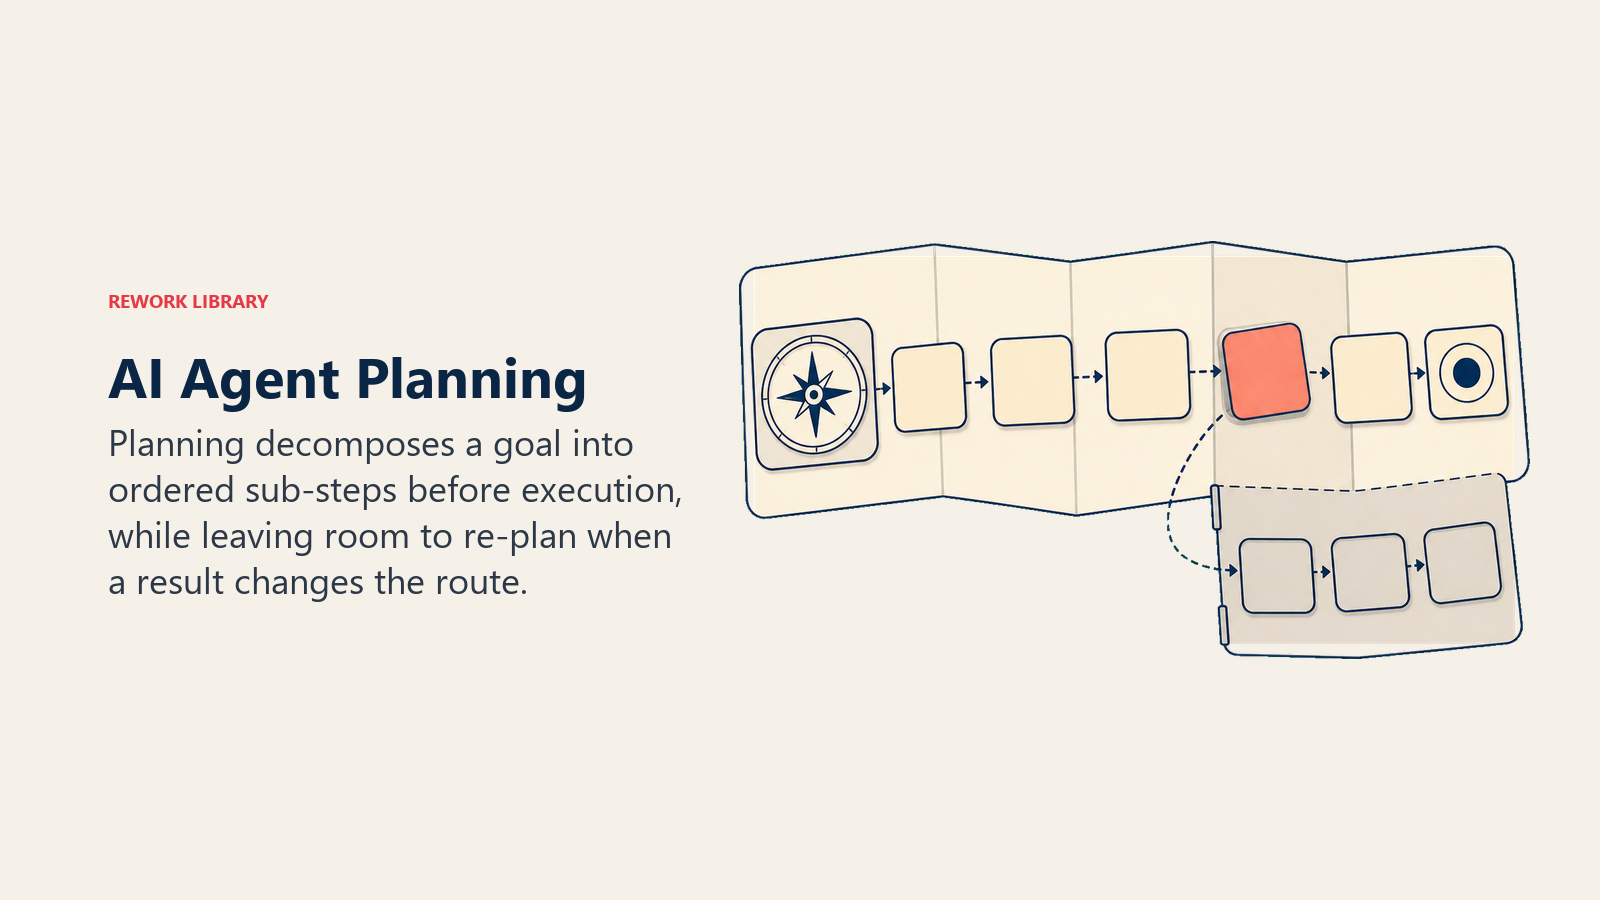
O ReAct puro improvisa um passo de cada vez, o que funciona bem em tarefas em que o próximo movimento certo só fica claro depois de ver o último resultado. Algumas tarefas se beneficiam de mais estrutura do que isso. O planejamento faz o agent decompor um objetivo em um conjunto ordenado de subetapas antes de executar qualquer uma delas, mais parecido com escrever um esboço antes do rascunho do que com inventar frase por frase.
Uma tarefa de previsão de receita é um bom exemplo. Em vez de improvisar uma consulta por vez, um agent construído sobre o blueprint do AI Forecasting Agent se beneficia de planejar a abordagem primeiro: puxar as taxas históricas de fechamento por segmento, verificar a cobertura atual do pipeline, ponderar os deals em aberto por estágio e então combinar tudo isso em uma faixa. Cada uma dessas subetapas ainda pode rodar o seu próprio loop ReAct internamente, mas o formato geral foi decidido de antemão, e não descoberto passo a passo.
O planejamento não é um compromisso único. Quando uma etapa falha ou uma informação nova muda o quadro, um agent bem construído replaneja em vez de forçar o plano original a funcionar mesmo assim. Uma extensão que vale conhecer é o raciocínio tree-of-thought, em que o agent explora mais de um plano candidato e os compara antes de se comprometer, útil quando há de fato mais de uma abordagem razoável. O que são modelos de raciocínio cobre esse território com mais profundidade, junto com a mudança mais ampla para modelos que gastam mais computação deliberando antes de responder.
Reflexão: Pegando os Próprios Erros
A reflexão acrescenta uma capacidade diferente: depois de produzir uma tentativa, o agent avalia a própria saída em relação ao objetivo e a revisa quando ela fica aquém, em vez de tratar o primeiro rascunho como final.
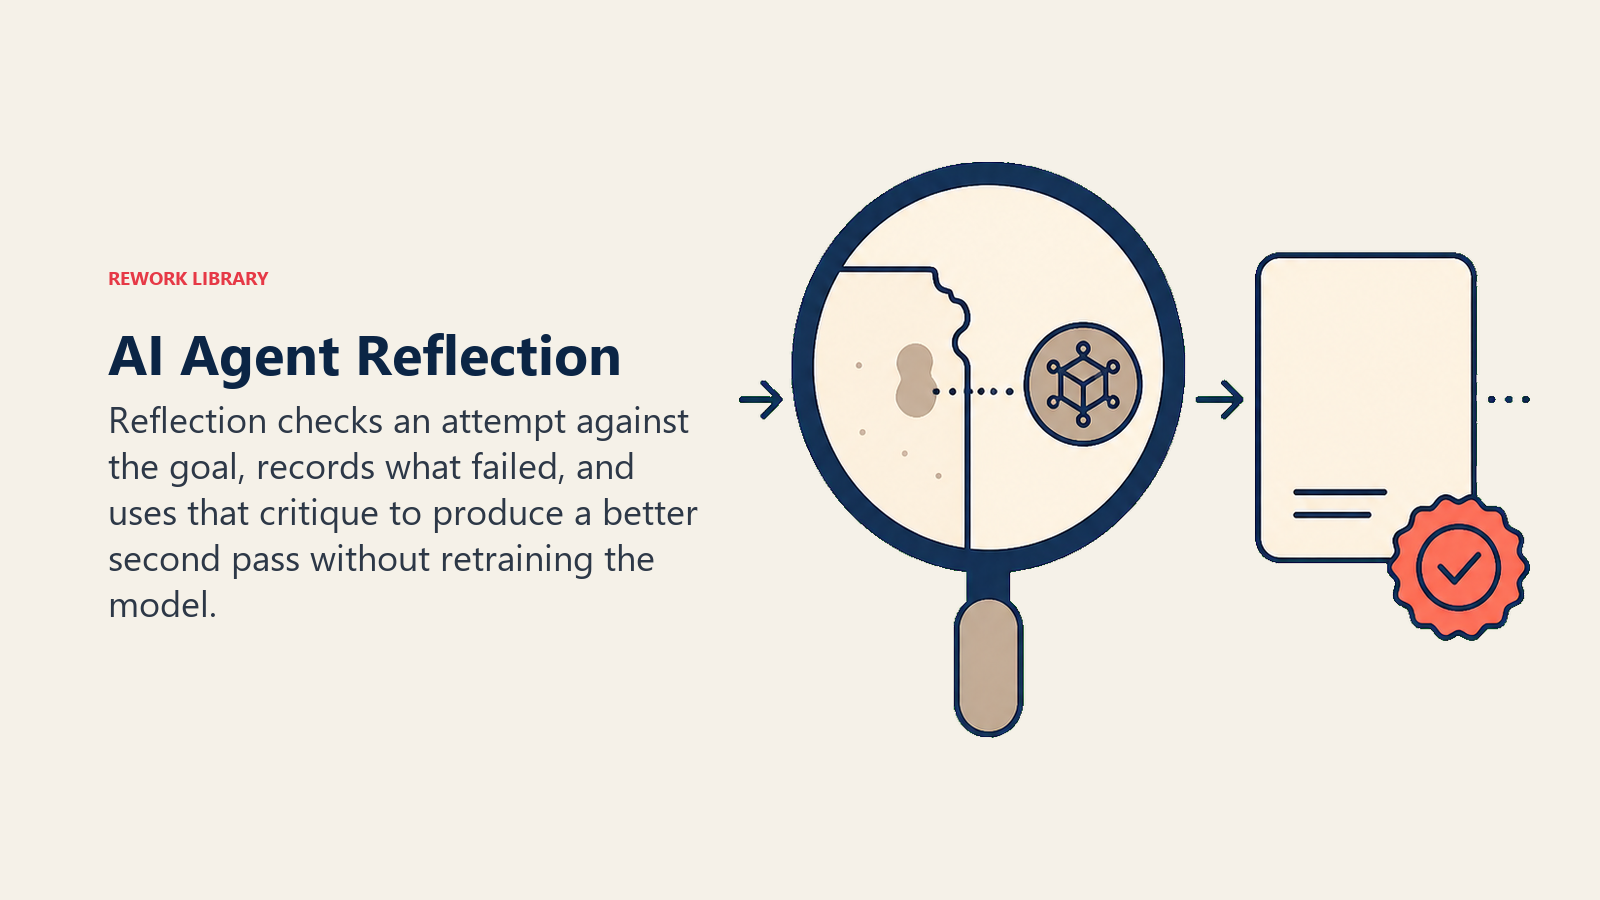
A pesquisa por trás disso, um artigo de 2023 sobre o Reflexion de Shinn e colegas, merece que se conheçam os números reais. A abordagem deles alcançou 91% de acurácia pass@1 no benchmark de programação HumanEval, contra 80% da linha de base padrão do GPT-4 na época, usando apenas um loop de autocrítica verbal guardado na memória entre as tentativas. Sem retreinamento, sem novos pesos de modelo, apenas o agent lendo a própria tentativa que falhou, escrevendo em linguagem simples o que deu errado e tentando de novo com essa nota no contexto. Essa autocrítica armazenada é uma forma da memória de trabalho tratada em como os AI agents funcionam; se você quer um quadro mais completo de como os agents retêm informações assim entre etapas e execuções, AI memory é a referência mais aprofundada.
Em termos de negócio, o blueprint do Content Drafting Agent usa uma ideia relacionada: redigir, conferir o rascunho com as diretrizes da marca e os elementos obrigatórios e revisar antes de entregá-lo a uma pessoa para a revisão final. A autoverificação não substitui a revisão humana. Ela reduz quantos rascunhos chegam com um problema óbvio e evitável já dentro deles.
Juntando Tudo: Um Passo a Passo de um Rastro de Raciocínio
Veja como as três técnicas ficam combinadas em uma tarefa real. Pede-se ao blueprint do AI Research Agent que produza um briefing sobre uma empresa-alvo antes de uma chamada de vendas.
- Planejar. O agent divide o objetivo em subtarefas: atividade recente de captação, mudanças na liderança e quaisquer notícias do último trimestre.
- Loop ReAct, subtarefa um. Pensamento: "Preciso de notícias recentes sobre captação." Ação: buscar. Observação: três resultados, um de fonte confiável. Pensamento: "Este parece atual e relevante, vou lê-lo." Ação: buscar a página. Observação: rodada de captação confirmada, com data e valor.
- Loop ReAct, subtarefas dois e três. O mesmo ciclo de pensamento, ação e observação se repete para as mudanças na liderança e as notícias recentes, cada loop parando quando o agent julga ter sinal suficiente.
- Refletir. Antes de finalizar, o agent confere o próprio rascunho com o objetivo original: ele cobre as três subtarefas, há algo desatualizado ou não confirmado, falta uma fonte para alguma afirmação. Se aparecer uma lacuna, ela vira mais uma busca direcionada, em vez de entregar o briefing com um buraco.
Três técnicas, uma saída coerente e um rastro em cada etapa que uma pessoa pode reler e entender, o que importa tanto quanto a resposta final.
Por Que a Profundidade do Raciocínio É um Trade-off entre Custo e Confiança
Nada disso é de graça. Cada pensamento que o agent escreve são tokens, e cada ciclo ReAct ou passada de reflexão extra soma latência por cima. Uma consulta simples não precisa de planejamento em várias etapas e de uma passada de autocrítica; precisa de uma resposta rápida e direta. O que são modelos de raciocínio trata da questão mais ampla de quando o raciocínio estendido e deliberado vale o custo adicional e quando uma resposta padrão e rápida é a melhor escolha, uma distinção que vale tanto para a profundidade de raciocínio interno de um agent quanto para a escolha de um modelo.
O outro lado do trade-off é a confiança, não só o custo. Um modelo pode chegar a uma ação errada com a mesma fluência e a mesma confiança com que chega a uma certa. A orientação Building Effective Agents da Anthropic, extraída de implantações em produção, defende manter os loops de agents tão simples quanto a tarefa permitir, em vez de buscar a máxima autonomia por padrão, justamente porque mais etapas de raciocínio significam mais lugares para um erro entrar sem ser notado. É por isso que todo rastro de raciocínio deve ser registrado e revisável, e não apenas a ação final; observabilidade de AI agents trata do que essa camada de registro e monitoramento precisa incluir.
Key Facts
- Raciocínio em um agent significa que o modelo gera um texto intermediário visível sobre o próximo movimento antes de agir, mais comumente por um processo no estilo chain-of-thought.
- O ReAct intercala raciocínio e ação no mesmo loop. Na pesquisa original, ele superou as linhas de base de imitação e de aprendizado por reforço em 34 pontos no ALFWorld e em cerca de 11 pontos no WebShop.
- O planejamento decompõe um objetivo em subetapas ordenadas antes de executar, e um agent bem construído replaneja quando uma etapa falha ou uma informação nova muda o quadro.
- Na reflexão, o agent critica a própria tentativa e a revisa. A pesquisa do Reflexion alcançou 91% de pass@1 no HumanEval contra 80% da linha de base, usando um loop de autocrítica verbal, sem nenhum retreinamento.
- Um raciocínio mais profundo custa mais tokens, tempo e dinheiro, e não reduz o risco de uma ação errada tomada com confiança, e é por isso que os rastros de raciocínio precisam ser registrados e revisáveis, e não apenas aceitos sem verificação.
Perguntas Frequentes sobre Como os AI Agents Raciocinam
O que é ReAct em AI agents?
ReAct vem de "reasoning and acting" (raciocinar e agir). É um padrão em que um AI agent intercala etapas curtas de raciocínio (pensamentos) com ações reais (geralmente chamadas de ferramentas) e lê o resultado (uma observação) antes do próximo pensamento, em vez de raciocinar até uma resposta final antes de agir ou agir sem nenhum raciocínio.
Qual é a diferença entre planejamento e reflexão em AI agents?
O planejamento acontece antes da execução: o agent divide um objetivo em um conjunto ordenado de subetapas logo no início. A reflexão acontece depois de uma tentativa: o agent avalia a própria saída em relação ao objetivo e a revisa se ela ficar aquém. Muitos agents em produção usam os dois, junto com o raciocínio passo a passo no estilo ReAct dentro de cada subtarefa planejada.
Acrescentar mais etapas de raciocínio deixa um AI agent mais preciso?
Muitas vezes, mas não automaticamente, e não de graça. A pesquisa sobre o ReAct e sobre abordagens baseadas em reflexão mostra ganhos reais de precisão em tarefas de várias etapas. Mas cada etapa de raciocínio adicional custa tokens e tempo, e um rastro de raciocínio mais longo ainda pode chegar a uma conclusão errada com muita confiança, e é por isso que o rastro precisa ser registrado e revisado, e não aceito só porque é mais longo.
Um AI agent consegue corrigir os próprios erros?
Sim, dentro de limites. A reflexão permite que um agent identifique e corrija certas classes de erro, como um teste que falhou ou um rascunho incompleto, criticando a própria saída e tentando de novo. Ela não consegue pegar erros que não são detectáveis a partir das informações disponíveis, e é por isso que a revisão humana continua importando em decisões de consequência.
Como o raciocínio de agents se relaciona com modelos de raciocínio como o o1 da OpenAI?
São relacionados, mas distintos. Os modelos de raciocínio são treinados para gastar computação extra deliberando antes de responder a qualquer pergunta individual. As técnicas de raciocínio de agents, como ReAct, planejamento e reflexão, são padrões para estruturar essa deliberação ao longo de uma tarefa de várias etapas que também envolve executar ações reais. Um agent pode ser construído sobre um modelo padrão ou sobre um modelo de raciocínio, e a escolha depende de quão complexas são as demandas de raciocínio da tarefa.
Chain-of-thought é a mesma coisa que raciocínio de agents?
O chain-of-thought é a técnica de base: fazer um modelo escrever etapas intermediárias de raciocínio em vez de saltar direto para uma resposta. O raciocínio de agents se apoia nesse mesmo hábito, mas o liga a um loop que também executa ações e lê de volta resultados reais, o que é um problema diferente e mais complexo do que raciocinar sobre uma única pergunta estática.
Para Onde Ir Agora
O raciocínio decide o que um agent faz a seguir; como os AI agents usam ferramentas trata do que acontece quando essa decisão se transforma em uma ação. Para ver como o loop de raciocínio de um único agent muda quando o trabalho é dividido entre vários agents, veja sistemas multiagentes. E, se você está pronto para colocar isso em prática em um agent próprio, como construir um AI agent percorre o processo de construção de ponta a ponta, enquanto o roundup de ferramentas de produtividade e o guia como escolher um assistente de programação com AI são boas próximas paradas se um agent de programação com muito raciocínio é o tipo de ferramenta que você está avaliando.

On this page
- O Raciocínio É a Etapa "Reason" do Loop, Tornada Visível
- ReAct: Raciocinar e Agir no Mesmo Loop
- Planejamento: Pensar Vários Passos à Frente
- Reflexão: Pegando os Próprios Erros
- Juntando Tudo: Um Passo a Passo de um Rastro de Raciocínio
- Por Que a Profundidade do Raciocínio É um Trade-off entre Custo e Confiança
- Key Facts
- Para Onde Ir Agora