Fine-Tuning lwn. Prompting untuk AI Agent: Bila Perlu Menggunakan Yang Mana
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
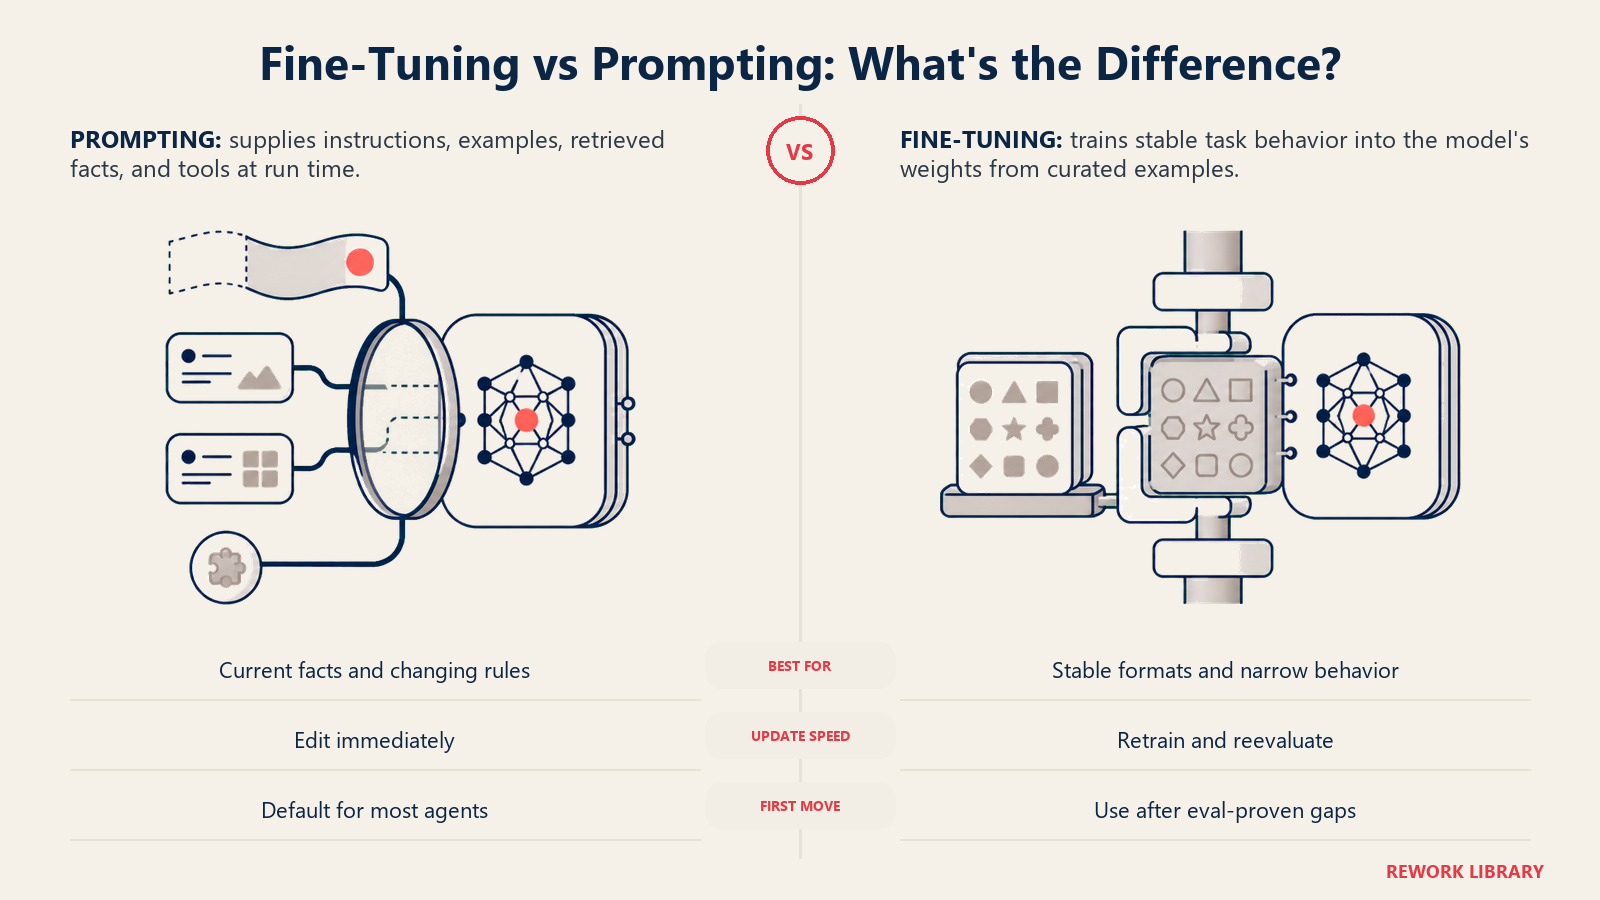
Fine-tuning dan prompting menyelesaikan masalah asas yang sama, iaitu membuat model AI berkelakuan seperti yang diperlukan perniagaan anda, melalui dua mekanisme yang sangat berbeza. Prompting (termasuk RAG dan penggunaan alat) membentuk tingkah laku pada saat model dijalankan, melalui arahan, contoh, dan konteks yang diambil semula, dan ia pantas diubah serta pantas dilancarkan. Fine-tuning pula menanamkan tingkah laku ke dalam pemberat (weights) model itu sendiri melalui latihan tambahan, dan ia lebih perlahan diubah tetapi boleh mengunci sesuatu kemahiran atau format dengan lebih boleh dipercayai daripada prompt. Bagi kebanyakan AI agent, prompting ialah pilihan lalai yang tepat, dan fine-tuning ialah alat sempit untuk jenis jurang tertentu yang benar-benar tidak dapat ditutup oleh prompting.
Mulakan dengan Memahami Fungsi Sebenar Setiap Satu
Prompting, dalam makna luas yang digunakan di sini, merangkumi segala yang boleh anda ubah tanpa melatih semula model: system prompt dan peraturan, contoh few-shot, retrieval-augmented generation yang menarik dokumen anda, dan panggilan alat yang membolehkan agent menyemak data langsung. Kejuruteraan prompt membincangkan seni menulis arahan itu dengan baik, dan retrieval-augmented generation menerangkan bagaimana agent berpaut pada data sebenar anda dan bukan meneka. Kedua-duanya berjalan pada masa inferens, pada setiap panggilan, menggunakan model asas serba guna. Pasukan kejuruteraan Anthropic sendiri membingkaikan versi moden amalan ini sebagai kejuruteraan konteks, menghuraikannya sebagai kemajuan semula jadi kejuruteraan prompt untuk membina agent yang mampu melakukan kerja berbilang langkah yang sebenar, tepat kerana tiada satu pun daripadanya memerlukan latihan semula.
Fine-tuning berbeza dari segi jenis. Ia mengambil model yang telah dilatih dan melatihnya lagi menggunakan contoh anda sendiri, melaraskan pemberat model supaya sesuatu tingkah laku menjadi hampir automatik dan bukan sesuatu yang perlu diminta oleh prompt setiap kali. Itu menjadikannya berkuasa untuk satu jenis masalah tertentu dan sebahagian besarnya tidak relevan untuk yang lain, dan sebab itulah keputusan memilih yang mana begitu penting.
Pilihan Lalai: Prompt, RAG, dan Alat Dahulu
Panduan fine-tuning daripada OpenAI sendiri jelas tentang susunan langkah: sediakan penilaian (evals) dahulu, dan hanya melabur dalam fine-tuning selepas anda mewujudkan cara untuk mengukur sama ada ia benar-benar membantu. Itu bukan sikap berhati-hati semata-mata, itulah keseluruhan strateginya. Tanpa evals, anda tidak dapat mengetahui sama ada model yang telah di-fine-tune benar-benar lebih baik daripada prompt yang ditulis dengan baik, anda hanya meneka dengan langkah tambahan.
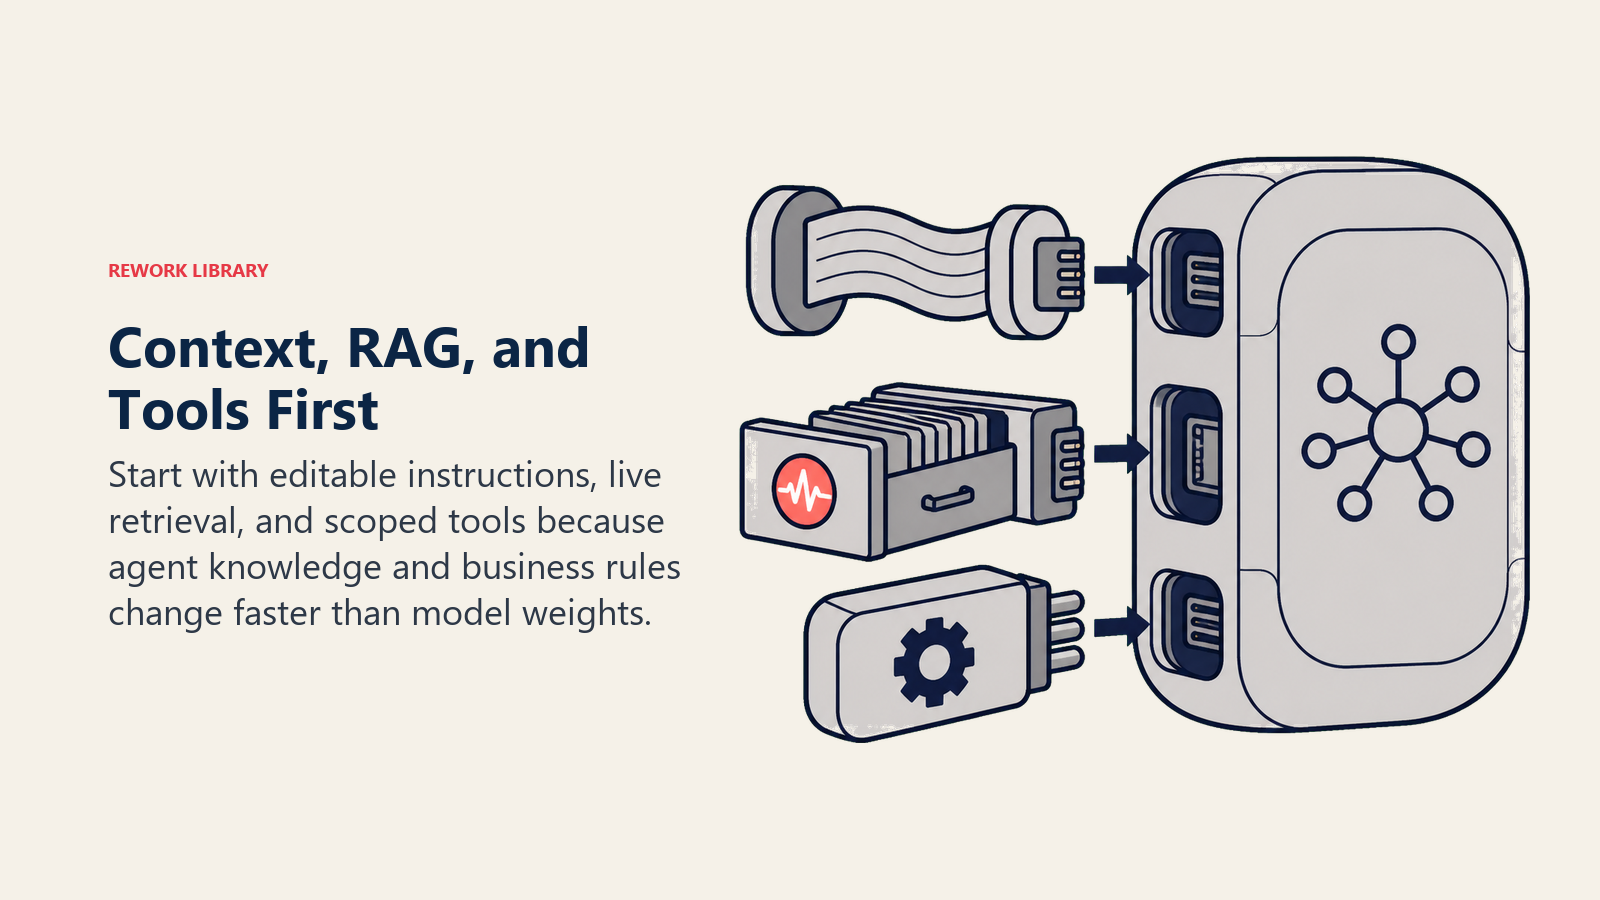
Sebab praktikal prompting didahulukan khusus untuk agent ialah kebanyakan perkara yang perlu agent kuasai berubah terlalu kerap untuk ditanam dalam pemberat. Peraturan perniagaan dikemas kini. Dasar berubah. Katalog produk beralih setiap minggu. RAG untuk AI agent menyatakan perkara ini secara langsung: perolehan semula membaca daripada sumber pada saat soalan ditanya, jadi kemas kini seterusnya tercermin pada kali berikutnya seseorang bertanya. Model yang di-fine-tune dan menghafal dasar suku tahun lepas menjadi lapuk pada hari dasar itu berubah, dan latihan semula bukan penyelesaian pada hari yang sama seperti menyunting dokumen atau prompt. Kes tersendiri bagi corak ini, model yang mengambil semula sekali dan menjawab, dibincangkan dalam corak RAG Assistant; agent lazimnya memerlukan asas yang sama ditambah keupayaan bertindak berdasarkan apa yang ditemuinya.
Di Mana Fine-Tuning Benar-Benar Berbaloi
Fine-tuning tidak usang, ia cuma disasarkan pada sasaran yang lebih sempit daripada yang disangka kebanyakan pasukan apabila mula-mula menggunakannya. Dokumentasi OpenAI menamakan kes yang sentiasa dibantunya: tugas pengelasan, kerja terjemahan yang bernuansa, penjanaan kandungan dalam format yang sangat khusus, dan membetulkan kegagalan model mengikut arahan yang tidak dapat diselesaikan oleh prompt yang lebih baik. Perhatikan apa yang tiada dalam senarai itu: pengetahuan am dan fakta yang kerap berubah, tepat wilayah yang dilindungi lebih baik oleh prompting dan RAG.
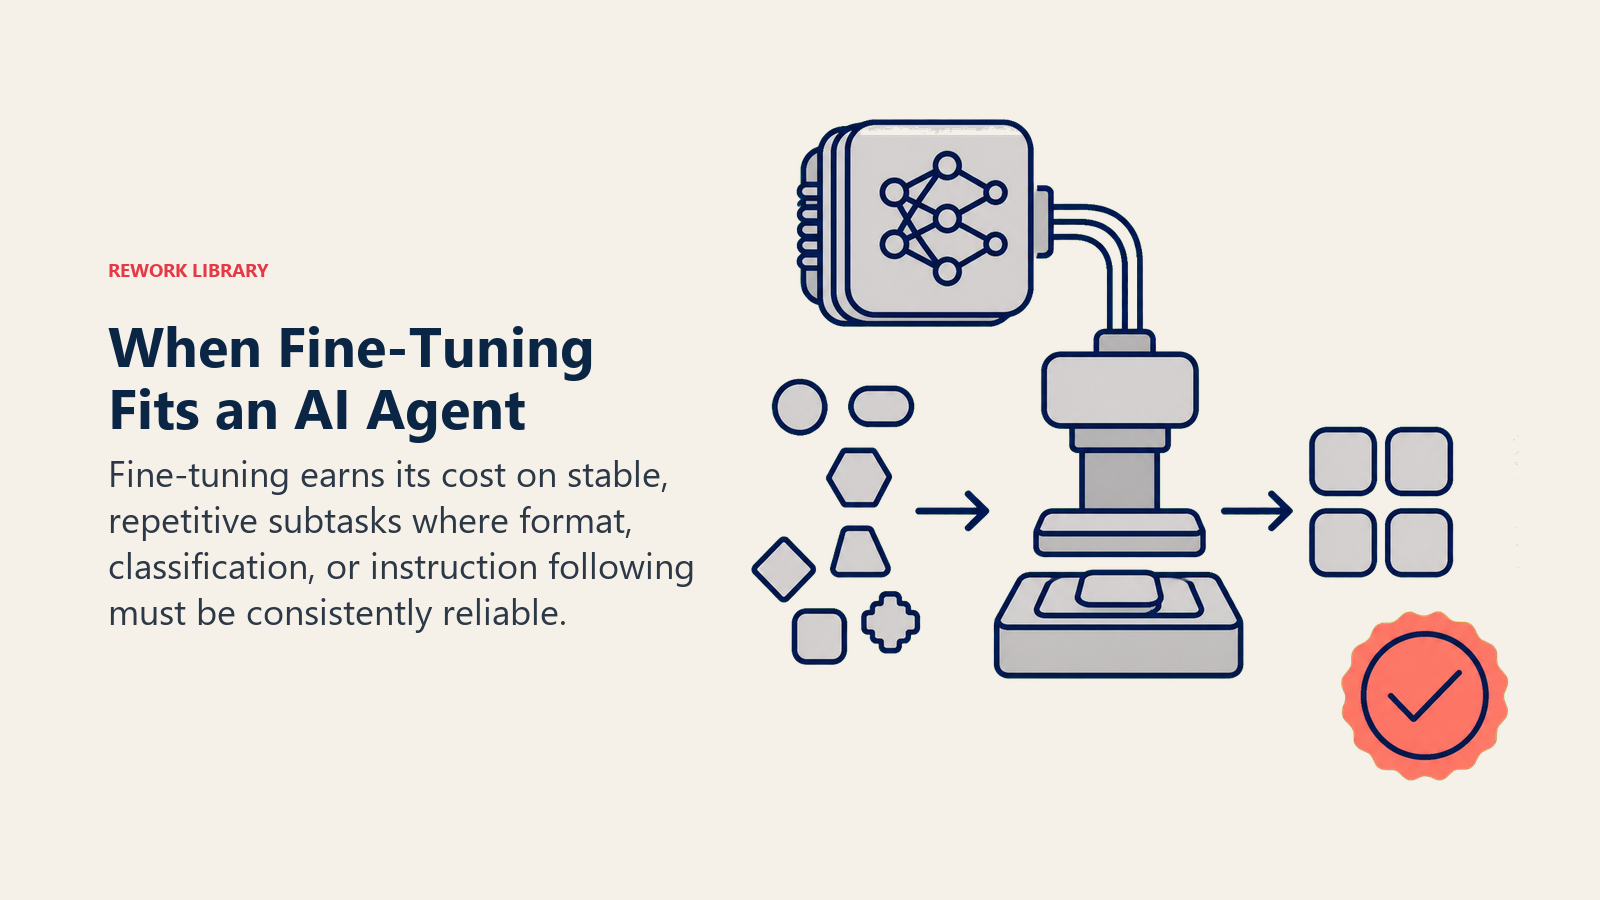
Cara berguna untuk membezakan keduanya: fine-tuning pandai mengajar model bagaimana untuk menjawab (format, nada, tingkah laku pengelasan yang sempit, mengikut corak arahan luar biasa dengan boleh dipercayai), manakala prompting dan perolehan semula lebih baik dalam mengajar model apa yang perlu dijawab (fakta semasa, dasar khusus anda, sejarah akaun pelanggan ini). Agent hampir selalu memerlukan yang kedua lebih banyak daripada yang pertama, kerana tugas agent kebanyakannya tentang bertindak dengan betul berdasarkan maklumat semasa, bukan menghasilkan teks yang gayanya tersendiri.
Dalam agent yang lebih besar, penggunaan fine-tuning yang paling sah dan lazim bukanlah langkah penaakulan utama agent langsung. Ia ialah subtugas yang sempit dan bervolum tinggi yang dijalankan sebagai satu bahagian gelung yang lebih besar, bukan keseluruhan otak agent. AI Support Triage Agent, yang mengelaskan tiket masuk ke dalam baris gilir yang betul, ialah jenis kerja pengelasan yang konsisten, berulang, dan bervolum tinggi di mana model kecil yang di-fine-tune boleh mengatasi model am besar yang diprompt untuk melakukan tugas sempit yang sama pada setiap panggilan. AI Document Processing Agent, yang mengekstrak medan berstruktur daripada dokumen yang bersepah dan formatnya tidak konsisten, ialah satu lagi contoh. Kedua-duanya masalah format dan corak lebih daripada masalah pengetahuan, dan itulah kekuatan fine-tuning.
Rangka Keputusan
| Soalan | Menjurus ke prompting/RAG/alat | Menjurus ke fine-tuning |
|---|---|---|
| Adakah pengetahuan asas berubah setiap minggu atau bulan? | Ya, perolehan semula lebih sesuai | Jarang, hanya jika benar-benar stabil |
| Adakah jurangnya fakta yang hilang, atau format/nada/tingkah laku yang salah? | Fakta yang hilang | Format atau tingkah laku yang salah |
| Adakah anda perlu memetik atau menerangkan dari mana jawapan datang? | Ya, perolehan semula boleh dijejak | Pemberat tidak boleh diperiksa dengan cara yang sama |
| Adakah ini subtugas yang sempit, bervolum tinggi, dan berulang? | Belum tentu | Selalunya paling sesuai |
| Sudahkah anda mencuba prompt yang ditulis dengan baik dan contoh yang bagus? | Cuba ini dahulu walau apa pun | Hanya selepas ini benar-benar gagal |
| Adakah evals sedia ada untuk mengukur sama ada ia membantu? | Bina ini dalam kedua-dua kes | Diwajibkan sebelum anda bermula |
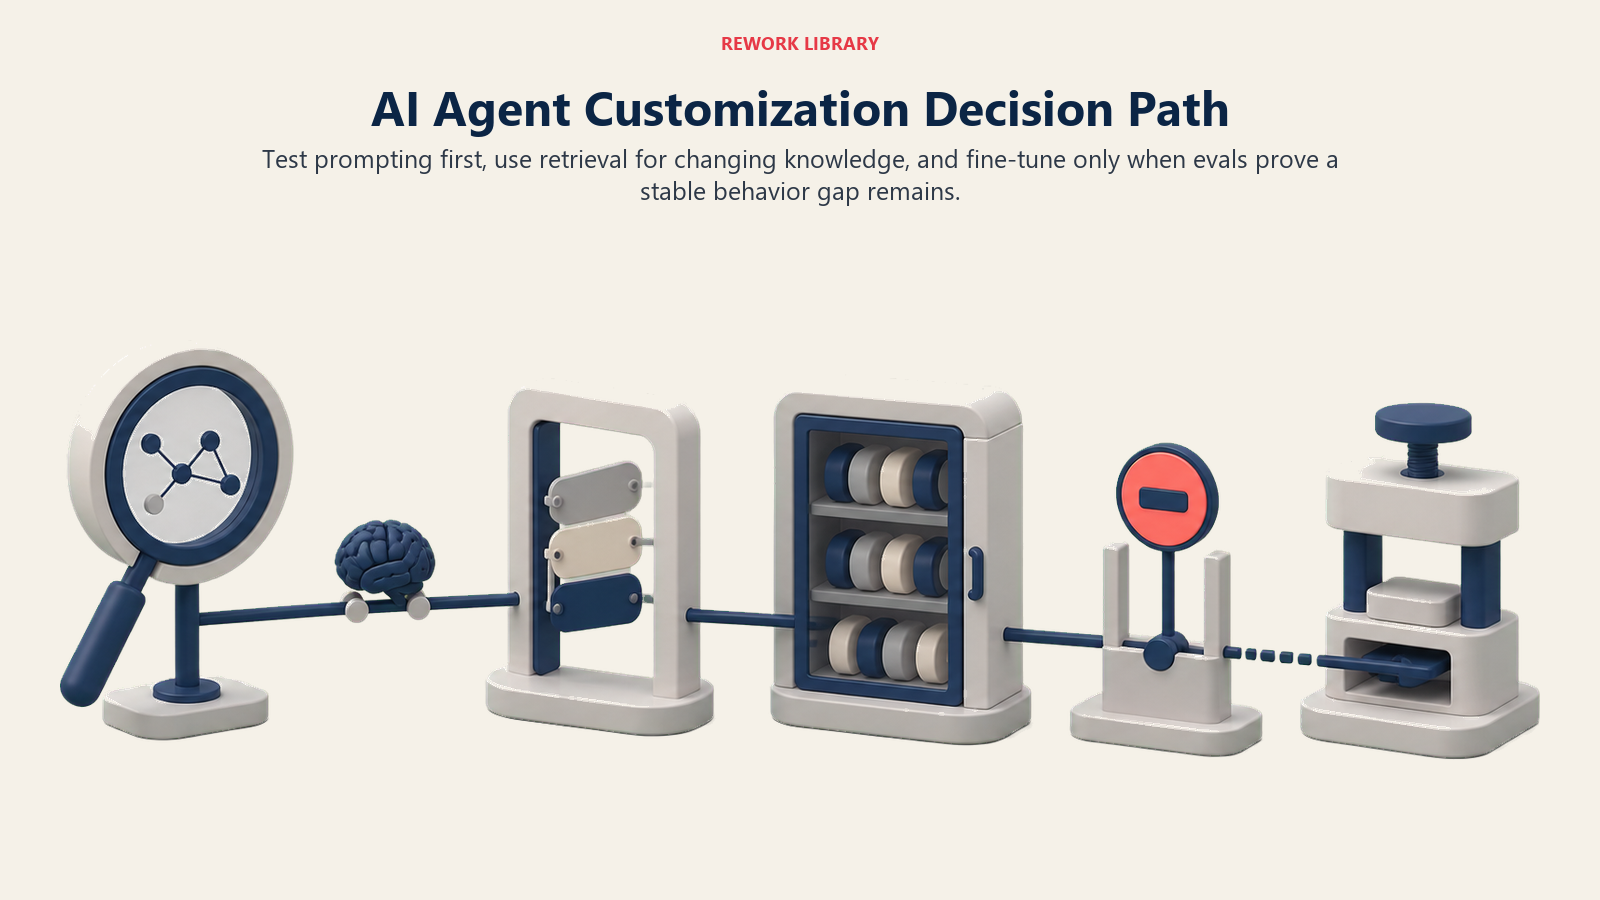
Kebanyakan baris menuju ke arah yang sama bagi kebanyakan agent: mulakan dengan prompting, tambah perolehan semula untuk apa-apa yang memerlukan pengetahuan semasa atau proprietari, dan simpan fine-tuning untuk baris tertentu yang memang lebih sesuai, bukan sebagai laluan naik taraf lalai.
Sisi Kos dalam Keputusan Ini
Fine-tuning bukan sekadar pilihan teknikal, ia komitmen infrastruktur: saluran latihan, set data berlabel yang perlu diselenggara apabila perniagaan anda berubah, penilaian untuk mengesahkan versi yang di-fine-tune benar-benar lebih baik, dan kadar latihan semula apabila tugas asas beralih. Tiada satu pun daripadanya percuma, dan tiada satu pun hilang selepas latihan pertama seperti suntingan prompt.
Komitmen itu wajar ditimbang berbanding kekerapan projek AI agentic terhenti atas sebab yang tiada kaitan dengan keupayaan mentah model. Gartner meramalkan bahawa lebih 40% projek AI agentic akan dibatalkan menjelang penghujung 2027, dengan kos yang meningkat dan nilai perniagaan yang tidak jelas antara punca utama. Melabur dalam saluran fine-tuning sebelum anda membuktikan kes penggunaan asas dengan kaedah yang lebih murah dan pantas ialah cara yang baik untuk menambah kos dan kerumitan pada projek sebelum anda tahu ia akan berjaya. Jika anda membandingkan platform berdasarkan ini, perbandingan alat AI kami menilai vendor berdasarkan lebih daripada kualiti model mentah, dan panduan pembelian platform chatbot AI membincangkan pertukaran antara prompting dan penyesuaian ini dari sudut pembeli.
Bila Jawapannya Benar-Benar "Kedua-duanya"
Semua ini tidak bermakna fine-tuning dan prompting saling eksklusif merentasi seluruh sistem agent. Agent besar yang mengendalikan pelbagai jenis langkah boleh dengan sah menggunakan model kecil yang di-fine-tune untuk satu langkah pengelasan yang sempit dan berulang, serta model frontier yang diprompt dan berpaut pada RAG untuk langkah penaakulan dan penyediaan draf yang memerlukan pengetahuan semasa dan pertimbangan. Cara membina AI agent membincangkan enam blok binaan yang diperlukan mana-mana agent, dan pilihan antara fine-tuning dengan prompting bukan satu keputusan yang dibuat sekali, ia keputusan yang dibuat bagi setiap langkah, berdasarkan apa yang sebenarnya diperlukan oleh langkah itu.
Fakta Utama
- Panduan fine-tuning OpenAI sendiri bermula dengan "evals yang baik dahulu": wujudkan cara mengukur sama ada fine-tuning membantu sebelum melabur di dalamnya, bukan selepas itu.
- Fine-tuning paling sesuai untuk pengelasan, terjemahan bernuansa, format output tertentu, dan membetulkan kegagalan mengikut arahan, bukan untuk mengajar model fakta baharu atau yang kerap berubah.
- Perolehan semula membaca daripada sumber pada saat soalan ditanya, jadi ia mencerminkan kemas kini serta-merta; model yang di-fine-tune hanya semasa seperti larian latihan terakhirnya.
- Penggunaan fine-tuning yang paling sah dan lazim dalam agent ialah subtugas sempit bervolum tinggi, seperti pengelasan tiket atau pengekstrakan medan dokumen, dijalankan sebagai satu langkah, bukan keseluruhan proses penaakulan agent.
- Gartner mengaitkan lebih 40% pembatalan projek AI agentic yang diunjurkan menjelang 2027 sebahagiannya dengan kos yang meningkat, risiko sebenar apabila saluran fine-tuning dibina sebelum kes penggunaan asas terbukti.
Soalan Lazim tentang Fine-Tuning lwn. Prompting untuk AI Agent
Patutkah saya fine-tune atau prompt AI agent saya?
Mulakan dengan prompting, perolehan semula, dan alat untuk hampir setiap kes penggunaan agent. Fine-tuning wajar dipertimbangkan hanya selepas prompt yang ditulis dengan baik dan contoh yang bagus benar-benar gagal menyelesaikan masalah khusus yang sempit, seperti format output yang tidak konsisten atau tugas pengelasan yang terus tersilap dengan prompt.
Apakah perbezaan utama antara fine-tuning dengan prompting?
Prompting membentuk tingkah laku model serba guna pada saat ia dijalankan, melalui arahan, contoh, dan konteks yang diambil semula, dan ia pantas diubah. Fine-tuning melatih model dengan lebih lanjut menggunakan data anda sendiri, melaraskan pemberatnya supaya tingkah laku menjadi hampir automatik, tetapi ia lebih perlahan dikemas kini dan memerlukan saluran latihan serta penilaian yang berterusan.
Bolehkah fine-tuning menggantikan RAG untuk memastikan agent kekal terkini?
Tidak. Fine-tuning menanamkan pengetahuan ke dalam pemberat model pada masa latihan, jadi ia menjadi lapuk sebaik sahaja dokumen sumber berubah. RAG mengambil semula daripada sumber langsung pada saat soalan ditanya, dan sebab itulah perolehan semula, bukan fine-tuning, ialah alat yang tepat untuk pengetahuan yang kerap berubah.
Apakah jenis tugas agent yang sesuai untuk fine-tuning?
Subtugas yang sempit, bervolum tinggi, dan berulang dengan bentuk input dan output yang konsisten: mengelaskan tiket ke dalam baris gilir, mengekstrak medan berstruktur daripada dokumen yang bersepah, atau memadankan nada atau format yang sangat khusus dengan boleh dipercayai. Ini biasanya satu langkah dalam agent yang lebih besar, bukan keseluruhan proses penaakulan agent.
Adakah saya memerlukan kepakaran pembelajaran mesin untuk fine-tune model bagi agent?
Anda memerlukan kurang daripada yang disangka untuk tugas sempit dengan set data yang baik, tetapi anda tetap memerlukan proses penilaian yang sebenar untuk mengesahkan versi yang di-fine-tune mengatasi alternatif yang diprompt dengan baik. Melangkau evals ialah cara paling lazim pasukan berakhir dengan model yang di-fine-tune yang sebenarnya tidak lebih baik, cuma berbeza.
Ke Mana Seterusnya
Jika prompting dan perolehan semula ialah titik permulaan yang tepat untuk agent anda, RAG untuk AI agent membincangkan cara mengasaskannya pada data anda sendiri, dan cara membina AI agent membincangkan di mana keputusan itu terletak dalam blok binaan agent yang lain. Jika kos antara perkara yang mendorong anda ke arah fine-tuning, pengoptimuman kos AI agent membincangkan caching dan penghalaan model, dua tuas yang selalunya menyelesaikan masalah yang sama tanpa saluran latihan.
