Bahasa Indonesia
Fine-Tuning vs. Prompting untuk AI Agent: Kapan Menggunakan Masing-Masing
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
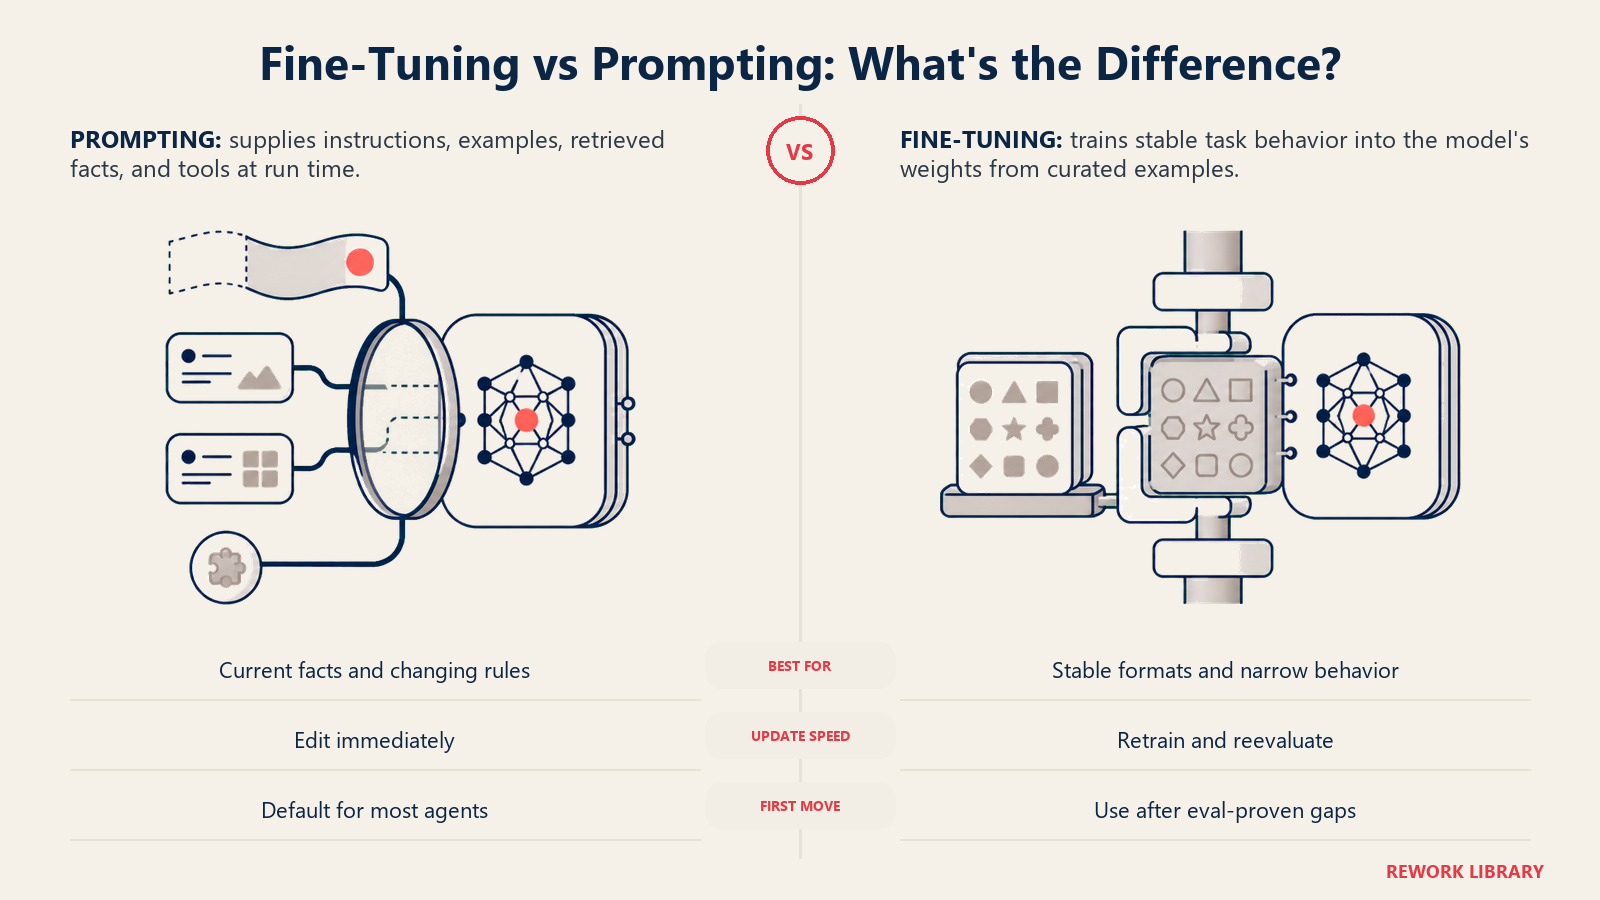
Fine-tuning dan prompting menyelesaikan masalah dasar yang sama, yaitu membuat model AI berperilaku sesuai kebutuhan bisnis Anda, tetapi lewat dua mekanisme yang sangat berbeda. Prompting (termasuk RAG dan penggunaan tool) membentuk perilaku pada saat model berjalan, lewat instruksi, contoh, dan konteks yang diambil, sehingga mudah diubah dan cepat dirilis. Fine-tuning menanamkan perilaku ke dalam bobot (weights) model itu sendiri melalui pelatihan tambahan; perubahannya lebih lambat, tetapi dapat mengunci keterampilan atau format tertentu dengan lebih andal daripada prompt. Untuk sebagian besar AI agent, prompting adalah pilihan default yang tepat, dan fine-tuning adalah alat sempit untuk jenis kesenjangan tertentu yang benar-benar tidak dapat ditutup oleh prompting.
Mulai dari Apa yang Sebenarnya Dilakukan Masing-Masing
Prompting, dalam arti luas yang dipakai di sini, mencakup semua hal yang dapat Anda ubah tanpa melatih ulang model: system prompt dan aturannya, contoh few-shot, retrieval-augmented generation yang menarik dokumen Anda, dan pemanggilan tool yang memungkinkan agent memeriksa data langsung. Prompt engineering membahas seni menulis instruksi itu dengan baik, dan retrieval-augmented generation membahas bagaimana agent berpijak pada data Anda yang sebenarnya, bukan menebak-nebak. Keduanya berjalan pada saat inferensi, di setiap pemanggilan, memakai model dasar serba guna. Tim engineering Anthropic sendiri membingkai versi modern dari praktik ini sebagai context engineering, yang mereka gambarkan sebagai kelanjutan alami dari prompt engineering untuk membangun agent yang mampu mengerjakan tugas multi-langkah yang nyata, justru karena tidak ada satu pun bagiannya yang memerlukan pelatihan ulang.
Fine-tuning berbeda secara hakiki. Pendekatan ini mengambil model yang sudah dilatih sebelumnya dan melatihnya lebih lanjut dengan contoh-contoh milik Anda sendiri, menyesuaikan bobot model sehingga suatu perilaku menjadi hampir otomatis, bukan sesuatu yang harus diminta lewat prompt setiap kali. Itu membuatnya ampuh untuk jenis masalah tertentu dan nyaris tidak relevan untuk yang lain, dan itulah sebabnya keputusan memilih salah satunya penting.
Default: Prompt, RAG, dan Tool Lebih Dulu
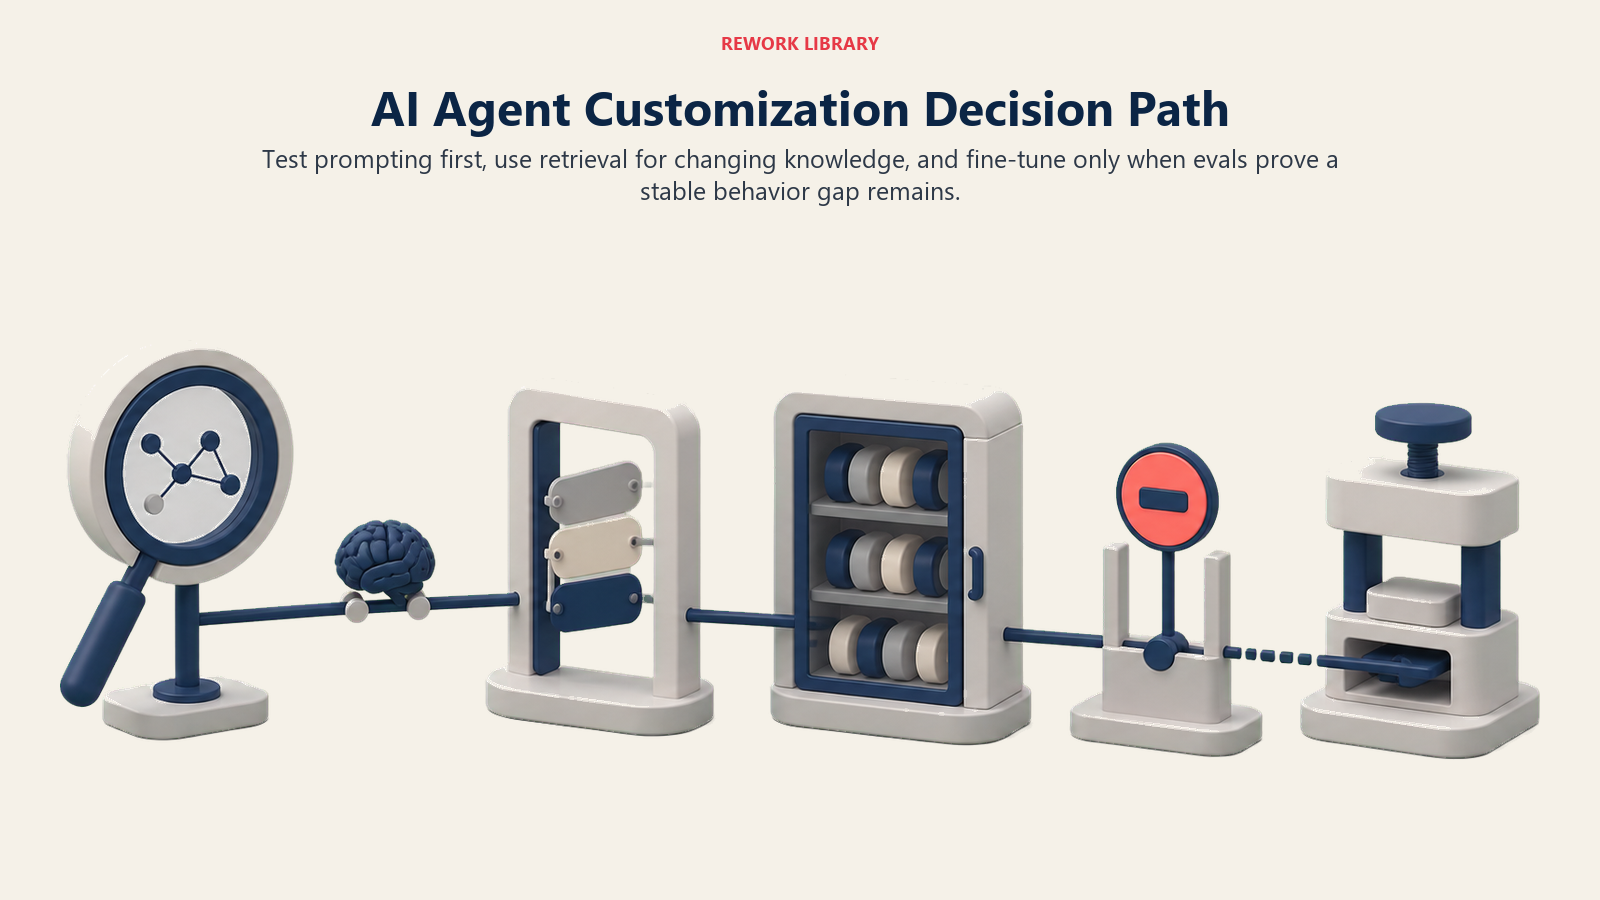
Panduan fine-tuning dari OpenAI sendiri lugas soal urutan langkahnya: siapkan evaluasi terlebih dahulu, dan baru berinvestasi pada fine-tuning setelah Anda punya cara untuk mengukur apakah hasilnya benar-benar membantu. Itu bukan sikap berjaga-jaga, melainkan seluruh strateginya. Tanpa evals, Anda tidak bisa tahu apakah model hasil fine-tuning benar-benar lebih baik daripada prompt yang ditulis dengan baik; Anda hanya menebak dengan langkah tambahan.
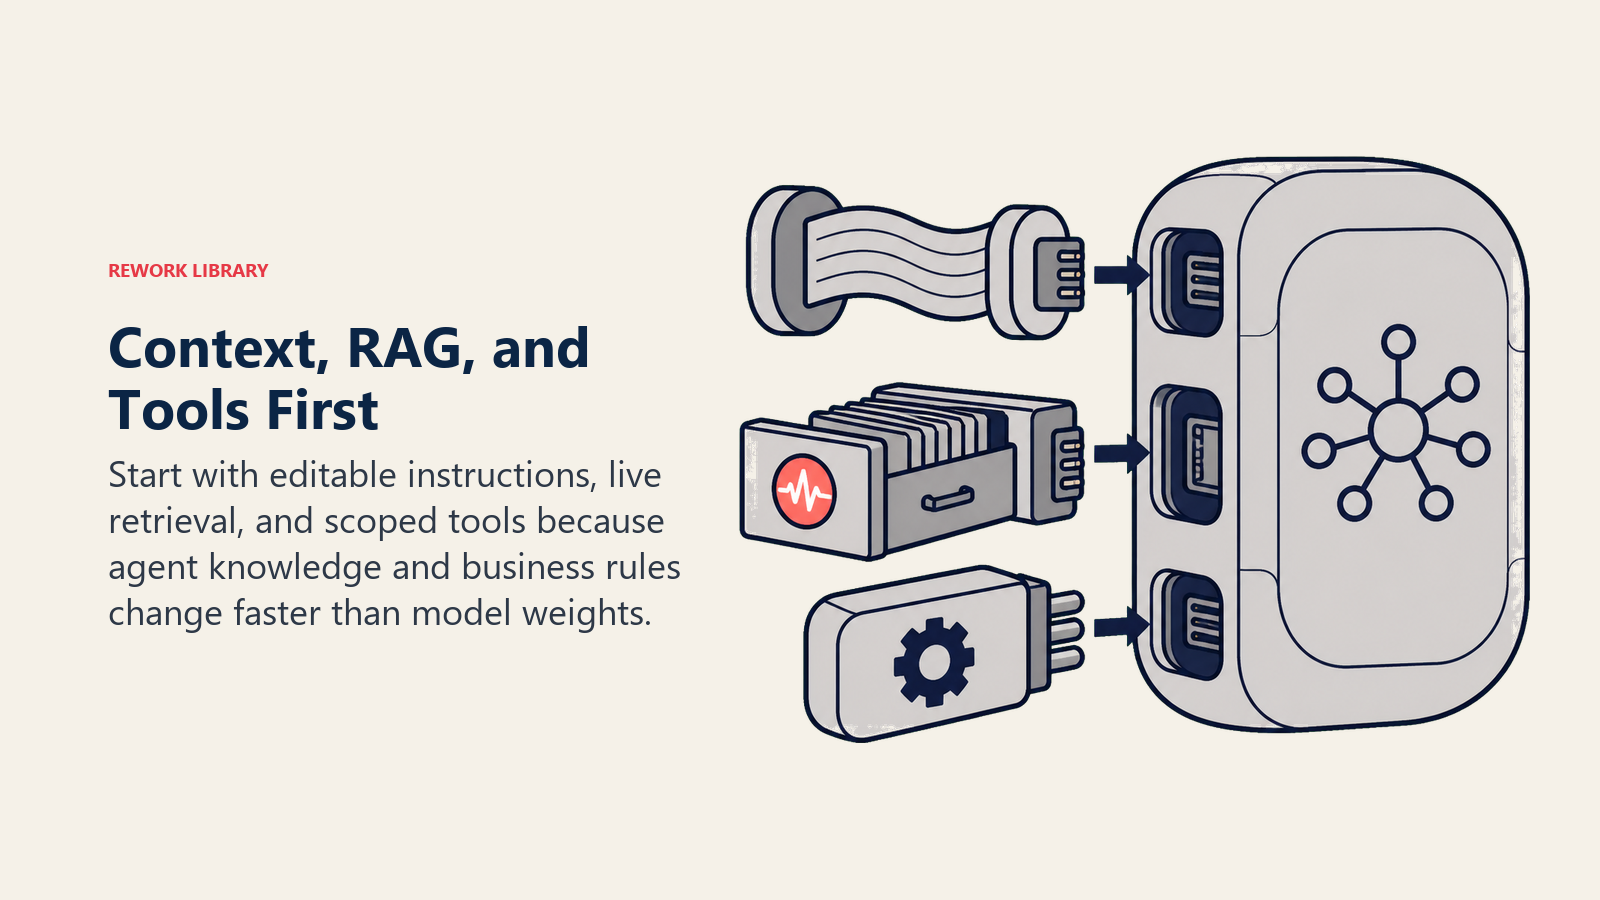
Alasan praktis mengapa prompting didahulukan khusus untuk agent adalah karena sebagian besar hal yang harus dikuasai agent terlalu sering berubah untuk ditanamkan ke dalam bobot. Aturan bisnis diperbarui. Kebijakan berubah. Katalog produk bergeser setiap minggu. RAG untuk AI agent menyatakan hal ini secara langsung: retrieval membaca dari sumber pada saat pertanyaan diajukan, sehingga pembaruan berikutnya langsung tercermin saat ada yang bertanya lagi. Model hasil fine-tuning yang menghafal kebijakan kuartal lalu menjadi usang pada hari kebijakan itu berubah, dan pelatihan ulang bukan perbaikan di hari yang sama seperti mengedit dokumen atau prompt. Kasus mandiri untuk pola ini, yaitu model yang mengambil informasi sekali lalu menjawab, dibahas dalam pola RAG Assistant; sebuah agent biasanya membutuhkan landasan yang sama ditambah kemampuan untuk bertindak berdasarkan apa yang ditemukannya.
Di Mana Fine-Tuning Benar-Benar Sepadan
Fine-tuning tidak usang; ia hanya mengincar sasaran yang lebih sempit daripada yang dibayangkan kebanyakan tim saat pertama kali menggunakannya. Dokumentasi OpenAI menyebutkan kasus-kasus ketika fine-tuning secara konsisten membantu: tugas klasifikasi, pekerjaan terjemahan yang bernuansa, pembuatan konten dalam format yang sangat spesifik, dan perbaikan kegagalan model dalam mengikuti instruksi yang tidak teratasi oleh prompt yang lebih baik. Perhatikan apa yang tidak ada dalam daftar itu: pengetahuan umum dan fakta yang sering berubah, tepatnya wilayah yang lebih baik ditangani prompting dan RAG.
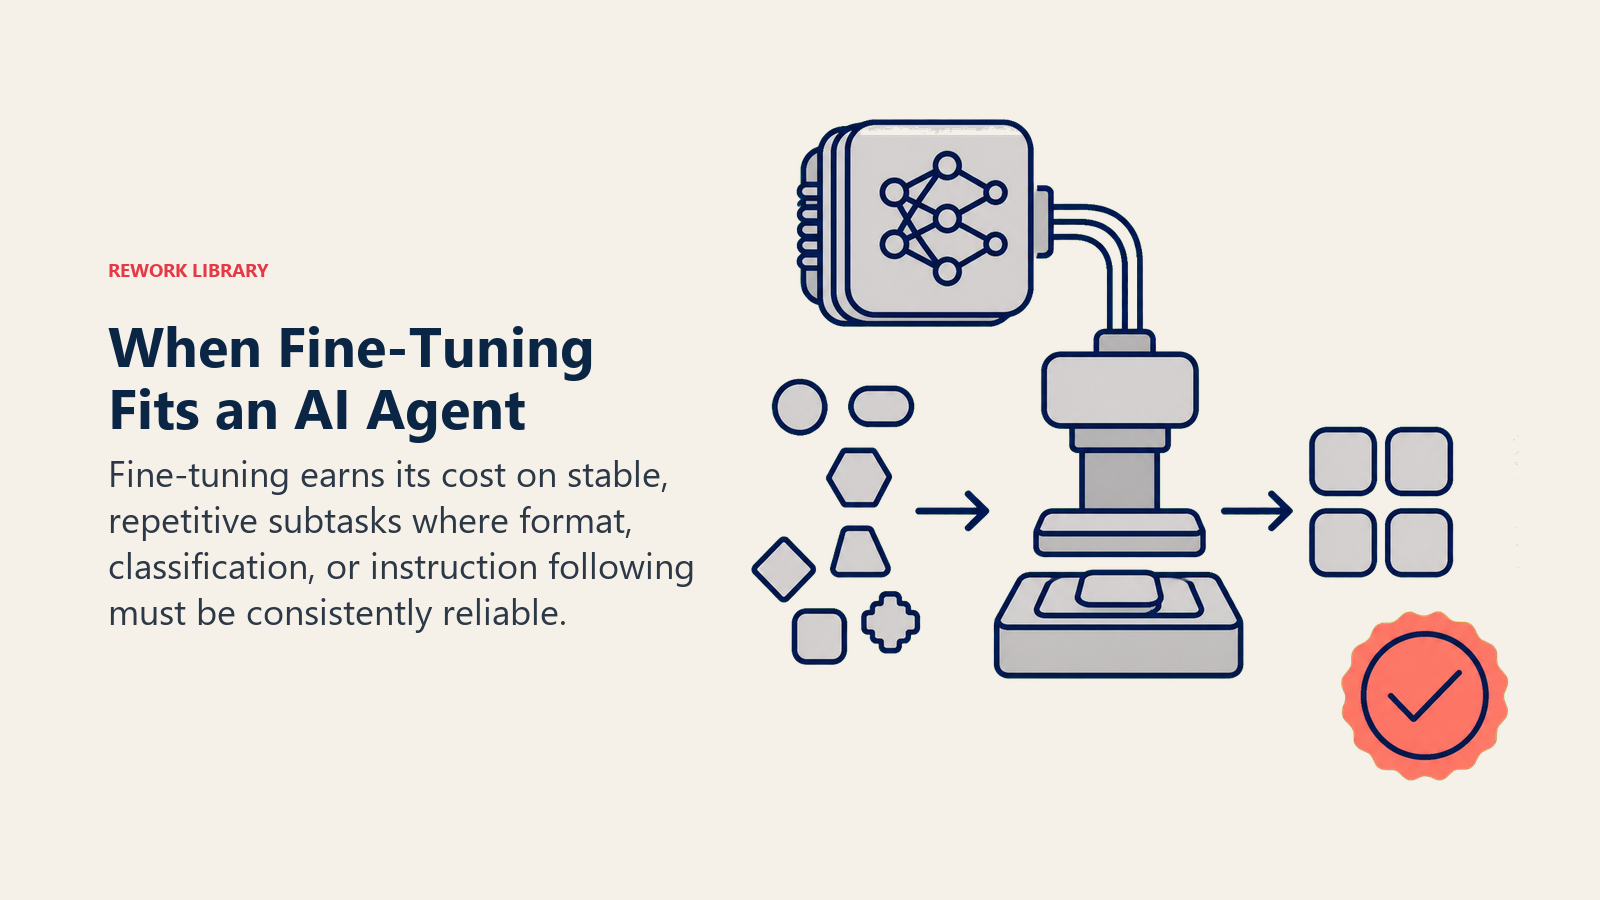
Cara yang berguna untuk membedakan keduanya: fine-tuning pandai mengajarkan model bagaimana merespons (format, nada, perilaku klasifikasi yang sempit, mengikuti pola instruksi yang tidak lazim secara andal), sedangkan prompting dan retrieval lebih pandai mengajarkan model dengan apa harus merespons (fakta terkini, kebijakan spesifik Anda, riwayat akun pelanggan ini). Sebuah agent hampir selalu membutuhkan lebih banyak yang kedua daripada yang pertama, karena tugas agent sebagian besar adalah bertindak dengan benar berdasarkan informasi terkini, bukan menghasilkan teks dengan gaya yang khas.
Di dalam agent yang lebih besar, penggunaan fine-tuning yang paling umum dan sah bukanlah langkah penalaran utama agent sama sekali. Penggunaannya adalah subtugas sempit bervolume tinggi yang dijalankan sebagai satu bagian dari loop yang lebih besar, bukan sebagai seluruh otak agent. AI Support Triage Agent, yang mengklasifikasikan tiket masuk ke antrean yang tepat, adalah contoh persis dari pekerjaan klasifikasi yang konsisten, berulang, dan bervolume tinggi, ketika model kecil hasil fine-tuning dapat mengungguli model umum besar yang diberi prompt untuk tugas sempit yang sama di setiap pemanggilan. AI Document Processing Agent, yang mengekstrak kolom terstruktur dari dokumen berantakan dengan format tidak seragam, adalah contoh lainnya. Keduanya lebih merupakan masalah format dan pola daripada masalah pengetahuan, dan itulah kekuatan utama fine-tuning.
Kerangka Keputusan
| Pertanyaan | Mengarah ke prompting/RAG/tool | Mengarah ke fine-tuning |
|---|---|---|
| Apakah pengetahuan dasarnya berubah mingguan atau bulanan? | Ya, retrieval lebih unggul | Jarang, hanya jika benar-benar stabil |
| Apakah kesenjangannya berupa fakta yang hilang, atau format/nada/perilaku yang salah? | Fakta yang hilang | Format atau perilaku yang salah |
| Apakah Anda perlu mengutip atau menjelaskan dari mana jawaban berasal? | Ya, retrieval dapat dilacak | Bobot tidak dapat diperiksa dengan cara yang sama |
| Apakah ini subtugas yang sempit, bervolume tinggi, dan berulang? | Belum tentu | Sering kali paling cocok |
| Apakah Anda sudah mencoba prompt yang ditulis dengan baik dan contoh yang bagus? | Coba ini lebih dulu apa pun kondisinya | Hanya setelah ini benar-benar gagal |
| Apakah evals sudah siap untuk mengukur apakah hasilnya membaik? | Bangun ini dalam kedua kasus | Wajib sebelum Anda mulai |
Sebagian besar baris menunjuk ke arah yang sama untuk sebagian besar agent: mulai dengan prompting, tambahkan retrieval untuk apa pun yang membutuhkan pengetahuan terkini atau milik perusahaan, dan sisakan fine-tuning untuk baris-baris tertentu yang memang lebih cocok untuknya, bukan sebagai jalur peningkatan default.
Sisi Biaya dari Keputusan Ini
Fine-tuning bukan sekadar pilihan teknis, melainkan komitmen infrastruktur: pipeline pelatihan, dataset berlabel yang harus dirawat seiring perubahan bisnis Anda, evaluasi untuk memastikan versi hasil fine-tuning memang lebih baik, dan jadwal pelatihan ulang ketika tugas yang mendasarinya bergeser. Tidak ada yang gratis, dan tidak ada yang hilang setelah pelatihan pertama selesai seperti halnya pengeditan prompt.
Komitmen itu perlu ditimbang terhadap seberapa sering proyek agentic AI terhenti karena alasan yang tidak ada hubungannya dengan kemampuan mentah model. Gartner memprediksi bahwa lebih dari 40% proyek agentic AI akan dibatalkan pada akhir 2027, dengan membengkaknya biaya dan nilai bisnis yang tidak jelas sebagai salah satu penyebab utama. Berkomitmen pada pipeline fine-tuning sebelum Anda membuktikan kasus penggunaannya dengan metode yang lebih murah dan cepat adalah cara yang baik untuk menambah biaya dan kompleksitas pada proyek sebelum Anda tahu proyek itu akan berhasil. Jika Anda membandingkan platform dengan dasar ini, perbandingan alat AI kami menilai vendor dengan kriteria yang lebih luas daripada kualitas model mentah, dan panduan membeli platform chatbot AI membahas trade-off prompting versus kustomisasi ini dari sudut pandang pembeli.
Ketika Jawabannya Memang "Keduanya"
Semua ini tidak berarti fine-tuning dan prompting saling meniadakan di seluruh sistem agent. Agent besar yang menangani banyak jenis langkah dapat dengan sah memakai model kecil hasil fine-tuning untuk satu langkah klasifikasi yang sempit dan berulang, serta model frontier berbasis prompt dan berlandaskan RAG untuk langkah penalaran dan penyusunan yang membutuhkan pengetahuan terkini dan penilaian. Cara membangun AI agent membahas enam blok penyusun yang dibutuhkan setiap agent, dan pilihan antara fine-tuning dan prompting bukan satu keputusan yang diambil sekali, melainkan keputusan yang diambil per langkah, berdasarkan apa yang benar-benar dibutuhkan langkah itu.
Key Facts
- Panduan fine-tuning OpenAI sendiri diawali dengan "evals yang baik lebih dulu": tetapkan cara mengukur apakah fine-tuning membantu sebelum berinvestasi di dalamnya, bukan sesudahnya.
- Fine-tuning paling cocok untuk klasifikasi, terjemahan yang bernuansa, format keluaran tertentu, dan perbaikan kegagalan mengikuti instruksi, bukan untuk mengajarkan fakta baru atau yang sering berubah kepada model.
- Retrieval membaca dari sumber pada saat pertanyaan diajukan, sehingga langsung mencerminkan pembaruan; model hasil fine-tuning hanya semutakhir pelatihan terakhirnya.
- Penggunaan fine-tuning yang paling umum dan sah di dalam agent adalah subtugas sempit bervolume tinggi, seperti klasifikasi tiket atau ekstraksi kolom dokumen, yang dijalankan sebagai satu langkah, bukan sebagai seluruh proses penalaran agent.
- Gartner mengaitkan lebih dari 40% proyeksi pembatalan proyek agentic AI hingga 2027 sebagian dengan membengkaknya biaya, risiko nyata ketika pipeline fine-tuning dibangun sebelum kasus penggunaan dasarnya terbukti.
Pertanyaan yang Sering Diajukan tentang Fine-Tuning vs. Prompting untuk AI Agent
Sebaiknya saya melakukan fine-tuning atau prompting pada AI agent saya?
Mulailah dengan prompting, retrieval, dan tool untuk hampir semua kasus penggunaan agent. Fine-tuning layak dipertimbangkan hanya setelah prompt yang ditulis dengan baik dan contoh yang bagus benar-benar gagal memperbaiki masalah tertentu yang sempit, seperti format keluaran yang tidak konsisten atau tugas klasifikasi yang terus salah ditangani prompt.
Apa perbedaan utama antara fine-tuning dan prompting?
Prompting membentuk perilaku model serba guna pada saat model berjalan, lewat instruksi, contoh, dan konteks yang diambil, dan mudah diubah. Fine-tuning melatih model lebih lanjut dengan data Anda sendiri, menyesuaikan bobotnya sehingga suatu perilaku menjadi hampir otomatis, tetapi pembaruannya lebih lambat dan membutuhkan pipeline pelatihan serta evaluasi yang berkelanjutan.
Dapatkah fine-tuning menggantikan RAG untuk menjaga agent tetap mutakhir?
Tidak. Fine-tuning menanamkan pengetahuan ke dalam bobot model pada saat pelatihan, sehingga langsung usang begitu dokumen sumber berubah. RAG mengambil dari sumber langsung pada saat pertanyaan diajukan, itulah sebabnya retrieval, bukan fine-tuning, adalah alat yang tepat untuk pengetahuan yang berubah secara berkala.
Jenis tugas agent apa yang cocok untuk fine-tuning?
Subtugas sempit, bervolume tinggi, dan berulang dengan bentuk input dan output yang konsisten: mengklasifikasikan tiket ke antrean, mengekstrak kolom terstruktur dari dokumen berantakan, atau menyamai nada atau format yang sangat spesifik secara andal. Biasanya ini hanya satu langkah di dalam agent yang lebih besar, bukan seluruh proses penalaran agent.
Apakah saya perlu keahlian machine learning untuk melakukan fine-tuning model bagi sebuah agent?
Untuk tugas sempit dengan dataset yang baik, Anda membutuhkan lebih sedikit daripada yang dibayangkan, tetapi Anda tetap memerlukan proses evaluasi yang nyata untuk memastikan versi hasil fine-tuning mengungguli alternatif yang diberi prompt dengan baik. Melewatkan evals adalah cara paling umum bagi tim untuk berakhir dengan model hasil fine-tuning yang tidak benar-benar lebih baik, hanya berbeda.
Langkah Selanjutnya
Jika prompting dan retrieval adalah titik awal yang tepat untuk agent Anda, RAG untuk AI agent membahas cara menambatkannya pada data Anda sendiri, dan cara membangun AI agent membahas posisi keputusan itu di antara blok penyusun agent lainnya. Jika biaya ikut mendorong Anda ke arah fine-tuning, optimasi biaya AI agent membahas caching dan model routing, dua tuas yang sering menyelesaikan masalah yang sama tanpa pipeline pelatihan.
