利用拡大に伴うモデルコストの管理
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
モデルのコストは、ほとんどのソフトウェアのコストとは振る舞いが異なります。従来のSaaS製品は、1万社目の顧客にもほとんど追加コストなしでサービスを提供できます。AIプロダクトは、顧客が何かを頼むたびに計算資源の費用を支払うため、請求額は利用量とともに増えます。そして顧客が製品を気に入るほど、利用量は売上より速く伸びる傾向があります。創業者やCOOが管理しているのは、まさにこの状況です。一度きりの最適化プロジェクトではなく、責任者、ダッシュボード、そして一連の手段を必要とするコスト項目なのです。
本ガイドでは、そうした手段を会社全体の視点から取り上げます。意図的に特定のベンダーに依存しない内容にしています。モデルの価格は頻繁に変わり、リファレンス記事で示しても役に立たないため一切記載せず、製品ではなく手法の種類を説明します。キャッシュ、ルーティング、呼び出し予算をエージェント単位のエンジニアリングの視点で知りたい方は、AIエージェントのコスト最適化をお読みください。会計面、つまりこれらのコストがどう分類され、どう利益率に流れ込むかについては、AI企業の売上原価(COGS)とAIの推論コストと粗利益率をご覧ください。ここでは、成長期の経営チームが実際に直面する問いに絞ります。何ができるのか、どの順番で行うのか、そして誰が責任を持つのか、です。
最適化ではなく可視化から始める
失敗するコスト削減の取り組みは、ほぼすべて間違った場所から始まっています。お金がどこに流れているかを知る前に、気の利いた手法を選んでしまうのです。最初の手段は、手法ですらありません。測定です。
モデルプロバイダーからの請求書は、会社全体で1つの数字です。その数字からは、特定の顧客が利益を生んでいるか、新機能が利益率を漏らしているか、急増が実際の成長によるものか暴走した1つのジョブによるものかは分かりません。答えを得るには、自社が販売している単位にコストを割り当てる必要があります。
課金の方法と顧客の考え方に合った単位を選んでください。
- タスクまたは成果あたりのコスト: 処理した書類1件、解決したチケット1件、作成したレポート1件。
- 顧客1社あたりの月間コスト: アカウントに紐づけたモデル費用の合計。
- 機能あたりのコスト: 製品のどの部分が最も多くの計算資源を消費しているか。
- アクティブユーザーあたりのコスト: 妥当性の確認には役立ちますが、ヘビーユーザーとライトユーザーの差を覆い隠します。
実務的には、モデルの呼び出しを行う時点で、すべての呼び出しに顧客ID、機能名、タスクの種類のタグを付け、そのタグをtoken数やレイテンシとともに保存するということです。地味な配管工事ですが、以下に述べるすべての基盤になります。これが整ったら、平均だけでなく分布をプロットしてください。多くの製品では、少数の顧客がコストの大部分を生んでおり、平均はそれを隠してしまいます。顧客によってコストが変わるあらゆるビジネスで同じ規律が当てはまり、一般的な考え方はユニットエコノミクスの解説で取り上げています。
早い段階で作っておく価値のあるビューが2つあります。1つ目は、顧客セグメント別に単位あたりのコストと単位あたりの価格を比べるもので、どのセグメントが赤字になっているかが分かります。2つ目は、単位あたりのコストの推移で、製品の変更やモデルの変更が効果を上げているのか、逆効果なのかを判断できます。
手段の一覧表
単位ごとにコストが見えるようになれば、手段は当て推量ではなく選択肢になります。次の表は、各手段の内容、一般的なトレードオフ、そして適しやすい場面をまとめたものです。表の後の各セクションで詳しく説明します。
| 手段 | 内容 | 一般的なトレードオフ | 適した場面 |
|---|---|---|---|
| 単位ごとのコスト可視化 | すべての呼び出しに顧客、機能、タスクのタグを付ける | 初期のエンジニアリング工数 | 常に、ほかの何よりも先に |
| ルーティングとカスケード | まず安価なモデルを試し、必要なときに上位モデルに引き上げる | 誤ったルーティングによる品質リスク、レイテンシの増加 | 難易度の異なるリクエストが相当量ある場合 |
| promptとコンテキストの削減 | 1回の呼び出しで送るtokenを減らす | 有用なコンテキストを失う可能性 | 長いprompt、冗長な検索結果、やり取りの多いエージェント |
| キャッシュ | 繰り返される入力に対して過去の計算結果を再利用する | 情報の陳腐化、キャッシュ管理の手間 | 安定した前置き部分、繰り返しやほぼ重複するクエリ |
| バッチ処理 | 急ぎでない作業を非同期でまとめて実行する | 結果が出るのが遅れる | レポート、データ補完、バックオフィス業務 |
| 蒸留とfine-tuning | 大きなモデルの出力で小さなモデルを学習させる | 初期の手間、能力の範囲が狭まる、保守 | 安定していて量が多く、明確に定義されたタスク |
| オープンウェイトまたは自社ホスティング | 自社のインフラでモデルを動かす | 運用負担、キャパシティのリスク | 予測可能な高負荷、データ管理の要件 |
| レート制限と利用上限 | ユーザーまたはアカウントごとに消費量を制限する | 正当なヘビーユーザーにとっての不便 | 不正利用のリスク、無料プラン、需要のばらつき |
| 価格面の歯止め | 公正利用の条件、クレジット、超過料金 | 営業上の摩擦、複雑さ | 顧客によってコストが大きく異なる場合 |
| ガバナンス | 予算、アラート、責任者の指名 | プロセスの負担 | 費用が重要な規模になった時点 |
ルーティングとカスケード: まず小さなモデルから
カスケードの考え方はシンプルです。ほとんどのリクエストは簡単で、安価なモデルで十分に処理できます。少数のリクエストは難しく、より高性能で高価なモデルが必要です。どちらがどちらかを見分けられるか、安く見極められるなら、高い価格を払うのはそれに見合うときだけで済みます。
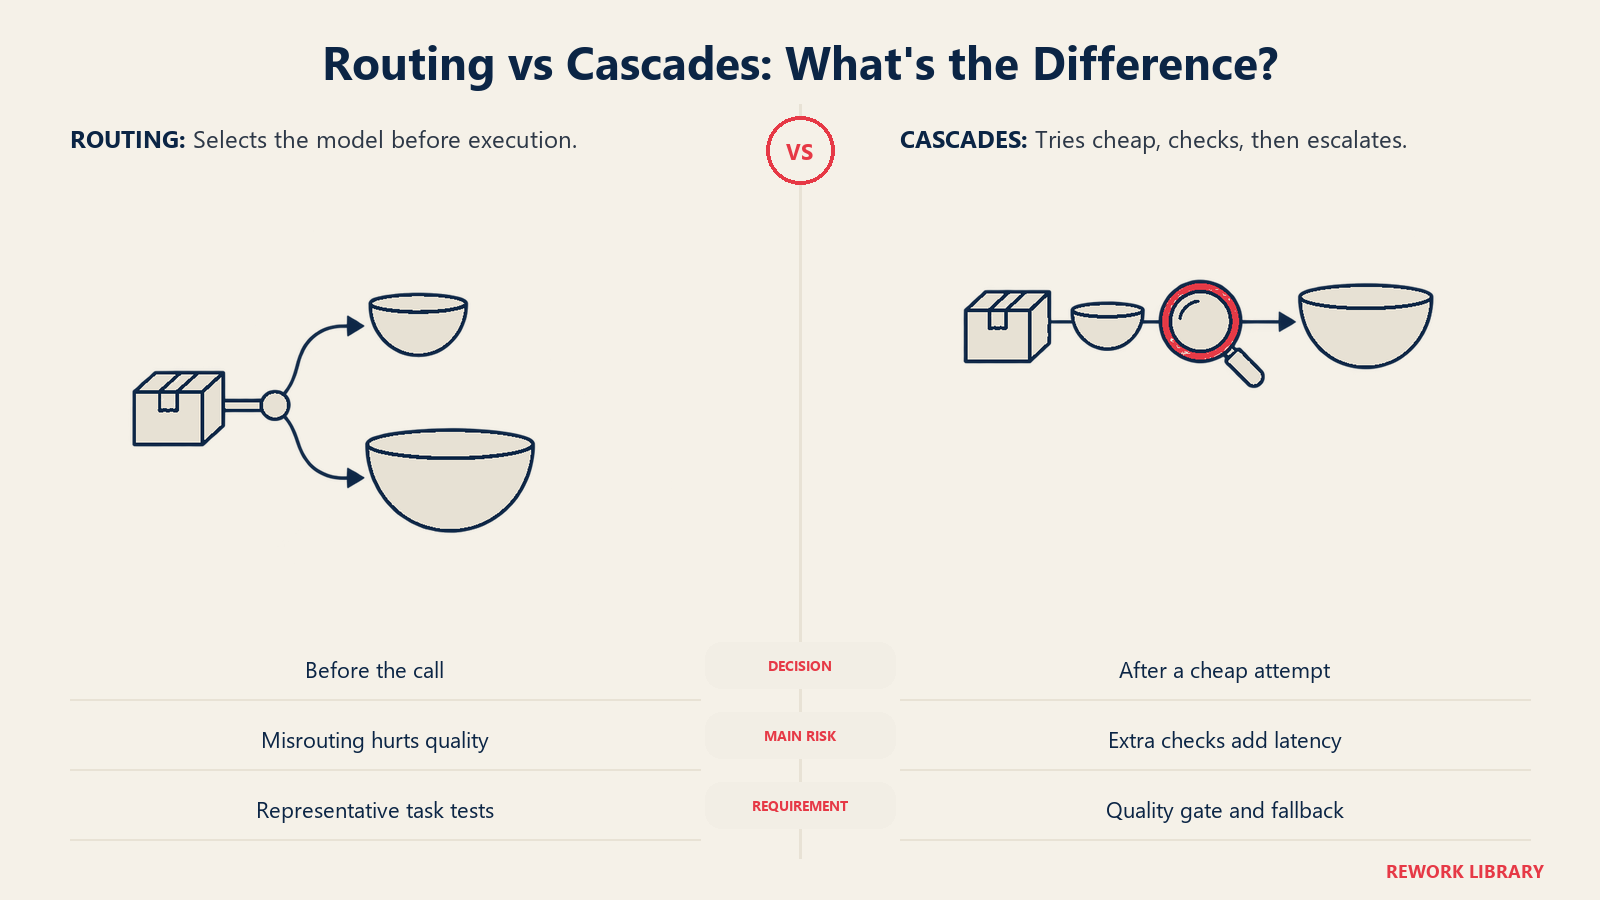
一般的な形は2つあります。カスケードでは、まず安価なモデルにリクエストを送り、答えが十分かどうかを確認し、十分でない場合にのみ強力なモデルに引き上げます。ルーティングでは、安価なモデルを先に試すことなく、分類器が最初にどのモデルがリクエストを処理すべきかを決めます。
この分野の研究は知っておく価値があり、数字は注意深く読む価値があります。FrugalGPTの論文は、モデル間のカスケードを提案し、この手法によって最良の単一モデルと同等の性能を最大98%のコスト削減で達成できる、あるいは同じコストでそのモデルより精度を4%向上できると報告しています。これは著者たちのベンチマークでの結果であり、1つ目の主張では「最大」という言葉が大きな意味を持っています。自社のワークロードでは結果が異なるでしょう。RouteLLMの論文は、人間の選好データでルーターを学習させ、その手法が特定のケースでは応答品質を損なうことなくコストを2分の1以下に削減すると報告しています。また、テスト時に基盤となるモデルを変えても、ルーターは機能し続けました。
どちらも、削減額の予測としてではなく、この手段が実在する証拠として扱ってください。率直に言えば、トレードオフは次のとおりです。
- 誤ったルーティングは品質を損なう。 ルーターが難しいリクエストを弱いモデルに送り、何もそれを検知しなければ、顧客は質の悪い答えを受け取ります。ルーターを信頼する前に、自社のタスクで答えの品質を測定する手段が必要です。
- カスケードはレイテンシを増やす。 安価な試行で失敗したリクエストは、安価な呼び出し、チェック、そして高価な呼び出しの費用を払うことになります。対話型の製品では、この遅れが問題になることがあります。
- チェックにもコストがかかる。 答えが十分かどうかの判断は無料ではありません。単純なルールを使うチーム、小さなモデルを使うチーム、信頼度のシグナルを使うチームがあります。いずれにも失敗のパターンがあります。
- 評価セットが必要である。 正解が分かっている代表的なタスクのセットがなければ、ルーティングの変更が役立ったのか、気づかないうちに悪化させたのかを判断できません。
会社全体で見た実践的な一手は、コストが集中している場所から始めることです。単位ごとのデータを使って費用の大部分を占める1つか2つのタスクの種類を見つけ、まずそこでルーティングを試してください。
promptとコンテキストの削減
コストは入出力されるテキストの量に応じて増えるため、最も安いtokenは送らないtokenです。地味に感じられるため過小評価されがちな手段ですが、すぐに効果が出ることがよくあります。
見直すべき一般的な箇所は次のとおりです。
- 肥大化した指示。 システムpromptには、何か月もかけてルールが積み重なります。その多くは、振る舞いを変えずに短くしたり削除したりできます。
- 過剰な検索。 3つで足りるのに10個の文書チャンクをコンテキストに取り込むと、毎回の呼び出しでコストが上がります。
- 会話履歴。 毎ターン長い履歴を送り直すと、それがコストの大半を占めることがあります。古いターンを要約すれば、忠実度をわずかに犠牲にする代わりに大きく節約できます。
- 冗長な出力。 製品上許される範囲で、構造化された簡潔な応答を求めれば、出力の費用が減ります。
トレードオフは、コンテキストを削ると、見えにくい形で品質も削られかねないことです。削減の変更はすべて、片付け作業ではなく、評価セットに照らした実験として扱ってください。30%短く5%悪くなったpromptが成功と言えるのは、顧客が違いに気づかず、かつ利益率に手助けが必要だった場合だけです。
キャッシュ: 同じ作業に二度払わない
キャッシュには大きく2つの種類があります。
**promptキャッシュ(プレフィックスキャッシュ)**では、指示や参考文書など、promptの長く安定した冒頭部分の計算結果を、プロバイダーやサービング層が再利用できます。そのため、同じ前置き部分を持つ繰り返しの呼び出しのコストが下がります。安定した部分を先に、変化する部分を後に置いた構造のpromptほど効果があります。条件や割引率はプロバイダーによって異なり、時とともに変わるため、記事の数字を信じるのではなく最新のドキュメントを確認してください。
**レスポンスキャッシュ(セマンティックキャッシュ)**は、答えを保存しておき、新しいリクエストがまったく同じか十分に近い場合にそれを再び返します。モデルの呼び出しを完全になくせる場合もあります。リスクは、似ているように見えただけの質問に対して、古い答えや微妙に間違った答えを返してしまうことで、パーソナライズされたもの、時間に左右されるもの、重大な影響を伴うものでは深刻な問題になります。よくあるサポートの問い合わせや定型的な分類など、範囲が狭く繰り返しの多い質問には適していますが、自由度の高い生成にはあまり向きません。
キャッシュが最も適しているのは、利用データが頻繁な繰り返しを示している場合です。タグ付けしたログで、同じ大きな前置き部分が1日に何千回も送られていることが分かったら、より凝った手法よりも先にキャッシュに注目すべきです。
バッチ処理: スピードを価格と引き換えにする
すべてのリクエストに即座の答えが必要なわけではありません。夜間のデータ補完、レポート作成、一括分類、バックオフィスの整理作業は、バッチで非同期に実行できます。多くのプロバイダーは、後回しにできるバッチ型の処理をリアルタイム処理より安く設定しており、バッチ処理は自社インフラの負荷を平準化する効果もあります。トレードオフは、結果が届くのが遅れることです。これは製品上の判断です。夜間に実行しても顧客が本当に気づかないジョブはどれか。それをリストアップし、移せるものを移してください。
蒸留とfine-tuning: 狭い仕事には小さなモデルを
蒸留とは、特定のタスクで大きなモデルを模倣するように小さなモデルを学習させることです。fine-tuningとは、既存のモデルを自社のデータに適応させることです。どちらも同じ成果を目指しています。必要な1つのことを十分にこなせる、より安価なモデルです。
研究は、一定の範囲内でこの考え方を裏付けています。「Distilling Step-by-Step」の論文は、大きなモデルの根拠説明を追加の学習シグナルとして使うことで、7億7,000万パラメータのT5モデルが、利用可能な学習データの80%だけを使って、あるベンチマークでfew-shotのpromptを与えた5,400億パラメータのPaLMモデルを上回ったと報告しています。これは1つのベンチマークでの結果ですが、原則をよく示しています。定義されたタスクであれば、小さな専用モデルが汎用の巨大モデルと競えるのです。
企業にとってのトレードオフは次のとおりです。
- 初期と継続的な手間。 学習データ、評価セット、エンジニアリングの工数、そしてタスクやデータが変化したときに再学習する計画が必要です。
- 能力の範囲が狭まる。 小さなモデルは1つの仕事をうまくこなしますが、その範囲外の入力では失敗することがあります。代替の処理経路が必要です。
- 目標が動き続ける。 汎用モデルは改善と低価格化を続けるため、蒸留したモデルの優位性は縮小し得ます。定期的に比較し直してください。
- 利用規約。 一部のプロバイダーは、自社モデルの出力をほかのモデルの学習に使うことを制限しています。その前提でパイプラインを構築する前に、規約を確認してください。
最も適しているのは、タスクが安定していて、量が多く、明確に定義されていて、評価しやすい場合です。毎週変わるタスクや幅広い推論が必要なタスクには向きません。
関連して知っておく価値のある手法に、投機的デコーディングがあります。小さなモデルがtokenの下書きを作り、大きなモデルがそれを検証する手法です。元の論文は、標準的な実装と比べて、出力をまったく変えずに2倍から3倍の高速化を報告しています。これは製品上の判断というより、主にサービングプロバイダーやインフラチームが実装するものですが、自社ホスティングのサービングコストが下がり続けている理由を説明してくれます。
オープンウェイトと自社ホスティング対API
ある程度の量に達すると、創業者はAPIでモデルを借りるのをやめ、オープンウェイトのモデルを自社のインフラで動かすべきかを考えるようになります。もっともな問いですが、答えがはっきりとイエスかノーになることはまれです。
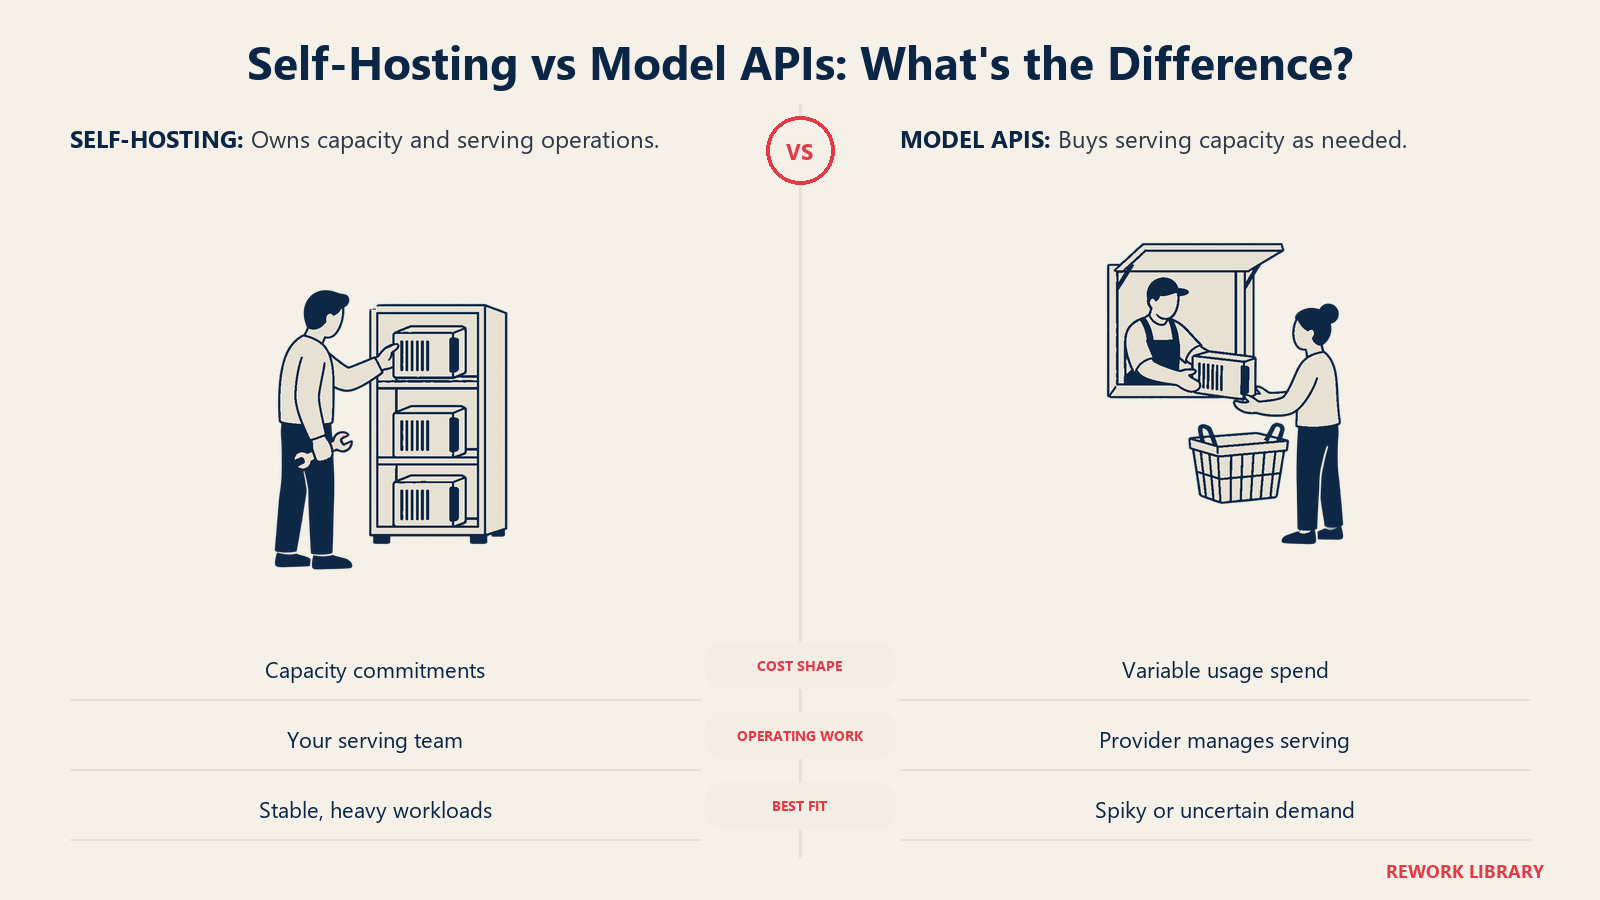
自社ホスティングで得られるもの: 大量で安定した利用におけるより予測可能なコスト、データの保存場所と取り扱いの管理、カスタマイズの自由、そしてプロバイダーの価格やポリシーの変更からの影響の遮断です。
そのコスト: キャパシティ計画、GPUの調達やレンタル契約、サービングのエンジニアリング、モニタリング、セキュリティ、アップグレードを自ら担うことになります。使われていないキャパシティは純粋な無駄であり、需要の急増は固定されたキャパシティを圧倒することがあります。また、オープンモデルと最先端モデルの間に品質の差があれば、それも自社で抱えることになります。
有用な捉え方があります。APIは固定キャパシティの問題を変動費に変え、自社ホスティングはそれを元に戻すものです。需要の変動が激しい、あるいはまだ見通せないなら、変動費であることは利点です。需要が安定して大きく、タスクがオープンモデルに適しているなら、固定費のほうが有利になる場合もありますが、それはエンジニアの人件費を計算に入れた後の話です。多くの企業は最終的にハイブリッド型になります。大量でよく理解されたワークロードは自社ホスティングし、ロングテールと最も難しいリクエストにはAPIを使うのです。スタックのどこまでを自社で所有するかはコストだけでなく戦略上の選択でもあり、その側面はアプリケーション層とモデル層の比較で取り上げています。
レート制限と利用上限
技術的な制限は、最悪のコストの不意打ち2つ、つまり不正利用と事故から自社を守ります。無料プランには、製品を許される限り酷使する人が集まります。顧客側の連携にバグがあると、ループして1時間に何千回もの呼び出しを消費することがあります。
妥当な管理策には、ユーザーごとやアカウントごとのレート制限、さらなる支出が発生する前にレビューを発動する日次または月次の支出上限、無料アカウントや試用アカウントへの厳格な上限があります。顧客のことを考えて設計してください。有料顧客を驚かせる制限は、サポートチケットになり、解約のリスクになります。70%や80%の時点で警告し、上限に達したら何が起きるかを説明し、管理者が上限を引き上げられる手段を用意してください。
価格面の歯止め: コストの一部を価格に負担させる
エンジニアリングの手段は自社のコストを下げます。価格の手段は、誰がそのコストを負担するかを変えます。利益率の問題は、コスト側よりも売上側のほうが早く解決できることが多いため、両方を同じ議論の中で扱うべきです。
一般的な歯止めは次のとおりです。
- 「無制限」をうたうプランの公正利用ポリシーで、無制限が実際に何を意味するかを定義する。
- 超過料金付きの利用枠で、ヘビーな利用がコストだけでなく売上も生むようにする。AIプロダクトのハイブリッド型価格設定のガイドでは、利用枠と超過料金の設定方法を順に説明しています。
- クレジットで、扱いにくい変動費を、顧客が予算を立てられる単一の通貨に変える。クレジット制の価格設定をご覧ください。
- 価値に連動した計量で、売上が単なる活動量ではなく、顧客が製品から実際に得ているものに応じて動くようにする。
トレードオフは、営業上の摩擦と請求の複雑さです。顧客は予測可能な請求を好み、ルールが1つ増えるたびに説明が必要になります。良いテストは、最もコストのかかる顧客が、現在の価格でも利益を生んでいるかどうかです。単位ごとのデータが「いいえ」と示しているなら、それはエンジニアリングの問題である前に価格設定の問題です。
ガバナンス: 誰がその数字に責任を持つか
手段は勝手には動きません。モデル費用を管理できている企業には、たいてい同じいくつかの仕組みがあります。
責任者の指名。 モデルのコストは、エンジニアリング、プロダクト、財務、場合によってはカスタマーサクセスにまたがります。全員のものは、誰のものでもありません。説明責任を負う1人を選んでください。多くの場合、財務担当のパートナーと組むエンジニアリング部門の幹部です。そしてその人にダッシュボードを渡してください。
製品領域ごとの予算。 機能やチームごとに、タスクあたりのコストや売上に対する比率など、意味のある単位で表したモデル費用の予算を割り当てます。予算は、人々が自分の設計上の選択の結果を目にするため、行動を変えます。
レポートだけでなくアラートを。 月次レビューでは、暴走したコストに30日遅れで気づくことになります。日次の支出、タスクあたりのコスト、顧客単位の異常な消費量にアラートを設定してください。
リリース前のレビュー。 新しいAI機能はすべて、リリース前にコストの見積もりを行います。タスクあたりの想定呼び出し回数、想定token数、単位あたりの想定コスト、想定価格です。短いチェックリストですが、「リリースしたら利益率が消えた」という事態を防ぎます。
定期的なサイクル。 ルーティングのルール、キャッシュ、モデルの選択を四半期ごとに見直してください。選択肢は変わり続けており、昨年の最良の構成が今年も最良であることはまれです。
妥当な実施の順序
ゼロから始める場合、おおよその順序を守れば、労力を成果に見合ったものにできます。
- タスク、顧客、機能ごとのコストを計測できるようにする。
- 費用がどこに集中しているか、どの顧客が赤字かを見つける。
- promptとコンテキストを削減し、繰り返しが明らかな箇所にキャッシュを追加する。
- 急ぎでない作業をバッチ処理に移す。
- 費用が最も多いタスクの種類に、評価セットに裏付けられたルーティングまたはカスケードを追加する。
- 上限、アラート、公正利用の条件を設定し、データが差を示している箇所の価格設定を修正する。
- 蒸留や自社ホスティングは、安定した大量のワークロードに限り、より安価な手段を使い尽くした後にのみ検討する。
この順序なら、安価で元に戻せる施策を先に、重く元に戻しにくい施策を最後に行えます。
重要なポイント
- 最適化する前に、販売している単位(タスク、顧客、機能)でコストを測定してください。プロバイダーからの1枚の請求書では、誰が利益を生んでいないかは分かりません。
- カスケードはまず安価なモデルを試し、必要に応じて上位モデルに引き上げます。FrugalGPTの著者たちは、最良の単一モデルと同等の性能を最大98%のコスト削減で達成、あるいは同じコストで精度を4%向上と報告しています。
- 学習済みのルーターもコストを削減できます。RouteLLMの著者たちは、特定のケースで応答品質を損なわずにコストを2分の1以下に削減と報告しています。
- 蒸留によって、タスクに特化した小さなモデルを作れます。ある研究は、利用可能な学習データの80%を使い、7億7,000万パラメータのモデルが、あるベンチマークでfew-shotのpromptを与えた5,400億パラメータのモデルを上回ったと報告しています。
- 投機的デコーディングは大規模モデルのサービングを高速化します。その著者たちは、出力をまったく変えずに2倍から3倍の高速化を報告しています。
- 研究結果は特定のベンチマークから得られたものです。削減を当てにする前に、すべての手段を自社の評価セットで検証してください。
- 価格の手段(利用枠、超過料金、クレジット、公正利用)は、コストを生み出している側にコストを移すもので、エンジニアリングの変更より早く導入できることが多いです。
- すべてのコスト項目には、指名された責任者、予算、アラートが必要です。
AIモデルのコスト管理に関するよくある質問
モデルのコストが上がり始めたら、最初に何をすべきですか。
すべてのモデル呼び出しにタグを付け、タスク、顧客、機能ごとのコストを測定してください。1枚の請求書では、どの顧客や機能が費用を押し上げているかは分かりません。お金がどこに流れているかが見えれば、当て推量ではなく、状況に合った手段を選べます。
モデルのカスケードとは何で、どれくらい節約できますか。
カスケードは、まず安価なモデルにリクエストを送り、最初の答えが十分でない場合にのみ強力なモデルに引き上げる仕組みです。FrugalGPTの論文は、同論文のベンチマークで、最良の単一モデルと同等の性能を最大98%のコスト削減で達成したと報告しています。実際の節約額は簡単なリクエストと難しいリクエストの比率によって変わるため、自社のタスクで試してください。
キャッシュはAIプロダクトにとって安全ですか。
promptの安定した冒頭部分を再利用するpromptキャッシュは、答えを変えません。似た質問に保存済みの答えを返すレスポンスキャッシュは、古い結果や合わない結果を返すことがあるため、範囲が狭く繰り返しの多いクエリに使い、パーソナライズされたものや時間に左右されるものには使わないでください。
APIではなくオープンウェイトのモデルを自社ホスティングするのが理にかなうのはどんなときですか。
通常は、利用量が多く安定していて、タスクがオープンモデルに適しており、それを運用するエンジニアリング体制がある場合です。APIはキャパシティを変動費に変えるため、不確実で変動の激しい需要に向いています。多くの企業は最終的にハイブリッド型になり、予測可能な重いワークロードは自社ホスティングし、それ以外にはAPIを使っています。
価格設定でモデルコストの問題を解決できますか。
多くの場合、できます。超過料金付きの利用枠、クレジット、公正利用の条件は、ヘビーな利用のコストを、それを生み出している顧客に移します。最もコストのかかる顧客が現在の価格で利益を生んでいないなら、それはエンジニアリングの作業より先に、あるいは並行して埋めるべき価格設定の差です。
社内でモデルのコストに責任を持つべきなのは誰ですか。
指名された1人で、通常は財務担当のパートナーと組むエンジニアリング部門の幹部です。単位あたりのコストのダッシュボード、製品領域ごとの予算、異常な支出へのアラートをその人に与えてください。説明責任を負う1人がいないまま責任を共有すると、結局誰も動かないことになりがちです。
関連記事
