AI企業の推論コストと粗利益率
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
従来のソフトウェアには、ありがたい特性があります。製品をいったん作ってしまえば、顧客を1社増やしてもほとんどコストがかからないのです。だからこそ、ソフトウェアの粗利益率は投資家の称賛の的になりました。AIプロダクトはこの特性を崩します。顧客が製品に何かを頼むたびにモデルが動き、モデルを動かすには実際にお金がかかります。このコストは推論と呼ばれ、AI企業の粗利益率が従来のソフトウェア企業とまったく違って見える最大の理由です。
本記事では、その仕組みを説明します。推論とは何か、なぜ変動費のように振る舞うのか、1件のリクエストのコストがどのように利益率の数字になるのか、なぜ一握りのヘビーユーザーが平均を大きく崩し得るのか、そして価格モデルが誰にリスクを負わせるかをどう決めるのか、です。対象はチームを持つB2B企業の創業者とオーナーCEOです。計算例ではキリのよい架空の数字を使っており、実在するモデルの価格を反映したものではありません。
これらのコストが損益計算書上でどう分類されるかは、AI企業における売上原価(COGS)の会計処理をご覧ください。コストを削減する方法については、AIモデルのコスト管理をご覧ください。本記事では、コストがどのように発生し、どのように利益率に届くかに絞って説明します。
学習と推論の違い
AIビジネスでは、2つの異なる活動が計算資源を消費し、その振る舞いは大きく異なります。
学習とは、モデルを構築したり適応させたりすることです。顧客へのサービス提供の前に(あるいは並行して定期的に)行われます。コストが高く、発生のタイミングが不規則で、製品の利用者数とはほとんど関係がありません。自社でモデルを構築する場合、学習の実行は、販売に伴う提供コストというより開発プロジェクトに近いものです。
推論とは、学習済みのモデルを動かして答えを生成することです。顧客が操作を行うたびに発生します。モデルをfine-tuningする場合も、他社のモデルを呼び出す場合も、同じ区別が当てはまります。能力を構築するのが1つのコストで、それを提供するのが別のコストです。
この区別が重要なのは、2つのコストが異なる軸でスケールするからです。学習コストは、モデルがどれだけ野心的かに応じてスケールします。推論コストは、顧客がどれだけ使うかに応じてスケールします。AIプロダクトをより多くの顧客に販売したり、既存顧客の利用を増やしたりしても、学習の請求額は増えません。増えるのは推論の請求額で、ほぼ比例して増えていきます。
だからこそ、推論は粗利益率に表れるコストなのです。製品を提供する行為の中で発生し、提供が増えれば増えます。
推論が変動費のように振る舞う理由
従来のソフトウェア製品では、1件のリクエストにかかる限界費用は誤差の範囲です。サーバー代はまとまった単位で支払い、トラフィックがその枠を埋めていきます。AIプロダクトでは、リクエストごとに独自の計算処理が行われ、その量はリクエストの内容によって変わります。それを決める要素はいくつかあります。
入力tokenと出力token。 言語モデルは、tokenと呼ばれる小さな単位でテキストを読み書きします。短い質問に短い答えを返すのは安価です。長い文書から長い要約を作るのはそうではありません。プロバイダーの場合も自社ホスティングの場合も、読み取り側(入力)と書き込み側(出力)は別扱いされる傾向があり、一般に長い出力を生成するコストは、同じ量の入力を読み取るコストより高くなります。
コンテキストの長さ。 多くの製品は、それまでの会話、検索で取得した文書、指示、例など、追加の情報を各リクエストに詰め込みます。そのコンテキストは毎回読み直されます。20往復続いたチャットでは、履歴全体が毎回一緒に送られるため、1メッセージあたりのコストは最初のメッセージより高くなります。
モデルのサイズ。 より大きく高性能なモデルは、小さなモデルよりtokenあたりのコストが高くなります。すべてのタスクに1つのモデルを使うのは最もシンプルな設計ですが、最も高くつくことが多いのです。
推論ステップ。 一部のモデルは、答える前に「考える」ために追加のtokenを使います。顧客の目には触れなくても、こうした思考tokenは通常、支払いの対象に含まれます。難しい質問では、目に見える答えから想像されるより何倍も多いtokenが生成されることがあります。
エージェントのループ。 AIエージェントは1回答えて終わりではありません。計画を立て、ツールを呼び出し、結果を読み、次に何をするかを決め、それを繰り返します。1周ごとにモデルの呼び出しが1回増え、呼び出しのたびに膨らみ続けるコンテキストを読み直します。Anthropicのエンジニアリングチームは、自社のマルチエージェント型リサーチシステムについて、エージェントは通常チャットでのやり取りの約4倍、マルチエージェントシステムは約15倍のtokenを使うと報告しています。これは1社の、1種類のワークロードに関するデータです。普遍的な倍率としてではなく、答えるだけの段階から行動する段階に移るとコストがどれほど急激に上がり得るかを示す例として捉えてください。
再試行と失敗。 出力がチェックに通らなかったり、検証ツールに却下されたり、ツール呼び出しがエラーになったりすると、製品はたいてい再試行します。再試行のたびに、元の試行と同じコストがかかります。再試行率が10%の製品は、「正常系」から想定されるより約10%多い推論費用を抱えています。
これらを合わせると、製品の画面上ではまったく同じに見える2つの操作、たとえば「分析を実行」が、コストでは10倍、100倍も違い得る理由が分かります。エージェントシステムに特化したコスト管理を詳しく知りたい方は、AIエージェントのコスト最適化をご覧ください。
リクエストあたりのコストが粗利益率になる仕組み
粗利益率は、売上から製品提供の直接コストを差し引き、それを売上で割ったものです。AI企業では、その差し引く項目の中で推論が最大の直接コストであり、通常はホスティング、モニタリング、カスタマーサポートがそれに加わります。一般的な計算式は粗利益率の解説ページで取り上げています。ここで必要なのは、その関係の形だけです。
顧客あたりの売上が固定で、顧客あたりの推論コストが利用量に応じて変わるなら、粗利益率は顧客ごとに変わります。利益率は製品の性質ではありません。ある価格のもとで、製品に各顧客の使い方を掛け合わせたものの性質なのです。
これには実務上の帰結があります。全体を平均した利益率の数字を見ても、事業が健全かどうかは分かりません。平均70%の利益率は、ほとんどの顧客が80%で、少数が20%という意味かもしれません。全員が70%前後という意味かもしれません。この2つの企業はリスクがまったく異なり、ヘビーユーザーの問題を抱えているのは前者だけです。
例示用の数字を使った計算例
実際に1つ作ってみましょう。ここでの数字はすべてキリのよい架空のものです。実際の価格は1つもありません。
AIアシスタントを1シートあたり月額30ドルの定額で販売しているとします。1リクエストの推論コストは1セントと仮定します。シートは100あり、利用量にはばらつきがあります。実際、ほぼ必ずばらつきがあるものです。
| 顧客グループ | シート数 | 1シートあたりの月間リクエスト数 | 1シートあたりの推論コスト | 推論コストの合計 |
|---|---|---|---|---|
| ライト | 60 | 50 | 0.50ドル | 30ドル |
| ミディアム | 30 | 400 | 4.00ドル | 120ドル |
| ヘビー | 9 | 4,000 | 40.00ドル | 360ドル |
| エクストリーム | 1 | 20,000 | 200.00ドル | 200ドル |
| 合計 | 100 | 710ドル |
売上は100シート×30ドルで3,000ドルです。推論コストは710ドルです。ほかのコストをすべて無視すると、粗利益率は(3,000-710)÷3,000で、約**76%**になります。
健全に見えます。では、中身を見てみましょう。
- 60のライトシートは、それぞれ約29.50ドルの利益を生みます。
- 9のヘビーシートは、40ドルの推論コストが支払額の30ドルを上回るため、それぞれ10ドルの赤字になります。
- 1のエクストリームシートは170ドルの赤字です。
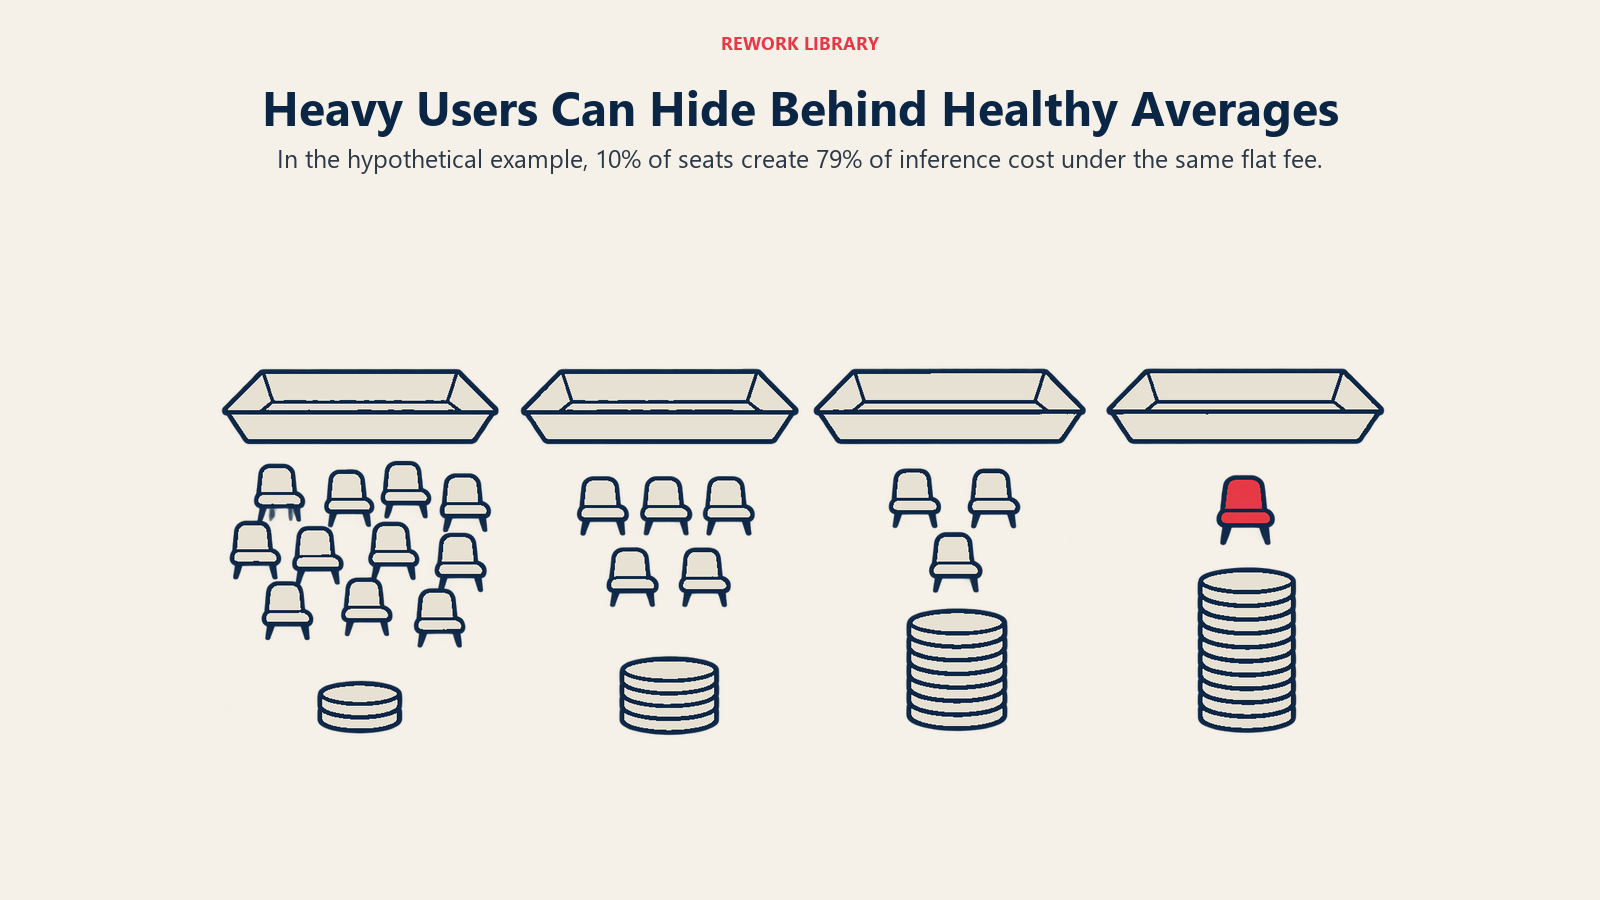
- この10のヘビーシートとエクストリームシート(顧客の10%)が、710ドルのコストのうち560ドル、つまり推論費用全体の約**79%**を生んでいます。
平均の数字は内部補助を覆い隠しています。ライトユーザーがヘビーユーザーの分を支払っているのです。利用者の構成が安定している限りは問題ありませんが、構成が変わった瞬間に脆くなります。
タスクあたりの利用量が増えるとどうなるか
次に、アップグレードを出荷したとします。アシスタントが、1リクエストごとに複数のステップを実行するエージェントになるのです。これで各リクエストのコストが5倍になり、1リクエストあたり5セントになるとしましょう。顧客が送るリクエストの数は変わりません。コストは3,000ドルの売上に対して3,550ドルになり、粗利益率は約**マイナス18%**になります。
製品を良くし、利用量は変わっていないのに、ソフトウェア並みの利益率から、すべてのシートで赤字を出す状態に転落しました。定額の価格は、リクエストあたりのコストの変化を吸収できません。価格がリクエストのことを知らないからです。
ヘビーユーザーのテール
この例は、ヘビーユーザーのテールと呼ばれるパターンを示しています。顧客間の利用量が正規分布になることはまれです。偏った分布になる傾向があり、ほとんどの顧客はほどほどの量を使い、少数のグループがはるかに多くを使います。定額の価格設定では、各顧客からの売上には上限がありますが、コストには上限がありません。
AIでは、従来のソフトウェアよりもテールを悪化させる要因が3つあります。
- 最良の顧客が最もコストのかかる顧客である。 製品を気に入っている人ほど、たくさん使います。契約を更新し、利用を拡大し、同僚に勧めてくれます。しかし、その熱意に比例して推論の請求額も膨らみます。
- エージェントが上限を引き上げる。 人間が1時間に送れるリクエストの数には限りがあります。スケジュール実行されるエージェントは数千件を送れます。自動化によって、シートあたりの利用量の自然な上限がなくなります。
- 製品が良くなるほどテールが伸びる。 出力が良くなれば、顧客はより大きなタスク、より長い文書、より自律的な作業を製品に任せるようになります。そのどれもがタスクあたりのコストを押し上げます。
だからといって、定額の価格設定が間違っているわけではありません。定額の価格設定はコストのリスクを自社に負わせるということであり、そういう取引をしたのだと自覚しておくべきだということです。
価格モデルの選択が誰にリスクを負わせるかを決める
AIプロダクトの価格設定を最も明快に考える方法は、1つの問いを立てることです。顧客あたりのコストが上がったとき、誰が支払うのか、という問いです。
| 価格モデル | 顧客が支払う対象 | 推論コストのリスクを負うのは誰か | 利益率が守られるのはどんなときか |
|---|---|---|---|
| シート単位の定額 | 1ユーザー分のアクセス | 主に自社 | シートあたりの利用量が安定していて少ないとき |
| 従量課金 | 消費した単位(リクエスト、タスク、分) | 主に顧客 | 単価が十分な余裕を持ってコストをカバーしているとき |
| クレジット | アクションに使う前払いの残高 | 料金表次第で分担 | アクションあたりのクレジットが実際のコストに連動しているとき |
| ハイブリッド型(プラットフォーム利用料と利用枠) | 基本料金と超過分 | 分担 | 利用枠がテールより十分低く設定されているとき |
シート単位の定額は販売しやすく、買い手にとっても予測しやすいモデルです。同時に、テールの影響を最も受けやすいモデルでもあります。AI時代のシート課金の記事では、仕事を人ではなくソフトウェアが行うようになると、なぜシートという単位が弱くなるのかを詳しく説明しています。
従量課金は、コストを生むのと同じ要因に売上を結びつけます。1リクエストごとに3セントの売上があり、コストが1セントなら、リクエストがいくつ来ても、各リクエストで67%の利益率を保てます。その代わりに支払う代償は、買い手にとっての予測しにくさです。
クレジットは、従量課金を別の形で包んだものです。料金表が実際のコストに基づいて作られていれば、アクションごとに利益率が守られます。アクションあたりのコストが変わっても料金表が変わらなければ、クレジットの仕組みの中で定額の価格設定と同じ問題を再現してしまいます。設計上の選択肢については、クレジット制の価格設定の解説で取り上げています。
ハイブリッド型は、予測可能な基本料金に利用枠を組み合わせ、それを超えた分を従量で課金します。買い手には予算を立てるための数字を、自社にはテールがどこまで伸びるかの上限をもたらします。AIプロダクトのハイブリッド型価格設定をご覧ください。
先ほどの例に戻ると、解決策は難しいものではありません。1シートあたり10ドルに、最初の300リクエストを含め、それを超えた分を1リクエスト3セントとする形に変えれば、エクストリームシートは30ドルではなく約600ドルを支払い、200ドルのコストはカバーされます。ライトシートは10ドルの基本料金を払い、利用枠の範囲内に収まります。表示価格が下がっても成約率が保たれるかは検証する必要があり、これは本当のトレードオフです。しかしこの構造なら、コストが実際に発生する場所で売上とコストが釣り合います。
長期的な傾向: 単位あたりは安く、タスクあたりの単位は多く
創業者はよく、推論は安くなっているのだから利益率の問題は自然に解決すると聞かされます。これには一理ありますが、落とし穴もあります。
一理あるという点は、十分に裏付けられています。Andreessen Horowitzは、この傾向をLLMflationと呼んで分析し、同等の性能のLLMであれば、コストは毎年10分の1になっていると述べています。Epoch AIは、約3年間にわたって6つのベンチマークで最先端モデルを調査し、低下の速度は性能の到達点によって大きく異なり、年に9分の1から900分の1の幅があることを見いだしました。さらに、最も急激な低下は直近の1年に起きているため、それが続くかどうかはあまりはっきりしないとも付け加えています。どちらの記述も、一定の能力水準に到達するための価格に関するものです。来年利用できる最高のモデルにいくら支払うことになるかを示しているわけではありません。
落とし穴は、方程式の後半にあります。タスクあたりのコストは、能力1単位あたりのコストに、そのタスクが消費する能力の量を掛けたものです。前者は急速に下がってきました。後者は、本記事で先に述べた理由から上がる傾向があります。
- 顧客が求めるのは昨年のモデルではなく最も高性能なモデルなので、常に最先端のものを買い続けます。
- 推論ステップが、答えごとにtokenを増やします。
- エージェントのループが、1つのリクエストを多数の呼び出しに変えます。
- より長いコンテキストやより大きな文書が実用的になり、人々がそれを使うようになります。
先に挙げたAnthropicの数字は、利用量側の規模を示しています。チャットからエージェントに移行すると、タスクあたりのtokenが数倍に膨らみます。能力1単位あたりの価格が年に10分の1に下がっても、タスクあたりにはるかに多くの単位を使う製品なら、その低下は消費し尽くされてしまいます。利益率への正味の影響は、自社のワークロードでどちらの力が勝つかによって決まり、それは自社のデータから答えを出すしかない実証的な問いです。
ここから導かれる計画上の姿勢は保守的なものです。コストが十分に下がって救ってくれることを前提に、今日の製品の価格を決めないでください。今日のコストで各顧客の利益率が保たれるように価格を設定し、単位コストの低下は、顧客と分け合うことも自社で確保することもできる上振れ要因として扱ってください。
何を測定すべきか
仕組みが役に立つのは、それを自社の数字の中で確認できる場合だけです。次の指標を追跡してください。
- アクティブ顧客1社あたりの月間推論コスト。 平均よりも分布のほうが役に立ちます。中央値、90パーセンタイル、上位10アカウントを確認してください。
- 顧客別、または利用量のコホート別の粗利益率。 目標を下回っている顧客がどれだけいるかを把握してください。
- リクエストあたりではなく、完了したタスクあたりのコスト。 再試行やエージェントのステップが「1つのタスク」の中に隠れていると、リクエストあたりの数字はコストを過小評価します。
- 上位10%のユーザーが占めるコストの割合。 例では79%でした。自社でも同様に集中しているなら、まず見直すべきは価格設定です。
- 同じ利用行動のもとでのリクエストあたりコストの推移。 これによって、単価の低下と利用量の増加を切り分けられます。
今これらを算出できないのであれば、そのためのログ基盤を作ることは、ほとんどの価格設定の実験よりも価値があります。あらゆる価格設定の判断は、コストがどこから来ているかを知っていることを前提にしているからです。
重要なポイント: 推論コストと粗利益率
- 学習はモデルを構築するもので、顧客の量とはほとんど関係がありません。推論は顧客の操作ごとにモデルを動かすもので、利用量に応じてスケールします。だからこそ、推論は粗利益率に表れるのです。
- リクエストあたりのコストは、入力と出力のtoken、コンテキストの長さ、モデルのサイズ、推論ステップ、エージェントのループ、再試行によって決まります。
- エージェントは通常チャットでのやり取りの約4倍、マルチエージェントシステムは約15倍のtokenを使います(Anthropicのエンジニアリングチームによる、自社のリサーチシステムに関する報告)。
- 同等の性能のLLMであれば、コストは毎年10分の1になっています(a16z)。
- Epoch AIによると、価格の低下は年に9分の1から900分の1の幅があり、性能の到達点によって異なり、最も急激な低下は直近の1年に起きています。
- 定額の価格設定では、顧客あたりの売上には上限がありますが推論コストにはないため、平均の数字が健全に見えていても、ヘビーユーザーは赤字の利益率で動いていることがあります。
- 本記事の例では、シートの10%が推論コストの約79%を生み、リクエストあたりのコストが5倍になると76%の利益率が赤字に変わります。
- 従量課金、クレジット、ハイブリッド型の価格設定は、シート単位の定額よりも多くのコストのリスクを顧客側に移します。
結論は短いものです。推論は、ソフトウェアの提供コストを誤差の範囲から、リクエストのたびに動く項目へと変えます。そして、その変動が顧客にかかるのか自社の利益率にかかるのかは、価格モデルによって決まります。アカウント全体での利用量の分布を把握し、今あるコストに基づいて価格を設定してください。
推論コストと粗利益率に関するよくある質問
AIにおける推論とは何ですか。
推論とは、学習済みのモデルを動かして、質問への回答やタスクの完了など、ユーザーのための出力を生成することです。顧客が操作を行うたびに発生するため、そのコストは利用量に応じて増えます。これに対して学習は、モデルを構築するための一度きり、または定期的な作業です。
推論はなぜ変動費なのですか。
リクエストごとに独自の計算処理が発生し、その量は入力と出力のtoken、コンテキストの長さ、モデルのサイズ、推論ステップ、エージェントのループ、再試行によって決まります。リクエストが増えたり重くなったりすれば、請求額も大きくなります。リクエストが1件増えてもほとんどコストがかからない従来のソフトウェアとは異なります。
推論コストは粗利益率にどう影響しますか。
推論は通常、AIプロダクトを提供する際の最大の直接コストであるため、粗利益率を直接押し下げます。サブスクリプションの売上は顧客ごとに変わらないことが多い一方で、推論コストは顧客ごとに変わるため、利益率は顧客ごとの数字になります。平均では健全な利益率でも、支払額以上のコストがかかっている顧客が隠れていることがあります。
AIの価格設定におけるヘビーユーザーの問題とは何ですか。
定額の価格設定では、顧客あたりの売上には上限がありますが、推論コストにはありません。少数のヘビーユーザー、多くの場合は最も熱心な顧客が、コストの大部分を占め、赤字の利益率で動くことがあります。結果的にライトユーザーがヘビーユーザーの分を補助することになり、これは利用者の構成が安定している間しか成り立ちません。
推論価格の低下だけで利益率の問題は解決しますか。
確実ではありません。一定の能力水準に対する価格は急速に下がっており、a16zは年に約10分の1、Epoch AIは年に9分の1から900分の1の幅を挙げています。しかし顧客は、より高性能なモデル、より長いコンテキスト、推論ステップ、エージェントも使うようになり、タスクあたりの計算量が増えます。どちらの力が勝つかは、自社のワークロード次第です。
推論コストから利益率を最もよく守る価格モデルはどれですか。
従量課金や、正確な料金表を持つクレジットなど、売上を利用量に結びつけるモデルは、リクエストごとに利益率を守ります。利用枠を含むハイブリッド型は、予測可能な基本料金を保ちながらテールに上限を設けます。シート単位の定額は、最も多くのリスクを自社に残します。適切な選択は、買い手がどの程度の予測しにくさを受け入れるかにもよります。
最初に何を測定すべきですか。
まず、顧客あたりの推論コストとアカウント全体での分布、特に上位10%のユーザーが占めるコストの割合から始めてください。次に、リクエストあたりではなく完了したタスクあたりのコストと、利用量のコホート別の粗利益率を追跡します。この3つで、自社の価格設定がコストの発生源と合っているかどうかが分かります。
関連記事
