Bahasa Indonesia
Mengelola Biaya Model seiring Pertumbuhan Penggunaan
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Biaya model berperilaku berbeda dari sebagian besar biaya perangkat lunak. Produk SaaS tradisional melayani pelanggannya yang ke-10.000 hampir tanpa biaya tambahan. Produk AI membayar komputasi setiap kali pelanggan memintanya melakukan sesuatu, sehingga tagihannya tumbuh seiring penggunaan, dan penggunaan cenderung tumbuh lebih cepat daripada pendapatan ketika pelanggan menyukai produknya. Itulah situasi yang dikelola para founder dan COO: bukan proyek optimasi satu kali, melainkan pos biaya yang membutuhkan pemilik, dashboard, dan serangkaian tuas.
Panduan ini membahas tuas-tuas tersebut di tingkat perusahaan. Panduan ini sengaja netral terhadap vendor. Tidak ada harga model yang disebutkan, karena harga terlalu sering berubah untuk berguna dalam artikel referensi, dan yang dijelaskan adalah kelompok teknik, bukan produk. Jika Anda menginginkan sudut pandang engineering per agen tentang caching, routing, dan anggaran panggilan, bacalah optimasi biaya agen AI. Jika Anda menginginkan sisi akuntansinya, yaitu bagaimana biaya ini diklasifikasikan dan bagaimana biaya itu mengalir ke margin, lihat COGS perusahaan AI dan biaya inferensi AI dan margin kotor. Di sini kita tetap pada pertanyaan yang benar-benar dihadapi tim kepemimpinan di tahap pertumbuhan: apa yang dapat kita lakukan, dengan urutan apa, dan siapa pemiliknya?
Mulailah dari visibilitas, bukan optimasi
Hampir setiap upaya pemangkasan biaya yang gagal dimulai dari tempat yang salah. Tim memilih teknik yang cerdas sebelum mereka tahu ke mana uangnya mengalir. Tuas pertama sama sekali bukan teknik. Tuas pertama adalah pengukuran.
Faktur dari penyedia model adalah satu angka untuk seluruh perusahaan. Angka itu tidak dapat memberi tahu Anda apakah pelanggan tertentu menguntungkan, apakah fitur baru membocorkan margin, atau apakah lonjakan berasal dari pertumbuhan nyata atau dari satu pekerjaan yang lepas kendali. Untuk mendapatkan jawaban, Anda membutuhkan biaya yang diatribusikan ke unit yang dijual bisnis Anda.
Pilih unit yang sesuai dengan cara Anda menagih dan cara pelanggan berpikir:
- Biaya per tugas atau hasil: satu dokumen diproses, satu tiket diselesaikan, satu laporan dihasilkan.
- Biaya per pelanggan per bulan: total belanja model yang ditandai ke sebuah akun.
- Biaya per fitur: bagian produk mana yang mengonsumsi komputasi terbanyak.
- Biaya per pengguna aktif: berguna sebagai pemeriksaan kewajaran, tetapi menyembunyikan pembagian antara pengguna berat dan ringan.
Secara praktis, ini berarti menandai setiap panggilan model dengan ID pelanggan, nama fitur, dan jenis tugas pada saat panggilan dilakukan, lalu menyimpan tanda tersebut bersama jumlah token dan latensi. Ini pekerjaan infrastruktur yang tidak glamor, dan merupakan fondasi bagi semua hal di bawah ini. Setelah tersedia, petakan distribusinya, bukan sekadar rata-ratanya. Di banyak produk, sebagian kecil pelanggan mendorong sebagian besar biaya, dan rata-rata menyembunyikannya. Disiplin yang sama berlaku di bisnis apa pun di mana biaya bervariasi per pelanggan, dan penjelasan kami tentang unit economics membahas kerangka umumnya.
Dua tampilan layak dibangun sejak awal. Yang pertama adalah biaya per unit dibandingkan harga per unit, per segmen pelanggan, sehingga Anda dapat melihat segmen mana yang merugi. Yang kedua adalah biaya per unit dari waktu ke waktu, sehingga Anda dapat mengetahui apakah perubahan produk atau perubahan model membantu atau justru merugikan.
Tabel tuas
Setelah Anda dapat melihat biaya di tingkat unit, tuas-tuas itu menjadi pilihan, bukan tebakan. Tabel berikut merangkum masing-masing: apa itu, kompromi yang biasa terjadi, dan kapan ia cenderung cocok. Bagian-bagian setelahnya memberikan detailnya.
| Tuas | Apa itu | Kompromi umum | Kapan cocok |
|---|---|---|---|
| Visibilitas biaya per unit | Tandai setiap panggilan berdasarkan pelanggan, fitur, dan tugas | Waktu engineering di awal | Selalu, sebelum hal lainnya |
| Routing dan cascade | Coba model yang lebih murah dulu, eskalasi bila perlu | Risiko kualitas pada permintaan yang salah arah, latensi tambahan | Permintaan dengan tingkat kesulitan campuran pada volume yang berarti |
| Pemangkasan prompt dan konteks | Kirim lebih sedikit token per panggilan | Kemungkinan hilangnya konteks yang berguna | Prompt panjang, retrieval yang berlebihan, agen yang bertele-tele |
| Caching | Gunakan ulang komputasi sebelumnya untuk masukan yang berulang | Data usang, upaya pengelolaan cache | Prefiks yang stabil, kueri berulang atau hampir duplikat |
| Batching | Jalankan pekerjaan tidak mendesak secara asinkron dalam jumlah besar | Hasil tertunda | Laporan, pengayaan data, pekerjaan back-office |
| Distilasi dan fine-tuning | Latih model yang lebih kecil dengan keluaran model yang lebih besar | Upaya di awal, kemampuan lebih sempit, pemeliharaan | Tugas yang stabil, bervolume tinggi, dan terdefinisi dengan baik |
| Open-weight atau self-hosting | Jalankan model di infrastruktur sendiri | Beban operasional, risiko kapasitas | Beban berat yang dapat diprediksi, kebutuhan kendali data |
| Batas laju dan batas pemakaian | Batasi konsumsi per pengguna atau akun | Hambatan bagi pengguna berat yang sah | Risiko penyalahgunaan, paket gratis, permintaan yang tidak merata |
| Pagar pengaman harga | Ketentuan pemakaian wajar, kredit, kelebihan pemakaian | Hambatan penjualan, kompleksitas | Biaya yang sangat bervariasi per pelanggan |
| Tata kelola | Anggaran, peringatan, pemilik yang ditunjuk | Beban proses | Begitu belanja menjadi material |
Routing dan cascade: model kecil lebih dulu
Gagasan di balik cascade itu sederhana. Sebagian besar permintaan itu mudah, dan model murah menanganinya dengan baik. Sebagian kecil sulit dan membutuhkan model yang lebih mampu dan lebih mahal. Jika Anda dapat membedakan mana yang mana, atau mengetahuinya dengan biaya murah, Anda hanya membayar harga tinggi ketika memang sepadan.
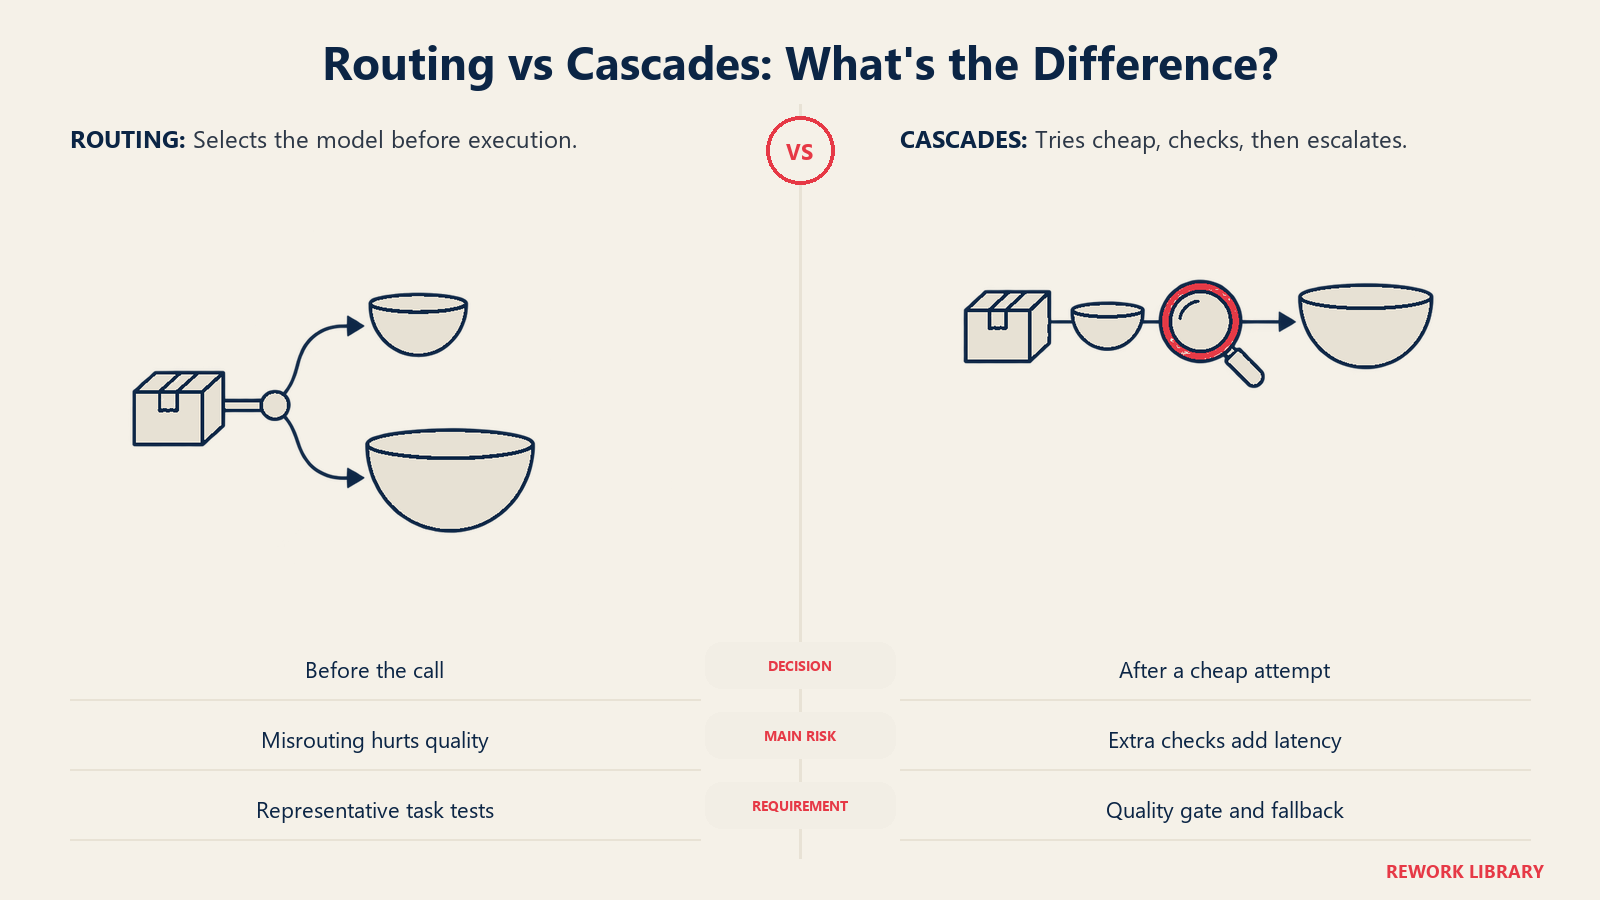
Ada dua bentuk umum. Dalam cascade, Anda mengirim permintaan ke model yang lebih murah terlebih dahulu, memeriksa apakah jawabannya cukup baik, dan mengeskalasi ke model yang lebih kuat hanya jika tidak. Dalam routing, sebuah pengklasifikasi memutuskan di awal model mana yang harus menangani permintaan, tanpa mencoba model murah terlebih dahulu.
Riset di bidang ini layak diketahui, dan angkanya layak dibaca dengan cermat. Makalah FrugalGPT mengusulkan cascade antarmodel dan melaporkan bahwa pendekatan ini dapat menyamai kinerja model individual terbaik dengan pengurangan biaya hingga 98 persen, atau meningkatkan akurasi di atas model tersebut sebesar 4 persen dengan biaya yang sama. Itu adalah hasil para penulis pada benchmark mereka, dan kata "hingga" sangat menentukan dalam klaim pertama. Beban kerja Anda akan berbeda. Makalah RouteLLM melatih router dengan data preferensi manusia dan melaporkan bahwa pendekatannya mengurangi biaya lebih dari 2 kali lipat dalam kasus tertentu tanpa mengorbankan kualitas respons, dan bahwa router tersebut tetap berfungsi ketika model yang mendasarinya berubah saat pengujian.
Perlakukan keduanya sebagai bukti bahwa tuas ini nyata, bukan sebagai perkiraan penghematan. Kompromi jujurnya adalah sebagai berikut:
- Salah routing mengorbankan kualitas. Jika router mengirim permintaan sulit ke model yang lemah dan tidak ada yang menangkapnya, pelanggan mendapat jawaban yang buruk. Anda membutuhkan cara untuk mengukur kualitas jawaban pada tugas Anda sendiri sebelum memercayai sebuah router.
- Cascade menambah latensi. Permintaan yang gagal pada percobaan murah membayar panggilan murah, pemeriksaan, lalu panggilan mahal. Untuk produk interaktif, penundaan itu bisa berpengaruh.
- Pemeriksa juga memiliki biaya. Memutuskan apakah sebuah jawaban cukup baik tidaklah gratis. Sebagian tim menggunakan aturan sederhana, sebagian menggunakan model kecil, sebagian menggunakan sinyal tingkat keyakinan. Masing-masing memiliki titik kegagalan.
- Dibutuhkan set evaluasi. Tanpa sekumpulan tugas representatif dengan jawaban yang diketahui benar, Anda tidak dapat mengetahui apakah perubahan routing membantu atau diam-diam merugikan.
Di tingkat perusahaan, langkah praktisnya adalah memulai dari tempat biaya terkonsentrasi. Gunakan data per unit Anda untuk menemukan satu atau dua jenis tugas yang menyumbang sebagian besar belanja, dan uji routing di sana terlebih dahulu.
Pemangkasan prompt dan konteks
Biaya berskala sesuai jumlah teks yang masuk dan keluar, sehingga token termurah adalah token yang tidak pernah Anda kirim. Tuas ini cenderung diremehkan karena terasa biasa saja, padahal sering memberi hasil dengan cepat.
Tempat-tempat yang umum untuk diperiksa:
- Instruksi yang membengkak. Prompt sistem mengumpulkan aturan selama berbulan-bulan. Banyak di antaranya dapat dipersingkat atau dihapus tanpa mengubah perilaku.
- Retrieval berlebihan. Menarik sepuluh potongan dokumen ke dalam konteks padahal tiga sudah cukup akan menaikkan biaya di setiap panggilan.
- Riwayat percakapan. Mengirim ulang riwayat panjang di setiap giliran dapat mendominasi biaya. Meringkas giliran-giliran lama menukar sedikit ketepatan dengan penghematan yang besar.
- Keluaran yang bertele-tele. Meminta respons yang terstruktur dan ringkas, sejauh produk memungkinkan, mengurangi belanja keluaran.
Komprominya adalah memangkas konteks dapat memangkas kualitas dengan cara yang sulit dilihat. Perlakukan setiap perubahan pemangkasan sebagai eksperimen terhadap set evaluasi Anda, bukan sebagai pekerjaan bersih-bersih. Prompt yang 30 persen lebih pendek dan 5 persen lebih buruk hanya merupakan kemenangan jika pelanggan Anda tidak dapat merasakannya dan margin Anda memang membutuhkan bantuan.
Caching: jangan membayar dua kali untuk pekerjaan yang sama
Caching hadir dalam dua jenis besar.
Prompt (prefix) caching memungkinkan penyedia atau lapisan penyajian menggunakan ulang komputasi untuk bagian awal prompt yang panjang dan stabil, seperti instruksi dan dokumen referensi, sehingga panggilan berulang dengan prefiks yang sama berbiaya lebih rendah. Teknik ini menguntungkan prompt yang disusun dengan bagian stabil di depan dan bagian yang berubah di belakang. Ketentuan dan diskonnya berbeda-beda antarpenyedia dan berubah dari waktu ke waktu, jadi periksa dokumentasi terkini alih-alih memercayai angka dalam sebuah artikel.
Response (semantic) caching menyimpan jawaban dan menyajikannya kembali ketika permintaan baru identik atau cukup mirip. Teknik ini dapat menghilangkan panggilan model sepenuhnya. Risikonya adalah menyajikan jawaban yang usang atau sedikit keliru untuk pertanyaan yang hanya tampak serupa, yang merupakan masalah nyata untuk apa pun yang dipersonalisasi, sensitif terhadap waktu, atau berisiko tinggi. Teknik ini cocok untuk pertanyaan sempit dan berulang seperti kueri dukungan yang umum atau klasifikasi standar, dan kurang cocok untuk pembuatan konten terbuka.
Caching paling cocok di tempat data penggunaan Anda menunjukkan pengulangan yang tinggi. Jika log yang sudah ditandai menunjukkan prefiks besar yang sama dikirim ribuan kali sehari, caching layak mendapat perhatian sebelum teknik yang lebih canggih.
Batching: menukar kecepatan dengan harga
Tidak setiap permintaan membutuhkan jawaban instan. Pengayaan data malam hari, pembuatan laporan, klasifikasi massal, dan pembersihan back-office dapat dijalankan secara asinkron dalam batch. Banyak penyedia menetapkan harga pemrosesan tertunda bergaya batch di bawah pemrosesan waktu nyata, dan batching juga meratakan beban pada infrastruktur Anda sendiri. Komprominya adalah hasilnya datang belakangan. Keputusannya adalah keputusan produk: pekerjaan mana yang benar-benar tidak akan disadari pelanggan jika dijalankan semalaman? Buat daftarnya, dan pindahkan apa yang bisa dipindahkan.
Distilasi dan fine-tuning: model lebih kecil untuk pekerjaan yang sempit
Distilasi melatih model yang lebih kecil untuk meniru model yang lebih besar pada tugas tertentu. Fine-tuning mengadaptasi model yang sudah ada ke data Anda. Keduanya mengarah ke hasil yang sama: model yang lebih murah yang cukup baik untuk satu hal yang Anda butuhkan.
Riset mendukung gagasan ini dalam batas tertentu. Makalah "Distilling Step-by-Step" melaporkan bahwa model T5 dengan 770M parameter mengungguli model PaLM 540B parameter yang diberi prompt few-shot pada sebuah benchmark, dengan hanya menggunakan 80 persen data pelatihan yang tersedia, dengan memanfaatkan penalaran model yang lebih besar sebagai sinyal pelatihan tambahan. Itu adalah hasil pada satu benchmark, tetapi mengilustrasikan prinsipnya: untuk tugas yang terdefinisi, model kecil yang terspesialisasi dapat bersaing dengan raksasa umum.
Kompromi bagi perusahaan:
- Upaya di awal dan berkelanjutan. Anda membutuhkan data pelatihan, set evaluasi, waktu engineering, dan rencana untuk melatih ulang ketika tugas atau datanya bergeser.
- Kemampuan yang lebih sempit. Model kecil mengerjakan satu pekerjaan dengan baik dan mungkin gagal pada masukan di luar itu. Anda membutuhkan jalur cadangan.
- Sasaran yang terus bergerak. Model umum terus membaik dan makin murah, sehingga keunggulan model hasil distilasi dapat menyusut. Periksa ulang perbandingannya secara berkala.
- Ketentuan penggunaan. Sebagian penyedia membatasi penggunaan keluaran model mereka untuk melatih model lain. Periksa ketentuannya sebelum Anda membangun pipeline berdasarkan asumsi itu.
Teknik ini paling cocok ketika tugasnya stabil, bervolume tinggi, terdefinisi dengan baik, dan mudah dievaluasi. Teknik ini kurang cocok untuk tugas yang berubah setiap minggu atau yang membutuhkan penalaran luas.
Teknik terkait yang layak diketahui adalah speculative decoding, di mana model kecil membuat draf token yang kemudian diverifikasi oleh model besar. Makalah aslinya melaporkan percepatan 2X hingga 3X dibandingkan implementasi standar dengan keluaran yang identik. Ini sebagian besar diterapkan oleh penyedia layanan penyajian atau tim infrastruktur Anda, bukan keputusan produk, tetapi menjelaskan mengapa biaya penyajian yang di-hosting sendiri terus menurun.
Open-weight dan self-hosting versus API
Pada volume tertentu, founder bertanya apakah sebaiknya berhenti menyewa model melalui API dan menjalankan model open-weight di infrastruktur sendiri. Ini pertanyaan yang sah, dan jawabannya jarang berupa ya atau tidak yang tegas.
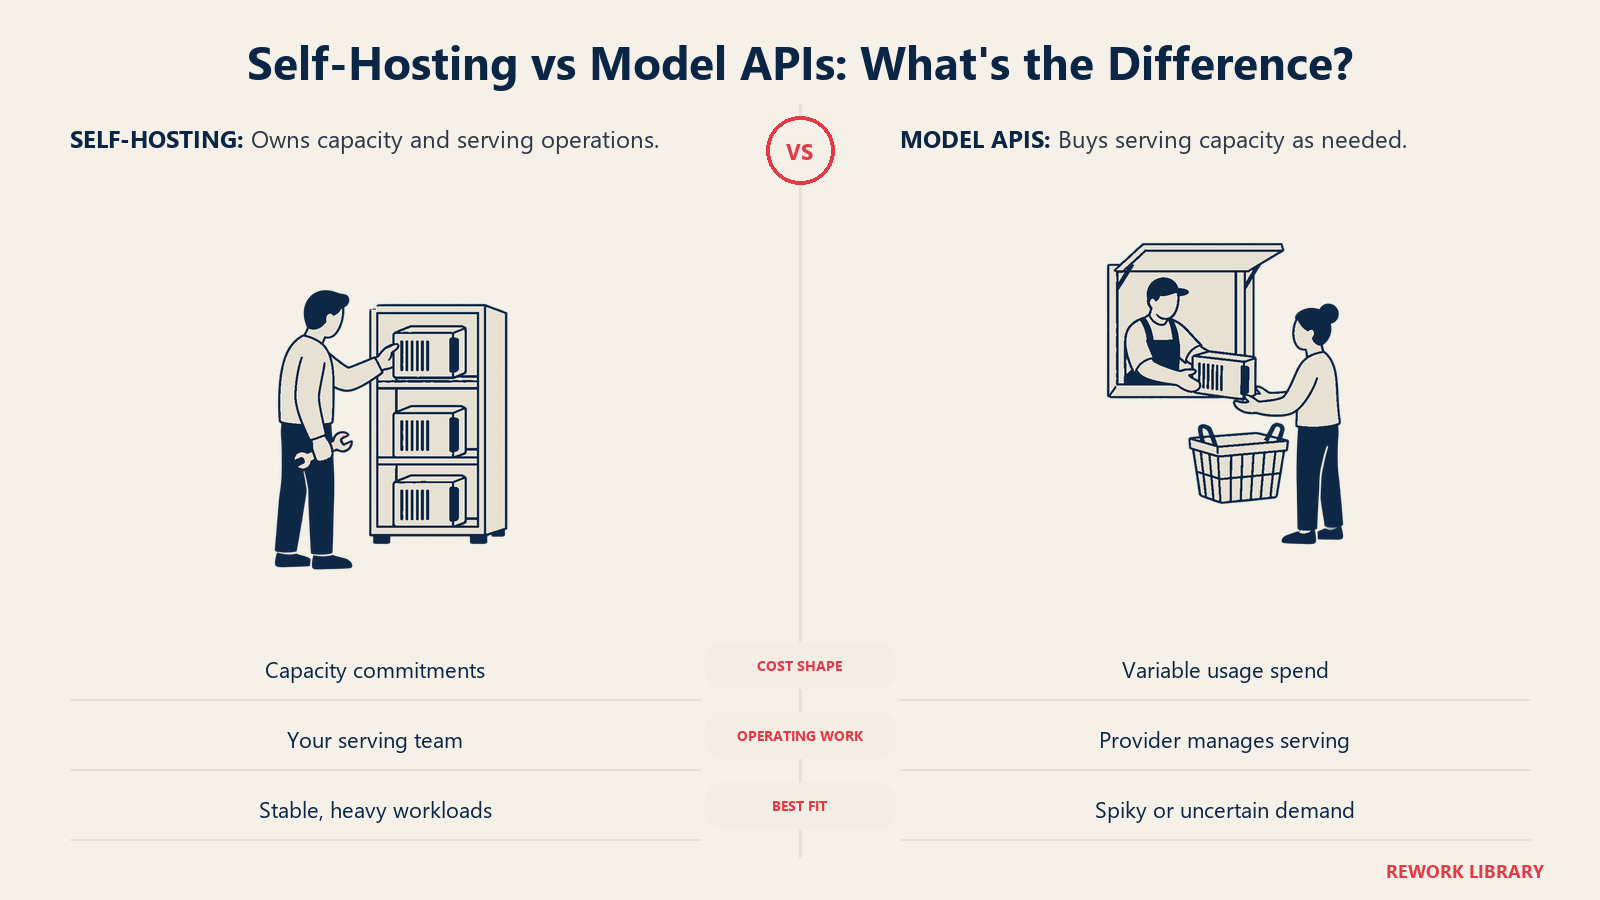
Apa yang dapat ditawarkan self-hosting: biaya yang lebih dapat diprediksi pada volume tinggi dan stabil, kendali atas lokasi dan penanganan data, kebebasan untuk melakukan kustomisasi, dan perlindungan dari perubahan harga atau kebijakan penyedia.
Apa biayanya: Anda menanggung perencanaan kapasitas, pengadaan GPU atau komitmen sewa, engineering penyajian, pemantauan, keamanan, dan pembaruan. Kapasitas yang menganggur adalah pemborosan murni, dan lonjakan permintaan dapat membanjiri kapasitas yang tetap. Anda juga menanggung kesenjangan kualitas, jika ada, antara model terbuka dan model terdepan.
Cara yang berguna untuk membingkainya: API mengubah masalah kapasitas tetap menjadi biaya variabel, dan self-hosting mengubahnya kembali. Jika permintaan Anda naik turun tajam atau belum diketahui, biaya variabel adalah sebuah keunggulan. Jika permintaan Anda stabil dan besar, dan tugasnya cocok untuk model terbuka, biaya tetap mungkin lebih menguntungkan, tetapi baru setelah Anda menghitung biaya para engineer. Banyak perusahaan akhirnya memakai pendekatan hibrida: melakukan self-hosting untuk beban kerja bervolume tinggi yang sudah dipahami dengan baik, dan menggunakan API untuk ekor panjang dan permintaan yang paling sulit. Seberapa banyak bagian stack yang Anda miliki juga merupakan pilihan strategis, bukan sekadar pilihan biaya, dan lapisan aplikasi vs lapisan model membahas sisi tersebut.
Batas laju dan batas pemakaian
Batas teknis melindungi Anda dari dua kejutan biaya terburuk: penyalahgunaan dan kecelakaan. Paket gratis menarik orang-orang yang akan memaksa produk sejauh yang diizinkan. Bug dalam integrasi pelanggan dapat berputar terus dan menghabiskan ribuan panggilan dalam satu jam.
Kontrol yang masuk akal mencakup batas laju per pengguna dan per akun, plafon belanja harian atau bulanan yang memicu peninjauan sebelum memicu belanja lebih lanjut, dan batas keras pada akun gratis dan uji coba. Rancang semuanya dengan memperhatikan pelanggan. Batas yang mengejutkan pelanggan berbayar berarti tiket dukungan dan risiko churn. Beri peringatan pada 70 atau 80 persen, jelaskan apa yang terjadi saat batas tercapai, dan beri admin cara untuk menaikkannya.
Pagar pengaman harga: biarkan harga menanggung sebagian biaya
Tuas engineering mengurangi biaya Anda. Tuas harga mengubah siapa yang menanggungnya. Keduanya termasuk dalam percakapan yang sama, karena masalah margin sering kali dapat diperbaiki dari sisi pendapatan lebih cepat daripada dari sisi biaya.
Pagar pengaman yang umum adalah:
- Kebijakan pemakaian wajar pada paket yang bertuliskan "tanpa batas," yang mendefinisikan arti tanpa batas dalam praktiknya.
- Kuota yang sudah termasuk dengan biaya kelebihan pemakaian, sehingga penggunaan berat menghasilkan pendapatan, bukan sekadar biaya. Panduan kami tentang harga hibrida untuk produk AI menjelaskan cara menentukan ukuran kuota dan tarif kelebihan pemakaian.
- Kredit, yang mengubah biaya variabel yang berantakan menjadi satu mata uang yang dapat dianggarkan pelanggan. Lihat harga berbasis kredit.
- Meteran yang terikat pada nilai, sehingga pendapatan bergerak mengikuti apa yang benar-benar didapat pelanggan dari produk, bukan mengikuti aktivitas mentah.
Komprominya adalah hambatan penjualan dan kompleksitas penagihan. Pelanggan menyukai tagihan yang dapat diprediksi, dan setiap aturan tambahan adalah sesuatu yang harus dijelaskan. Uji yang baik adalah apakah pelanggan termahal Anda juga menguntungkan pada harga saat ini. Jika data per unit mengatakan tidak, itu adalah masalah harga sebelum menjadi masalah engineering.
Tata kelola: siapa pemilik angkanya
Tuas tidak menarik dirinya sendiri. Perusahaan yang mengendalikan belanja model biasanya memiliki beberapa hal yang sama.
Pemilik yang ditunjuk. Biaya model melintasi engineering, produk, keuangan, dan terkadang customer success. Ketika menjadi milik semua orang, biaya itu tidak menjadi milik siapa pun. Pilih satu orang yang bertanggung jawab, sering kali seseorang di kepemimpinan engineering dengan mitra dari keuangan, dan berikan dashboard kepadanya.
Anggaran per area produk. Alokasikan anggaran belanja model untuk setiap fitur atau tim, dinyatakan dalam unit yang masuk akal, seperti biaya per tugas atau porsi pendapatan. Anggaran mengubah perilaku karena orang melihat konsekuensi dari pilihan desain mereka.
Peringatan, bukan sekadar laporan. Tinjauan bulanan menemukan biaya yang lepas kendali tiga puluh hari terlambat. Pasang peringatan pada belanja harian, pada biaya per tugas, dan pada konsumsi tingkat pelanggan yang tidak biasa.
Tinjauan sebelum peluncuran. Setiap fitur AI baru mendapat perkiraan biaya sebelum dirilis: perkiraan panggilan per tugas, perkiraan token, perkiraan biaya per unit, dan perkiraan harga. Ini daftar periksa yang singkat, dan mencegah cerita "kami meluncurkannya dan marginnya lenyap".
Ritme yang teratur. Tinjau ulang aturan routing, caching, dan pilihan model setiap kuartal. Pilihan terus berubah, dan konfigurasi terbaik tahun lalu jarang menjadi yang terbaik tahun ini.
Urutan langkah yang masuk akal
Jika Anda memulai dari nol, urutan kasar berikut menjaga upaya tetap sebanding dengan hasilnya:
- Pasang instrumen biaya per tugas, pelanggan, dan fitur.
- Temukan di mana belanja terkonsentrasi dan pelanggan mana yang merugi.
- Pangkas prompt dan konteks, serta tambahkan caching di tempat pengulangannya jelas.
- Pindahkan pekerjaan yang tidak mendesak ke pemrosesan batch.
- Tambahkan routing atau cascade untuk jenis tugas dengan belanja tertinggi, didukung oleh set evaluasi.
- Tetapkan batas pemakaian, peringatan, dan ketentuan pemakaian wajar, serta perbaiki harga di tempat data menunjukkan adanya celah.
- Pertimbangkan distilasi atau self-hosting hanya untuk beban kerja yang stabil dan bervolume tinggi, dan hanya setelah tuas yang lebih murah habis digunakan.
Urutan itu menempatkan langkah yang murah dan dapat dibatalkan di depan, serta langkah yang berat dan sulit dibatalkan di belakang.
Fakta Utama
- Ukur biaya pada unit yang Anda jual (tugas, pelanggan, fitur) sebelum melakukan optimasi. Satu faktur penyedia tidak dapat memberi tahu Anda siapa yang tidak menguntungkan.
- Cascade mencoba model yang lebih murah terlebih dahulu lalu mengeskalasi. Para penulis FrugalGPT melaporkan menyamai model individual terbaik dengan pengurangan biaya hingga 98 persen, atau meningkatkan akurasi sebesar 4 persen dengan biaya yang sama.
- Router yang dilatih juga dapat memangkas biaya. Para penulis RouteLLM melaporkan pengurangan biaya lebih dari 2 kali lipat dalam kasus tertentu tanpa mengorbankan kualitas respons.
- Distilasi dapat menghasilkan model kecil yang khusus untuk satu tugas. Satu studi melaporkan model 770M parameter mengungguli model 540B parameter yang diberi prompt few-shot pada sebuah benchmark, dengan menggunakan 80 persen data pelatihan yang tersedia.
- Speculative decoding mempercepat penyajian model besar. Para penulisnya melaporkan percepatan 2X hingga 3X dengan keluaran yang identik.
- Hasil riset berasal dari benchmark tertentu. Validasi setiap tuas terhadap set evaluasi Anda sendiri sebelum mengandalkan penghematannya.
- Tuas harga (kuota, kelebihan pemakaian, kredit, pemakaian wajar) memindahkan biaya kepada pihak yang menimbulkannya, dan sering kali lebih cepat diterapkan dibandingkan perubahan engineering.
- Setiap pos biaya membutuhkan pemilik yang ditunjuk, anggaran, dan peringatan.
Pertanyaan yang Sering Diajukan tentang Mengelola Biaya Model AI
Apa hal pertama yang harus dilakukan ketika biaya model mulai naik?
Ukur biaya per tugas, per pelanggan, dan per fitur dengan menandai setiap panggilan model. Satu faktur tidak dapat menunjukkan pelanggan atau fitur mana yang mendorong belanja. Setelah Anda dapat melihat ke mana uang mengalir, Anda dapat memilih tuas yang cocok alih-alih menebak.
Apa itu cascade model, dan berapa banyak penghematan yang bisa diberikannya?
Cascade mengirim permintaan ke model yang lebih murah terlebih dahulu dan mengeskalasi ke model yang lebih kuat hanya ketika jawaban pertama tidak cukup baik. Makalah FrugalGPT melaporkan dapat menyamai model tunggal terbaik dengan pengurangan biaya hingga 98 persen pada benchmark-nya. Penghematan nyata bergantung pada komposisi permintaan mudah dan sulit Anda, jadi ujilah pada tugas Anda sendiri.
Apakah caching aman untuk produk AI?
Prompt caching, yang menggunakan ulang bagian awal prompt yang stabil, tidak mengubah jawaban. Response caching, yang menyajikan jawaban tersimpan untuk pertanyaan serupa, dapat menghasilkan jawaban yang usang atau tidak sesuai, jadi gunakan untuk kueri yang sempit dan berulang, serta hindari untuk kueri yang dipersonalisasi atau sensitif terhadap waktu.
Kapan masuk akal melakukan self-hosting model open-weight alih-alih menggunakan API?
Biasanya ketika volumenya tinggi dan stabil, tugasnya cocok untuk model terbuka, dan Anda memiliki kapasitas engineering untuk menjalankannya. API mengubah kapasitas menjadi biaya variabel, yang cocok untuk permintaan yang tidak pasti atau naik turun tajam. Banyak perusahaan akhirnya memakai pendekatan hibrida, melakukan self-hosting untuk beban kerja berat yang dapat diprediksi dan menggunakan API untuk sisanya.
Apakah harga dapat memperbaiki masalah biaya model?
Sering kali, ya. Kuota yang sudah termasuk dengan biaya kelebihan pemakaian, kredit, dan ketentuan pemakaian wajar menggeser biaya penggunaan berat kepada pelanggan yang menimbulkannya. Jika pelanggan termahal Anda tidak menguntungkan pada harga saat ini, itu adalah celah harga yang perlu ditutup sebelum, atau bersamaan dengan, pekerjaan engineering.
Siapa yang sebaiknya memiliki biaya model di dalam perusahaan?
Satu orang yang ditunjuk, biasanya di kepemimpinan engineering dengan mitra dari keuangan. Berikan kepadanya dashboard biaya per unit, anggaran per area produk, dan peringatan atas belanja yang tidak biasa. Kepemilikan bersama tanpa satu pemilik yang bertanggung jawab cenderung berarti tidak ada yang bertindak.
Bacaan Terkait

Co-Founder & COO
On this page
- Mulailah dari visibilitas, bukan optimasi
- Tabel tuas
- Routing dan cascade: model kecil lebih dulu
- Pemangkasan prompt dan konteks
- Caching: jangan membayar dua kali untuk pekerjaan yang sama
- Batching: menukar kecepatan dengan harga
- Distilasi dan fine-tuning: model lebih kecil untuk pekerjaan yang sempit
- Open-weight dan self-hosting versus API
- Batas laju dan batas pemakaian
- Pagar pengaman harga: biarkan harga menanggung sebagian biaya
- Tata kelola: siapa pemilik angkanya
- Urutan langkah yang masuk akal
- Fakta Utama
- Bacaan Terkait