Modellkosten steuern, wenn die Nutzung wächst
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Modellkosten verhalten sich anders als die meisten Softwarekosten. Ein klassisches SaaS-Produkt bedient seinen zehntausendsten Kunden fast ohne Mehrkosten. Ein KI-Produkt bezahlt jedes Mal für Rechenleistung, wenn ein Kunde es um etwas bittet, daher wächst die Rechnung mit der Nutzung, und die Nutzung wächst tendenziell schneller als der Umsatz, wenn Kunden das Produkt lieben. Das ist die Situation, die Gründer und COOs steuern: kein einmaliges Optimierungsprojekt, sondern eine Kostenposition, die einen Verantwortlichen, ein Dashboard und eine Reihe von Hebeln braucht.
Dieser Leitfaden behandelt diese Hebel auf Unternehmensebene. Er ist bewusst anbieterneutral. Er nennt keine Modellpreise, weil sie sich zu oft ändern, um in einem Nachschlageartikel nützlich zu sein, und er beschreibt Klassen von Techniken statt Produkten. Wenn Sie die Engineering-Sicht pro Agent auf Caching, Routing und Aufrufbudgets suchen, lesen Sie Kostenoptimierung für KI-Agents. Wenn Sie die buchhalterische Seite suchen, also wie diese Kosten eingeordnet werden und wie sie in die Marge einfließen, lesen Sie Was bei einem KI-Unternehmen als COGS zählt und Inferenzkosten und Bruttomarge in KI-Unternehmen. Hier bleiben wir bei der Frage, vor der ein Führungsteam in der Wachstumsphase tatsächlich steht: Was können wir dagegen tun, in welcher Reihenfolge, und wer ist dafür verantwortlich?
Mit Transparenz beginnen, nicht mit Optimierung
Fast jede Kostensenkungsinitiative, die scheitert, beginnt an der falschen Stelle. Teams wählen eine raffinierte Technik, bevor sie wissen, wohin das Geld fließt. Der erste Hebel ist überhaupt keine Technik. Er ist Messung.
Die Rechnung eines Modellanbieters ist eine einzige Zahl für das ganze Unternehmen. Diese Zahl kann Ihnen nicht sagen, ob ein bestimmter Kunde profitabel ist, ob eine neue Funktion die Marge auszehrt oder ob ein Anstieg von echtem Wachstum oder von einem einzigen außer Kontrolle geratenen Job stammt. Um Antworten zu bekommen, müssen die Kosten der Einheit zugeordnet werden, die Ihr Unternehmen verkauft.
Wählen Sie die Einheit, die dazu passt, wie Sie abrechnen und wie Kunden denken:
- Kosten pro Aufgabe oder Ergebnis: ein verarbeitetes Dokument, ein gelöstes Ticket, ein erstellter Bericht.
- Kosten pro Kunde und Monat: die gesamten Modellausgaben, einem Account zugeordnet.
- Kosten pro Funktion: welche Teile des Produkts die meiste Rechenleistung verbrauchen.
- Kosten pro aktivem Nutzer: nützlich als Plausibilitätsprüfung, verbirgt aber die Aufteilung zwischen intensiven und geringen Nutzern.
Praktisch bedeutet das, jeden Modellaufruf zum Zeitpunkt des Aufrufs mit einer Kunden-ID, einem Funktionsnamen und einem Aufgabentyp zu kennzeichnen und diese Tags zusammen mit Token-Zahlen und Latenz zu speichern. Das ist unspektakuläre Infrastruktur, und sie ist das Fundament für alles Folgende. Sobald sie steht, stellen Sie die Verteilung dar, nicht nur den Durchschnitt. Bei vielen Produkten verursacht ein kleiner Teil der Kunden einen großen Teil der Kosten, und der Durchschnitt verdeckt das. Dieselbe Disziplin gilt in jedem Geschäft, in dem die Kosten je nach Kunde schwanken, und unser Erklärartikel zu Unit Economics behandelt den allgemeinen Rahmen.
Zwei Ansichten lohnen sich früh. Die erste stellt die Kosten pro Einheit dem Preis pro Einheit gegenüber, nach Kundensegment, damit Sie sehen, welche Segmente unter Wasser sind. Die zweite zeigt die Kosten pro Einheit im Zeitverlauf, damit Sie erkennen, ob Produkt- oder Modelländerungen helfen oder schaden.
Die Hebeltabelle
Sobald Sie die Kosten auf Einheitsebene sehen können, werden die Hebel zu Entscheidungen statt zu Vermutungen. Die Tabelle fasst jeden zusammen: was er ist, der übliche Zielkonflikt und wann er typischerweise passt. Die Abschnitte danach liefern die Details.
| Hebel | Was er ist | Typischer Zielkonflikt | Wann er passt |
|---|---|---|---|
| Kostentransparenz pro Einheit | Jeden Aufruf nach Kunde, Funktion und Aufgabe kennzeichnen | Engineering-Zeit im Voraus | Immer, vor allem anderen |
| Routing und Kaskaden | Zuerst ein günstigeres Modell versuchen, bei Bedarf eskalieren | Qualitätsrisiko bei falsch gerouteten Anfragen, zusätzliche Latenz | Anfragen gemischter Schwierigkeit in nennenswertem Volumen |
| Kürzen von Prompt und Kontext | Weniger Tokens pro Aufruf senden | Möglicher Verlust nützlichen Kontexts | Lange Prompts, ausufernder Abruf, gesprächige Agents |
| Caching | Frühere Berechnungen für wiederholte Eingaben wiederverwenden | Veraltete Ergebnisse, Aufwand für Cache-Verwaltung | Stabile Präfixe, wiederholte oder nahezu identische Anfragen |
| Batching | Nicht dringende Arbeit asynchron im Paket ausführen | Verzögerte Ergebnisse | Berichte, Anreicherung, Backoffice-Jobs |
| Distillation und Fine-tuning | Ein kleineres Modell mit den Ausgaben eines größeren trainieren | Aufwand im Voraus, engere Fähigkeiten, Wartung | Eine stabile, volumenstarke, klar definierte Aufgabe |
| Open-Weight-Modelle oder Self-Hosting | Modelle auf eigener Infrastruktur betreiben | Betrieblicher Aufwand, Kapazitätsrisiko | Planbar hohe Last, Bedarf an Datenkontrolle |
| Rate Limits und Nutzungsobergrenzen | Verbrauch pro Nutzer oder Account begrenzen | Reibung für legitime intensive Nutzer | Missbrauchsrisiko, Free Tiers, ungleichmäßige Nachfrage |
| Preisleitplanken | Fair-Use-Bedingungen, Credits, Mehrverbrauch | Reibung im Vertrieb, Komplexität | Kosten, die je nach Kunde stark schwanken |
| Governance | Budgets, Alerts, ein benannter Verantwortlicher | Prozessaufwand | Sobald die Ausgaben wesentlich werden |
Routing und Kaskaden: zuerst das kleine Modell
Die Idee hinter einer Kaskade ist einfach. Die meisten Anfragen sind leicht, und ein günstiges Modell bewältigt sie gut. Eine Minderheit ist schwierig und braucht ein leistungsfähigeres, teureres Modell. Wenn Sie erkennen können, welche welche ist, oder es günstig herausfinden, zahlen Sie den hohen Preis nur dann, wenn er sich lohnt.
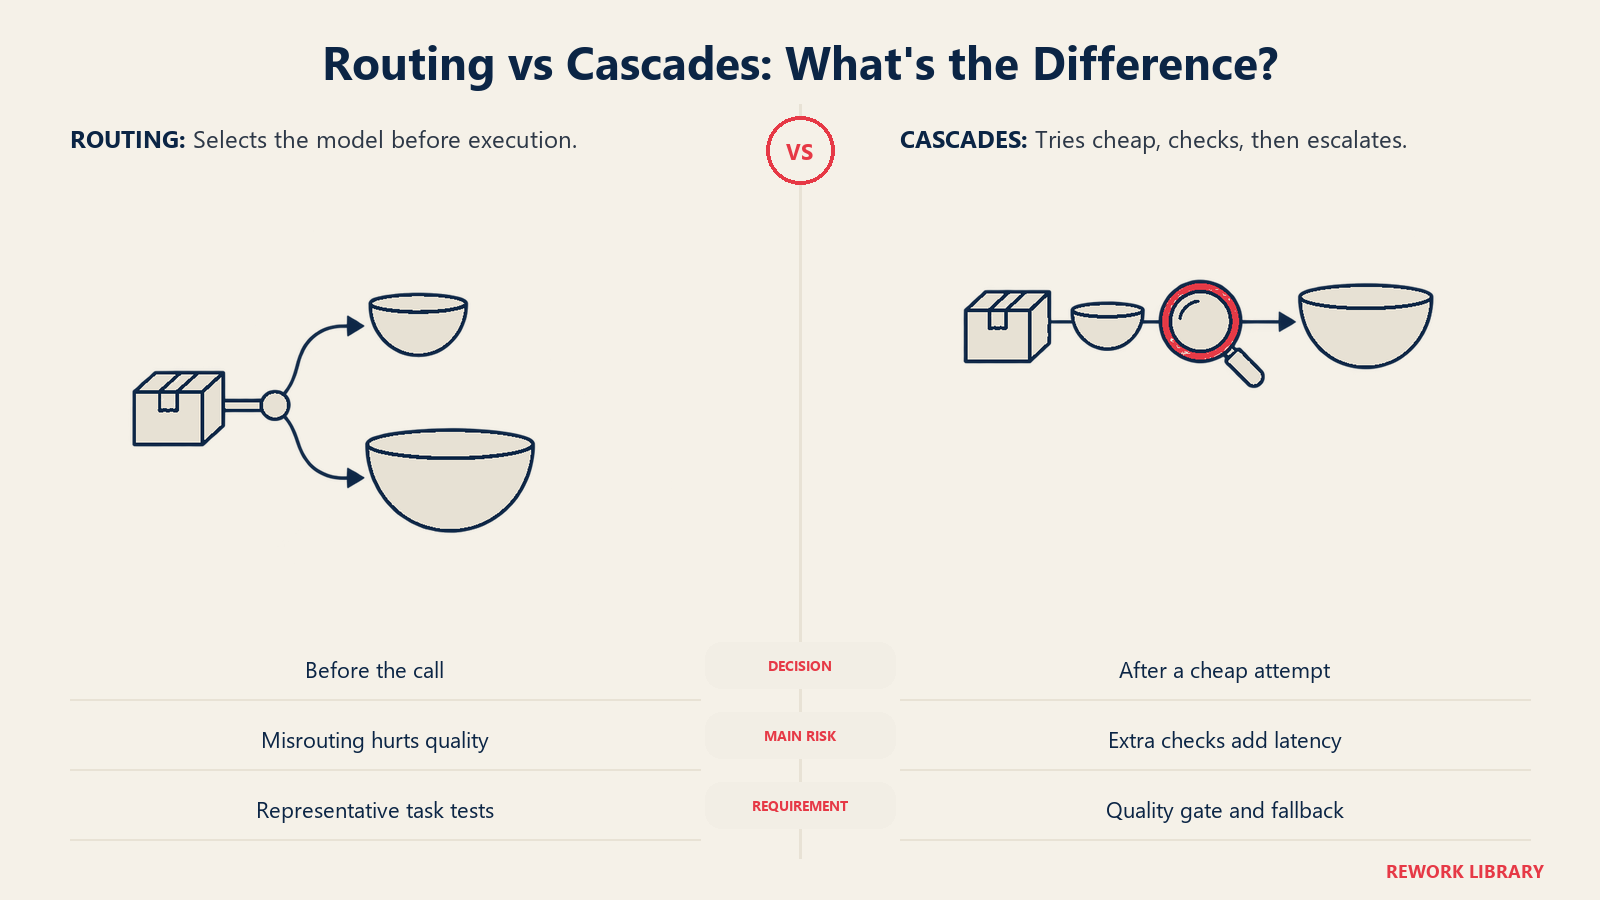
Es gibt zwei gängige Formen. Bei einer Kaskade senden Sie die Anfrage zuerst an das günstigere Modell, prüfen, ob die Antwort gut genug ist, und eskalieren nur dann an ein stärkeres Modell, wenn sie es nicht ist. Beim Routing entscheidet ein Klassifikator vorab, welches Modell die Anfrage bearbeiten soll, ohne zuerst das günstige zu versuchen.
Die Forschung dazu ist wissenswert, und es lohnt sich, die Zahlen genau zu lesen. Das FrugalGPT-Paper schlägt Kaskaden über mehrere Modelle vor und berichtet, dass der Ansatz die Leistung des besten Einzelmodells bei bis zu 98 Prozent Kostensenkung erreichen oder die Genauigkeit gegenüber diesem Modell bei gleichen Kosten um 4 Prozent verbessern kann. Das sind die Ergebnisse der Autoren auf ihren Benchmarks, und das „bis zu“ trägt in der ersten Aussage viel Gewicht. Ihre Arbeitslast wird sich unterscheiden. Das RouteLLM-Paper trainiert Router auf Daten menschlicher Präferenzen und berichtet, dass sein Ansatz die Kosten in bestimmten Fällen um mehr als das 2-Fache senkt, ohne die Antwortqualität zu beeinträchtigen, und dass die Router weiter funktionierten, als die zugrunde liegenden Modelle zur Testzeit gewechselt wurden.
Behandeln Sie beides als Beleg dafür, dass der Hebel real ist, nicht als Einsparprognose. Die ehrlichen Zielkonflikte sind diese:
- Falsches Routing kostet Qualität. Wenn der Router eine schwierige Anfrage an das schwache Modell schickt und nichts das abfängt, bekommt ein Kunde eine schlechte Antwort. Sie brauchen eine Möglichkeit, die Antwortqualität bei Ihren eigenen Aufgaben zu messen, bevor Sie einem Router vertrauen.
- Kaskaden erhöhen die Latenz. Eine Anfrage, die beim günstigen Versuch scheitert, bezahlt den günstigen Aufruf, die Prüfung und dann den teuren Aufruf. Bei interaktiven Produkten kann diese Verzögerung ins Gewicht fallen.
- Auch die Prüfung kostet etwas. Zu entscheiden, ob eine Antwort gut genug ist, ist nicht kostenlos. Manche Teams nutzen einfache Regeln, manche ein kleines Modell, manche Konfidenzsignale. Jede Variante hat ihre Fehlerquellen.
- Es braucht ein Evaluationsset. Ohne einen Satz repräsentativer Aufgaben mit bekannten guten Antworten können Sie nicht erkennen, ob eine Routing-Änderung geholfen oder unbemerkt geschadet hat.
Auf Unternehmensebene ist der praktische Schritt, dort anzufangen, wo sich die Kosten konzentrieren. Nutzen Sie Ihre Daten auf Einheitsebene, um die ein oder zwei Aufgabentypen zu finden, die den Großteil der Ausgaben verursachen, und testen Sie das Routing zuerst dort.
Kürzen von Prompt und Kontext
Die Kosten skalieren mit der Textmenge, die hinein- und herausgeht, daher sind die günstigsten Tokens die, die Sie nie senden. Dieser Hebel wird oft unterschätzt, weil er banal wirkt, und er zahlt sich häufig schnell aus.
Typische Stellen, an denen Sie suchen sollten:
- Aufgeblähte Anweisungen. System-Prompts sammeln über Monate Regeln an. Viele lassen sich kürzen oder entfernen, ohne das Verhalten zu verändern.
- Übermäßiger Abruf. Zehn Dokumentabschnitte in den Kontext zu laden, wenn drei genügen würden, erhöht die Kosten bei jedem Aufruf.
- Gesprächsverlauf. Einen langen Verlauf bei jeder Runde erneut zu senden, kann die Kosten dominieren. Ältere Runden zusammenzufassen tauscht ein wenig Genauigkeit gegen erhebliche Einsparungen.
- Ausschweifende Ausgaben. Strukturierte, knappe Antworten anzufordern, wo das Produkt es zulässt, senkt die Ausgaben für die Ausgabe.
Der Zielkonflikt besteht darin, dass gekürzter Kontext die Qualität auf schwer erkennbare Weise mindern kann. Behandeln Sie jede Kürzung als Experiment gegen Ihr Evaluationsset, nicht als Aufräumarbeit. Ein Prompt, der 30 Prozent kürzer und 5 Prozent schlechter ist, ist nur dann ein Gewinn, wenn Ihre Kunden es nicht merken und Ihre Marge die Hilfe brauchte.
Caching: nicht zweimal für dieselbe Arbeit bezahlen
Caching gibt es in zwei grundlegenden Formen.
Prompt-Caching (Präfix-Caching) ermöglicht es einem Anbieter oder einer Serving-Schicht, die Berechnung für einen langen, stabilen Anfang eines Prompts wiederzuverwenden, etwa Anweisungen und Referenzdokumente, sodass wiederholte Aufrufe mit demselben Präfix weniger kosten. Es belohnt Prompts, die mit dem stabilen Teil zuerst und dem wechselnden Teil zuletzt aufgebaut sind. Bedingungen und Rabatte unterscheiden sich je nach Anbieter und ändern sich im Lauf der Zeit, prüfen Sie daher die aktuelle Dokumentation, statt einer Zahl in einem Artikel zu vertrauen.
Antwort-Caching (semantisches Caching) speichert Antworten und liefert sie erneut aus, wenn eine neue Anfrage identisch oder ähnlich genug ist. Es kann den Modellaufruf vollständig überflüssig machen. Das Risiko besteht darin, auf eine Frage, die nur ähnlich aussah, eine veraltete oder subtil falsche Antwort auszuliefern, und das ist ein echtes Problem für alles Personalisierte, Zeitkritische oder Folgenreiche. Es eignet sich für enge, sich wiederholende Fragen wie häufige Supportanfragen oder Standardklassifizierungen und schlecht für offene Generierung.
Caching passt am besten dort, wo Ihre Nutzungsdaten starke Wiederholung zeigen. Wenn Ihre gekennzeichneten Logs zeigen, dass dasselbe große Präfix tausendmal am Tag hinausgeht, verdient Caching Aufmerksamkeit, bevor es etwas Ausgefeilteres tut.
Batching: Geschwindigkeit gegen Preis tauschen
Nicht jede Anfrage braucht eine sofortige Antwort. Nächtliche Anreicherung, Berichtserstellung, Massenklassifizierung und Backoffice-Bereinigung können asynchron in Paketen laufen. Viele Anbieter bepreisen zeitversetzte Verarbeitung im Batch-Stil günstiger als Echtzeitverarbeitung, und Batching glättet auch die Last auf Ihrer eigenen Infrastruktur. Der Zielkonflikt ist, dass die Ergebnisse später ankommen. Die Entscheidung ist eine Produktentscheidung: Bei welchen Jobs würden Kunden wirklich nicht bemerken, dass sie über Nacht laufen? Listen Sie sie auf und verlagern Sie, was Sie können.
Distillation und Fine-tuning: ein kleineres Modell für eine enge Aufgabe
Distillation trainiert ein kleineres Modell darauf, ein größeres bei einer bestimmten Aufgabe nachzuahmen. Fine-tuning passt ein bestehendes Modell an Ihre Daten an. Beide zielen auf dasselbe Ergebnis: ein günstigeres Modell, das bei der einen Sache, die Sie brauchen, gut genug ist.
Die Forschung stützt die Idee in Grenzen. Das Paper „Distilling Step-by-Step“ berichtet, dass ein T5-Modell mit 770 Mio. Parametern ein per Few-Shot-Prompting angesteuertes PaLM-Modell mit 540 Mrd. Parametern auf einem Benchmark übertraf und dabei nur 80 Prozent der verfügbaren Trainingsdaten nutzte, indem es die Begründungen des größeren Modells als zusätzliches Trainingssignal verwendete. Das ist ein Ergebnis auf einem Benchmark, veranschaulicht aber das Prinzip: Für eine definierte Aufgabe kann ein kleines, spezialisiertes Modell mit einem allgemeinen Giganten mithalten.
Die Zielkonflikte für ein Unternehmen:
- Aufwand im Voraus und laufend. Sie brauchen Trainingsdaten, ein Evaluationsset, Engineering-Zeit und einen Plan für das erneute Training, wenn sich die Aufgabe oder die Daten verschieben.
- Engere Fähigkeiten. Das kleine Modell erledigt eine Aufgabe gut und kann bei Eingaben außerhalb davon scheitern. Sie brauchen einen Ausweichpfad.
- Ein bewegliches Ziel. Allgemeine Modelle werden laufend besser und günstiger, daher kann der Vorteil eines destillierten Modells schrumpfen. Prüfen Sie den Vergleich regelmäßig neu.
- Nutzungsbedingungen. Manche Anbieter schränken ein, die Ausgaben ihres Modells zum Training anderer Modelle zu verwenden. Prüfen Sie die Bedingungen, bevor Sie eine Pipeline auf dieser Annahme aufbauen.
Es passt am besten, wenn eine Aufgabe stabil, volumenstark, klar definiert und leicht zu evaluieren ist. Es passt schlecht bei Aufgaben, die sich wöchentlich ändern oder breites logisches Denken erfordern.
Eine verwandte Technik, die man kennen sollte, ist Speculative Decoding, bei dem ein kleines Modell Tokens entwirft, die ein großes Modell überprüft. Das ursprüngliche Paper berichtet von einer Beschleunigung um das 2- bis 3-Fache gegenüber der Standardimplementierung bei identischen Ausgaben. Das setzt meist Ihr Serving-Anbieter oder Ihr Infrastrukturteam um und ist weniger eine Produktentscheidung, erklärt aber, warum die Kosten für selbst gehostetes Serving weiter sinken.
Open-Weight-Modelle und Self-Hosting im Vergleich zur API
Ab einem gewissen Volumen fragen sich Gründer, ob sie aufhören sollen, Modelle über eine API zu mieten, und stattdessen Open-Weight-Modelle auf eigener Infrastruktur betreiben. Das ist eine berechtigte Frage, und die Antwort ist selten ein klares Ja oder Nein.
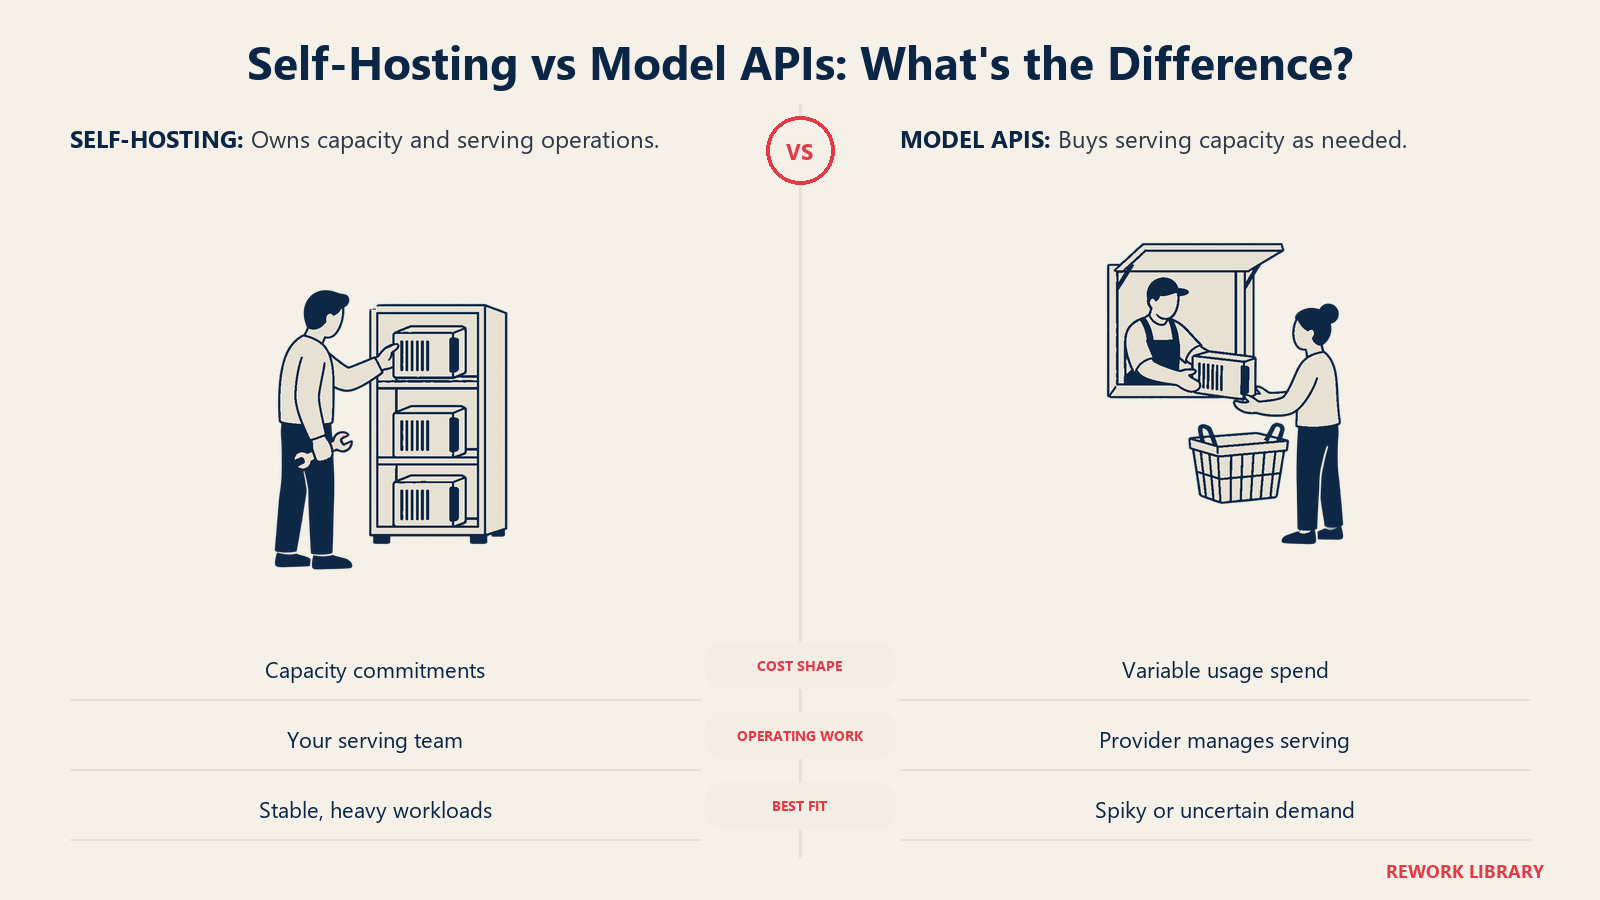
Was Self-Hosting bieten kann: planbarere Kosten bei hohem, gleichmäßigem Volumen, Kontrolle über Speicherort und Verarbeitung der Daten, Freiheit zur Anpassung und Schutz vor Preis- oder Richtlinienänderungen eines Anbieters.
Was es kostet: Sie übernehmen Kapazitätsplanung, GPU-Beschaffung oder Mietverpflichtungen, Serving-Engineering, Monitoring, Sicherheit und Upgrades. Ungenutzte Kapazität ist reine Verschwendung, und Nachfragespitzen können feste Kapazität überfordern. Außerdem tragen Sie eine etwaige Qualitätslücke zwischen dem offenen Modell und dem Spitzenmodell selbst.
Eine nützliche Sichtweise: Eine API verwandelt ein Problem fester Kapazität in variable Kosten, und Self-Hosting verwandelt es zurück. Wenn Ihre Nachfrage sprunghaft oder noch unbekannt ist, sind die variablen Kosten ein Vorteil. Wenn Ihre Nachfrage gleichmäßig und groß ist und die Aufgabe zu einem offenen Modell passt, können die Fixkosten günstiger ausfallen, aber erst, nachdem Sie die Ingenieure mitgerechnet haben. Viele Unternehmen landen bei einer hybriden Lösung: Sie hosten die volumenstarken, gut verstandenen Arbeitslasten selbst und nutzen APIs für den Long Tail und die schwierigsten Anfragen. Wie viel des Stacks Sie besitzen, ist außerdem eine strategische Entscheidung, nicht nur eine Kostenfrage, und Anwendungsschicht vs. Modellschicht behandelt diese Seite.
Rate Limits und Nutzungsobergrenzen
Technische Grenzen schützen Sie vor den beiden schlimmsten Kostenüberraschungen: Missbrauch und Versehen. Free Tiers ziehen Menschen an, die das Produkt so stark ausreizen, wie es zulässt. Ein Fehler in der Integration eines Kunden kann in eine Schleife geraten und in einer Stunde Tausende von Aufrufen verbrennen.
Sinnvolle Kontrollen umfassen Rate Limits pro Nutzer und pro Account, tägliche oder monatliche Ausgabenobergrenzen, die eine Prüfung auslösen, bevor sie weitere Ausgaben auslösen, und harte Obergrenzen für kostenlose und Testaccounts. Gestalten Sie sie mit Blick auf den Kunden. Eine Grenze, die einen zahlenden Kunden überrascht, ist ein Supportticket und ein Abwanderungsrisiko. Warnen Sie bei 70 oder 80 Prozent, erklären Sie, was beim Erreichen der Grenze passiert, und geben Sie Admins eine Möglichkeit, sie anzuheben.
Preisleitplanken: den Preis einen Teil der Kosten tragen lassen
Engineering-Hebel senken Ihre Kosten. Preishebel verändern, wer sie trägt. Beide gehören in dasselbe Gespräch, denn ein Margenproblem lässt sich oft auf der Umsatzseite schneller beheben als auf der Kostenseite.
Die üblichen Leitplanken sind:
- Fair-Use-Richtlinien für Tarife, die „unbegrenzt“ versprechen, die festlegen, was unbegrenzt in der Praxis bedeutet.
- Enthaltene Kontingente mit Mehrverbrauch, sodass intensive Nutzung Umsatz erzeugt statt nur Kosten. Unser Leitfaden zu hybrider Preisgestaltung für KI-Produkte erläutert, wie Sie das Kontingent und den Tarif für Mehrverbrauch bemessen.
- Credits, die unübersichtliche variable Kosten in eine einzige Währung verwandeln, mit der Kunden budgetieren können. Siehe creditbasierte Preisgestaltung.
- An den Wert gekoppelte Messgrößen, sodass sich der Umsatz mit dem bewegt, was Kunden tatsächlich vom Produkt haben, statt mit reiner Aktivität.
Der Zielkonflikt sind Reibung im Vertrieb und komplexere Abrechnung. Kunden mögen planbare Rechnungen, und jede zusätzliche Regel muss erklärt werden. Ein guter Test ist, ob Ihr teuerster Kunde zu den aktuellen Preisen auch ein profitabler ist. Wenn die Daten auf Einheitsebene Nein sagen, ist das ein Preisproblem, bevor es ein Engineering-Problem ist.
Governance: wer für die Zahl verantwortlich ist
Hebel ziehen sich nicht von selbst. Unternehmen, die ihre Modellausgaben im Griff haben, haben meist dieselben wenigen Dinge etabliert.
Ein benannter Verantwortlicher. Modellkosten liegen quer über Engineering, Produkt, Finanzen und manchmal Customer Success. Wenn sie allen gehören, gehören sie niemandem. Bestimmen Sie eine verantwortliche Person, oft jemanden aus der Engineering-Leitung mit einem Partner aus den Finanzen, und geben Sie ihr das Dashboard.
Budgets nach Produktbereich. Weisen Sie jeder Funktion oder jedem Team ein Budget für Modellausgaben zu, ausgedrückt in einer sinnvollen Einheit wie Kosten pro Aufgabe oder Anteil am Umsatz. Budgets verändern Verhalten, weil Menschen die Folgen ihrer Designentscheidungen sehen.
Alerts, nicht nur Berichte. Eine monatliche Prüfung entdeckt ausufernde Kosten dreißig Tage zu spät. Richten Sie Alerts für tägliche Ausgaben, für Kosten pro Aufgabe und für ungewöhnlichen Verbrauch auf Kundenebene ein.
Eine Prüfung vor dem Launch. Jede neue KI-Funktion bekommt vor der Veröffentlichung eine Kostenschätzung: erwartete Aufrufe pro Aufgabe, erwartete Tokens, erwartete Kosten pro Einheit und erwarteter Preis. Das ist eine kurze Checkliste, und sie verhindert die Geschichte „Wir haben es ausgeliefert, und die Marge ist verschwunden“.
Ein regelmäßiger Rhythmus. Überprüfen Sie Routing-Regeln, Caching und Modellauswahl vierteljährlich. Die Optionen ändern sich laufend, und die beste Konfiguration des letzten Jahres ist selten die beste dieses Jahres.
Eine sinnvolle Reihenfolge
Wenn Sie bei null anfangen, hält eine grobe Abfolge den Aufwand im Verhältnis zum Ertrag:
- Kosten pro Aufgabe, Kunde und Funktion messbar machen.
- Herausfinden, wo sich die Ausgaben konzentrieren und welche Kunden unter Wasser sind.
- Prompts und Kontext kürzen und Caching ergänzen, wo Wiederholung offensichtlich ist.
- Nicht dringende Arbeit in die Batch-Verarbeitung verlagern.
- Routing oder Kaskaden für die ausgabenstärksten Aufgabentypen einführen, abgesichert durch ein Evaluationsset.
- Obergrenzen, Alerts und Fair-Use-Bedingungen festlegen und die Preisgestaltung dort korrigieren, wo die Daten eine Lücke zeigen.
- Distillation oder Self-Hosting nur für stabile, volumenstarke Arbeitslasten erwägen, und erst, nachdem die günstigeren Hebel ausgeschöpft sind.
Diese Reihenfolge stellt die günstigen, umkehrbaren Schritte an den Anfang und die schweren, schwer umkehrbaren ans Ende.
Wichtige Fakten
- Messen Sie die Kosten in der Einheit, die Sie verkaufen (Aufgabe, Kunde, Funktion), bevor Sie optimieren. Eine einzelne Anbieterrechnung kann Ihnen nicht sagen, wer unprofitabel ist.
- Kaskaden versuchen zuerst ein günstigeres Modell und eskalieren dann. Die Autoren von FrugalGPT berichten, dass sie das beste Einzelmodell bei bis zu 98 Prozent Kostensenkung erreichen oder die Genauigkeit bei gleichen Kosten um 4 Prozent verbessern.
- Gelernte Router können ebenfalls Kosten senken. Die Autoren von RouteLLM berichten von Kostensenkungen um mehr als das 2-Fache in bestimmten Fällen, ohne die Antwortqualität zu beeinträchtigen.
- Distillation kann kleine, aufgabenspezifische Modelle hervorbringen. Eine Studie berichtet, dass ein Modell mit 770 Mio. Parametern ein per Few-Shot-Prompting angesteuertes Modell mit 540 Mrd. Parametern auf einem Benchmark übertraf, mit 80 Prozent der verfügbaren Trainingsdaten.
- Speculative Decoding beschleunigt das Serving großer Modelle. Seine Autoren berichten von einer Beschleunigung um das 2- bis 3-Fache bei identischen Ausgaben.
- Forschungsergebnisse stammen von bestimmten Benchmarks. Validieren Sie jeden Hebel an Ihrem eigenen Evaluationsset, bevor Sie mit Einsparungen rechnen.
- Preishebel (Kontingente, Mehrverbrauch, Credits, Fair Use) verlagern Kosten auf die Partei, die sie verursacht, und lassen sich oft schneller umsetzen als Engineering-Änderungen.
- Jede Kostenposition braucht einen benannten Verantwortlichen, ein Budget und Alerts.
Häufig gestellte Fragen zur Steuerung von KI-Modellkosten
Was ist der erste Schritt, wenn die Modellkosten zu steigen beginnen?
Messen Sie die Kosten pro Aufgabe, pro Kunde und pro Funktion, indem Sie jeden Modellaufruf kennzeichnen. Eine einzelne Rechnung kann nicht zeigen, welche Kunden oder Funktionen die Ausgaben treiben. Sobald Sie sehen, wohin das Geld fließt, können Sie den passenden Hebel wählen, statt zu raten.
Was ist eine Modellkaskade, und wie viel kann sie einsparen?
Eine Kaskade sendet eine Anfrage zuerst an ein günstigeres Modell und eskaliert nur dann an ein stärkeres, wenn die erste Antwort nicht gut genug ist. Das FrugalGPT-Paper berichtet, dass auf seinen Benchmarks das beste Einzelmodell bei bis zu 98 Prozent Kostensenkung erreicht wurde. Die tatsächlichen Einsparungen hängen von Ihrer Mischung aus leichten und schwierigen Anfragen ab, testen Sie es also an Ihren eigenen Aufgaben.
Ist Caching für KI-Produkte sicher?
Prompt-Caching, das den stabilen Anfang eines Prompts wiederverwendet, verändert die Antworten nicht. Antwort-Caching, das gespeicherte Antworten auf ähnliche Fragen ausliefert, kann veraltete oder unpassende Ergebnisse liefern. Nutzen Sie es daher für enge, sich wiederholende Anfragen und meiden Sie es bei personalisierten oder zeitkritischen.
Wann ist es sinnvoll, Open-Weight-Modelle selbst zu hosten, statt eine API zu nutzen?
In der Regel, wenn das Volumen hoch und gleichmäßig ist, die Aufgabe zu einem offenen Modell passt und Sie die Engineering-Kapazität für den Betrieb haben. Eine API macht aus Kapazität variable Kosten, was zu unsicherer oder sprunghafter Nachfrage passt. Viele Unternehmen landen bei einer hybriden Lösung, hosten die planbaren intensiven Arbeitslasten selbst und nutzen APIs für den Rest.
Kann die Preisgestaltung ein Problem mit Modellkosten lösen?
Oft ja. Enthaltene Kontingente mit Mehrverbrauch, Credits und Fair-Use-Bedingungen verlagern die Kosten intensiver Nutzung auf die Kunden, die sie verursachen. Wenn Ihre teuersten Kunden zu den aktuellen Preisen unprofitabel sind, ist das eine Preislücke, die Sie vor der Engineering-Arbeit oder parallel dazu schließen sollten.
Wer sollte im Unternehmen für die Modellkosten verantwortlich sein?
Eine benannte Person, meist aus der Engineering-Leitung mit einem Partner aus den Finanzen. Geben Sie ihr ein Dashboard mit Kosten pro Einheit, Budgets nach Produktbereich und Alerts bei ungewöhnlichen Ausgaben. Geteilte Verantwortung ohne eine einzelne verantwortliche Person führt meist dazu, dass niemand handelt.
Weiterführende Lektüre

Co-Founder & COO
On this page
- Mit Transparenz beginnen, nicht mit Optimierung
- Die Hebeltabelle
- Routing und Kaskaden: zuerst das kleine Modell
- Kürzen von Prompt und Kontext
- Caching: nicht zweimal für dieselbe Arbeit bezahlen
- Batching: Geschwindigkeit gegen Preis tauschen
- Distillation und Fine-tuning: ein kleineres Modell für eine enge Aufgabe
- Open-Weight-Modelle und Self-Hosting im Vergleich zur API
- Rate Limits und Nutzungsobergrenzen
- Preisleitplanken: den Preis einen Teil der Kosten tragen lassen
- Governance: wer für die Zahl verantwortlich ist
- Eine sinnvolle Reihenfolge
- Wichtige Fakten
- Weiterführende Lektüre