データフライホイールとは何か
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
データフライホイールとは、製品の利用がデータを生み、そのデータが製品を改善し、改善された製品がさらに利用を呼び込み、それがまたデータを生むというループのことです。AIスタートアップでは、「大企業に真似されないのはなぜか」という問いに対する最も人気のある答えです。同時に、最も誇張されやすい答えの1つでもあります。本当にフライホイールを持つ製品もあります。しかし多くは、データの流れに図を描き添えただけのものです。
このページでは、この考え方の由来、ループが実際にどう機能するか、どこで壊れるか、そしてある製品がフライホイールを持っているかを判断するためのテストを説明します。より広い参入障壁の論点はAIスタートアップの防御力マップで扱っており、本ページはあえて範囲を絞っています。優位性の源泉としてのデータに焦点を当て、ワークフロー、流通、ブランドは扱いません。
この考え方の由来
「フライホイール」という言葉は、データの比喩である前にビジネスの比喩です。Jim Collinsが『ビジョナリー・カンパニー2 飛躍の法則』(Good to Great)で広め、彼自身のフライホイールの概念の説明では、非常に重い車輪を押すイメージが使われています。初期の進歩はほとんど目に見えず、一押しごとに前の勢いが積み重なり、ある時点から勢いが味方してくれるようになります。Collinsは、一発逆転の決定打という考えを否定しています。成果は一貫した方向に積み重ねた押しから生まれるというのです。ビジネス戦略としてのフライホイールについては、フライホイール効果の解説ページをご覧ください。
データ版のフライホイールには、特有の仕組みが加わります。Collinsの描く車輪は、持続的な努力によって回ります。データの車輪は、ある程度は自ら回るはずだとされます。顧客とのやり取りのたびに情報が生まれ、それが次の顧客のために製品を改善するからです。この主張こそが投資家にとっての魅力です。競合がお金で追い越せない複利的なリターンを約束するからです。
そして、最も厳しく検証すべき主張でもあります。実際には2つの主張が1つにまとめられているからです。1つ目は、データが増えれば製品が良くなるという主張です。2つ目は、その改善が十分に大きく、速く、独占的で、競合を締め出せるという主張です。1つ目はしばしば正しいものです。多くのフライホイールが崩れるのは2つ目です。
ループが実際に機能する仕組み
機能するデータフライホイールには4つのつながりがあり、どれもが弱点になり得ます。
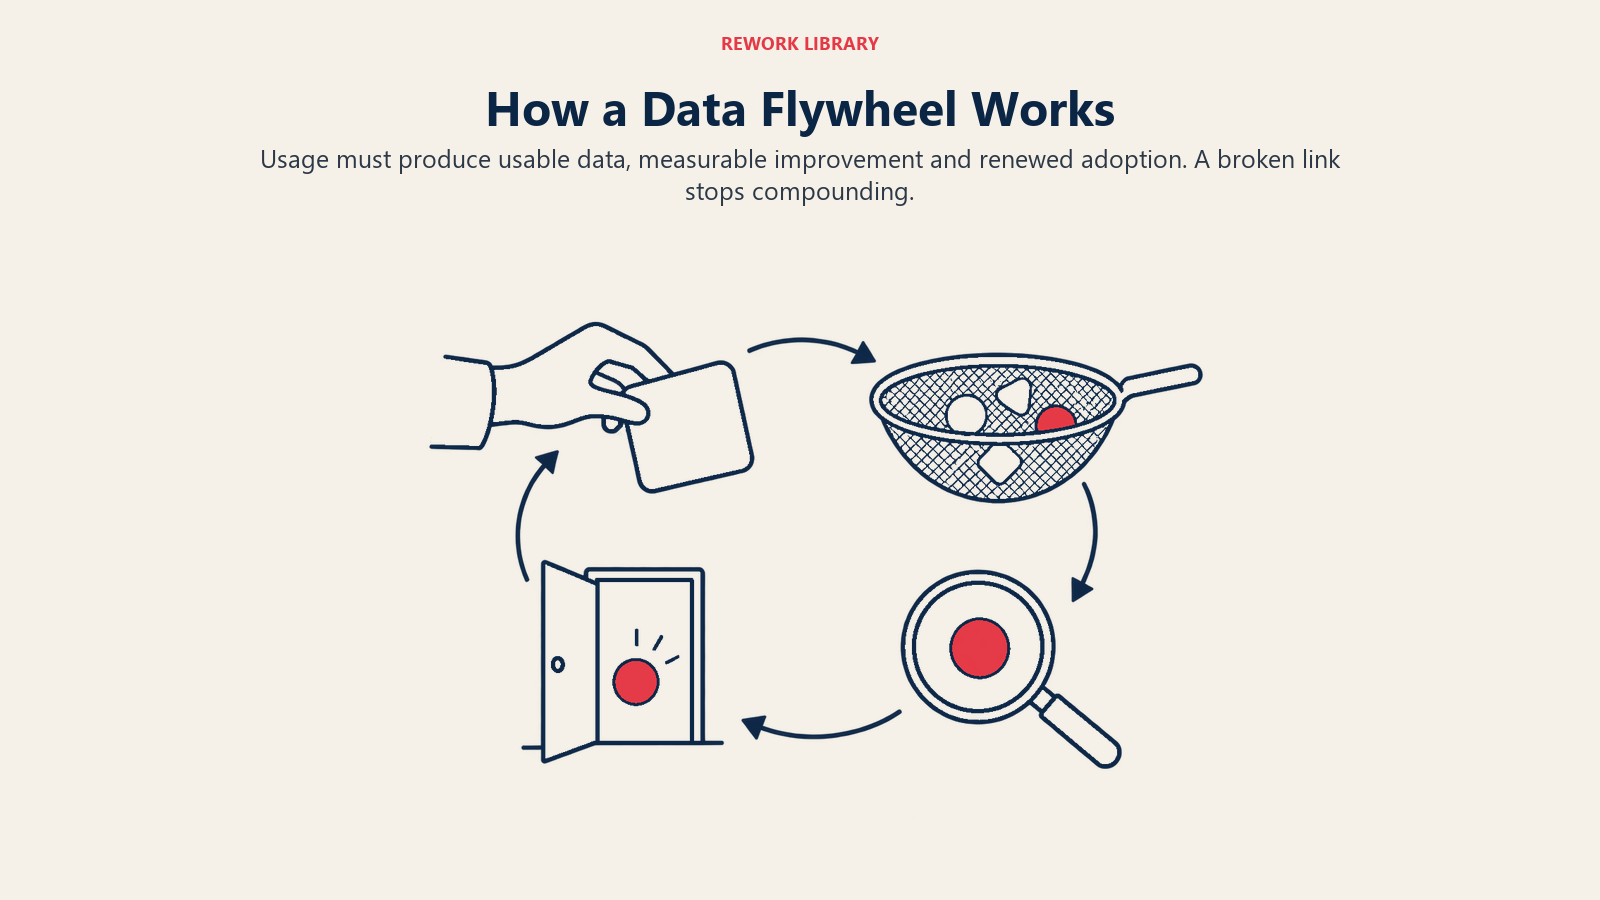
- 利用がデータを生む。 顧客が製品内で、修正、承認、却下された提案、完了したタスクなど、役に立つ痕跡を残す行動をします。
- データが収集され、整理される。 企業がそのデータを使う許可を得ており、使える形で保存し、シグナルとノイズを区別できます。
- データが製品を改善する。 モデルの学習、fine-tuning、検索、prompt、評価セット、ルールにデータが反映され、改善を測定できます。
- 改善がさらなる利用を生む。 より良い出力が信頼、ワークフロー、顧客、継続率の向上につながり、サイクルが繰り返されます。
ループが複利的に効くのは、4つのつながりがすべて成り立つ場合だけです。1つ目のつながり(あらゆる操作はログを残します)だけがあって、ほかは何もない製品はたくさんあります。データを集めることはフライホイールではありません。フライホイールとは、実際に使われ、製品を変え、顧客の行動を変えるデータのことです。
どのようなデータが意味を持つか
データの価値はすべて同じではなく、その種類によってループの防御力が決まります。
| データの種類 | シグナルの例 | 参入障壁としての一般的な強さ |
|---|---|---|
| 公開データまたは購入可能なデータ | Webテキスト、ライセンス取得したデータセット | 弱い: 競合も同じ入力を入手できる |
| 生の利用ログ | クリック、クエリ、セッションの長さ | 弱いから中程度: 収集は安価だが、学習に使うにはノイズが多い |
| 明示的なフィードバック | 高評価・低評価、評点、ランキング | 中程度: 有用だが、量が少なく操作されやすい |
| 修正と編集 | ユーザーがAIの下書きを書き直す、エージェントの判断を人が覆す | 強い: 実務を行う専門家がラベルを付けている |
| 成果データ | 商談は成立したか、保険金は支払われたか、患者は回復したか | 最も強い: 出力を実際の結果に結びつけ、再現が難しい |
パターンはシンプルです。実際の専門家が下した実際の判断に近く、競合がスクレイピングや購入で手に入れられるものから遠いデータほど、価値が高くなります。
データがAIの参入障壁の定番になった理由
魅力の一部は研究から来ています。Hestnessらによるディープラーニングにおけるスケーリングの研究では、機械翻訳、言語モデリング、画像処理、音声認識のいずれでも、学習データが増えるにつれて汎化誤差がべき乗則に従うことが分かりました。その後の言語モデルのスケーリング則の研究では、損失がモデルサイズ、データセットサイズ、計算量に対してべき乗則でスケールし、一部の傾向は7桁以上にわたることが報告されています。一般には「データが増えれば、モデルは確実に良くなる」と読まれています。この解釈が、フライホイールの物語の種になりました。
2つ目の理由は、人から学ぶことが効果的だという点です。OpenAIのInstructGPT論文によると、ラベラーによる実演と出力のランク付けで学習した13億パラメータのモデルの出力は、パラメータ数が100分の1であるにもかかわらず、1,750億パラメータのGPT-3の出力よりも好まれました。つまり、製品の振る舞いにとっては、純粋な規模よりもフィードバックデータのほうが重要になり得るのです。
どちらの発見も本物です。しかし、どちらもスタートアップに参入障壁があることを証明するものではありません。べき乗則は収穫逓減の曲線でもありますし、ラベラーにお金を払っている企業は、資金力のある競合なら誰でも真似できるプロセスを説明しているにすぎません。
データフライホイールが本物である場合
次の条件の多くが当てはまるとき、フライホイールは本物である傾向があります。
データが独自のもので、製品自体から生まれている。 最良のデータが自社顧客の業務から生まれるなら、競合はそれをライセンス取得することもクロールすることもできません。まず顧客を獲得しなければならず、そちらのほうがはるかに難しい問題です。
ワークフローなしではデータを得にくい。 いずれにせよ人が行わなければならない作業(書類のレビュー、チケットの解決、請求書の承認)の副産物として生まれるデータは、ユーザーに余計な手間をかけずに蓄積されます。ユーザーが手を止めて評価しなければならないデータは、少しずつしか集まりません。ワークフロー上の位置がそれ自体どう優位性を生むかについては、AIのワークフローのロックインをご覧ください。
改善が顧客の目に見える。 より良いモデルが顧客の目に映るものを何も変えないなら、ループは利用を促しません。顧客が言われなくても製品が良くなったと気づけるかどうかが試金石です。
データでカバーできるロングテールが領域にある。 入力が多様で雑然としている領域では、蓄積されたエッジケースそのものが製品になります。これがバーティカルAIを支持する議論の核心です。狭い領域では、データが集中する場所が生まれます。
ループに活動だけでなく成果が含まれている。 顧客が何をしたかを知ることは有用です。しかし、その後に何が起きたかを知ることで、製品は「良い」とは何かを学べるようになります。
古典的な戦略論でデータループに最も近いのは、ネットワーク効果とスイッチングコストです。データは両方を強化できますが、自動的にどちらかになるわけではありません。ネットワーク効果とは、新しいユーザーが1人増えるたびに、ほかのすべてのユーザーにとって製品の価値が高まることです。データループは通常、新しいユーザーが1人増えるたびに、全員にとって製品が少し良くなることを意味し、これはより弱い効果です。
過大評価されている場合
創業者も投資家も読み飛ばしがちな部分です。2019年に公開されたMartin CasadoとPeter Lautenのエッセイ「データによる参入障壁という空約束」は、懐疑的な立場をはっきりと示しています。中心となる主張は、単にデータが多いだけでは一般に本来のネットワーク効果は生まれず、そう見えるものは多くの場合、規模の効果にすぎないというものです。しかも古典的な規模の経済とは決定的に異なり、コーパスに独自のデータを追加するコストは上がる一方で、追加データの価値は下がる可能性があります。
その論理から、失敗パターンの有用なチェックリストが得られます。
収穫逓減
このエッセイのチャットボットの例が、最も分かりやすい説明です。最初に集めたクエリの一部でよくある質問がカバーされ、大きな改善が得られます。例では、クエリの40%を目にした時点で、それ以上集めても優位性は残っていません。曲線は平坦になり、その平坦な部分に到達した競合は対等な立場に立ちます。研究論文のべき乗則と事業計画の平坦な曲線は、同じ形を異なる距離から見ているにすぎません。
コールドスタートの壁には限りがある
同じエッセイは、最小限の実用的なコーパスを立ち上げることは達成可能であり、それだけでは持続的な参入障壁になり得ないと論じています。新規参入者が購入データ、合成データ、少数のデザインパートナー、あるいは強力なベースモデルで「十分な水準」に到達できるなら、既存企業の先行優位はロングテール部分だけに縮小します。
ロングテールはコストが高い
後の論考「Taming the Tail」で、CasadoとMatt Bornsteinは、ロングテール型の分布は機械学習の問題に付き物であり、それが規模の不経済を意味し得ると論じています。作業のうち、1件あたりの価値が最も低い部分の割合が増えていくからです。また、AIアプリケーションの開発コストは一般的なソフトウェアの3倍から5倍になり得ると報告しています。まれなケースを糧にしなければならないフライホイールは、摩擦が減っていくのではなく増えていくフライホイールです。
公開データが反対側から優位性を侵食する
基盤モデルは主に公開データで学習されており、その蓄積には限りがあります。Epochの人間が生成したデータに基づくLLMのスケーリングの限界に関する研究は、2026年から2032年の間に、モデルが利用可能な公開テキストの総量とほぼ同じ規模のデータセットで学習されるようになると予測しています。スタートアップにとっての教訓は、データが尽きることそのものではありません。汎用モデルが公開データから学べることに長けていくにつれ、公開データに依存する製品の部分は差別化要因でなくなるということです。残るのは、公開されていない領域にあるものだけです。
より優れたベースモデルが優位性を吸収し得る
スタートアップのデータ優位性が「一般的なタスクを改善する事例でfine-tuningした」というものなら、次の四半期にリリースされるより強力な基盤モデルが、新しいデータなしでその差を埋めてしまうかもしれません。これがAI wrapperとAI-nativeの違いという問いの背後にある実際的なリスクです。自社で管理できないモデル層にある優位性は、所有しているのではなく借りているものです。
量ではなくフィードバックの質
量は測りやすく、自慢もしやすいものです。質はそうはいきません。高評価ボタンは急いでいる人に押され、レビュアーの意見が割れればラベルはぶれ、ログはユーザーが何をしたかを記録しても、それが正しかったかどうかは記録しません。ノイズの多いフィードバックで回るフライホイールは、何も改善せずに空回りすることがあります。最もきれいなシグナルは通常、専門家による修正か検証済みの成果であり、それらは多くのチームが後回しにしがちな評価と信頼の取り組みから生まれます。
実践的なテスト: 自社にフライホイールはあるか
機能するフライホイールとスローガンを見分けるための質問です。
| 質問 | 強い答えの例 |
|---|---|
| 競合は同等のデータを購入またはスクレイピングできるか | いいえ。そのデータは自社顧客のワークフローの中にしか存在しない |
| 改善のために顧客データを使う許可はあるか | はい。契約で明確な範囲とともに定めている |
| データのおかげで製品が良くなったことを示せるか | はい。固定の評価セットで導入前後を比較できる |
| その改善は継続率、利用量、受注率に表れているか | はい。想定ではなく測定している |
| 曲線のどこにいるか | 初期、中盤、平坦のどこにいるかを把握している |
| より強力なベースモデルがリリースされたらどうなるか | 優位性はモデルの内部ではなくモデルの上にあるので、生き残る |
| 新規顧客が「良い」水準に達するまでの速さは | ゼロから始める競合よりも速い |
最も重要なのは曲線に関する質問です。独自データの量に対する品質をプロットできるスタートアップは、3つの状況のどれにいるかが分かります。データの追加に大きな価値がある「まだ上昇中」、追加データの価値が小さい「平坦化しつつある」、そして参入障壁をほかから得なければならない「すでに平坦」です。ほとんどの創業者は、このグラフを描いたことがありません。
もう1つの有効な習慣は、学習に一切使わない固定の評価セットを維持することです。それがなければ、どのような改善の主張も逸話にすぎません。関連する測定の考え方はAIプロダクトの導入指標で取り上げており、利用データを収集するインフラ面は製品内AIのテレメトリーループとプロダクトテレメトリーの優位性で扱っています。
フライホイールはより大きな参入障壁にどう組み込まれるか
強力なデータフライホイールであっても、単独で成り立つことはまれです。古典的な戦略論の言葉では、経済的な参入障壁とは持続的な優位性のことであり、持続的であるためには通常、互いに強化し合う複数の源泉が必要です。データと組み合わさりやすいのは次のものです。
- ワークフロー上の位置。 仕事が行われる場所にいることが、そもそもデータを生み出す前提です。
- 流通。 顧客が増えればデータも増えます。最初の顧客をどう獲得するかは別の問題なので、AIの流通による参入障壁をご覧ください。
- スイッチングコスト。 蓄積された顧客固有の設定は乗り換えを困難にし、データが流れ込み続けることにつながります。
フライホイールは、ほかの優位性の代わりではなく、ほかの優位性を増幅するものとして扱ってください。CasadoとLautenの警告は、データを魔法の参入障壁として扱うと、勝つために本当に必要なことから創業者の目をそらしかねないというものです。この考え方の有用な形は、より狭く検証可能なものです。この製品、この領域において、独自の利用データが、競合がすぐには追いつけない形で結果を測定可能なほど改善するのか、という問いです。
よくある間違い
- ログをデータ優位性として数える。 ラベルや成果のない量からは、ほとんど何も学べません。
- 曲線が平坦にならないと思い込む。 収穫逓減は、ほかの誰のデータと同じく自社のデータにも当てはまります。
- データの権利を無視する。 顧客との契約がそのデータからの学習を認めていなければ、ループは法的に止まります。
- 借り物のモデルを中心にループを作る。 ベースモデルのアップグレードで改善を再現できるなら、それは自社のものではありません。
- 顧客から見える品質ではなく学習データの量を測る。 ループが閉じるのは、顧客が気づいたときです。
- 対照群を省く。 学習に使わない評価セットがなければ、改善とドリフトを区別できません。
重要なポイント
- 比喩の由来: Jim Collinsはフライホイールを、一貫した方向への押しの積み重ねであり、単一の決定的なイノベーションは存在しないものとして説明しています。
- スケーリング研究: Hestnessらは4つの機械学習領域で汎化誤差がべき乗則でスケールすることを見いだし、Kaplanらは損失がモデルサイズ、データセットサイズ、計算量に対してべき乗則でスケールすると報告しています。
- フィードバックが規模に勝った例: InstructGPTでは、パラメータ数が100分の1であるにもかかわらず、13億パラメータのモデルの出力が1,750億パラメータのGPT-3の出力よりも好まれました。
- 懐疑的な立場: CasadoとLauten(2019年)は、データが多いこと自体ではネットワーク効果は生まれず、独自データのコストは上がる一方でその追加的な価値は下がり得ると論じています。
- ロングテールの経済性: CasadoとBornstein(2020年)は、AIアプリケーションの開発コストが一般的なソフトウェアの3倍から5倍になり得ると述べています。
- 公開データの限界: Epochの研究者は、2026年から2032年の間に学習データセットが公開テキストの総量とほぼ同じ規模になると予測しています。
