Como gerenciar os custos de modelos à medida que o uso cresce
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Os custos de modelos se comportam de forma diferente da maioria dos custos de software. Um produto SaaS tradicional atende o seu décimo milésimo cliente quase sem custo extra. Um produto de IA paga por computação toda vez que um cliente pede que ele faça algo, então a conta cresce com o uso, e o uso tende a crescer mais rápido do que a receita quando os clientes amam o produto. Essa é a situação que fundadores e COOs estão gerenciando: não um projeto pontual de otimização, mas uma linha de custo que precisa de um responsável, de um dashboard e de um conjunto de alavancas.
Este guia trata dessas alavancas no nível da empresa. Ele é propositalmente neutro em relação a fornecedores. Não cita preços de modelos, porque eles mudam com frequência demais para serem úteis em um artigo de referência, e descreve classes de técnicas em vez de produtos. Se você quer a visão de engenharia por agente sobre cache, roteamento e orçamentos de chamadas, leia otimização de custos de agentes de IA. Se quer o lado contábil, como esses custos são classificados e como chegam à margem, veja COGS de empresas de IA e custos de inferência e margem bruta em IA. Aqui ficamos na pergunta que uma equipe de liderança em fase de crescimento realmente enfrenta: o que podemos fazer a respeito, em que ordem e quem é o responsável?
Comece pela visibilidade, não pela otimização
Quase todo esforço de corte de custos que fracassa começa no lugar errado. As equipes escolhem uma técnica engenhosa antes de saber para onde vai o dinheiro. A primeira alavanca nem é uma técnica. É a medição.
A fatura de um provedor de modelos é um único número para a empresa inteira. Esse número não diz se um cliente específico é lucrativo, se um novo recurso está vazando margem ou se um pico veio de crescimento real ou de um único processo descontrolado. Para ter respostas, você precisa do custo atribuído à unidade que o seu negócio vende.
Escolha a unidade que corresponde à forma como você cobra e como os clientes pensam:
- Custo por tarefa ou resultado: um documento processado, um chamado resolvido, um relatório gerado.
- Custo por cliente por mês: o gasto total com modelos associado a uma conta.
- Custo por recurso: quais partes do produto consomem mais computação.
- Custo por usuário ativo: útil como verificação de sanidade, mas esconde a divisão entre usuários intensivos e leves.
Na prática, isso significa marcar cada chamada ao modelo com um ID de cliente, um nome de recurso e um tipo de tarefa no momento em que ela é feita, e armazenar essas marcações junto com a contagem de tokens e a latência. É uma tubulação pouco glamorosa, e é a base de tudo o que vem a seguir. Depois de implementada, faça o gráfico da distribuição, não só da média. Em muitos produtos, uma pequena parcela dos clientes gera uma grande parcela do custo, e a média esconde isso. A mesma disciplina vale para qualquer negócio em que o custo varia por cliente, e o nosso explicativo sobre unit economics aborda o enquadramento geral.
Vale construir duas visões logo no início. A primeira é o custo por unidade em relação ao preço por unidade, por segmento de clientes, para você ver quais segmentos estão no prejuízo. A segunda é o custo por unidade ao longo do tempo, para saber se as mudanças de produto ou de modelo estão ajudando ou atrapalhando.
A tabela de alavancas
Depois que você consegue ver o custo no nível da unidade, as alavancas viram escolhas em vez de palpites. A tabela resume cada uma: o que é, a troca habitual e quando costuma se encaixar. As seções seguintes trazem os detalhes.
| Alavanca | O que é | Troca típica | Quando se encaixa |
|---|---|---|---|
| Visibilidade de custo por unidade | Marcar cada chamada por cliente, recurso e tarefa | Tempo de engenharia no início | Sempre, antes de qualquer outra coisa |
| Roteamento e cascatas | Tentar primeiro um modelo mais barato e escalar quando necessário | Risco de qualidade em requisições mal roteadas, latência adicional | Requisições de dificuldade variada em volume significativo |
| Enxugamento de prompt e contexto | Enviar menos tokens por chamada | Possível perda de contexto útil | Prompts longos, recuperação verbosa, agentes prolixos |
| Cache | Reaproveitar computação anterior para entradas repetidas | Dados desatualizados, esforço de gestão do cache | Prefixos estáveis, consultas repetidas ou quase duplicadas |
| Processamento em lote | Executar trabalho não urgente de forma assíncrona e em massa | Resultados atrasados | Relatórios, enriquecimento, tarefas de back-office |
| Destilação e fine-tuning | Treinar um modelo menor com as saídas de um maior | Esforço inicial, capacidade mais restrita, manutenção | Uma tarefa estável, de alto volume e bem definida |
| Open-weight ou auto-hospedagem | Executar modelos na sua própria infraestrutura | Carga operacional, risco de capacidade | Carga pesada e previsível, necessidade de controle dos dados |
| Limites de taxa e de uso | Limitar o consumo por usuário ou conta | Atrito para usuários intensivos legítimos | Risco de abuso, planos gratuitos, demanda desigual |
| Salvaguardas de preço | Termos de uso justo, créditos, excedente | Atrito nas vendas, complexidade | Custos que variam muito por cliente |
| Governança | Orçamentos, alertas, um responsável nomeado | Sobrecarga de processo | Quando o gasto se torna relevante |
Roteamento e cascatas: modelo pequeno primeiro
A ideia por trás de uma cascata é simples. A maioria das requisições é fácil, e um modelo barato dá conta delas. Uma minoria é difícil e precisa de um modelo mais capaz e mais caro. Se você consegue distinguir uma da outra, ou descobrir isso de forma barata, só paga o preço alto quando ele compensa.
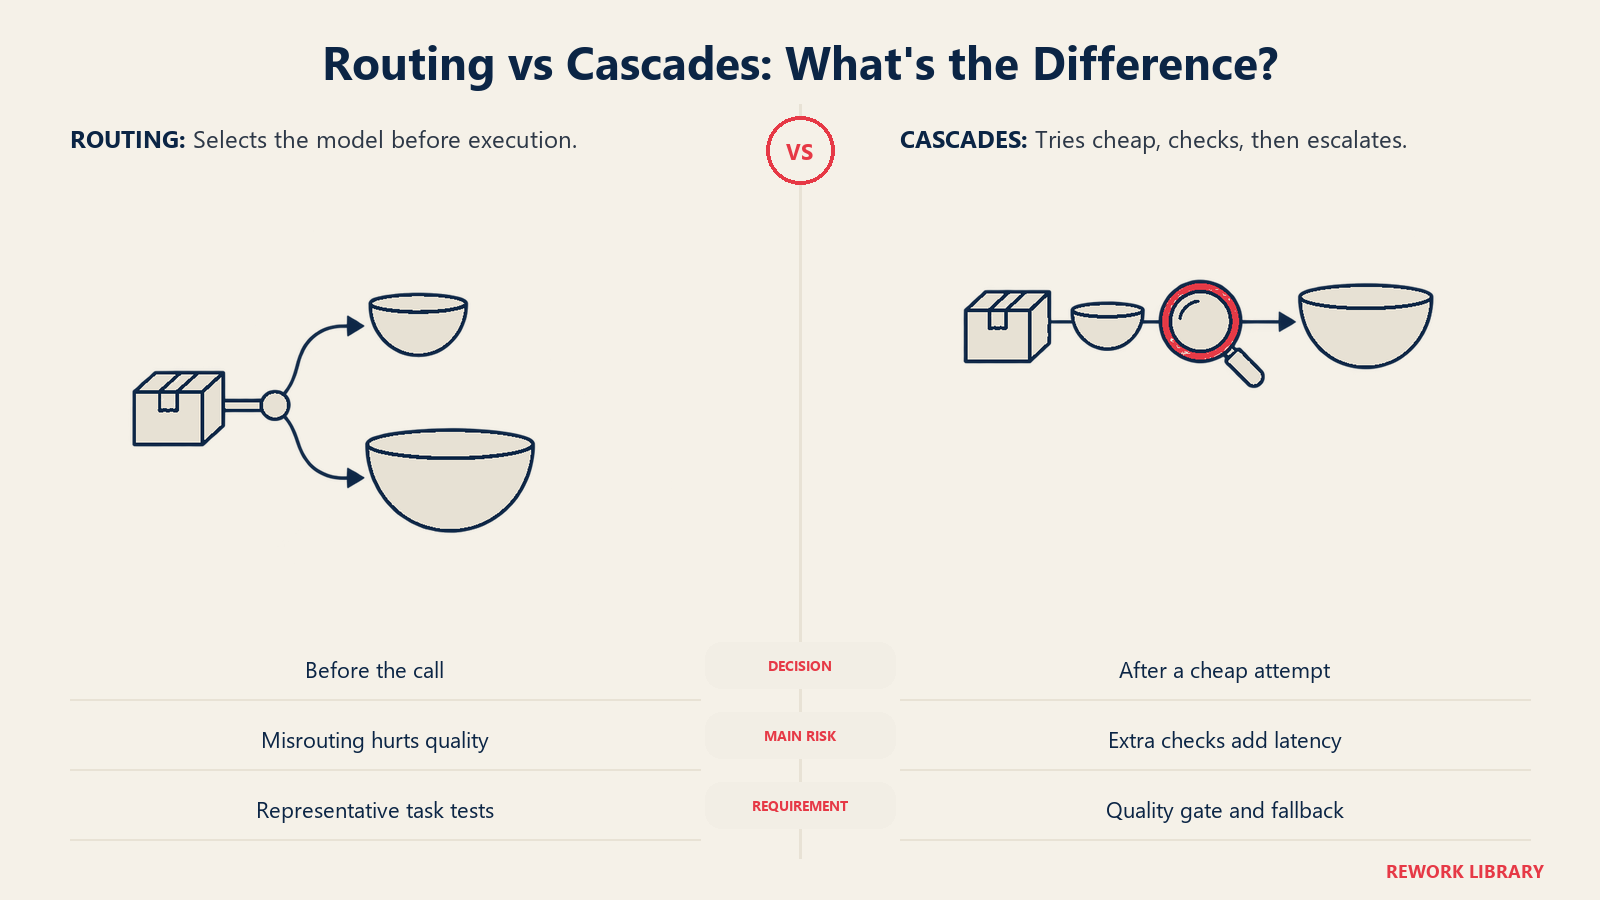
Há dois formatos comuns. Em uma cascata, você envia a requisição primeiro ao modelo mais barato, verifica se a resposta é boa o suficiente e escala para um modelo mais forte só se não for. No roteamento, um classificador decide de antemão qual modelo deve atender a requisição, sem tentar primeiro o barato.
Vale conhecer a pesquisa sobre o tema e ler os números com atenção. O artigo do FrugalGPT propõe cascatas entre modelos e relata que a abordagem pode igualar o desempenho do melhor modelo individual com redução de custo de até 98% ou melhorar a precisão em relação a esse modelo em 4% com o mesmo custo. Esses são os resultados dos autores nos seus benchmarks, e o "até" pesa bastante na primeira afirmação. A sua carga de trabalho será diferente. O artigo do RouteLLM treina roteadores com dados de preferência humana e relata que a abordagem reduz os custos em mais de 2 vezes em certos casos sem comprometer a qualidade das respostas, e que os roteadores continuaram funcionando quando os modelos subjacentes mudaram no momento do teste.
Trate as duas pesquisas como evidência de que a alavanca é real, não como previsão de economia. As trocas honestas são estas:
- Roteamento errado custa qualidade. Se o roteador envia uma requisição difícil para o modelo fraco e nada detecta isso, o cliente recebe uma resposta ruim. Você precisa de uma forma de medir a qualidade das respostas nas suas próprias tarefas antes de confiar em um roteador.
- Cascatas acrescentam latência. Uma requisição que falha na tentativa barata paga pela chamada barata, pela verificação e depois pela chamada cara. Em produtos interativos, esse atraso pode fazer diferença.
- O verificador também tem custo. Decidir se uma resposta é boa o suficiente não sai de graça. Algumas equipes usam regras simples, outras usam um modelo pequeno, outras usam sinais de confiança. Cada abordagem tem modos de falha.
- É preciso um conjunto de avaliação. Sem um conjunto de tarefas representativas com respostas boas conhecidas, você não consegue saber se uma mudança de roteamento ajudou ou prejudicou silenciosamente.
No nível da empresa, o movimento prático é começar onde o custo está concentrado. Use os seus dados por unidade para encontrar os um ou dois tipos de tarefa que respondem pela maior parte do gasto e teste o roteamento ali primeiro.
Enxugamento de prompt e contexto
O custo escala com a quantidade de texto que entra e sai, então os tokens mais baratos são aqueles que você nunca envia. Essa alavanca tende a ser subestimada porque parece trivial, e muitas vezes dá retorno rápido.
Lugares comuns para olhar:
- Instruções inchadas. Os system prompts acumulam regras ao longo dos meses. Muitas podem ser encurtadas ou removidas sem mudar o comportamento.
- Recuperação excessiva. Trazer dez trechos de documentos para o contexto quando três bastariam aumenta o custo de cada chamada.
- Histórico da conversa. Reenviar um histórico longo a cada turno pode dominar o custo. Resumir os turnos mais antigos troca um pouco de fidelidade por muita economia.
- Saídas verbosas. Pedir respostas estruturadas e concisas, onde o produto permitir, reduz o gasto com saída.
A troca é que cortar contexto pode cortar qualidade de formas difíceis de perceber. Trate cada mudança de enxugamento como um experimento contra o seu conjunto de avaliação, não como uma tarefa de limpeza. Um prompt 30% mais curto e 5% pior só é uma vitória se os seus clientes não perceberem e se a sua margem precisava dessa ajuda.
Cache: não pague duas vezes pelo mesmo trabalho
O cache se divide em dois grandes tipos.
O cache de prompt (prefixo) permite que um provedor ou camada de serviço reaproveite a computação de um início longo e estável de um prompt, como instruções e documentos de referência, de modo que chamadas repetidas com o mesmo prefixo custem menos. Ele recompensa prompts estruturados com a parte estável primeiro e a parte variável por último. Termos e descontos variam por provedor e mudam com o tempo, então consulte a documentação atual em vez de confiar em um número de artigo.
O cache de resposta (semântico) armazena respostas e as entrega de novo quando uma nova requisição é idêntica ou parecida o suficiente. Ele pode eliminar totalmente a chamada ao modelo. O risco é entregar uma resposta desatualizada ou sutilmente errada para uma pergunta que só parecia semelhante, o que é um problema real em qualquer coisa personalizada, sensível ao tempo ou de alto risco. Ele serve para perguntas restritas e repetitivas, como consultas comuns de suporte ou classificações padrão, e serve mal para geração aberta.
O cache se encaixa melhor onde os seus dados de uso mostram muita repetição. Se os seus logs marcados mostram o mesmo prefixo grande saindo milhares de vezes por dia, o cache merece atenção antes de qualquer coisa mais sofisticada.
Processamento em lote: troque velocidade por preço
Nem toda requisição precisa de resposta instantânea. Enriquecimento noturno, geração de relatórios, classificação em massa e limpeza de back-office podem ser executados de forma assíncrona, em lotes. Muitos provedores cobram menos pelo processamento adiado, em lote, do que pelo processamento em tempo real, e o processamento em lote também suaviza a carga na sua própria infraestrutura. A troca é que os resultados chegam depois. A decisão é de produto: quais tarefas os clientes realmente não perceberiam se rodassem durante a noite? Liste-as e mude o que puder.
Destilação e fine-tuning: um modelo menor para uma tarefa restrita
A destilação treina um modelo menor para imitar um maior em uma tarefa específica. O fine-tuning adapta um modelo existente aos seus dados. Os dois buscam o mesmo resultado: um modelo mais barato que seja bom o suficiente naquilo de que você precisa.
A pesquisa apoia a ideia, dentro de limites. O artigo "Distilling Step-by-Step" relata que um modelo T5 de 770M de parâmetros superou um modelo PaLM de 540B de parâmetros com prompt few-shot em um benchmark, usando apenas 80% dos dados de treinamento disponíveis, ao usar as justificativas do modelo maior como sinal adicional de treinamento. É um resultado em um único benchmark, mas ilustra o princípio: para uma tarefa definida, um modelo pequeno e especializado pode competir com um gigante generalista.
As trocas para uma empresa:
- Esforço inicial e contínuo. Você precisa de dados de treinamento, de um conjunto de avaliação, de tempo de engenharia e de um plano para retreinar quando a tarefa ou os dados mudarem.
- Capacidade mais restrita. O modelo pequeno faz bem uma tarefa e pode falhar com entradas fora dela. Você precisa de um caminho alternativo.
- Um alvo em movimento. Os modelos gerais continuam melhorando e ficando mais baratos, então a vantagem de um modelo destilado pode diminuir. Refaça a comparação periodicamente.
- Termos de uso. Alguns provedores restringem o uso das saídas dos seus modelos para treinar outros modelos. Verifique os termos antes de construir um pipeline com base nessa premissa.
Ela se encaixa melhor quando uma tarefa é estável, de alto volume, bem definida e fácil de avaliar. Encaixa-se mal em tarefas que mudam toda semana ou que exigem raciocínio amplo.
Uma técnica relacionada que vale conhecer é a decodificação especulativa, em que um modelo pequeno rascunha tokens que um modelo grande verifica. O artigo original relata uma aceleração de 2X a 3X em relação à implementação padrão, com saídas idênticas. Na maioria das vezes, isso é algo que o seu provedor de serviço ou a sua equipe de infraestrutura implementa, e não uma decisão de produto, mas explica por que os custos de serviço auto-hospedado continuam caindo.
Open-weight e auto-hospedagem versus API
A partir de certo volume, os fundadores perguntam se devem parar de alugar modelos por meio de uma API e executar modelos open-weight na própria infraestrutura. É uma pergunta legítima, e a resposta raramente é um sim ou não limpo.
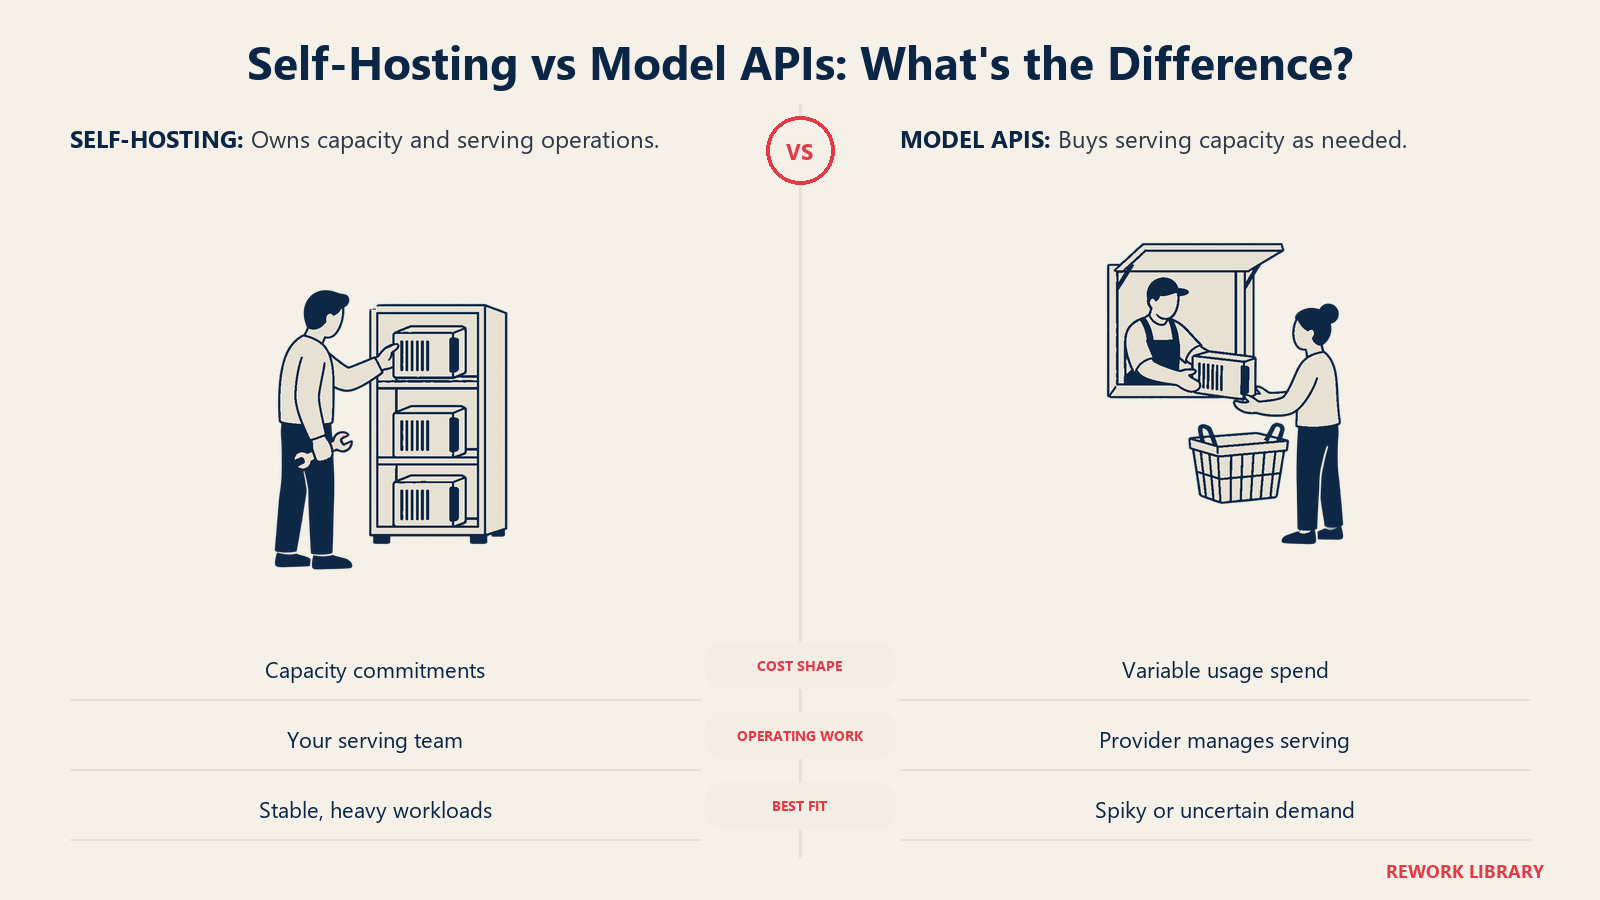
O que a auto-hospedagem pode oferecer: custo mais previsível em volume alto e constante, controle sobre a localização e o tratamento dos dados, liberdade para personalizar e proteção contra mudanças de preço ou de política do provedor.
O que ela custa: você assume o planejamento de capacidade, a compra de GPU ou compromissos de aluguel, a engenharia de serviço, o monitoramento, a segurança e as atualizações. Capacidade ociosa é puro desperdício, e picos de demanda podem sobrecarregar uma capacidade fixa. Você também fica com a eventual diferença de qualidade entre o modelo aberto e o de fronteira.
Uma forma útil de enquadrar a questão: uma API converte um problema de capacidade fixa em custo variável, e a auto-hospedagem o converte de volta. Se a sua demanda é irregular ou ainda desconhecida, o custo variável é uma vantagem. Se a sua demanda é constante e grande, e a tarefa se encaixa em um modelo aberto, o custo fixo pode sair na frente, mas só depois de você contar os engenheiros. Muitas empresas acabam com um modelo híbrido: auto-hospedam as cargas de alto volume e bem compreendidas e usam APIs para a cauda longa e para as requisições mais difíceis. O quanto da stack você possui também é uma escolha estratégica, não só de custo, e camada de aplicação vs camada de modelo trata desse lado.
Limites de taxa e de uso
Limites técnicos protegem você das duas piores surpresas de custo: abuso e acidente. Os planos gratuitos atraem pessoas que vão forçar o produto até onde ele permitir. Um bug na integração de um cliente pode entrar em loop e queimar milhares de chamadas em uma hora.
Controles sensatos incluem limites de taxa por usuário e por conta, tetos de gasto diários ou mensais que disparam uma revisão antes de disparar mais gastos e limites rígidos para contas gratuitas e de teste. Desenhe-os pensando no cliente. Um limite que surpreende um cliente pagante é um chamado de suporte e um risco de churn. Avise em 70% ou 80%, explique o que acontece no limite e dê aos administradores uma forma de aumentá-lo.
Salvaguardas de preço: deixe o preço carregar parte do custo
As alavancas de engenharia reduzem o seu custo. As alavancas de preço mudam quem o suporta. As duas pertencem à mesma conversa, porque um problema de margem muitas vezes pode ser resolvido do lado da receita mais rápido do que do lado do custo.
As salvaguardas habituais são:
- Políticas de uso justo em planos que dizem "ilimitado", definindo o que ilimitado significa na prática.
- Franquias incluídas com excedente, para que o uso intensivo gere receita em vez de apenas custo. Nosso guia de precificação híbrida para produtos de IA mostra como dimensionar a franquia e a tarifa de excedente.
- Créditos, que transformam um custo variável confuso em uma moeda única que os clientes conseguem orçar. Veja precificação baseada em créditos.
- Medidores ligados ao valor, para que a receita acompanhe o que os clientes realmente obtêm do produto, e não a atividade bruta.
A troca é o atrito nas vendas e a complexidade de cobrança. Os clientes gostam de contas previsíveis, e cada regra extra é algo a ser explicado. Um bom teste é verificar se o seu cliente mais caro também é lucrativo com os preços atuais. Se os dados por unidade disserem que não, esse é um problema de preço antes de ser um problema de engenharia.
Governança: quem é o dono do número
As alavancas não se acionam sozinhas. As empresas que controlam o gasto com modelos costumam ter as mesmas poucas coisas implementadas.
Um responsável nomeado. O custo de modelos atravessa engenharia, produto, finanças e, às vezes, customer success. Quando pertence a todos, não pertence a ninguém. Escolha uma pessoa responsável, muitas vezes alguém da liderança de engenharia com um parceiro de finanças, e entregue o dashboard a ela.
Orçamentos por área de produto. Aloque um orçamento de gasto com modelos para cada recurso ou equipe, expresso em uma unidade que faça sentido, como custo por tarefa ou percentual da receita. Orçamentos mudam comportamentos porque as pessoas veem as consequências das suas escolhas de design.
Alertas, não apenas relatórios. Uma revisão mensal descobre um custo descontrolado com trinta dias de atraso. Configure alertas sobre o gasto diário, o custo por tarefa e o consumo incomum por cliente.
Uma revisão antes do lançamento. Todo novo recurso de IA recebe uma estimativa de custo antes do lançamento: chamadas esperadas por tarefa, tokens esperados, custo esperado por unidade e preço esperado. É um checklist curto, e evita a história do "lançamos e a margem sumiu".
Uma cadência regular. Revise trimestralmente as regras de roteamento, o cache e as escolhas de modelos. As opções não param de mudar, e a melhor configuração do ano passado raramente é a deste ano.
Uma ordem sensata de execução
Se você está começando do zero, uma sequência aproximada mantém o esforço proporcional ao retorno:
- Instrumente o custo por tarefa, por cliente e por recurso.
- Descubra onde o gasto se concentra e quais clientes estão no prejuízo.
- Enxugue prompts e contexto e adicione cache onde a repetição for evidente.
- Mova o trabalho não urgente para processamento em lote.
- Adicione roteamento ou cascatas para os tipos de tarefa de maior gasto, apoiados por um conjunto de avaliação.
- Defina limites, alertas e termos de uso justo e corrija a precificação onde os dados mostrarem uma lacuna.
- Considere destilação ou auto-hospedagem apenas para cargas estáveis e de alto volume, e só depois de esgotar as alavancas mais baratas.
Essa ordem coloca primeiro os movimentos baratos e reversíveis e por último os pesados e difíceis de reverter.
Fatos principais
- Meça o custo na unidade que você vende (tarefa, cliente, recurso) antes de otimizar. Uma única fatura do provedor não diz quem não é lucrativo.
- As cascatas tentam primeiro um modelo mais barato e escalam. Os autores do FrugalGPT relatam igualar o melhor modelo individual com redução de custo de até 98% ou melhorar a precisão em 4% com o mesmo custo.
- Roteadores treinados também podem reduzir custos. Os autores do RouteLLM relatam reduções de custo de mais de 2 vezes em certos casos sem comprometer a qualidade das respostas.
- A destilação pode produzir modelos pequenos e específicos para uma tarefa. Um estudo relata um modelo de 770M de parâmetros superando um modelo de 540B de parâmetros com prompt few-shot em um benchmark, usando 80% dos dados de treinamento disponíveis.
- A decodificação especulativa acelera o serviço de modelos grandes. Seus autores relatam uma aceleração de 2X a 3X com saídas idênticas.
- Resultados de pesquisa vêm de benchmarks específicos. Valide cada alavanca no seu próprio conjunto de avaliação antes de contar com a economia.
- As alavancas de preço (franquias, excedente, créditos, uso justo) transferem o custo para quem o gera e costumam ser mais rápidas de implantar do que mudanças de engenharia.
- Toda linha de custo precisa de um responsável nomeado, de um orçamento e de alertas.
Perguntas frequentes sobre a gestão de custos de modelos de IA
Qual é a primeira coisa a fazer quando os custos de modelos começam a subir?
Meça o custo por tarefa, por cliente e por recurso, marcando cada chamada ao modelo. Uma única fatura não mostra quais clientes ou recursos estão gerando o gasto. Quando você consegue ver para onde vai o dinheiro, pode escolher a alavanca adequada em vez de adivinhar.
O que é uma cascata de modelos e quanto ela pode economizar?
Uma cascata envia a requisição primeiro a um modelo mais barato e escala para um mais forte apenas quando a primeira resposta não é boa o suficiente. O artigo do FrugalGPT relata igualar o melhor modelo individual com redução de custo de até 98% nos seus benchmarks. A economia real depende da sua mistura de requisições fáceis e difíceis, então teste nas suas próprias tarefas.
O cache é seguro para produtos de IA?
O cache de prompt, que reaproveita o início estável de um prompt, não muda as respostas. O cache de resposta, que entrega respostas armazenadas para perguntas semelhantes, pode retornar resultados desatualizados ou inadequados, então use-o para consultas restritas e repetitivas e evite-o para consultas personalizadas ou sensíveis ao tempo.
Quando faz sentido auto-hospedar modelos open-weight em vez de usar uma API?
Geralmente quando o volume é alto e constante, a tarefa se encaixa em um modelo aberto e você tem capacidade de engenharia para operá-lo. Uma API transforma capacidade em custo variável, o que combina com demanda incerta ou irregular. Muitas empresas acabam com um modelo híbrido, auto-hospedando as cargas pesadas e previsíveis e usando APIs para o restante.
A precificação pode resolver um problema de custo de modelos?
Muitas vezes, sim. Franquias incluídas com excedente, créditos e termos de uso justo transferem os custos do uso intensivo para os clientes que os geram. Se os seus clientes mais caros não são lucrativos com os preços atuais, essa é uma lacuna de preço a fechar antes do trabalho de engenharia, ou junto com ele.
Quem deve ser o responsável pelos custos de modelos dentro de uma empresa?
Uma pessoa nomeada, geralmente da liderança de engenharia, com um parceiro de finanças. Dê a ela um dashboard de custo por unidade, orçamentos por área de produto e alertas sobre gastos incomuns. Responsabilidade compartilhada sem um único responsável tende a significar que ninguém age.
Leitura relacionada

Co-Founder & COO
On this page
- Comece pela visibilidade, não pela otimização
- A tabela de alavancas
- Roteamento e cascatas: modelo pequeno primeiro
- Enxugamento de prompt e contexto
- Cache: não pague duas vezes pelo mesmo trabalho
- Processamento em lote: troque velocidade por preço
- Destilação e fine-tuning: um modelo menor para uma tarefa restrita
- Open-weight e auto-hospedagem versus API
- Limites de taxa e de uso
- Salvaguardas de preço: deixe o preço carregar parte do custo
- Governança: quem é o dono do número
- Uma ordem sensata de execução
- Fatos principais
- Leitura relacionada