Cómo gestionar los costos de los modelos a medida que crece el uso
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Los costos de los modelos se comportan de forma distinta a la mayoría de los costos de software. Un producto SaaS tradicional atiende a su cliente número diez mil casi sin costo adicional. Un producto de IA paga cómputo cada vez que un cliente le pide hacer algo, así que la factura crece con el uso, y el uso tiende a crecer más rápido que los ingresos cuando a los clientes les encanta el producto. Esa es la situación que gestionan los fundadores y los COO: no un proyecto de optimización puntual, sino una partida de costos que necesita un responsable, un dashboard y un conjunto de palancas.
Esta guía trata sobre esas palancas a nivel de empresa. Es deliberadamente neutral respecto a los proveedores. No menciona precios de modelos, porque cambian demasiado a menudo para ser útiles en un artículo de referencia, y describe categorías de técnicas en lugar de productos. Si busca la visión de ingeniería por agente sobre caché, enrutamiento y presupuestos de llamadas, lea optimización de costos de agentes de IA. Si busca el lado contable, cómo se clasifican estos costos y cómo llegan al margen, consulte el COGS de las empresas de IA y costos de inferencia y margen bruto en la IA. Aquí nos quedamos en la pregunta que realmente enfrenta un equipo directivo en etapa de crecimiento: ¿qué podemos hacer al respecto, en qué orden y quién es el responsable?
Empiece por la visibilidad, no por la optimización
Casi todos los esfuerzos de reducción de costos que fracasan empiezan en el lugar equivocado. Los equipos eligen una técnica ingeniosa antes de saber adónde va el dinero. La primera palanca ni siquiera es una técnica. Es la medición.
La factura de un proveedor de modelos es una sola cifra para toda la empresa. Esa cifra no puede decirle si un cliente concreto es rentable, si una función nueva es una fuga de margen o si un pico se debió a un crecimiento real o a un único proceso descontrolado. Para obtener respuestas, necesita atribuir el costo a la unidad que vende su negocio.
Elija la unidad que coincida con la forma en que usted cobra y en que piensan los clientes:
- Costo por tarea o resultado: un documento procesado, un ticket resuelto, un informe generado.
- Costo por cliente al mes: el gasto total en modelos etiquetado a una cuenta.
- Costo por función: qué partes del producto consumen más cómputo.
- Costo por usuario activo: útil como verificación de sentido común, pero oculta la división entre usuarios intensivos y ligeros.
En la práctica, eso significa etiquetar cada llamada al modelo con un ID de cliente, un nombre de función y un tipo de tarea en el momento en que se realiza, y almacenar esas etiquetas junto con el conteo de tokens y la latencia. Es una tubería poco glamorosa, y es la base de todo lo que sigue. Una vez implementada, grafique la distribución, no solo el promedio. En muchos productos, una pequeña proporción de clientes genera una gran proporción del costo, y el promedio lo oculta. La misma disciplina se aplica a cualquier negocio en el que el costo varíe por cliente, y nuestra explicación sobre la economía unitaria cubre el planteamiento general.
Vale la pena construir pronto dos vistas. La primera es el costo por unidad frente al precio por unidad, por segmento de clientes, para ver qué segmentos están en pérdida. La segunda es el costo por unidad a lo largo del tiempo, para saber si los cambios de producto o de modelo están ayudando o perjudicando.
La tabla de palancas
Una vez que puede ver el costo a nivel de unidad, las palancas se convierten en decisiones en lugar de suposiciones. La tabla resume cada una: qué es, la disyuntiva habitual y cuándo suele encajar. Las secciones que siguen dan el detalle.
| Palanca | Qué es | Disyuntiva típica | Cuándo encaja |
|---|---|---|---|
| Visibilidad de costos por unidad | Etiquetar cada llamada por cliente, función y tarea | Tiempo de ingeniería al inicio | Siempre, antes que cualquier otra cosa |
| Enrutamiento y cascadas | Probar primero un modelo más barato y escalar cuando haga falta | Riesgo de calidad en solicitudes mal enrutadas, latencia adicional | Solicitudes de dificultad mixta con un volumen significativo |
| Recorte de prompts y contexto | Enviar menos tokens por llamada | Posible pérdida de contexto útil | Prompts largos, recuperación excesiva, agentes verbosos |
| Caché | Reutilizar cómputo previo para entradas repetidas | Información desactualizada, esfuerzo de gestión de la caché | Prefijos estables, consultas repetidas o casi duplicadas |
| Procesamiento por lotes | Ejecutar en bloque y de forma asíncrona el trabajo no urgente | Resultados con retraso | Informes, enriquecimiento de datos, tareas administrativas |
| Destilación y fine-tuning | Entrenar un modelo más pequeño con los resultados de uno más grande | Esfuerzo inicial, capacidad más acotada, mantenimiento | Una tarea estable, de alto volumen y bien definida |
| Modelos de pesos abiertos o alojamiento propio | Ejecutar modelos en su propia infraestructura | Carga operativa, riesgo de capacidad | Carga intensa y previsible, necesidades de control de datos |
| Límites de tasa y topes de uso | Acotar el consumo por usuario o por cuenta | Fricción para usuarios intensivos legítimos | Riesgo de abuso, planes gratuitos, demanda desigual |
| Barreras de precios | Términos de uso razonable, créditos, excedentes | Fricción en ventas, complejidad | Costos que varían mucho entre clientes |
| Gobernanza | Presupuestos, alertas, un responsable designado | Carga de procesos | Una vez que el gasto se vuelve significativo |
Enrutamiento y cascadas: primero el modelo pequeño
La idea detrás de una cascada es sencilla. La mayoría de las solicitudes son fáciles y un modelo barato las resuelve bien. Una minoría son difíciles y necesitan uno más capaz y más caro. Si usted puede saber cuál es cuál, o averiguarlo a bajo costo, paga el precio alto solo cuando lo justifica.
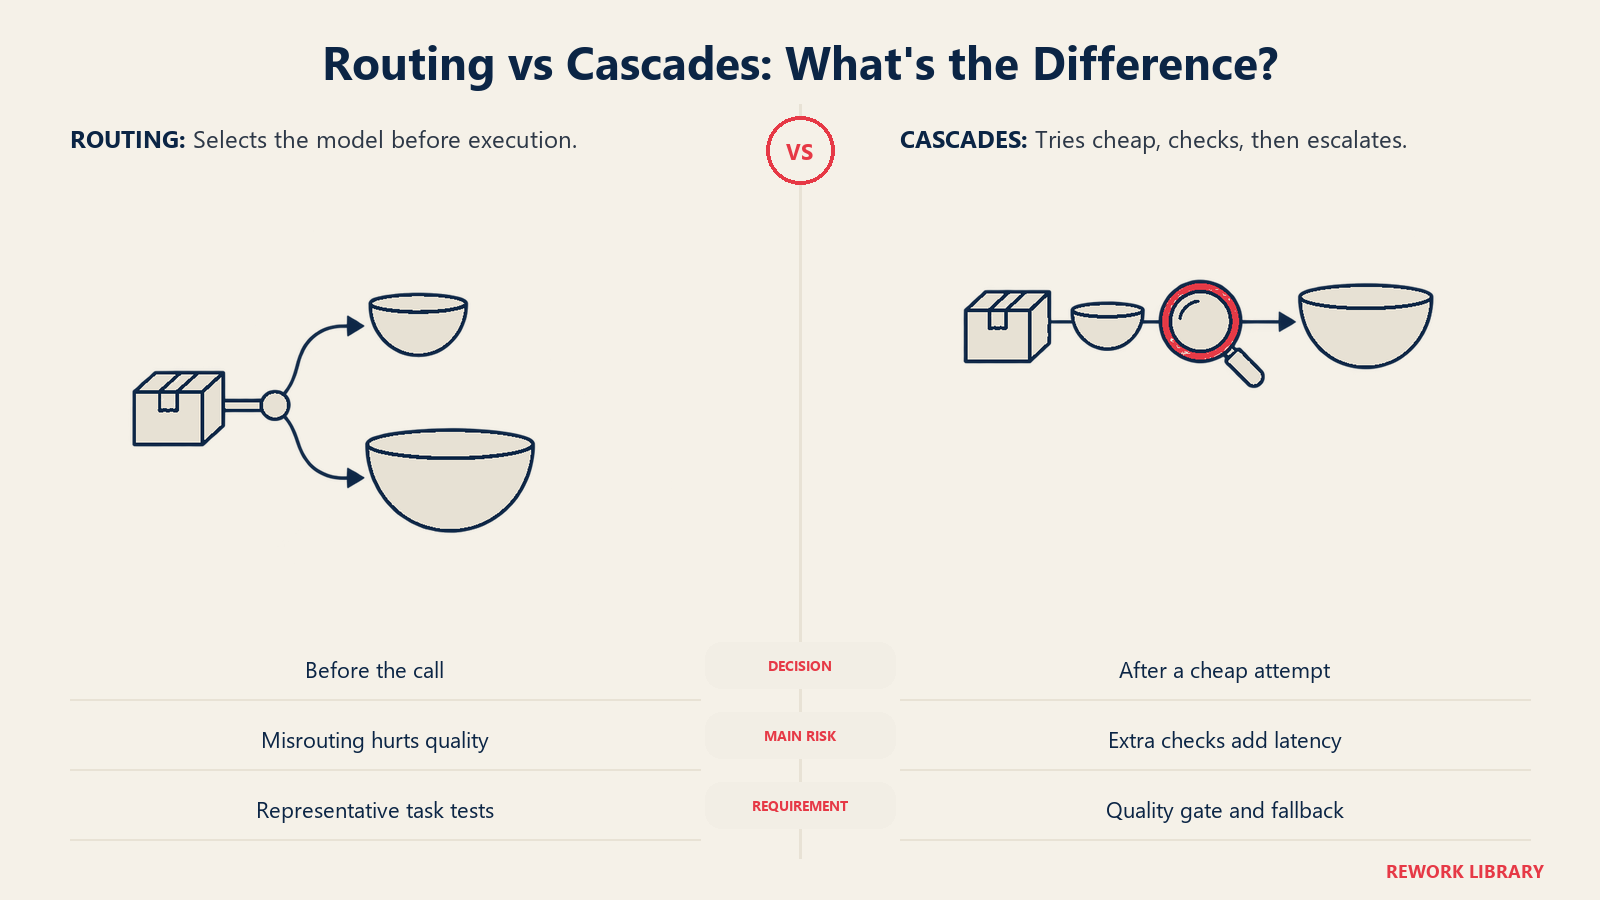
Hay dos formas comunes. En una cascada, la solicitud se envía primero al modelo más barato, se comprueba si la respuesta es suficientemente buena y se escala a un modelo más potente solo si no lo es. En el enrutamiento, un clasificador decide de antemano qué modelo debe atender la solicitud, sin probar primero el barato.
Vale la pena conocer la investigación al respecto, y vale la pena leer las cifras con cuidado. El artículo de FrugalGPT propone encadenar modelos en cascada e informa que el enfoque puede igualar el rendimiento del mejor modelo individual con hasta un 98 % de reducción de costos, o mejorar la precisión de ese modelo en un 4 % con el mismo costo. Son los resultados de los autores en sus benchmarks, y el «hasta» tiene mucho peso en la primera afirmación. Su carga de trabajo será distinta. El artículo de RouteLLM entrena enrutadores con datos de preferencias humanas e informa que su enfoque reduce los costos en más de 2 veces en ciertos casos sin comprometer la calidad de las respuestas, y que los enrutadores siguieron funcionando cuando los modelos subyacentes cambiaron en el momento de la prueba.
Tome ambos como evidencia de que la palanca es real, no como un pronóstico de ahorro. Las disyuntivas honestas son estas:
- El mal enrutamiento cuesta calidad. Si el enrutador envía una solicitud difícil al modelo débil y nada lo detecta, un cliente recibe una mala respuesta. Necesita una forma de medir la calidad de las respuestas en sus propias tareas antes de confiar en un enrutador.
- Las cascadas añaden latencia. Una solicitud que falla en el intento barato paga la llamada barata, la verificación y luego la llamada cara. En productos interactivos, ese retraso puede importar.
- El verificador también tiene un costo. Decidir si una respuesta es suficientemente buena no es gratis. Algunos equipos usan reglas simples, otros un modelo pequeño, otros señales de confianza. Cada opción tiene sus modos de falla.
- Requiere un conjunto de evaluación. Sin un conjunto de tareas representativas con respuestas correctas conocidas, no puede saber si un cambio de enrutamiento ayudó o perjudicó en silencio.
A nivel de empresa, el paso práctico es empezar donde se concentra el costo. Use sus datos por unidad para encontrar uno o dos tipos de tarea que representen la mayor parte del gasto y pruebe primero el enrutamiento ahí.
Recorte de prompts y contexto
El costo escala con la cantidad de texto que entra y sale, así que los tokens más baratos son los que nunca envía. Esta palanca suele estar subestimada porque parece trivial, y a menudo rinde rápido.
Lugares comunes donde buscar:
- Instrucciones infladas. Los prompts de sistema acumulan reglas con los meses. Muchas se pueden acortar o eliminar sin cambiar el comportamiento.
- Recuperación excesiva. Incluir diez fragmentos de documentos en el contexto cuando bastarían tres eleva el costo en cada llamada.
- Historial de conversación. Reenviar un historial largo en cada turno puede dominar el costo. Resumir los turnos más antiguos sacrifica un poco de fidelidad a cambio de un gran ahorro.
- Salidas verbosas. Pedir respuestas estructuradas y concisas donde el producto lo permita reduce el gasto en salida.
La disyuntiva es que recortar contexto puede recortar calidad de formas difíciles de ver. Trate cada cambio de recorte como un experimento frente a su conjunto de evaluación, no como una tarea de limpieza. Un prompt un 30 % más corto y un 5 % peor solo es una victoria si sus clientes no lo notan y su margen necesitaba la ayuda.
Caché: no pague dos veces por el mismo trabajo
La caché se presenta en dos grandes tipos.
La caché de prompts (de prefijo) permite a un proveedor o a una capa de servicio reutilizar el cómputo de un inicio largo y estable de un prompt, como las instrucciones y los documentos de referencia, de modo que las llamadas repetidas con el mismo prefijo cuesten menos. Premia los prompts estructurados con la parte estable al principio y la parte cambiante al final. Las condiciones y los descuentos varían según el proveedor y cambian con el tiempo, así que consulte la documentación vigente en lugar de confiar en una cifra de un artículo.
La caché de respuestas (semántica) almacena respuestas y las vuelve a servir cuando una solicitud nueva es idéntica o lo bastante parecida. Puede eliminar por completo la llamada al modelo. El riesgo es servir una respuesta desactualizada o sutilmente incorrecta a una pregunta que solo parecía similar, lo cual es un problema real para cualquier cosa personalizada, sensible al tiempo o de alto riesgo. Encaja con preguntas acotadas y repetitivas, como las consultas de soporte comunes o las clasificaciones estándar, y encaja mal con la generación abierta.
La caché funciona mejor donde sus datos de uso muestran mucha repetición. Si sus registros etiquetados muestran el mismo prefijo grande saliendo miles de veces al día, la caché merece atención antes que cualquier cosa más sofisticada.
Procesamiento por lotes: cambiar velocidad por precio
No todas las solicitudes necesitan una respuesta instantánea. El enriquecimiento nocturno de datos, la generación de informes, la clasificación masiva y la limpieza administrativa pueden ejecutarse de forma asíncrona por lotes. Muchos proveedores cobran el procesamiento diferido por lotes por debajo del procesamiento en tiempo real, y el procesamiento por lotes también suaviza la carga en su propia infraestructura. La disyuntiva es que los resultados llegan más tarde. La decisión es de producto: ¿qué trabajos realmente no notarían los clientes si se ejecutaran durante la noche? Haga la lista y traslade lo que pueda.
Destilación y fine-tuning: un modelo más pequeño para un trabajo acotado
La destilación entrena un modelo más pequeño para que imite a uno más grande en una tarea específica. El fine-tuning adapta un modelo existente a sus datos. Ambos apuntan al mismo resultado: un modelo más barato que sea suficientemente bueno en lo único que usted necesita.
La investigación respalda la idea dentro de ciertos límites. El artículo «Distilling Step-by-Step» informa que un modelo T5 de 770 millones de parámetros superó a un modelo PaLM de 540 000 millones de parámetros con prompts de pocos ejemplos en un benchmark, usando solo el 80 % de los datos de entrenamiento disponibles, al emplear los razonamientos del modelo más grande como señal adicional de entrenamiento. Es un resultado en un solo benchmark, pero ilustra el principio: para una tarea definida, un modelo pequeño especializado puede competir con un gigante general.
Las disyuntivas para una empresa:
- Esfuerzo inicial y continuo. Necesita datos de entrenamiento, un conjunto de evaluación, tiempo de ingeniería y un plan para volver a entrenar cuando la tarea o los datos cambien.
- Capacidad más acotada. El modelo pequeño hace bien un trabajo y puede fallar con entradas fuera de él. Necesita una ruta alternativa.
- Un objetivo en movimiento. Los modelos generales siguen mejorando y abaratándose, así que la ventaja de un modelo destilado puede reducirse. Revise la comparación periódicamente.
- Términos de uso. Algunos proveedores restringen el uso de los resultados de sus modelos para entrenar otros modelos. Revise los términos antes de construir una tubería sobre esa suposición.
Encaja mejor cuando una tarea es estable, de alto volumen, bien definida y fácil de evaluar. Encaja mal en tareas que cambian cada semana o que necesitan un razonamiento amplio.
Una técnica relacionada que conviene conocer es la decodificación especulativa, en la que un modelo pequeño redacta tokens que un modelo grande verifica. El artículo original informa una aceleración de 2 a 3 veces respecto a la implementación estándar, con resultados idénticos. Es sobre todo algo que implementa su proveedor de servicio o su equipo de infraestructura, más que una decisión de producto, pero explica por qué los costos de servir modelos con alojamiento propio siguen bajando.
Modelos de pesos abiertos y alojamiento propio frente a API
A partir de cierto volumen, los fundadores se preguntan si deben dejar de alquilar modelos a través de una API y ejecutar modelos de pesos abiertos en su propia infraestructura. Es una pregunta legítima, y la respuesta rara vez es un sí o un no claros.
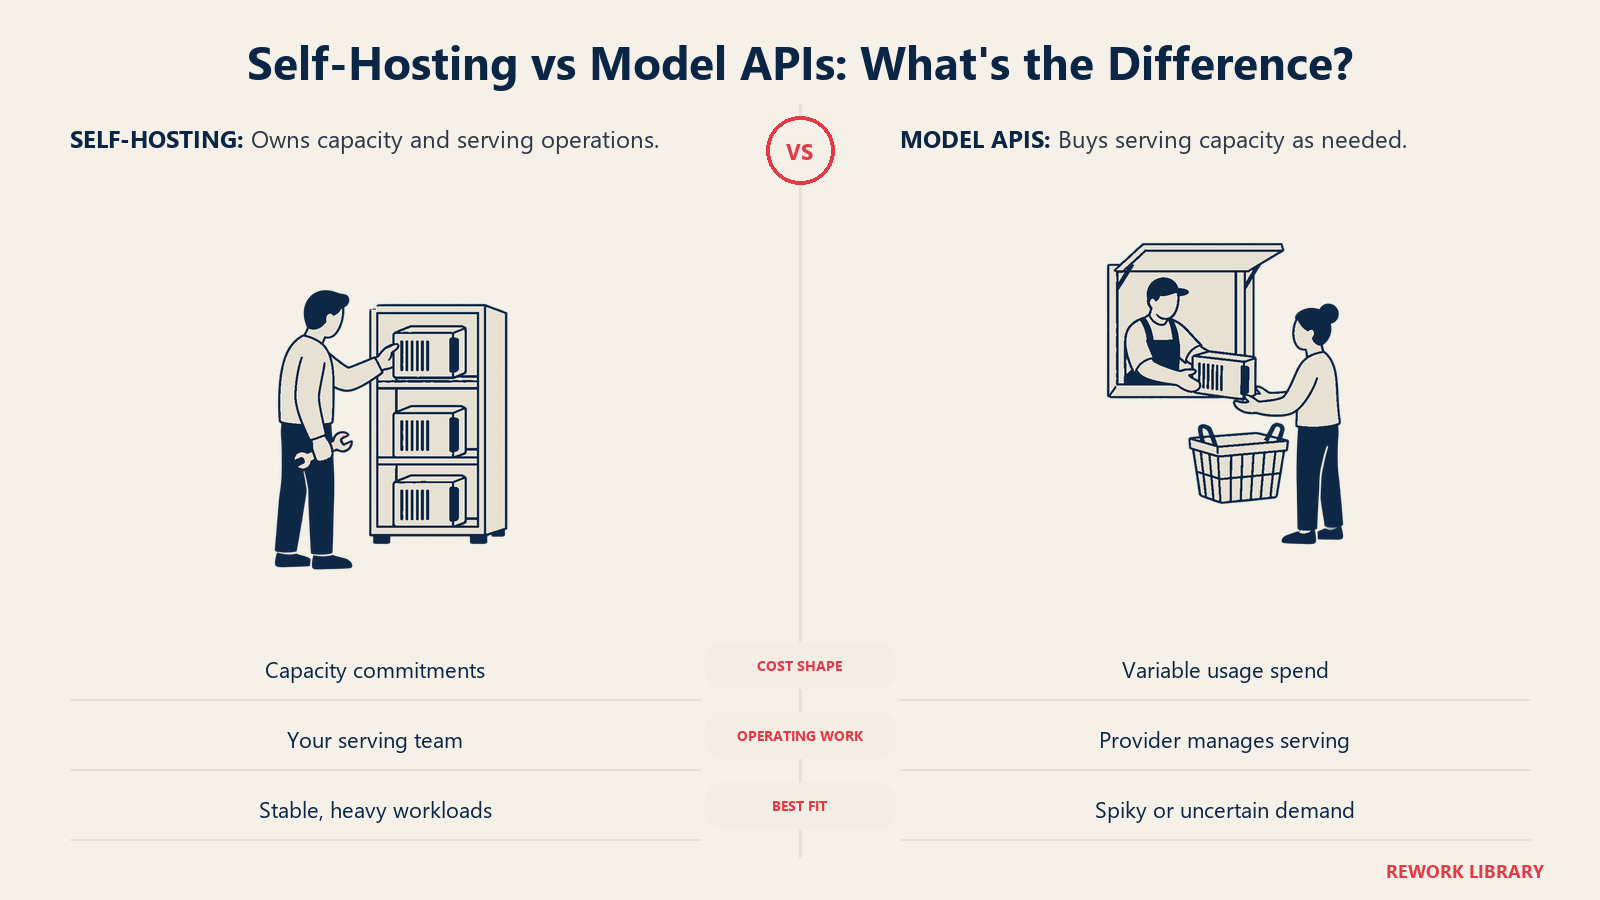
Lo que puede ofrecer el alojamiento propio: un costo más previsible con un volumen alto y constante, control sobre la ubicación y el manejo de los datos, libertad para personalizar y protección frente a los cambios de precios o de políticas de un proveedor.
Lo que cuesta: usted asume la planificación de capacidad, la compra de GPU o los compromisos de alquiler, la ingeniería de servicio, el monitoreo, la seguridad y las actualizaciones. La capacidad ociosa es puro desperdicio, y los picos de demanda pueden desbordar una capacidad fija. También es responsable de la brecha de calidad, si la hay, entre el modelo abierto y el de frontera.
Una forma útil de plantearlo: una API convierte un problema de capacidad fija en un costo variable, y el alojamiento propio lo vuelve a convertir en fijo. Si su demanda es irregular o todavía desconocida, el costo variable es una ventaja. Si su demanda es constante y grande, y la tarea encaja con un modelo abierto, el costo fijo puede salir ganando, pero solo después de contar a los ingenieros. Muchas empresas terminan con un esquema híbrido: alojan por su cuenta las cargas de alto volumen y bien comprendidas, y usan API para la cola larga y para las solicitudes más difíciles. Cuánto del stack controla usted es también una decisión estratégica, no solo de costos, y capa de aplicación frente a capa de modelo cubre ese lado.
Límites de tasa y topes de uso
Los límites técnicos lo protegen de las dos peores sorpresas de costos: el abuso y el accidente. Los planes gratuitos atraen a personas que exigirán al producto todo lo que permita. Un error en la integración de un cliente puede entrar en bucle y consumir miles de llamadas en una hora.
Los controles sensatos incluyen límites de tasa por usuario y por cuenta, topes de gasto diarios o mensuales que activen una revisión antes de activar más gasto, y límites estrictos en las cuentas gratuitas y de prueba. Diséñelos pensando en el cliente. Un límite que sorprende a un cliente que paga es un ticket de soporte y un riesgo de abandono. Avise al 70 u 80 %, explique qué ocurre al alcanzar el límite y dé a los administradores una forma de ampliarlo.
Barreras de precios: que el precio cargue con parte del costo
Las palancas de ingeniería reducen su costo. Las palancas de precios cambian quién lo asume. Ambas pertenecen a la misma conversación, porque un problema de margen a menudo se puede resolver más rápido por el lado de los ingresos que por el lado de los costos.
Las barreras habituales son:
- Políticas de uso razonable en los planes que dicen «ilimitado», que definen qué significa ilimitado en la práctica.
- Asignaciones incluidas con excedentes, de modo que el uso intensivo genere ingresos y no solo costos. Nuestra guía de precios híbridos para productos de IA explica cómo dimensionar la asignación y la tarifa de excedentes.
- Créditos, que convierten un costo variable desordenado en una sola moneda con la que los clientes pueden presupuestar. Consulte precios basados en créditos.
- Medidores vinculados al valor, para que los ingresos se muevan con lo que los clientes realmente obtienen del producto y no con la actividad bruta.
La disyuntiva es la fricción en ventas y la complejidad de facturación. A los clientes les gustan las facturas previsibles, y cada regla adicional es algo que hay que explicar. Una buena prueba es si su cliente más caro también es rentable con los precios actuales. Si los datos por unidad dicen que no, eso es un problema de precios antes que un problema de ingeniería.
Gobernanza: quién es responsable de la cifra
Las palancas no se accionan solas. Las empresas que controlan el gasto en modelos suelen tener implementadas las mismas pocas cosas.
Un responsable designado. El costo de los modelos abarca ingeniería, producto, finanzas y, a veces, éxito del cliente. Cuando es de todos, no es de nadie. Elija a una persona responsable, a menudo alguien de la dirección de ingeniería con un socio de finanzas, y entréguele el dashboard.
Presupuestos por área de producto. Asigne un presupuesto de gasto en modelos a cada función o equipo, expresado en una unidad que tenga sentido, como el costo por tarea o la proporción de los ingresos. Los presupuestos cambian el comportamiento porque las personas ven las consecuencias de sus decisiones de diseño.
Alertas, no solo informes. Una revisión mensual detecta un costo descontrolado treinta días tarde. Configure alertas sobre el gasto diario, sobre el costo por tarea y sobre un consumo inusual a nivel de cliente.
Una revisión antes del lanzamiento. Toda función nueva de IA recibe una estimación de costos antes de lanzarse: llamadas esperadas por tarea, tokens esperados, costo esperado por unidad y precio esperado. Es una lista de verificación breve, y evita la historia de «lo lanzamos y el margen desapareció».
Una cadencia regular. Revise trimestralmente las reglas de enrutamiento, la caché y la elección de modelos. Las opciones cambian constantemente, y la mejor configuración del año pasado rara vez es la de este año.
Un orden de operaciones sensato
Si parte de cero, una secuencia aproximada mantiene el esfuerzo en proporción al beneficio:
- Instrumente el costo por tarea, cliente y función.
- Encuentre dónde se concentra el gasto y qué clientes están en pérdida.
- Recorte prompts y contexto, y añada caché donde la repetición sea evidente.
- Traslade el trabajo no urgente al procesamiento por lotes.
- Añada enrutamiento o cascadas para los tipos de tarea con mayor gasto, respaldados por un conjunto de evaluación.
- Establezca topes, alertas y términos de uso razonable, y corrija los precios donde los datos muestren una brecha.
- Considere la destilación o el alojamiento propio solo para cargas de trabajo estables y de alto volumen, y solo después de agotar las palancas más baratas.
Ese orden coloca primero los movimientos baratos y reversibles, y al final los pesados y difíciles de revertir.
Datos clave
- Mida el costo en la unidad que vende (tarea, cliente, función) antes de optimizar. Una sola factura del proveedor no puede decirle quién no es rentable.
- Las cascadas prueban primero un modelo más barato y escalan. Los autores de FrugalGPT informan que lograron igualar al mejor modelo individual con hasta un 98 % de reducción de costos, o mejorar la precisión en un 4 % con el mismo costo.
- Los enrutadores entrenados también pueden reducir costos. Los autores de RouteLLM informan reducciones de costos de más de 2 veces en ciertos casos sin comprometer la calidad de las respuestas.
- La destilación puede producir modelos pequeños específicos para una tarea. Un estudio informa que un modelo de 770 millones de parámetros superó a un modelo de 540 000 millones de parámetros con prompts de pocos ejemplos en un benchmark, usando el 80 % de los datos de entrenamiento disponibles.
- La decodificación especulativa acelera el servicio de modelos grandes. Sus autores informan una aceleración de 2 a 3 veces con resultados idénticos.
- Los resultados de investigación provienen de benchmarks específicos. Valide cada palanca frente a su propio conjunto de evaluación antes de contar con el ahorro.
- Las palancas de precios (asignaciones, excedentes, créditos, uso razonable) trasladan el costo a quien lo genera y suelen implementarse más rápido que los cambios de ingeniería.
- Toda partida de costos necesita un responsable designado, un presupuesto y alertas.
Preguntas frecuentes sobre la gestión de los costos de modelos de IA
¿Qué es lo primero que debe hacerse cuando los costos de los modelos empiezan a subir?
Medir el costo por tarea, por cliente y por función etiquetando cada llamada al modelo. Una sola factura no puede mostrar qué clientes o funciones impulsan el gasto. Una vez que puede ver adónde va el dinero, puede elegir la palanca adecuada en lugar de adivinar.
¿Qué es una cascada de modelos y cuánto puede ahorrar?
Una cascada envía una solicitud primero a un modelo más barato y escala a uno más potente solo cuando la primera respuesta no es suficientemente buena. El artículo de FrugalGPT informa que igualó al mejor modelo individual con hasta un 98 % de reducción de costos en sus benchmarks. El ahorro real depende de su mezcla de solicitudes fáciles y difíciles, así que pruébelo con sus propias tareas.
¿Es segura la caché para los productos de IA?
La caché de prompts, que reutiliza el inicio estable de un prompt, no cambia las respuestas. La caché de respuestas, que sirve respuestas almacenadas a preguntas similares, puede devolver resultados desactualizados o que no corresponden, así que úsela para consultas acotadas y repetitivas y evítela en las personalizadas o sensibles al tiempo.
¿Cuándo tiene sentido alojar por cuenta propia modelos de pesos abiertos en lugar de usar una API?
Por lo general, cuando el volumen es alto y constante, la tarea encaja con un modelo abierto y usted tiene la capacidad de ingeniería para operarlo. Una API convierte la capacidad en un costo variable, lo que conviene ante una demanda incierta o irregular. Muchas empresas terminan con un esquema híbrido: alojan por su cuenta las cargas intensas y previsibles y usan API para el resto.
¿Pueden los precios resolver un problema de costos de modelos?
A menudo, sí. Las asignaciones incluidas con excedentes, los créditos y los términos de uso razonable trasladan los costos del uso intensivo a los clientes que lo generan. Si sus clientes más caros no son rentables con los precios actuales, esa es una brecha de precios que debe cerrarse antes del trabajo de ingeniería, o en paralelo.
¿Quién debe ser responsable de los costos de los modelos dentro de una empresa?
Una persona designada, por lo general de la dirección de ingeniería, con un socio de finanzas. Entréguele un dashboard de costo por unidad, presupuestos por área de producto y alertas sobre gastos inusuales. La responsabilidad compartida sin un único responsable tiende a significar que nadie actúa.
Lecturas relacionadas

Co-Founder & COO
On this page
- Empiece por la visibilidad, no por la optimización
- La tabla de palancas
- Enrutamiento y cascadas: primero el modelo pequeño
- Recorte de prompts y contexto
- Caché: no pague dos veces por el mismo trabajo
- Procesamiento por lotes: cambiar velocidad por precio
- Destilación y fine-tuning: un modelo más pequeño para un trabajo acotado
- Modelos de pesos abiertos y alojamiento propio frente a API
- Límites de tasa y topes de uso
- Barreras de precios: que el precio cargue con parte del costo
- Gobernanza: quién es responsable de la cifra
- Un orden de operaciones sensato
- Datos clave
- Lecturas relacionadas