Mengurus Kos Model Apabila Penggunaan Berkembang
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Kos model berkelakuan berbeza daripada kebanyakan kos perisian. Produk SaaS tradisional melayani pelanggan ke-sepuluh ribunya hampir tanpa kos tambahan. Produk AI membayar untuk pengkomputeran setiap kali pelanggan memintanya melakukan sesuatu, jadi bil berkembang mengikut penggunaan, dan penggunaan cenderung berkembang lebih pantas daripada hasil apabila pelanggan menyukai produk itu. Itulah situasi yang diuruskan oleh pengasas dan COO: bukan projek pengoptimuman sekali sahaja, tetapi baris kos yang memerlukan pemilik, papan pemuka dan satu set tuil.
Panduan ini membincangkan tuil tersebut di peringkat syarikat. Ia sengaja neutral vendor. Ia tidak menyebut harga model, kerana harga terlalu kerap berubah untuk berguna dalam artikel rujukan, dan ia menerangkan kelas teknik dan bukannya produk. Jika anda mahukan pandangan kejuruteraan setiap ejen tentang cache, penghalaan dan belanjawan panggilan, baca pengoptimuman kos ejen AI. Jika anda mahukan sisi perakaunan, iaitu cara kos ini diklasifikasikan dan bagaimana ia mengalir ke margin, lihat COGS syarikat AI dan kos inferens AI dan margin kasar. Di sini kita kekal pada soalan yang benar-benar dihadapi pasukan kepimpinan peringkat pertumbuhan: apa yang boleh kita lakukan, dalam urutan apa, dan siapa pemiliknya?
Mulakan dengan keterlihatan, bukan pengoptimuman
Hampir setiap usaha pemotongan kos yang gagal bermula di tempat yang salah. Pasukan memilih teknik yang bijak sebelum mereka tahu ke mana wang pergi. Tuil pertama bukanlah teknik langsung. Ia ialah pengukuran.
Invois daripada penyedia model ialah satu angka untuk seluruh syarikat. Angka itu tidak dapat memberitahu anda sama ada pelanggan tertentu menguntungkan, sama ada ciri baharu membocorkan margin, atau sama ada lonjakan datang daripada pertumbuhan sebenar atau daripada satu kerja yang terlepas kawalan. Untuk mendapat jawapan, anda memerlukan kos yang diatribusikan kepada unit yang dijual perniagaan anda.
Pilih unit yang sepadan dengan cara anda mengenakan caj dan cara pelanggan berfikir:
- Kos setiap tugasan atau hasil: satu dokumen diproses, satu tiket diselesaikan, satu laporan dijana.
- Kos setiap pelanggan sebulan: jumlah perbelanjaan model yang ditandakan pada sesebuah akaun.
- Kos setiap ciri: bahagian produk mana yang paling banyak menggunakan pengkomputeran.
- Kos setiap pengguna aktif: berguna sebagai semakan kewarasan, tetapi ia menyembunyikan pembahagian antara pengguna berat dan ringan.
Secara praktikal, ini bermakna menandakan setiap panggilan model dengan ID pelanggan, nama ciri dan jenis tugasan pada saat ia dibuat, dan menyimpan tanda itu bersama kiraan token dan kependaman. Ia kerja paip yang tidak glamor, dan ia asas kepada semua perkara di bawah. Setelah ia tersedia, plot taburannya, bukan sekadar purata. Dalam banyak produk, sebahagian kecil pelanggan memacu sebahagian besar kos, dan purata menyembunyikannya. Disiplin yang sama terpakai dalam mana-mana perniagaan di mana kos berbeza mengikut pelanggan, dan penjelasan kami tentang ekonomi unit membincangkan pembingkaian umumnya.
Dua paparan berbaloi dibina awal. Pertama ialah kos setiap unit berbanding harga setiap unit, mengikut segmen pelanggan, supaya anda dapat melihat segmen mana yang rugi. Kedua ialah kos setiap unit dari semasa ke semasa, supaya anda tahu sama ada perubahan produk atau perubahan model membantu atau memudaratkan.
Jadual tuil
Setelah anda dapat melihat kos di peringkat unit, tuil menjadi pilihan dan bukan tekaan. Jadual ini meringkaskan setiap satu: apakah ia, pertukaran biasa, dan bila ia cenderung sesuai. Bahagian selepasnya memberikan perincian.
| Tuil | Apakah ia | Pertukaran biasa | Bila ia sesuai |
|---|---|---|---|
| Keterlihatan kos peringkat unit | Tandakan setiap panggilan mengikut pelanggan, ciri dan tugasan | Masa kejuruteraan di awal | Sentiasa, sebelum perkara lain |
| Penghalaan dan lata | Cuba model lebih murah dahulu, tingkatkan apabila perlu | Risiko kualiti pada permintaan yang tersalah hala, kependaman tambahan | Permintaan dengan kesukaran bercampur pada volum yang bermakna |
| Pemangkasan prompt dan konteks | Hantar lebih sedikit token setiap panggilan | Kemungkinan kehilangan konteks berguna | Prompt panjang, pengambilan semula berlebihan, ejen yang terlalu banyak bercakap |
| Cache | Guna semula pengkomputeran terdahulu untuk input berulang | Data lapuk, usaha pengurusan cache | Awalan stabil, pertanyaan berulang atau hampir pendua |
| Pemprosesan berkelompok | Jalankan kerja tidak mendesak secara tak segerak dalam kelompok | Hasil tertangguh | Laporan, pengayaan, kerja pejabat belakang |
| Distilasi dan fine-tuning | Latih model lebih kecil dengan output model lebih besar | Usaha awal, keupayaan lebih sempit, penyelenggaraan | Tugasan yang stabil, bervolum tinggi dan jelas definisinya |
| Model open-weight atau pengehosan sendiri | Jalankan model pada infrastruktur anda sendiri | Beban operasi, risiko kapasiti | Beban berat yang boleh diramal, keperluan kawalan data |
| Had kadar dan had penggunaan | Hadkan penggunaan setiap pengguna atau akaun | Geseran bagi pengguna berat yang sah | Risiko penyalahgunaan, peringkat percuma, permintaan tidak sekata |
| Pagar harga | Terma penggunaan adil, kredit, lebihan | Geseran jualan, kerumitan | Kos yang sangat berbeza mengikut pelanggan |
| Tadbir urus | Belanjawan, amaran, pemilik yang dinamakan | Overhed proses | Sebaik sahaja perbelanjaan menjadi ketara |
Penghalaan dan lata: model kecil dahulu
Idea di sebalik lata adalah mudah. Kebanyakan permintaan adalah mudah, dan model murah mengendalikannya dengan baik. Sebahagian kecil adalah sukar dan memerlukan model yang lebih berkeupayaan dan lebih mahal. Jika anda dapat membezakan antara keduanya, atau mengetahuinya dengan murah, anda hanya membayar harga tinggi apabila ia berbaloi.
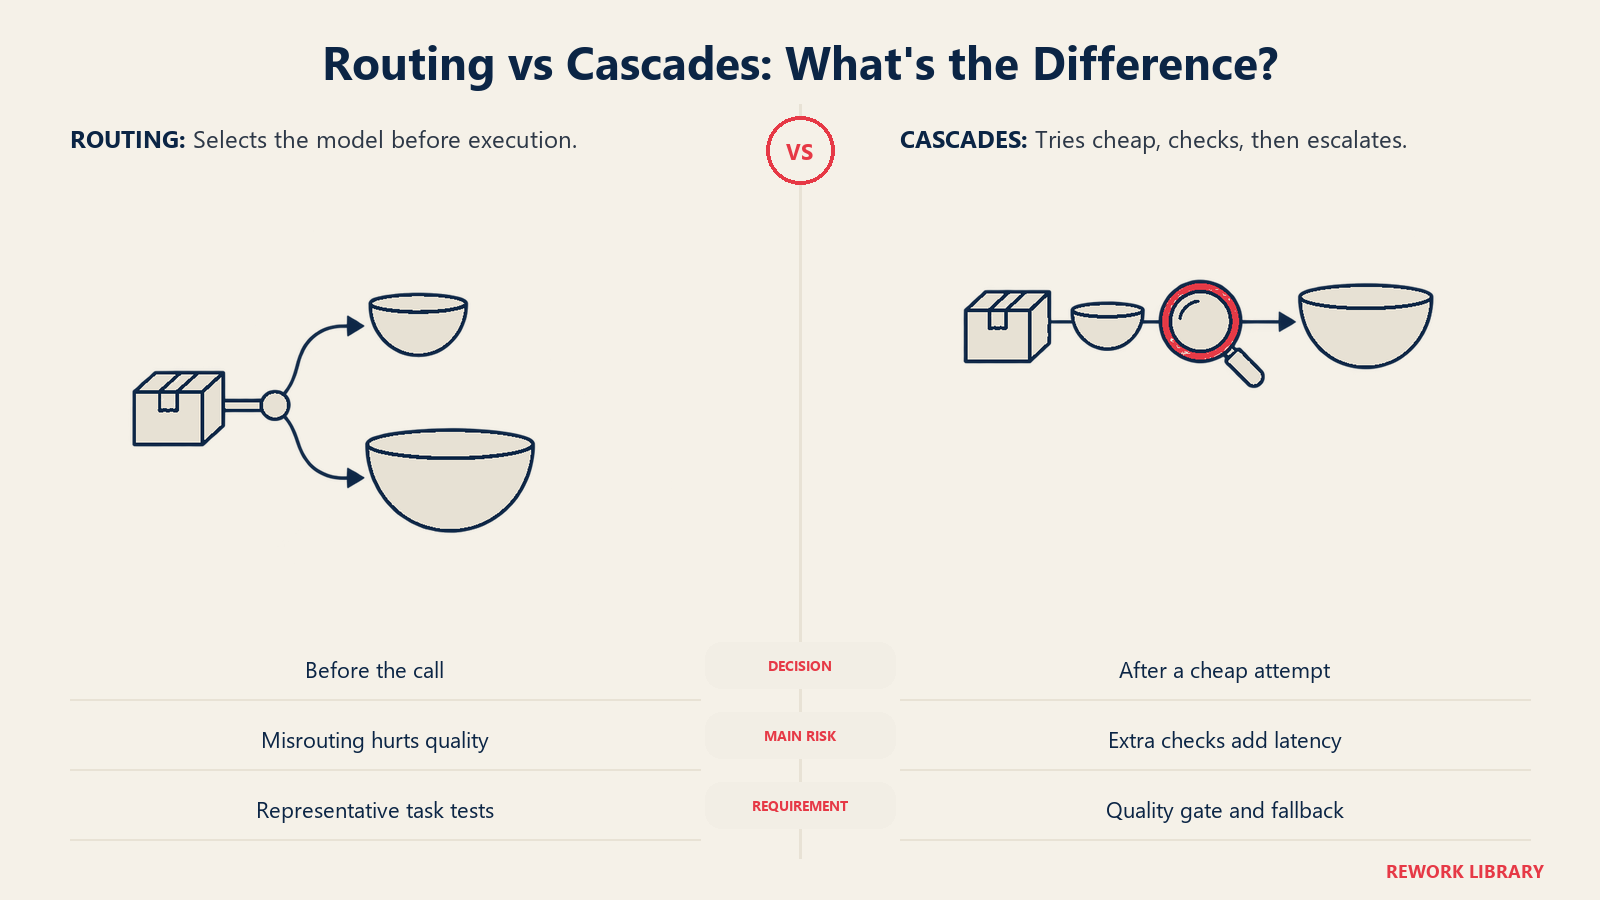
Terdapat dua bentuk biasa. Dalam lata, anda menghantar permintaan kepada model lebih murah dahulu, menyemak sama ada jawapannya cukup baik, dan meningkatkannya kepada model lebih kukuh hanya jika tidak. Dalam penghalaan, pengelas memutuskan di awal model mana yang patut mengendalikan permintaan, tanpa mencuba model murah dahulu.
Penyelidikan di sini berbaloi diketahui, dan angkanya patut dibaca dengan teliti. Kertas FrugalGPT mencadangkan lata merentasi model dan melaporkan bahawa pendekatan ini boleh menyamai prestasi model individu terbaik dengan pengurangan kos sehingga 98 peratus, atau meningkatkan ketepatan berbanding model itu sebanyak 4 peratus pada kos yang sama. Itu keputusan penulis pada penanda aras mereka, dengan perkataan "sehingga" memainkan peranan besar dalam dakwaan pertama. Beban kerja anda akan berbeza. Kertas RouteLLM melatih penghala menggunakan data keutamaan manusia dan melaporkan bahawa pendekatannya mengurangkan kos lebih daripada 2 kali ganda dalam kes tertentu tanpa menjejaskan kualiti respons, dan penghala itu terus berfungsi apabila model asas berubah semasa ujian.
Anggap kedua-duanya sebagai bukti bahawa tuil ini sebenar, bukan sebagai ramalan penjimatan. Pertukaran yang jujur adalah seperti berikut:
- Salah hala menjejaskan kualiti. Jika penghala menghantar permintaan sukar kepada model lemah dan tiada apa yang mengesannya, pelanggan mendapat jawapan yang buruk. Anda memerlukan cara untuk mengukur kualiti jawapan pada tugasan anda sendiri sebelum mempercayai penghala.
- Lata menambah kependaman. Permintaan yang gagal dalam cubaan murah membayar untuk panggilan murah, semakan, dan kemudian panggilan mahal. Bagi produk interaktif, kelewatan itu boleh menjadi penting.
- Penyemak juga ada kosnya. Menentukan sama ada jawapan cukup baik tidak percuma. Sesetengah pasukan menggunakan peraturan mudah, sesetengahnya model kecil, sesetengahnya isyarat keyakinan. Setiap satu mempunyai cara kegagalannya.
- Ia memerlukan set penilaian. Tanpa set tugasan yang mewakili dengan jawapan baik yang diketahui, anda tidak dapat mengetahui sama ada perubahan penghalaan membantu atau secara senyap memudaratkan.
Di peringkat syarikat, langkah praktikal ialah bermula di tempat kos tertumpu. Gunakan data peringkat unit anda untuk mencari satu atau dua jenis tugasan yang menyumbang sebahagian besar perbelanjaan, dan uji penghalaan di situ dahulu.
Pemangkasan prompt dan konteks
Kos berskala mengikut jumlah teks yang masuk dan keluar, jadi token paling murah ialah token yang tidak pernah anda hantar. Tuil ini cenderung dipandang rendah kerana ia terasa biasa, tetapi ia sering memberi pulangan dengan cepat.
Tempat biasa untuk diperiksa:
- Arahan yang membengkak. Prompt sistem mengumpul peraturan selama berbulan-bulan. Banyak yang boleh dipendekkan atau dibuang tanpa mengubah tingkah laku.
- Pengambilan semula berlebihan. Menarik sepuluh cebisan dokumen ke dalam konteks sedangkan tiga sudah memadai menaikkan kos pada setiap panggilan.
- Sejarah perbualan. Menghantar semula sejarah panjang pada setiap giliran boleh mendominasi kos. Meringkaskan giliran lama menukar sedikit ketepatan untuk penjimatan yang besar.
- Output yang meleret. Meminta respons berstruktur dan ringkas apabila produk membenarkannya mengurangkan perbelanjaan output.
Pertukarannya ialah memotong konteks boleh memotong kualiti dengan cara yang sukar dilihat. Anggap setiap perubahan pemangkasan sebagai eksperimen terhadap set penilaian anda, bukan kerja pembersihan. Prompt yang 30 peratus lebih pendek dan 5 peratus lebih buruk hanya satu kemenangan jika pelanggan anda tidak menyedarinya dan margin anda memang memerlukan bantuan.
Cache: jangan bayar dua kali untuk kerja yang sama
Cache terbahagi kepada dua jenis umum.
Cache prompt (awalan) membolehkan penyedia atau lapisan penyajian menggunakan semula pengkomputeran bagi permulaan prompt yang panjang dan stabil, seperti arahan dan dokumen rujukan, supaya panggilan berulang dengan awalan yang sama lebih murah. Ia memberi ganjaran kepada prompt yang distrukturkan dengan bahagian stabil dahulu dan bahagian yang berubah di akhir. Terma dan diskaun berbeza mengikut penyedia dan berubah dari semasa ke semasa, jadi semak dokumentasi semasa dan bukannya mempercayai angka dalam artikel.
Cache respons (semantik) menyimpan jawapan dan menyajikannya semula apabila permintaan baharu sama atau cukup hampir. Ia boleh menghapuskan panggilan model sepenuhnya. Risikonya ialah menyajikan jawapan lapuk atau salah secara halus kepada soalan yang hanya kelihatan serupa, dan ini masalah sebenar bagi apa sahaja yang diperibadikan, sensitif masa atau berisiko tinggi. Ia sesuai untuk soalan sempit dan berulang seperti pertanyaan sokongan biasa atau klasifikasi standard, dan kurang sesuai untuk penjanaan terbuka.
Cache paling sesuai di tempat data penggunaan anda menunjukkan pengulangan yang tinggi. Jika log bertanda anda menunjukkan awalan besar yang sama dihantar beribu-ribu kali sehari, cache patut diberi perhatian sebelum teknik yang lebih canggih.
Pemprosesan berkelompok: tukar kepantasan untuk harga
Tidak setiap permintaan memerlukan jawapan segera. Pengayaan malam, penjanaan laporan, klasifikasi pukal dan pembersihan pejabat belakang boleh dijalankan secara tak segerak dalam kelompok. Banyak penyedia mengenakan harga yang lebih rendah untuk pemprosesan tertangguh gaya kelompok berbanding pemprosesan masa nyata, dan pemprosesan berkelompok juga melancarkan beban pada infrastruktur anda sendiri. Pertukarannya ialah hasil tiba lebih lewat. Keputusannya ialah keputusan produk: kerja mana yang benar-benar tidak akan disedari pelanggan jika dijalankan semalaman? Senaraikannya, dan pindahkan apa yang boleh.
Distilasi dan fine-tuning: model lebih kecil untuk tugas yang sempit
Distilasi melatih model lebih kecil untuk meniru model lebih besar pada tugasan tertentu. Fine-tuning menyesuaikan model sedia ada dengan data anda. Kedua-duanya mensasarkan hasil yang sama: model lebih murah yang cukup baik dalam satu perkara yang anda perlukan.
Penyelidikan menyokong idea ini dalam had tertentu. Kertas "Distilling Step-by-Step" melaporkan bahawa model T5 dengan 770M parameter mengatasi model PaLM 540B parameter yang diberi prompt few-shot pada satu penanda aras sambil hanya menggunakan 80 peratus data latihan yang tersedia, dengan menggunakan rasional model lebih besar sebagai isyarat latihan tambahan. Itu keputusan pada satu penanda aras, tetapi ia menggambarkan prinsipnya: bagi tugasan yang jelas, model khusus kecil boleh bersaing dengan gergasi umum.
Pertukaran bagi sesebuah syarikat:
- Usaha di awal dan berterusan. Anda memerlukan data latihan, set penilaian, masa kejuruteraan dan rancangan untuk melatih semula apabila tugasan atau data berubah.
- Keupayaan lebih sempit. Model kecil melakukan satu tugas dengan baik dan mungkin gagal pada input di luarnya. Anda memerlukan laluan sandaran.
- Sasaran yang bergerak. Model umum terus bertambah baik dan semakin murah, jadi kelebihan model yang didistilasi boleh mengecil. Semak semula perbandingan secara berkala.
- Terma penggunaan. Sesetengah penyedia menyekat penggunaan output model mereka untuk melatih model lain. Semak terma sebelum anda membina saluran berdasarkan andaian itu.
Ia paling sesuai apabila tugasan stabil, bervolum tinggi, jelas definisinya dan mudah dinilai. Ia kurang sesuai bagi tugasan yang berubah setiap minggu atau yang memerlukan penaakulan luas.
Teknik berkaitan yang patut diketahui ialah penyahkodan spekulatif, di mana model kecil merangka token yang kemudian disahkan oleh model besar. Kertas asal melaporkan pecutan 2X hingga 3X berbanding pelaksanaan standard dengan output yang sama. Ia kebanyakannya dilaksanakan oleh penyedia penyajian atau pasukan infrastruktur anda, bukan keputusan produk, tetapi ia menjelaskan mengapa kos penyajian yang dihoskan sendiri terus menurun.
Model open-weight dan pengehosan sendiri berbanding API
Pada volum tertentu, pengasas bertanya sama ada mereka patut berhenti menyewa model melalui API dan menjalankan model open-weight pada infrastruktur sendiri. Ia soalan yang wajar, dan jawapannya jarang ya atau tidak secara jelas.
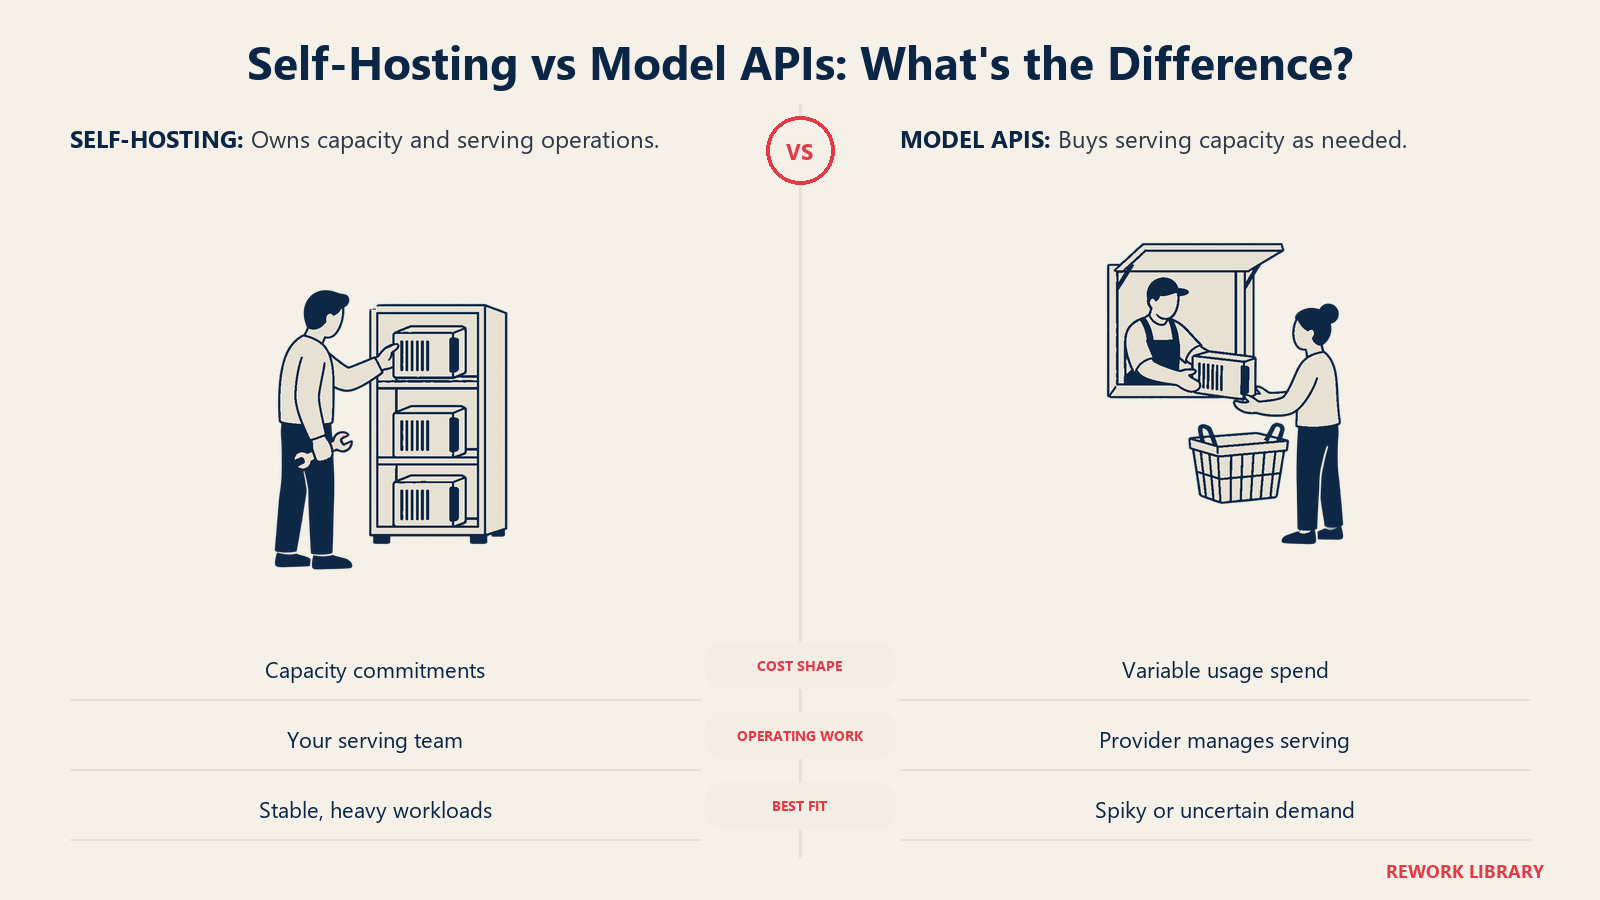
Apa yang boleh ditawarkan pengehosan sendiri: kos yang lebih boleh diramal pada volum tinggi dan stabil, kawalan ke atas lokasi dan pengendalian data, kebebasan untuk menyesuaikan, dan perlindungan daripada perubahan harga atau dasar penyedia.
Apa kosnya: anda mengambil alih perancangan kapasiti, perolehan GPU atau komitmen sewaan, kejuruteraan penyajian, pemantauan, keselamatan dan naik taraf. Kapasiti terbiar adalah pembaziran semata-mata, dan lonjakan permintaan boleh mengatasi kapasiti tetap. Anda juga menanggung jurang kualiti, jika ada, antara model terbuka dan model barisan hadapan.
Cara berguna untuk membingkainya: API menukar masalah kapasiti tetap kepada kos berubah, dan pengehosan sendiri menukarnya kembali. Jika permintaan anda tidak menentu atau masih tidak diketahui, kos berubah ialah satu kelebihan. Jika permintaan anda stabil dan besar, dan tugasan sesuai dengan model terbuka, kos tetap mungkin lebih menguntungkan, tetapi hanya selepas anda mengambil kira jurutera. Banyak syarikat akhirnya menggunakan pendekatan hibrid: menghoskan sendiri beban kerja bervolum tinggi yang difahami dengan baik, dan menggunakan API untuk ekor panjang dan permintaan paling sukar. Berapa banyak timbunan teknologi yang anda miliki juga pilihan strategik, bukan sekadar pilihan kos, dan lapisan aplikasi berbanding lapisan model membincangkan sisi itu.
Had kadar dan had penggunaan
Had teknikal melindungi anda daripada dua kejutan kos paling teruk: penyalahgunaan dan kemalangan. Peringkat percuma menarik orang yang akan menggunakan produk sekuat yang dibenarkan. Pepijat dalam integrasi pelanggan boleh berulang tanpa henti dan menghabiskan beribu-ribu panggilan dalam sejam.
Kawalan yang munasabah termasuk had kadar setiap pengguna dan setiap akaun, siling perbelanjaan harian atau bulanan yang mencetuskan semakan sebelum mencetuskan lebih banyak perbelanjaan, dan had keras pada akaun percuma dan percubaan. Reka bentuknya dengan memikirkan pelanggan. Had yang mengejutkan pelanggan berbayar ialah tiket sokongan dan risiko kehilangan pelanggan. Beri amaran pada 70 atau 80 peratus, terangkan apa yang berlaku apabila had dicapai, dan beri pentadbir cara untuk menaikkannya.
Pagar harga: biarkan harga menanggung sebahagian kos
Tuil kejuruteraan mengurangkan kos anda. Tuil harga mengubah siapa yang menanggungnya. Kedua-duanya patut berada dalam perbualan yang sama, kerana masalah margin sering boleh diperbaiki di sisi hasil lebih pantas berbanding di sisi kos.
Pagar biasa ialah:
- Dasar penggunaan adil pada pelan yang menyatakan "tanpa had," yang mentakrifkan maksud tanpa had secara praktikal.
- Peruntukan termasuk dengan lebihan, supaya penggunaan berat menghasilkan hasil dan bukan sekadar kos. Panduan kami tentang harga hibrid untuk produk AI menerangkan cara menetapkan saiz peruntukan dan kadar lebihan.
- Kredit, yang mengubah kos berubah yang tidak teratur kepada satu mata wang yang boleh dibajetkan pelanggan. Lihat harga berasaskan kredit.
- Meter yang terikat pada nilai, supaya hasil bergerak seiring dengan apa yang sebenarnya diperoleh pelanggan daripada produk dan bukannya aktiviti mentah.
Pertukarannya ialah geseran jualan dan kerumitan pengebilan. Pelanggan menyukai bil yang boleh diramal, dan setiap peraturan tambahan perlu diterangkan. Ujian yang baik ialah sama ada pelanggan anda yang paling mahal juga menguntungkan pada harga semasa. Jika data peringkat unit mengatakan tidak, itu masalah harga sebelum ia menjadi masalah kejuruteraan.
Tadbir urus: siapa pemilik angka ini
Tuil tidak menarik dirinya sendiri. Syarikat yang mengawal perbelanjaan model biasanya mempunyai beberapa perkara yang sama.
Pemilik yang dinamakan. Kos model merentasi kejuruteraan, produk, kewangan dan kadangkala kejayaan pelanggan. Apabila ia milik semua orang, ia tidak milik sesiapa. Pilih seorang yang bertanggungjawab, selalunya seseorang dalam kepimpinan kejuruteraan dengan rakan kongsi kewangan, dan berikan mereka papan pemuka.
Belanjawan mengikut bidang produk. Peruntukkan belanjawan perbelanjaan model kepada setiap ciri atau pasukan, dinyatakan dalam unit yang munasabah, seperti kos setiap tugasan atau bahagian hasil. Belanjawan mengubah tingkah laku kerana orang melihat akibat pilihan reka bentuk mereka.
Amaran, bukan sekadar laporan. Semakan bulanan menemui kos yang terlepas kawalan tiga puluh hari terlambat. Tetapkan amaran pada perbelanjaan harian, kos setiap tugasan dan penggunaan luar biasa di peringkat pelanggan.
Semakan sebelum pelancaran. Setiap ciri AI baharu mendapat anggaran kos sebelum dilancarkan: jangkaan panggilan setiap tugasan, jangkaan token, jangkaan kos setiap unit dan jangkaan harga. Ia senarai semak yang ringkas, dan ia mengelakkan cerita "kami melancarkannya dan margin hilang."
Kitaran tetap. Semak semula peraturan penghalaan, cache dan pilihan model setiap suku tahun. Pilihan terus berubah, dan konfigurasi terbaik tahun lepas jarang menjadi yang terbaik tahun ini.
Urutan tindakan yang munasabah
Jika anda bermula dari sifar, urutan kasar ini memastikan usaha seimbang dengan pulangan:
- Pasang pengukuran kos setiap tugasan, pelanggan dan ciri.
- Cari di mana perbelanjaan tertumpu dan pelanggan mana yang rugi.
- Pangkas prompt dan konteks, dan tambah cache di tempat pengulangan jelas.
- Pindahkan kerja tidak mendesak kepada pemprosesan berkelompok.
- Tambah penghalaan atau lata untuk jenis tugasan dengan perbelanjaan tertinggi, disokong oleh set penilaian.
- Tetapkan had, amaran dan terma penggunaan adil, dan perbaiki harga di tempat data menunjukkan jurang.
- Pertimbangkan distilasi atau pengehosan sendiri hanya untuk beban kerja yang stabil dan bervolum tinggi, dan hanya selepas tuil yang lebih murah telah digunakan sepenuhnya.
Urutan itu meletakkan langkah yang murah dan boleh diundur dahulu, dan langkah yang berat serta sukar diundur di akhir.
Fakta Utama
- Ukur kos pada unit yang anda jual (tugasan, pelanggan, ciri) sebelum mengoptimumkan. Satu invois penyedia tidak dapat memberitahu anda siapa yang tidak menguntungkan.
- Lata mencuba model lebih murah dahulu dan meningkatkan apabila perlu. Penulis FrugalGPT melaporkan menyamai model individu terbaik dengan pengurangan kos sehingga 98 peratus, atau meningkatkan ketepatan sebanyak 4 peratus pada kos yang sama.
- Penghala yang dilatih juga boleh memotong kos. Penulis RouteLLM melaporkan pengurangan kos lebih daripada 2 kali ganda dalam kes tertentu tanpa menjejaskan kualiti respons.
- Distilasi boleh menghasilkan model kecil khusus tugasan. Satu kajian melaporkan model 770M parameter mengatasi model 540B parameter yang diberi prompt few-shot pada satu penanda aras, menggunakan 80 peratus data latihan yang tersedia.
- Penyahkodan spekulatif mempercepatkan penyajian model besar. Penulisnya melaporkan pecutan 2X hingga 3X dengan output yang sama.
- Keputusan penyelidikan datang daripada penanda aras tertentu. Sahkan setiap tuil terhadap set penilaian anda sendiri sebelum bergantung pada penjimatan.
- Tuil harga (peruntukan, lebihan, kredit, penggunaan adil) memindahkan kos kepada pihak yang menciptanya, dan sering lebih pantas dilaksanakan berbanding perubahan kejuruteraan.
- Setiap baris kos memerlukan pemilik yang dinamakan, belanjawan dan amaran.
Soalan Lazim tentang Mengurus Kos Model AI
Apakah perkara pertama yang perlu dilakukan apabila kos model mula meningkat?
Ukur kos setiap tugasan, setiap pelanggan dan setiap ciri dengan menandakan setiap panggilan model. Satu invois tidak dapat menunjukkan pelanggan atau ciri mana yang memacu perbelanjaan. Setelah anda dapat melihat ke mana wang pergi, anda boleh memilih tuil yang sesuai dan bukannya meneka.
Apakah lata model, dan berapa banyak yang boleh dijimatkan?
Lata menghantar permintaan kepada model lebih murah dahulu dan meningkatkannya kepada model lebih kukuh hanya apabila jawapan pertama tidak cukup baik. Kertas FrugalGPT melaporkan menyamai model tunggal terbaik dengan pengurangan kos sehingga 98 peratus pada penanda arasnya. Penjimatan sebenar bergantung pada campuran permintaan mudah dan sukar anda, jadi uji pada tugasan anda sendiri.
Adakah cache selamat untuk produk AI?
Cache prompt, yang menggunakan semula permulaan prompt yang stabil, tidak mengubah jawapan. Cache respons, yang menyajikan jawapan tersimpan kepada soalan serupa, boleh mengembalikan hasil yang lapuk atau tidak sepadan, jadi gunakannya untuk pertanyaan sempit dan berulang serta elakkannya untuk pertanyaan yang diperibadikan atau sensitif masa.
Bilakah masuk akal untuk menghoskan sendiri model open-weight dan bukannya menggunakan API?
Biasanya apabila volum tinggi dan stabil, tugasan sesuai dengan model terbuka, dan anda mempunyai kapasiti kejuruteraan untuk menjalankannya. API menukar kapasiti kepada kos berubah, yang sesuai untuk permintaan tidak pasti atau tidak menentu. Banyak syarikat akhirnya menggunakan pendekatan hibrid, menghoskan sendiri beban kerja berat yang boleh diramal dan menggunakan API untuk selebihnya.
Bolehkah harga menyelesaikan masalah kos model?
Selalunya, ya. Peruntukan termasuk dengan lebihan, kredit dan terma penggunaan adil memindahkan kos penggunaan berat kepada pelanggan yang menjananya. Jika pelanggan anda yang paling mahal tidak menguntungkan pada harga semasa, itu jurang harga yang perlu ditutup sebelum, atau seiring dengan, kerja kejuruteraan.
Siapakah yang patut memiliki kos model dalam syarikat?
Seorang yang dinamakan, biasanya dalam kepimpinan kejuruteraan dengan rakan kongsi kewangan. Berikan mereka papan pemuka kos setiap unit, belanjawan mengikut bidang produk dan amaran tentang perbelanjaan luar biasa. Pemilikan bersama tanpa seorang pemilik yang bertanggungjawab cenderung bermakna tiada sesiapa yang bertindak.
Bacaan Berkaitan

Co-Founder & COO
On this page
- Mulakan dengan keterlihatan, bukan pengoptimuman
- Jadual tuil
- Penghalaan dan lata: model kecil dahulu
- Pemangkasan prompt dan konteks
- Cache: jangan bayar dua kali untuk kerja yang sama
- Pemprosesan berkelompok: tukar kepantasan untuk harga
- Distilasi dan fine-tuning: model lebih kecil untuk tugas yang sempit
- Model open-weight dan pengehosan sendiri berbanding API
- Had kadar dan had penggunaan
- Pagar harga: biarkan harga menanggung sebahagian kos
- Tadbir urus: siapa pemilik angka ini
- Urutan tindakan yang munasabah
- Fakta Utama
- Bacaan Berkaitan