AIにおけるアプリケーション層とモデル層の違い
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
AIスタートアップはどれも、スタックのどこかに位置しています。チップやデータセンターを作る企業もあれば、他のみんなが借りる大規模モデルを学習させる企業もあります。そうしたモデルをツールに組み込む企業もあれば、トークンという言葉を聞いたこともない顧客に完成した製品を売る企業もあります。どの層を選ぶかによって、必要な資本の額、コストが下がる速さ、そして誰がまねできるかが決まります。
「アプリケーション層とモデル層」という言い方は、この地図で最も重要な選択を縮めて表したものです。モデル層は費用がかかり、規模がものをいい、巨大企業がひしめいています。アプリケーション層は参入コストが低く、顧客に近い一方で、別のリスクにさらされています。下の層が、可能なことを一夜で変えてしまうことがあるのです。
この記事では、4つの層、それぞれの層で競争するのにかかるコスト、そしてベンチャー投資家や研究者が価値は各層にどう広がると論じてきたかを整理します。B2B企業を経営していてAIを使った開発を検討している方や、この分野のスタートアップを評価している方にとって、頭に入れておくべき地図です。
生成AIスタックの4つの層
スタックの分析の多くは、インフラ、モデル、アプリケーションの3層を使います。a16zは2023年1月に、まさにこの区分を示しました。モデルをユーザーに届けるアプリケーション、モデルそのもの(プロプライエタリなAPIまたはオープンソースのチェックポイントとして提供)、そして学習と推論を動かすクラウドプラットフォームとハードウェアメーカーのインフラです。
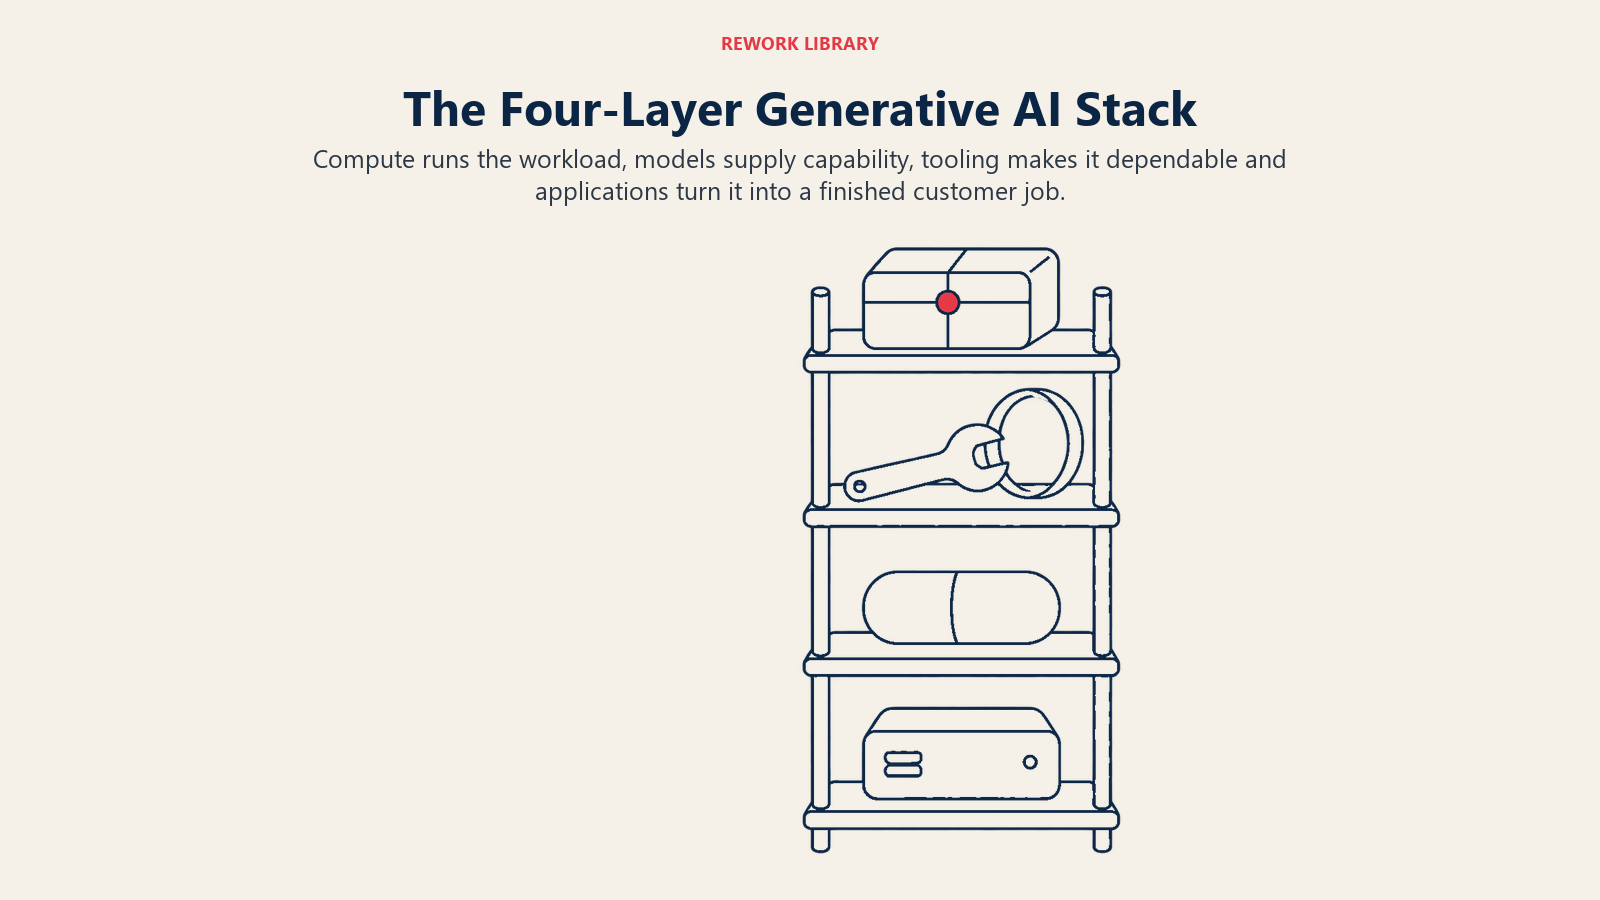
実際には、中間に第4の層が育ってきました。生のモデルを実際の仕事につなぐツールの層で、検索、オーケストレーション、評価、ガードレール、そしてモデル呼び出しを信頼できるワークフローに変える配管にあたる部分です。これを切り出すと全体像が明確になります。多くのスタートアップがここにいるからです。
| 層 | 売るもの | 典型的な顧客 | 資本集約度 | 主なリスク |
|---|---|---|---|---|
| コンピュートとインフラ | チップ、クラウドの容量、学習と推論のホスティング | モデルの開発企業、大企業 | 非常に高い | 価格のコモディティ化、ハードウェアの減価 |
| 基盤モデル | APIまたはオープンウェイトで提供する汎用モデル | 開発者、ツール企業、大企業 | 非常に高い | 急速な模倣、能力あたりの価格の下落 |
| ツールとオーケストレーション | 検索、エージェントのフレームワーク、評価、モニタリング | 開発者とプロダクトチーム | 中程度 | モデルやクラウドに吸収されること |
| アプリケーション | 特定の仕事を解決する完成した製品 | ビジネスユーザーと消費者 | 低〜中程度 | リテンション、差別化、利益率の圧迫 |
注目すべき点が2つあります。1つ目は、上へ行くほど資本集約度が下がること。2つ目は、投入物に対する支配力も下がることです。アプリケーション企業は、使うモデルのコストを決められず、自社が売っているまさにそのタスクをモデルがより上手にこなせるようになることも、止められません。
各層が実際に担うこと
コンピュートとインフラ。 この層は、他のすべてを可能にする物理的な、そしてクラウド上の容量を提供します。規模がものをいう世界で、巨大なバランスシートを持つ少数の企業、長いハードウェアのリードタイム、上の層に左右される需要が特徴です。ハードウェアやモデルの効率的な提供に本当に異なるアプローチを持ち込まない限り、スタートアップがここで勝つことはまれです。
基盤モデル。 幅広いデータで学習させた、大規模で汎用のモデルです。スタックの中で最もエンジンに近い存在です。ラボが1つのモデルを学習させ、数千のユースケースに向けてそのアクセス権を売ります。同じモデルが多くの買い手にサービスを提供するため、少なくとも最先端においては、最も多くの資本、計算資源、人材を持つ者が報われる経済構造です。
ツールとオーケストレーション。 ミドルウェアにあたる層です。典型的な例は、モデルの回答が正確かどうかをチームが評価するのを支援する企業や、顧客の文書をモデルに与える検索パイプラインを管理する企業です。顧客はエンドユーザーではなく開発者であり、その命運は、開発者がどれだけいるかに結びついています。
アプリケーション層。 ここでの製品は、モデルではなく、完了した仕事です。サードパーティの基盤モデルの上に作られた契約書レビューツール、企業のヘルプセンターで学習させたサポートアシスタント、エディタに組み込まれたコーディングアシスタント。それぞれが、モデルの能力を、企業が実際に購入するワークフロー、ユーザーインターフェース、データ接続の中に包んでいます。この層の最も薄いものがどう批判されるのかについては、AIラッパーとAIネイティブの違いで取り上げています。
スタートアップが競う場所とそのコスト
参入コストは、桁違いに異なります。Epoch AIは2024年6月に、最先端モデルの最終学習実行にかかるハードウェアとエネルギーの償却コストが2016年以降、年率2.4倍で増加してきたと推定し、最大規模の学習実行のコストは2027年までに10億ドルを超えるだろうと警告しました。主要モデルについてEpochが示した内訳では、開発コストの47〜67%がハードウェア、29〜49%が人件費、2〜6%がエネルギーです。これは2024年時点の予測なので、現在の価格ではなく方向性として捉えてください。ただ、この方向性は、基盤層が今のような姿になっている理由を説明します。潤沢な資金を持つ少数のラボと、大企業が支援するオープンウェイトの取り組みです。
20人のチームを抱え、シードまたはシリーズAの資金調達をした一般的な創業者にとって、この計算は最先端モデルの開発競争を除外します。残るのはアプリケーション層とツール層、そしてモデル層のより安価な周縁(小規模な特化型モデル、オープンウェイトのファインチューニング)です。モデルを適応させるか、プロンプトで制御するかを検討しているなら、エージェントのファインチューニングとプロンプティングの比較がその判断を順に説明しています。
アプリケーション層のほうが手が届きやすく感じられるのはなぜでしょうか。その下で、能力の価格が下がり続けているからです。Stanford AI Indexは2025年版で、2023年初頭の最先端クラスのモデルに匹敵するシステムの推論コストが、2022年11月から2024年10月の間に280倍以上低下したこと、そしてハードウェアのコストが年率30%で低下していることを報告しました。2022年には採算が合わなかった製品が、出荷する頃には黒字になりえます。最新版は、産業界が注目すべき最先端モデルの90%以上を生み出していることを示しており、最先端を押し広げるために誰が支出しているのか、そして市場のそれ以外の部分がなぜそれを所与の投入物として扱うのかが分かります。
重要なポイント: AIスタックの各層
- a16zの初期の分析では、インフラのベンダーがスタックを流れるお金の大半を獲得している一方で、アプリ企業はリテンション、差別化、粗利益率に苦戦していました(2023年1月公開)。
- 同じ分析は、アプリ企業が売上の約20〜40%を推論と顧客ごとのファインチューニングに支出しており、粗利益率は一部で90%に達するものの、50〜60%のことのほうが多いと報告しました。
- エンタープライズの生成AI支出は2025年に370億ドルに達し、2024年の115億ドルから増加しました。そのうち190億ドルがアプリケーション層、180億ドルがインフラ層に向かいました(Menlo Ventures、2025年12月)。
- 同じMenlo Venturesのレポートによると、2025年のエンタープライズ支出のうち、基盤モデルのAPIが125億ドルを占めました。
- 最先端モデルの学習コストは、2016年以降、年率約2.4倍で増加しています(Epoch AI、2024年6月)。
- 2023年初頭の最先端クラスの性能を得るための推論コストは、2022年11月から2024年10月の間に280倍以上低下しました(Stanford AI Index 2025)。
価値はどう蓄積すると論じられてきたか
率直に言えば、議論は動いてきましたし、今も動いています。3つのスナップショットが、その変化を示しています。
2023年初頭: まずインフラが勝つ。 上で挙げたa16zの分析は、ここまでの最大の勝者はおそらくインフラのベンダーだと結論づけました。アプリケーションは売上の伸びは力強かったものの、リテンション、製品の差別化、粗利益率に苦戦しており、モデルのプロバイダーはまだ大きな商業規模に達していませんでした。その時点では、スタックを流れるお金は、ほとんどが一番下で止まっていました。
2023年後半: アプリ層には独自の参入障壁が必要。 SequoiaのGenerative AI's Act Two(2023年9月)は、著者らがアプリケーション企業と基盤モデル企業ははっきり分かれていくと予想していたものの、そうはなっておらず、ユーザー向けアプリケーションで最初から最も成功したものは垂直統合型だったと述べました。次世代の基盤モデルがデータの参入障壁を消し去りうるため、ワークフローとユーザーのネットワークのほうが、データよりも持続的な優位性を生むようだと論じました。弱いリテンションにも言及しており、生成AIアプリの中央値はDAU/MAU比が14%で、最高のコンシューマー向けアプリを大きく下回っていました。
2024年半ば: インフラの請求書は支払わなければならない。 SequoiaのAI's $600B Question(2024年6月)は、GPUに投じられている資本が、AI製品が生み出している売上を大きく上回っていると論じ、年間約5,000億ドルのギャップがあると説明しました。価値についての主張は、計算資源の価格下落は開発者と長期的なイノベーションにとっては好ましいが、価格が維持されることに賭けた投資家にとっては好ましくない、というものでした。
2025年後半: 支出はアプリへ流れている。 Menlo Venturesの2025年のエンタープライズレポートは、エンタープライズの生成AI支出の過半、370億ドルのうち190億ドルがアプリケーション層に向かったことを明らかにしました。その内訳は、ホリゾンタルAIが84億ドル、部門別AIが73億ドル、バーティカルAIが35億ドルです。AIの買い手の転換率は47%で、従来のソフトウェアの25%を上回ることも分かりました。
これらのスナップショットを並べると、暫定的ではあるものの、役に立つパターンが見えてきます。初期には、お金は希少な投入物がある場所に集まりました。投入物が安くなり、モデルが十分に優れたものになるにつれ、エンタープライズの予算は、仕事を完結させる製品へと移りました。これらの情報源はどれも未来の予測ではなく、それぞれ1社の見解であり、答えに利害関係を持つことも少なくありません。それでも、方向性は計画に織り込めるほど一貫しています。
各層の経済性
上記の情報源と標準的なユニットエコノミクスの考え方に基づく、各レベルでお金がどう動く傾向にあるかを示します。
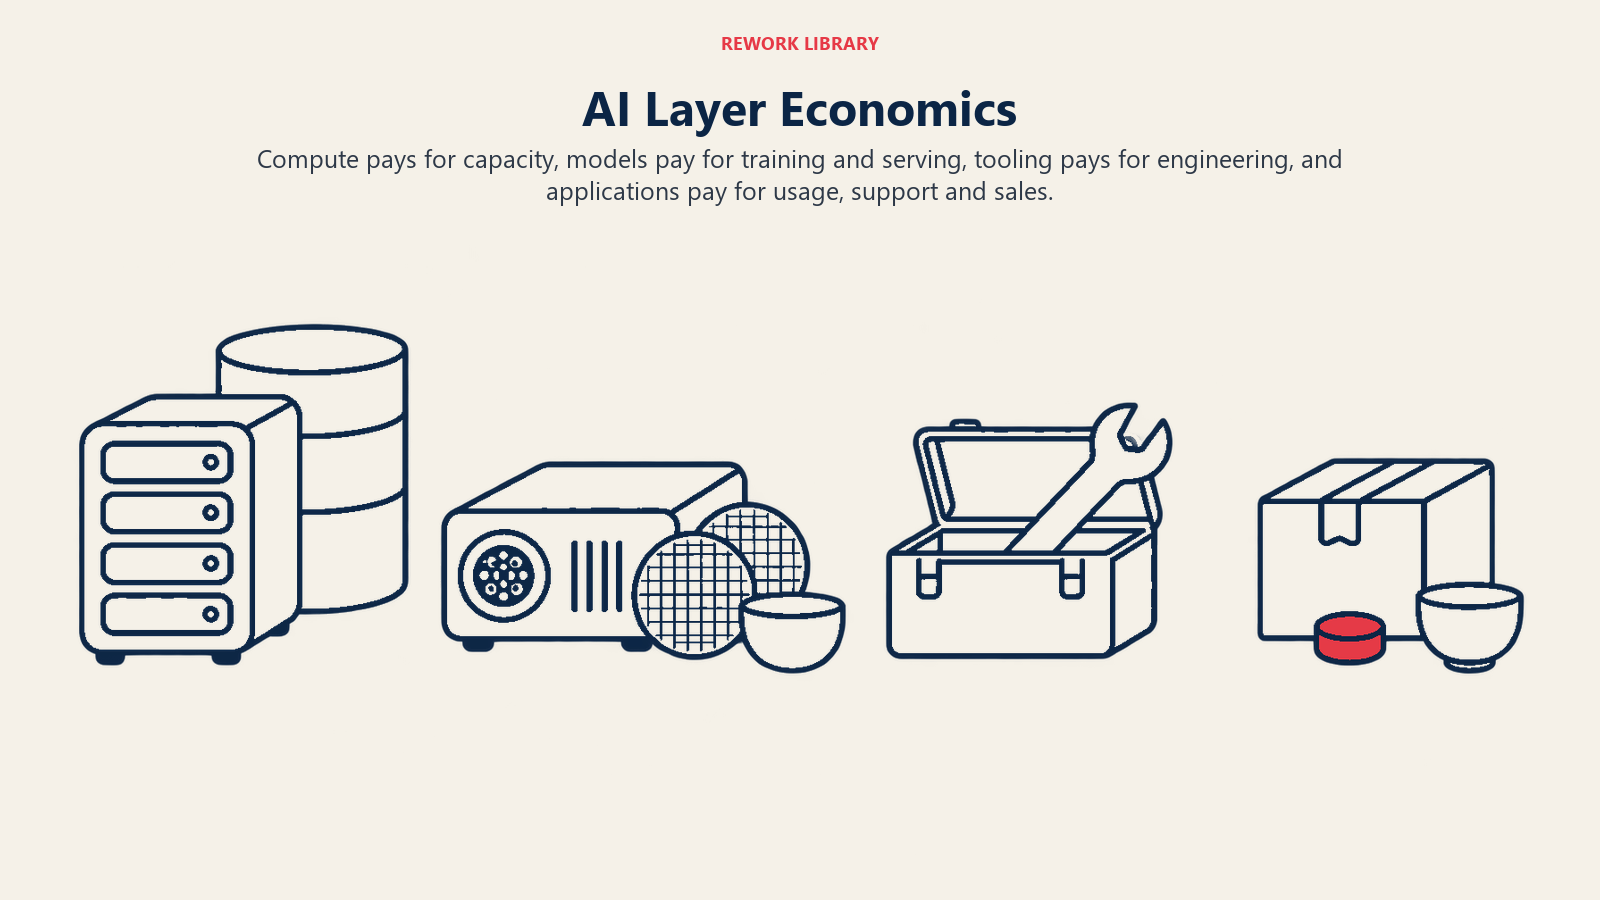
| 層 | 売上の形 | コストの形 | 利益率を決めるもの |
|---|---|---|---|
| コンピュートとインフラ | 従量課金、大型契約 | 巨額の先行資本、ハードウェアの減価 | 稼働率と価格決定力 |
| 基盤モデル | APIの利用、ライセンス | 学習の実行、人件費、提供コスト | 規模、効率、能力の差別化 |
| ツールとオーケストレーション | サブスクリプション、利用量に応じた段階 | エンジニアリング中心、クラウド支出は中程度 | 独立した製品であり続けるかどうか |
| アプリケーション | シート、従量、成果 | 顧客ごとのモデル利用、サポート、営業 | モデルのコストをどこまで転嫁できるか |
アプリケーション企業にとって最も重要な数字は粗利益率です。ソフトウェアは歴史的に、70%台から80%台の利益率が評価されてきました。AI製品は、リクエストのたびにモデルを呼び出すため、利用ごとに変動費がかかります。だからこそ、a16zが初期に見いだした、売上の20〜40%が推論とファインチューニングに向かうという結果が重要でした。従来のソフトウェアの利益率の構造が、そのまま当てはまるわけではないことを意味したからです。それが今でも適切なレンジかどうかは、製品、モデルの組み合わせ、利用量の価格設定によるため、評価する企業ごとに最新の数字を確認してください。
もう1つの効果があります。モデル層は能力あたりの単価が下がっているため、アプリケーションのコストは、自社で何もしなくても下がりえます。しかし、競合のコストも下がり、顧客が受け入れる価格も下がります。投入物の価格の下落はアプリケーション層のあらゆる参入者を助けるので、差別化はモデルそのもの以外のところから生まれることになります。
アプリケーション層かモデル層か: 選び方
この判断は、3つの問いとして考えてください。
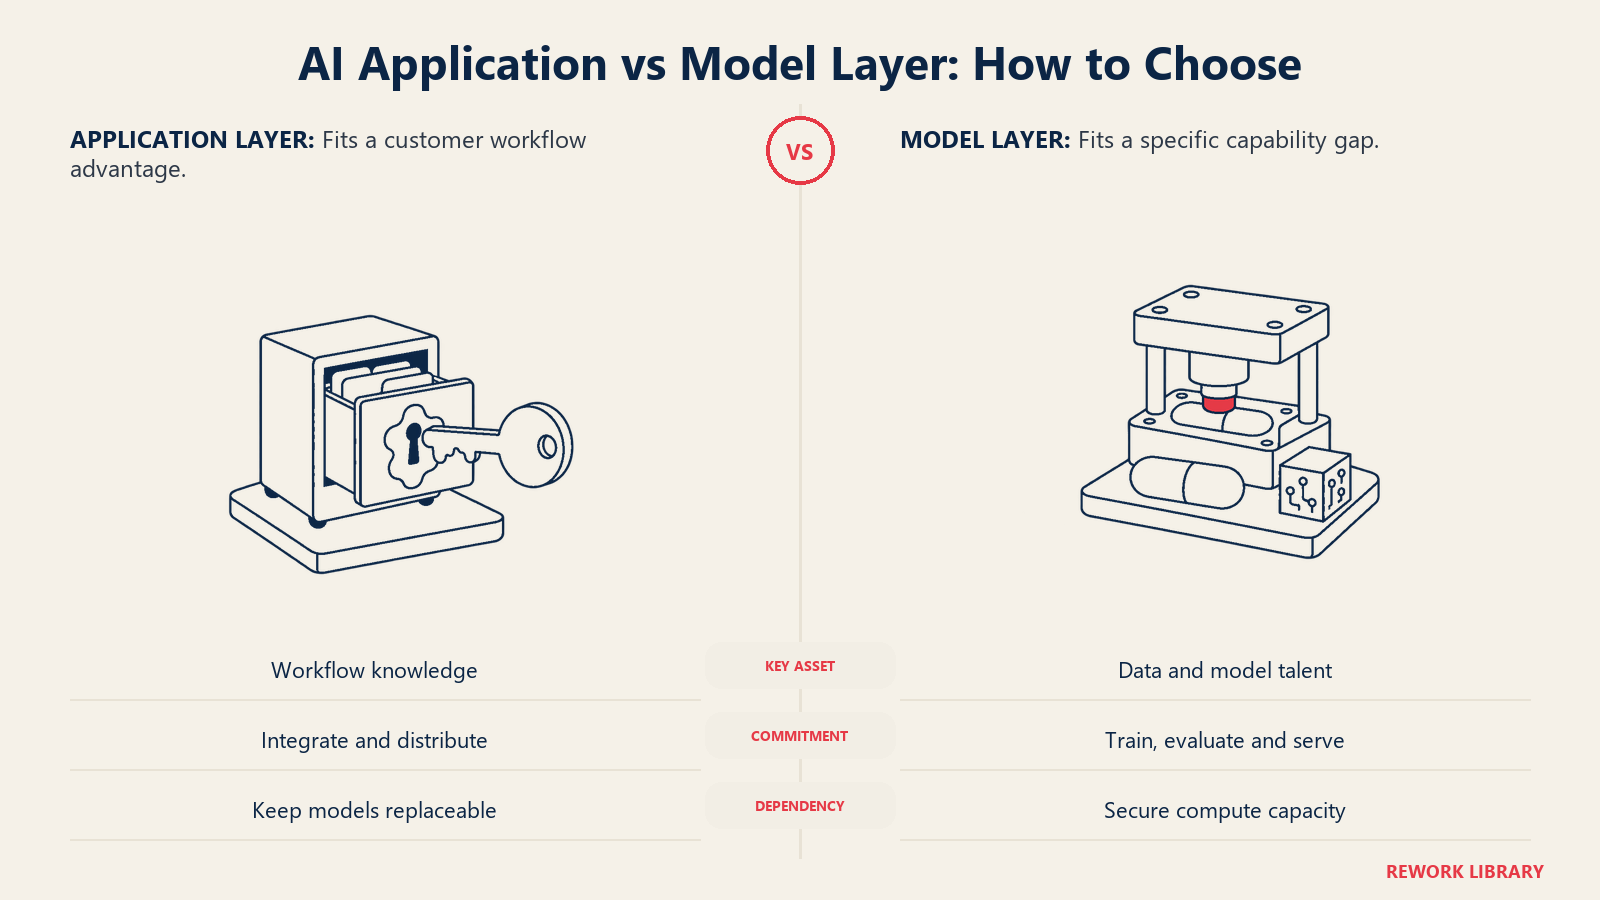
モデルを自社で持つ理由はあるか。 御社の強みが、汎用モデルでは提供できない能力にあるなら、たとえば独自のデータを持つ狭い領域で、レイテンシーやプライバシーを厳密に制御する必要があるなら、特化型またはファインチューニングしたモデルがスタックに含まれるべきかもしれません。強みが顧客のワークフローの理解にあるなら、通常はモデルを借りるほうが良い選択です。トレードオフは、SaaSのAI機能は購入か構築かで扱っています。
持続的な優位性はどこにあるか。 ワークフローとユーザーのネットワークについてのSequoiaの議論は、アプリケーション層を指しています。そこでは優位性が、販路、顧客のシステムとの連携、時間をかけて築いた信頼から生まれます。モデルの優位性は、次のリリースで追いつかれます。チームの日常業務に組み込まれたワークフローは、はるかに置き換えにくいものです。この考え方の土台となるフレームワークは、競争上のポジショニングをご覧ください。
下の層にどれだけ依存しているか。 あらゆるアプリケーションはモデルのサプライヤーに依存し、あらゆるモデル開発企業は計算資源に依存しています。自社製品のバリューチェーンを描いてみると、どのサプライヤーなら入れ替えられ、どれは入れ替えられないかが分かります。モデルを切り替えられる企業は交渉力を保てますが、切り替えられない企業は、価格の改定1つで利益率の問題に直面します。
役に立つテストがあります。製品の土台のモデルが来四半期に10倍優れたものになったら、御社の事業は強くなるでしょうか、それとも消えるでしょうか。ワークフロー、顧客との関係、データを自社が持っているために強くなるのなら、持続的なアプリケーションを築いています。製品全体が1つの巧みなプロンプトだったために消えるのなら、脆いものを築いています。後者のケースは、AIラッパーとAIネイティブの違いで検討しています。
層と焦点: バーティカルとホリゾンタル
どの層を選ぶかは、1つの軸です。もう1つの軸は幅です。ホリゾンタルなアプリケーションは、業界を横断して1つの機能に対応し、バーティカルなアプリケーションは、1つの業界を深く支援します。Menloの2025年の内訳は、どちらにも実際の予算があることを示しており、ホリゾンタルが84億ドル、バーティカルが35億ドルです。両者の比較はバーティカルAIとホリゾンタルAIの違いで、各層がどう収益を上げるかはAIスタートアップのビジネスモデルで扱っています。
スタックについてのよくある誤解
「モデル層がすべてを奪う。」 ラボがあらゆるユースケースを吸収すると考えたくなります。Sequoiaの分析は逆を指しています。最も成功したアプリケーションは垂直統合型であり、ワークフローとユーザーを握ることが、モデルと同じくらい重要であることを示唆しています。ただし、薄い製品にとってリスクは現実のものです。モデルがあるタスクで優れてくると、その隙間の上に築いた製品が消えてしまうことがあるからです。
「アプリケーション層は、ただのラッパーだ。」 そうしたアプリケーションもあります。しかし、多くはそうではありません。企業のシステムに組み込まれ、そのコンテキストを蓄積し、プロセスを学習する製品は、モデルにテキストを渡すだけでなく、はるかに多くのことをしています。この批判は、最も薄いケースには的確で、それ以外には不当です。
「インフラが常に勝つ。」 2023年の分析は、インフラが大半のお金を獲得していると見ており、それはその時点では正しいものでした。しかし2024年の分析は、売上の基盤がまだ支出に追いついていないと論じ、2025年のデータは、エンタープライズの予算がアプリケーションに傾いていることを示しています。スタック上の位置づけは、時間とともに移り変わります。
「1つの層を選んで、そこに留まる。」 多くの企業が、複数の層にまたがっています。バーティカルなアプリケーションが小規模なモデルをファインチューニングすることも、モデル企業が自社のアプリケーションを出荷することもあります。スタックは、依存関係と経済性を理解するための手段であり、壁の集まりではありません。
創業者にとっての意味
層ではなく、顧客の仕事から始めてください。最小の資本で、最も持続的な強みを持って、その仕事を解決できる層を選び、周囲の層が変わることを前提に設計します。モデルのサプライヤーは入れ替え可能にしておき、初日から顧客ごとの粗利益率を測り、より優れたモデルにもまねできない部分を築いてください。連携、ワークフロー、データの位置づけ、そして関係です。
スタックは動く標的でもあります。能力あたりの単価は下がり、有能なモデルの数は増え、エンタープライズの予算は、仕事を完結させる製品へ移っています。層の選択は、少なくとも年に一度は見直してください。
関連記事
AIのアプリケーション層とモデル層に関するよくある質問
AIのアプリケーション層とモデル層の違いは何ですか。
モデル層は、多くの製品が使える汎用モデルを学習させて提供します。アプリケーション層は、モデルの能力を、ワークフロー、インターフェース、顧客データとの接続を備えた、特定の仕事のための完成した製品に包みます。モデル企業は能力を売り、アプリケーション企業は成果を売ります。
AIスタートアップは通常どこで競っていますか。
最先端モデルの学習は資本負担が大きいため、ほとんどのスタートアップはアプリケーション層とツール層で競っています。Epoch AIは、最先端モデルの学習コストが2016年以降、年率2.4倍で増加してきたと推定し、2027年までに10億ドルを超える学習実行を見込みました。小規模なチームは通常、モデルを借りるか、オープンなモデルをファインチューニングします。
どの層が最も多くの価値を獲得しますか。
時期と情報源によります。a16zは2023年初頭に、インフラのベンダーが大半のお金を獲得していると結論づけましたが、Menlo Venturesは2025年後半に、エンタープライズの生成AI支出370億ドルのうち190億ドルがアプリケーションに向かったと明らかにしました。どちらも1社の見解ですので、確定した事実ではなく、証拠として扱ってください。
AIアプリケーションは、モデルのラッパーにすぎないのですか。
そうしたものもあり、モデルが改良されたときに最も影響を受けます。顧客のシステムに組み込まれ、ワークフローを学習し、データを保持するアプリケーションもあり、モデルのアップグレードでは消えない優位性を持ちます。製品が脆いか持続的かは、モデル以外に何を自社で持っているかによります。
AIアプリケーションの粗利益率が従来のソフトウェアと異なるのはなぜですか。
利用のたびにモデルが呼び出され、変動費が生じるためです。a16zは2023年初頭に、アプリ企業が売上の約20〜40%を推論と顧客ごとのファインチューニングに支出しており、粗利益率は90%よりも50〜60%のことのほうが多いと報告しました。現在の数字は製品と価格設定によって異なるため、企業ごとに確認してください。
スタートアップは、自社でモデルを構築すべきですか。
汎用モデルでは必要な能力を提供できず、それを維持するデータ、人材、資本がある場合に限ります。ほとんどのB2B製品では、モデルを借りてその周りにワークフローを構築するほうが、安く、速く進められます。利用によって必要性が証明されれば、後からモデルを特化させることもできます。
