Costos de inferencia y margen bruto en las empresas de IA
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
El software tradicional tiene una particularidad afortunada: una vez construido el producto, atender a un cliente más no cuesta casi nada. Por eso los márgenes brutos del software se convirtieron en lo que admiraban los inversionistas. Los productos de IA rompen esa particularidad. Cada vez que un cliente le pide al producto que haga algo, se ejecuta un modelo, y ejecutar un modelo cuesta dinero real. Ese costo se llama inferencia, y es la razón principal por la que el margen bruto de una empresa de IA puede no parecerse en nada al de una empresa de software clásica.
Este artículo explica la mecánica: qué es la inferencia, por qué se comporta como un costo variable, cómo el costo de una sola solicitud se convierte en una cifra de margen, por qué un puñado de usuarios intensivos puede arruinar el promedio y cómo su modelo de precios decide quién absorbe el riesgo. Está escrito para fundadores y CEO propietarios de empresas B2B con equipo. El ejemplo práctico usa cifras redondas e hipotéticas y no refleja el precio de ningún modelo real.
Para ver cómo se clasifican estos costos en el estado de resultados, consulte cómo contabilizan el COGS las empresas de IA. Para conocer formas de reducirlos, consulte gestión de costos de modelos de IA. Este texto se limita a cómo funcionan los costos y cómo llegan al margen.
Entrenamiento frente a inferencia
Dos actividades distintas consumen cómputo en un negocio de IA, y se comportan de forma muy diferente.
El entrenamiento consiste en construir o adaptar un modelo. Ocurre antes de atender a los clientes (o de forma periódica en paralelo). Es caro, irregular y en gran medida independiente de cuántas personas usen su producto. Si usted construye su propio modelo, una ejecución de entrenamiento se parece más a un proyecto de desarrollo que a un costo de entregar una venta.
La inferencia consiste en ejecutar un modelo ya entrenado para producir una respuesta. Ocurre cada vez que un cliente realiza una acción. Si usted hace fine-tuning de un modelo o llama al de otro proveedor, se aplica la misma división: construir la capacidad es un costo y servirla es otro.
La distinción importa porque ambos escalan en ejes distintos. El costo de entrenamiento escala según lo ambicioso que sea el modelo. El costo de inferencia escala según cuánto lo usan sus clientes. Una startup que vende un producto de IA a más clientes, o que logra que los clientes existentes lo usen más, no aumenta su factura de entrenamiento. Aumenta su factura de inferencia, casi en la misma proporción.
Por eso la inferencia es el costo que aparece en el margen bruto. Se incurre en el acto de entregar el producto y sube cuando sube la entrega.
Por qué la inferencia se comporta como un costo variable
En un producto de software clásico, el costo marginal de una solicitud es insignificante. Usted paga servidores por bloques y el tráfico llena esos bloques. En un producto de IA, cada solicitud realiza su propio bloque de cómputo, y el tamaño de ese bloque depende de qué sea la solicitud. Varios factores lo determinan.
Tokens de entrada y tokens de salida. Los modelos de lenguaje leen y escriben texto en unidades pequeñas llamadas tokens. Una pregunta corta con una respuesta corta es barata. Un documento largo con un resumen largo no lo es. Tanto los proveedores como las instalaciones propias suelen tratar de forma distinta el lado de lectura (la entrada) y el de escritura (la salida), y las salidas largas por lo general cuestan más de producir que lo que cuesta leer la misma cantidad de entrada.
Longitud del contexto. Muchos productos añaden material extra a cada solicitud: la conversación hasta ese momento, documentos recuperados, instrucciones, ejemplos. Ese contexto se vuelve a leer cada vez. Un chat que lleva veinte turnos cuesta más por mensaje que el primer mensaje, porque todo el historial viaja con él.
Tamaño del modelo. Un modelo más grande y capaz cuesta más por token que uno más pequeño. Elegir un solo modelo para todas las tareas es el diseño más sencillo y, a menudo, el más caro.
Pasos de razonamiento. Algunos modelos gastan tokens adicionales «pensando» antes de responder. Esos tokens de razonamiento suelen formar parte de lo que usted paga, aunque el cliente nunca los vea. Una pregunta difícil puede generar muchas veces más tokens de lo que sugiere la respuesta visible.
Ciclos de agentes. Un agente de IA no responde una sola vez. Planifica, llama a una herramienta, lee el resultado, decide qué hacer después y repite. Cada pasada es otra llamada al modelo, y cada llamada vuelve a leer un contexto que crece. El equipo de ingeniería de Anthropic, al describir su propio sistema de investigación multiagente, informa que los agentes suelen usar unas 4 veces más tokens que las interacciones de chat, y los sistemas multiagente unas 15 veces más. Son datos de una empresa sobre un tipo de carga de trabajo, así que tome las proporciones como una ilustración de lo mucho que puede subir el costo al pasar de responder a actuar, no como un multiplicador universal.
Reintentos y fallas. Cuando un resultado no supera una verificación, lo rechaza un validador o una llamada a una herramienta da error, el producto a menudo lo intenta de nuevo. Cada reintento cuesta lo mismo que el intento original. Un producto con una tasa de reintentos del 10 % carga con alrededor de un 10 % más de gasto en inferencia de lo que sugiere su «camino ideal».
Si se juntan estos factores, se entiende por qué dos acciones que se ven idénticas en la interfaz de su producto, por ejemplo «ejecutar un análisis», pueden diferir en costo por un factor de diez o de cien. Para profundizar en el control de costos específicamente en sistemas de agentes, consulte optimización de costos de agentes de IA.
Cómo el costo por solicitud se convierte en margen bruto
El margen bruto son los ingresos menos el costo directo de entregar el producto, divididos entre los ingresos. Para una empresa de IA, la inferencia es el mayor costo directo de esa resta, por lo general acompañada del hosting, el monitoreo y el soporte al cliente. Nuestra referencia sobre el margen bruto cubre la fórmula general. Aquí solo necesitamos la forma de la relación.
Si sus ingresos por cliente son fijos y su costo de inferencia por cliente varía con el uso, entonces el margen bruto varía por cliente. El margen no es una propiedad del producto. Es una propiedad del producto multiplicada por la forma en que cada cliente lo usa, con un precio determinado.
Eso tiene una consecuencia práctica. Usted no puede leer la cifra de margen combinado y saber si el negocio está sano. Un margen combinado del 70 % podría significar que la mayoría de los clientes está en el 80 % y unos pocos en el 20 %. O podría significar que todos están cerca del 70 %. Las dos empresas tienen riesgos muy distintos, y solo la primera tiene un problema de usuarios intensivos.
Un ejemplo práctico con cifras ilustrativas
Construyamos uno. Todas las cifras son hipotéticas y redondas. Ninguna es un precio real.
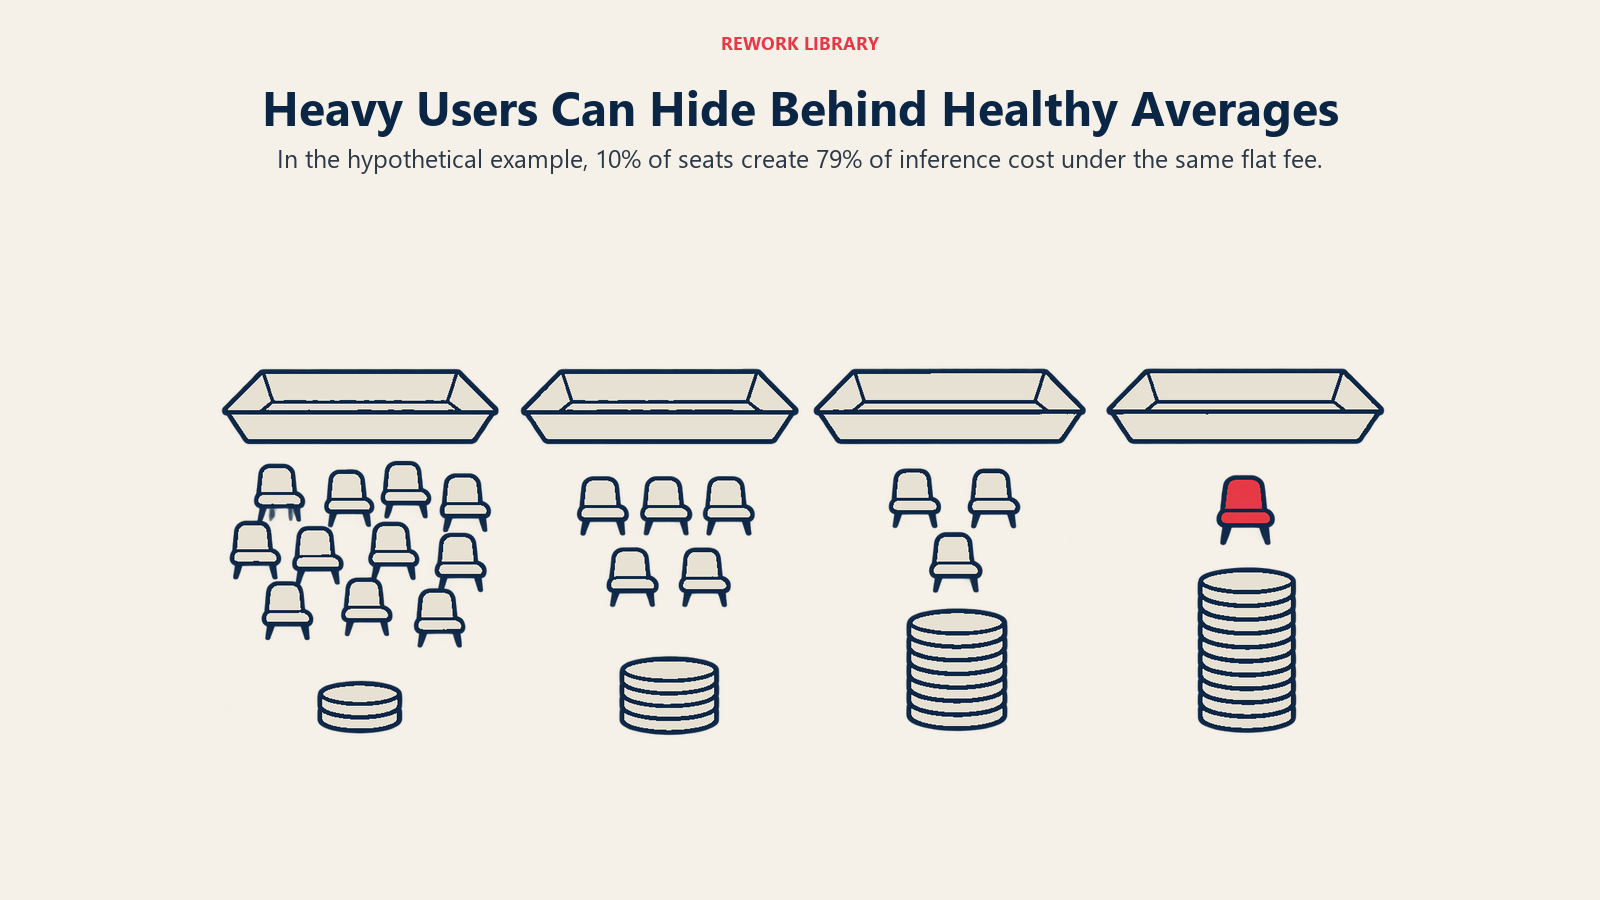
Suponga que vende un asistente de IA a una tarifa fija de $30 por licencia al mes. Suponga que una solicitud le cuesta 1 centavo en inferencia. Tiene 100 licencias y el uso es desigual, como casi siempre:
| Grupo de clientes | Licencias | Solicitudes por licencia al mes | Costo de inferencia por licencia | Costo total de inferencia |
|---|---|---|---|---|
| Ligero | 60 | 50 | $0,50 | $30 |
| Medio | 30 | 400 | $4,00 | $120 |
| Intensivo | 9 | 4000 | $40,00 | $360 |
| Extremo | 1 | 20 000 | $200,00 | $200 |
| Total | 100 | $710 |
Los ingresos son 100 licencias por $30, es decir, $3000. La inferencia suma $710. Si se ignoran todos los demás costos, el margen bruto es (3000 menos 710) dividido entre 3000, o alrededor del 76 %.
Parece sano. Ahora mire dentro.
- Las 60 licencias ligeras generan cada una unos $29,50 de margen.
- Las 9 licencias intensivas pierden cada una $10, porque $40 de inferencia superan los $30 que pagan.
- La licencia extrema pierde $170.
- Esas 10 licencias intensivas y extremas (el 10 % de los clientes) producen $560 de los $710 de costo, es decir, alrededor del 79 % de todo el gasto en inferencia.
La cifra combinada oculta un subsidio cruzado. Los usuarios ligeros pagan por los intensivos. Eso está bien mientras la mezcla se mantenga estable, y es frágil en cuanto cambia.
Qué ocurre cuando sube el uso por tarea
Ahora suponga que lanza una mejora: el asistente se convierte en un agente que realiza varios pasos por solicitud. Digamos que eso multiplica por cinco el costo de cada solicitud, de modo que una solicitud cuesta 5 centavos. Los clientes no cambian cuántas solicitudes envían. El costo ahora es de $3550 frente a $3000 de ingresos, así que el margen bruto es de alrededor de menos 18 %.
Usted mejoró el producto, el uso no cambió y pasó de un margen propio del software a perder dinero en cada licencia. Un precio fijo no puede absorber un cambio en el costo por solicitud, porque el precio no sabe nada de las solicitudes.
La cola de usuarios intensivos
El ejemplo muestra el patrón llamado cola de usuarios intensivos. El uso entre clientes rara vez sigue una curva de campana. Suele estar sesgado: la mayoría de los clientes usa una cantidad modesta y un grupo pequeño usa muchísimo más. Con precios fijos, los ingresos de cada cliente tienen un tope, pero el costo no.
Tres factores empeoran la cola en la IA en comparación con el software anterior.
- Los mejores clientes son los más caros. Las personas a las que les encanta el producto son las que más lo usan. Renuevan, amplían su contrato y se lo recomiendan a sus colegas. Pero sus facturas de inferencia crecen con su entusiasmo.
- Los agentes elevan el techo. Una persona solo puede enviar cierta cantidad de solicitudes por hora. Un agente programado puede enviar miles. La automatización elimina el límite natural del uso por licencia.
- La cola crece a medida que el producto mejora. Mejores resultados significan que los clientes confían al producto tareas más grandes, documentos más largos y trabajo más autónomo. Cada uno de esos elementos eleva el costo por tarea.
Nada de esto hace que el precio fijo sea un error. Significa que el precio fijo le asigna a usted el riesgo de costos, y debe saber que ese es el trato que ha hecho.
Cómo el modelo de precios decide quién asume el riesgo
La forma más clara de pensar el precio de un producto de IA es hacerse una sola pregunta: cuando sube el costo por cliente, ¿quién paga?
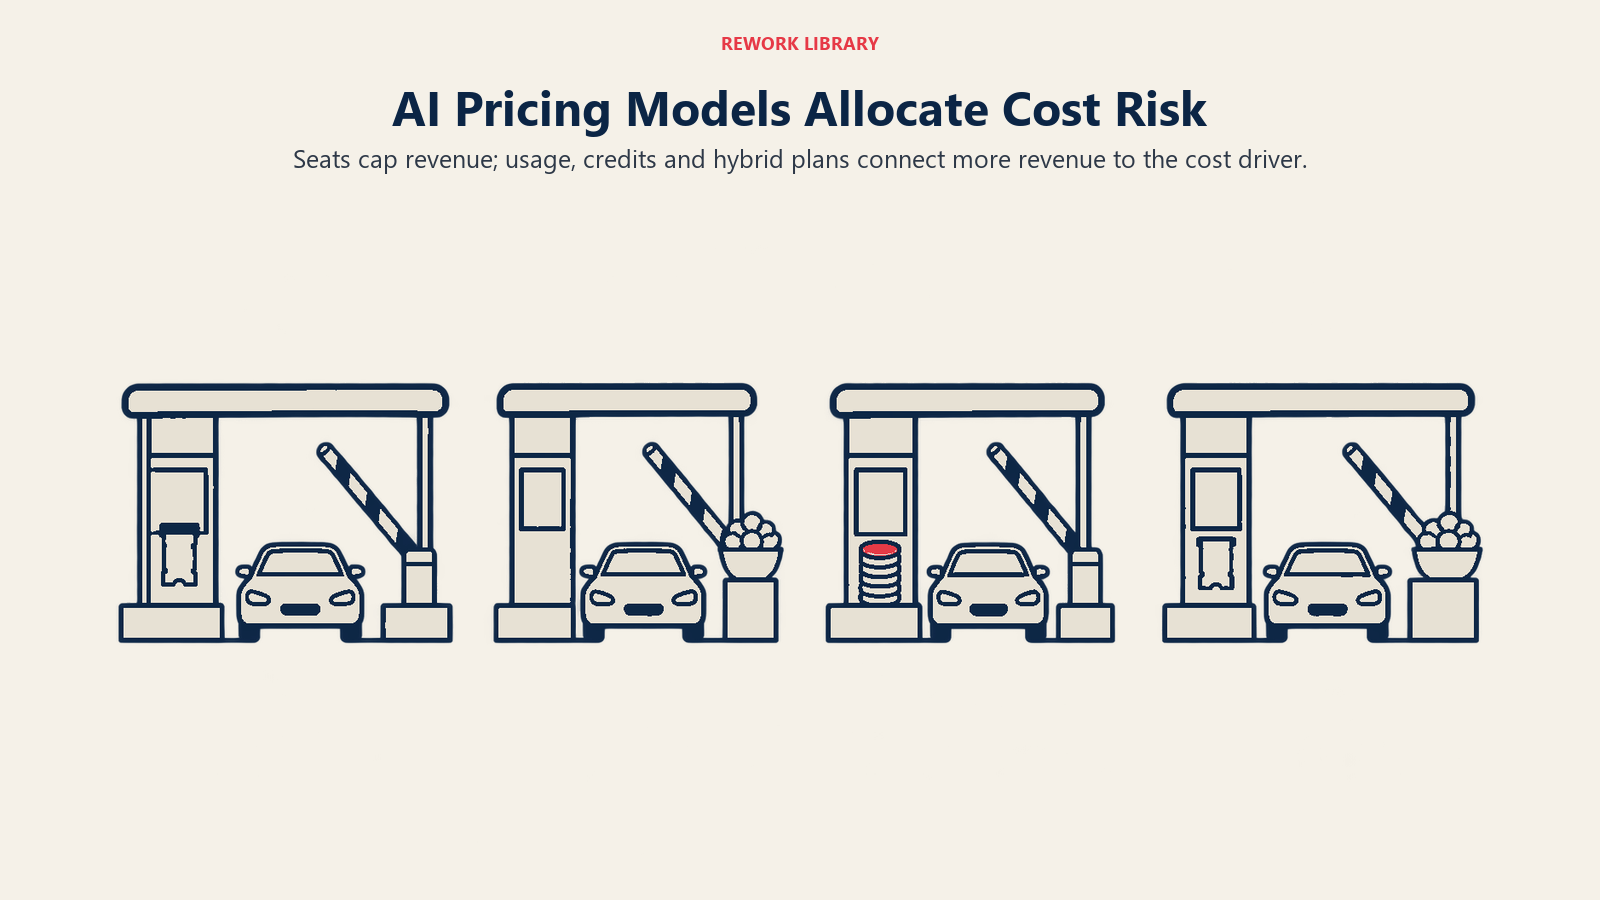
| Modelo de precios | Por qué paga el cliente | Quién asume el riesgo del costo de inferencia | Cuándo se protege el margen |
|---|---|---|---|
| Tarifa fija por usuario | Acceso para un usuario | Principalmente usted | Cuando el uso por licencia es estable y ligero |
| Precios basados en el uso | Unidades consumidas (solicitudes, tareas, minutos) | Principalmente el cliente | Cuando el precio unitario cubre el costo con holgura |
| Créditos | Un saldo prepagado que se gasta en acciones | Compartido, según la tabla de tarifas | Cuando los créditos por acción siguen el costo real |
| Híbrido (tarifa de plataforma más uso incluido) | Una base más excedentes | Compartido | Cuando la asignación incluida está muy por debajo de la cola |
Las licencias fijas son fáciles de vender y fáciles de prever para el comprador. También son el modelo más expuesto a la cola. Nuestro artículo sobre los precios por usuario en la era de la IA explica por qué la unidad de licencia se debilita cuando el trabajo lo hace el software y no las personas.
Los precios basados en el uso vinculan los ingresos con el mismo factor que impulsa el costo. Si cada solicitud genera 3 centavos y cuesta 1 centavo, usted conserva un margen del 67 % en cada solicitud, sin importar cuántas lleguen. El precio que paga a cambio es la imprevisibilidad para el comprador.
Los créditos son precios basados en el uso con un envoltorio. Si la tabla de tarifas se construye a partir de costos reales, el margen queda protegido por acción. Si el costo por acción cambia y la tabla de tarifas no, usted ha recreado el problema del precio fijo dentro de un sistema de créditos. Abordamos las decisiones de diseño en los precios basados en créditos explicados.
Los híbridos combinan una base previsible con una asignación y luego miden lo que la excede. Le dan al comprador una cifra con la que presupuestar y le dan a usted un tope de hasta dónde puede llegar la cola. Consulte precios híbridos para productos de IA.
Volviendo al ejemplo, la solución no es un misterio. Si pasara a $10 por licencia más 3 centavos por solicitud a partir de las primeras 300 incluidas, la licencia extrema pagaría aproximadamente $600 en lugar de $30, y su costo de $200 quedaría cubierto. Las licencias ligeras pagarían su base de $10 y se mantendrían dentro de la asignación. Tendría que comprobar si el precio de lista más bajo sigue convirtiendo, lo cual es una disyuntiva real. Pero la estructura alinea los ingresos con el costo justo donde el costo se genera.
La tendencia de largo plazo: más barato por unidad, más unidades por tarea
Los fundadores suelen escuchar que la inferencia se está abaratando, así que los problemas de margen se resolverán solos. Hay algo de verdad en ello, y hay una trampa.
La parte cierta está bien documentada. El análisis de Andreessen Horowitz sobre esta tendencia, que llama LLMflation, afirma que para un LLM de rendimiento equivalente, el costo disminuye 10 veces cada año. Epoch AI, que examinó modelos de última generación en seis benchmarks durante unos tres años, encuentra que el ritmo de descenso varía muchísimo según el hito de rendimiento, entre 9 y 900 veces por año. Añade que las caídas más rápidas se han producido en el año más reciente, por lo que es menos claro que vayan a persistir. Ambas afirmaciones se refieren al precio de alcanzar un nivel fijo de capacidad. No dicen cuánto pagará usted por el mejor modelo disponible el año que viene.
La trampa está en la segunda mitad de la ecuación. El costo por tarea es igual al costo por unidad de capacidad multiplicado por la cantidad de capacidad que consume la tarea. El primer término ha caído rápidamente. El segundo tiende a subir, por las razones expuestas antes en este artículo:
- Los clientes quieren el modelo más capaz, no el del año pasado, así que siguen comprando en la frontera.
- Los pasos de razonamiento añaden tokens a cada respuesta.
- Los ciclos de agentes convierten una solicitud en muchas llamadas.
- Los contextos más largos y los documentos más grandes se vuelven prácticos, así que la gente los usa.
Las cifras de Anthropic mencionadas antes muestran la escala del lado del uso: pasar del chat a los agentes multiplica varias veces los tokens por tarea. Una caída anual de 10 veces en el precio por unidad de capacidad puede quedar absorbida por un producto que usa muchas más unidades por tarea. El efecto neto en su margen depende de cuál de las dos fuerzas gane en su carga de trabajo, y esa es una pregunta empírica que debe responder con sus propios datos.
La postura de planificación que se desprende es conservadora. No fije el precio del producto actual suponiendo que los costos caerán lo suficiente para rescatarlo. Fíjelo de modo que el margen de cada cliente se sostenga con el costo actual, y trate la caída de los costos unitarios como un beneficio adicional que puede compartir con los clientes o conservar.
Qué medir
La mecánica solo ayuda si usted puede verla en sus propias cifras. Haga seguimiento de lo siguiente:
- Costo de inferencia por cliente activo, por mes. El promedio es menos útil que la distribución. Observe la mediana, el percentil 90 y las diez cuentas principales.
- Margen bruto por cliente o por cohorte de uso. Averigüe cuántos clientes están por debajo de su objetivo.
- Costo por tarea completada, no por solicitud. Si los reintentos y los pasos de los agentes están ocultos dentro de «una tarea», las cifras por solicitud subestimarán el costo.
- Proporción del costo que proviene del 10 % de usuarios principales. En el ejemplo fue el 79 %. Si la suya está igual de concentrada, el precio es lo primero que debe revisar.
- Costo por solicitud a lo largo del tiempo con comportamiento constante. Esto separa un precio unitario que baja de una huella de uso que sube.
Si hoy no puede calcular estas cifras, construir el registro necesario para hacerlo vale más que la mayoría de los experimentos de precios, porque toda decisión de precios se basa en saber de dónde viene el costo.
Datos clave: costos de inferencia y margen bruto
- El entrenamiento construye un modelo y es en gran medida independiente del volumen de clientes. La inferencia ejecuta el modelo con cada acción del cliente y escala con el uso, por eso llega al margen bruto.
- El costo por solicitud depende de los tokens de entrada y salida, la longitud del contexto, el tamaño del modelo, los pasos de razonamiento, los ciclos de agentes y los reintentos.
- Los agentes suelen usar unas 4 veces más tokens que las interacciones de chat, y los sistemas multiagente unas 15 veces más (ingeniería de Anthropic, sobre su propio sistema de investigación).
- Para un LLM de rendimiento equivalente, el costo disminuye 10 veces cada año (a16z).
- Epoch AI encuentra descensos de precios de entre 9 y 900 veces por año según el hito de rendimiento, con las caídas más rápidas en el año más reciente.
- Con precios fijos, los ingresos por cliente tienen un tope y el costo de inferencia no, así que los usuarios intensivos pueden operar con margen negativo mientras la cifra combinada parece sana.
- En el ejemplo ilustrativo de este artículo, el 10 % de las licencias genera alrededor del 79 % del costo de inferencia, y un aumento de 5 veces en el costo por solicitud convierte un margen del 76 % en una pérdida.
- Los precios basados en el uso, en créditos e híbridos trasladan al cliente una mayor parte del riesgo de costos que las licencias fijas.
La conclusión es breve. La inferencia convierte el costo de entregar software de algo insignificante en una partida que se mueve con cada solicitud, y su modelo de precios decide si ese movimiento recae en el cliente o en su margen. Conozca la distribución del uso entre sus cuentas y fije precios en función del costo que tiene hoy.
Preguntas frecuentes sobre los costos de inferencia y el margen bruto
¿Qué es la inferencia en la IA?
La inferencia es ejecutar un modelo ya entrenado para producir un resultado para un usuario, como responder una pregunta o completar una tarea. Ocurre cada vez que un cliente realiza una acción, por lo que su costo crece con el uso. El entrenamiento, en cambio, es el trabajo puntual o periódico de construir el modelo.
¿Por qué la inferencia es un costo variable?
Cada solicitud desencadena su propio cómputo, y el tamaño de ese cómputo depende de los tokens de entrada y salida, la longitud del contexto, el tamaño del modelo, los pasos de razonamiento, los ciclos de agentes y los reintentos. Más solicitudes, o solicitudes más pesadas, significan una factura más alta. Eso es distinto del software clásico, donde una solicitud adicional no cuesta casi nada.
¿Cómo afectan los costos de inferencia al margen bruto?
La inferencia suele ser el mayor costo directo de entregar un producto de IA, así que reduce directamente el margen bruto. Como varía por cliente mientras que los ingresos por suscripción a menudo no, el margen se convierte en una cifra por cliente. Un margen combinado sano puede ocultar clientes que cuestan más de lo que pagan.
¿Qué es el problema de los usuarios intensivos en los precios de IA?
Con precios fijos, los ingresos por cliente tienen un tope, pero el costo de inferencia no. Un grupo pequeño de usuarios intensivos, a menudo sus clientes más comprometidos, puede representar la mayor parte del costo y operar con margen negativo. Los usuarios ligeros terminan subsidiándolos, lo que solo funciona mientras la mezcla de uso se mantenga estable.
¿La caída de los precios de inferencia resolverá por sí sola el problema de margen?
No de forma confiable. Los precios para un nivel fijo de capacidad han caído rápido: a16z cita unas 10 veces por año y Epoch AI un rango de 9 a 900 veces por año. Pero los clientes también usan modelos más capaces, contextos más largos, razonamiento y agentes, lo que eleva la cantidad de cómputo por tarea. Cuál de las dos fuerzas gana depende de su carga de trabajo.
¿Qué modelo de precios protege mejor el margen frente a los costos de inferencia?
Los modelos que vinculan los ingresos con el uso, como los precios basados en el uso o los créditos con una tabla de tarifas precisa, protegen el margen por solicitud. Los híbridos con una asignación incluida ponen un tope a la cola y mantienen una base previsible. Las licencias fijas le dejan a usted la mayor parte del riesgo. La elección correcta también depende de cuánta imprevisibilidad acepten sus compradores.
¿Qué debo medir primero?
Empiece por el costo de inferencia por cliente y su distribución entre las cuentas, en especial la proporción del costo que proviene del 10 % de usuarios principales. Luego haga seguimiento del costo por tarea completada en lugar de por solicitud, y del margen bruto por cohorte de uso. Esas tres cifras muestran si sus precios coinciden con el lugar donde se genera el costo.
Lecturas relacionadas

Co-Founder & COO
On this page
- Entrenamiento frente a inferencia
- Por qué la inferencia se comporta como un costo variable
- Cómo el costo por solicitud se convierte en margen bruto
- Un ejemplo práctico con cifras ilustrativas
- Qué ocurre cuando sube el uso por tarea
- La cola de usuarios intensivos
- Cómo el modelo de precios decide quién asume el riesgo
- La tendencia de largo plazo: más barato por unidad, más unidades por tarea
- Qué medir
- Lecturas relacionadas