Custos de inferência e margem bruta em empresas de IA
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
O software tradicional tem uma peculiaridade feliz: depois que o produto está pronto, atender mais um cliente custa quase nada. É por isso que as margens brutas do software viraram aquilo que os investidores admiravam. Os produtos de IA quebram essa peculiaridade. Toda vez que um cliente pede ao produto para fazer algo, um modelo é executado, e executar um modelo custa dinheiro de verdade. Esse custo se chama inferência, e é o principal motivo pelo qual a margem bruta de uma empresa de IA pode não se parecer em nada com a de uma empresa de software clássica.
Este artigo explica a mecânica. O que é inferência, por que ela se comporta como um custo variável, como o custo de uma única requisição se transforma em um número de margem, por que alguns poucos usuários intensivos podem arruinar a média e como o seu modelo de precificação decide quem absorve o risco. Ele foi escrito para fundadores e CEOs-proprietários de empresas B2B com equipe. O exemplo prático usa números redondos e hipotéticos e não reflete o preço de nenhum modelo real.
Para saber como esses custos são classificados na demonstração de resultados, veja como as empresas de IA contabilizam o COGS. Para formas de reduzi-los, veja gestão de custos de modelos de IA. Este texto se concentra em como os custos funcionam e como chegam à margem.
Treinamento versus inferência
Duas atividades diferentes consomem computação em um negócio de IA, e elas se comportam de maneiras muito diferentes.
Treinamento é construir ou adaptar um modelo. Acontece antes de atender os clientes (ou periodicamente, em paralelo). É caro, irregular e em grande parte independente de quantas pessoas usam o seu produto. Se você constrói o seu próprio modelo, uma rodada de treinamento está mais perto de um projeto de desenvolvimento do que de um custo de entregar uma venda.
Inferência é executar um modelo treinado para produzir uma resposta. Acontece cada vez que um cliente realiza uma ação. Se você faz fine-tuning de um modelo ou chama o modelo de outra empresa, a mesma divisão se aplica: construir a capacidade é um custo, e servi-la é outro.
A distinção importa porque os dois escalam em eixos diferentes. O custo de treinamento escala com a ambição do modelo. O custo de inferência escala com o quanto os seus clientes o usam. Uma startup que vende um produto de IA para mais clientes, ou que faz os clientes existentes o usarem mais, não aumenta a conta de treinamento. Ela aumenta a conta de inferência, quase na mesma proporção.
É por isso que a inferência é o custo que aparece na margem bruta. Ele é incorrido no ato de entregar o produto e sobe quando a entrega sobe.
Por que a inferência se comporta como um custo variável
Em um produto de software clássico, o custo marginal de uma requisição é um erro de arredondamento. Você paga por servidores em blocos, e o tráfego preenche esses blocos. Em um produto de IA, cada requisição faz um bloco de computação próprio, e o tamanho desse bloco depende do que é a requisição. Vários fatores o definem.
Tokens de entrada e de saída. Os modelos de linguagem leem e escrevem texto em pequenas unidades chamadas tokens. Uma pergunta curta com uma resposta curta é barata. Um documento longo com um resumo longo, não. Tanto os provedores quanto as configurações auto-hospedadas costumam tratar de forma diferente o lado da leitura (a entrada) e o lado da escrita (a saída), e saídas longas geralmente custam mais para produzir do que a mesma quantidade de entrada custa para ler.
Tamanho do contexto. Muitos produtos colocam material extra em cada requisição: a conversa até ali, documentos recuperados, instruções, exemplos. Esse contexto é relido toda vez. Um chat que já tem vinte turnos custa mais por mensagem do que a primeira mensagem custou, porque todo o histórico vai junto.
Tamanho do modelo. Um modelo maior e mais capaz custa mais por token do que um menor. Escolher um único modelo para todas as tarefas é o design mais simples e, muitas vezes, o mais caro.
Etapas de raciocínio. Alguns modelos gastam tokens extras "pensando" antes de responder. Esses tokens de raciocínio geralmente fazem parte do que você paga, mesmo que o cliente nunca os veja. Uma pergunta difícil pode gerar muitas vezes mais tokens do que a resposta visível sugere.
Ciclos de agentes. Um agente de IA não responde uma vez só. Ele planeja, chama uma ferramenta, lê o resultado, decide o que fazer em seguida e repete. Cada passagem é outra chamada ao modelo, e cada chamada relê um contexto crescente. A equipe de engenharia da Anthropic, ao descrever o seu próprio sistema de pesquisa multiagente, relata que os agentes normalmente usam cerca de 4 vezes mais tokens do que interações de chat, e os sistemas multiagente cerca de 15 vezes mais. São dados de uma empresa sobre um tipo de carga de trabalho, então trate essas proporções como uma ilustração de como o custo pode subir rapidamente quando se passa de responder para agir, não como um multiplicador universal.
Novas tentativas e falhas. Quando uma saída não passa em uma verificação, é rejeitada por um validador ou uma chamada de ferramenta dá erro, o produto muitas vezes tenta de novo. Cada nova tentativa custa o mesmo que a tentativa original. Um produto com 10% de taxa de novas tentativas carrega cerca de 10% a mais de gasto com inferência do que o seu "caminho feliz" sugere.
Junte tudo isso e você entende por que duas ações que parecem idênticas na interface do seu produto, por exemplo "executar uma análise", podem ter custos que diferem por um fator de dez ou de cem. Para um olhar mais aprofundado sobre controle de custos especificamente em sistemas de agentes, veja otimização de custos de agentes de IA.
Como o custo por requisição vira margem bruta
Margem bruta é a receita menos o custo direto de entregar o produto, dividida pela receita. Para uma empresa de IA, a inferência é o maior custo direto nessa subtração, geralmente acompanhada de hospedagem, monitoramento e suporte ao cliente. Nossa referência sobre margem bruta trata da fórmula geral. Aqui só precisamos do formato da relação.
Se a sua receita por cliente é fixa e o seu custo de inferência por cliente varia com o uso, então a margem bruta varia por cliente. A margem não é uma propriedade do produto. É uma propriedade do produto multiplicada pela forma como cada cliente o usa, sob um determinado preço.
Isso tem uma consequência prática. Você não consegue ler o número da margem combinada e saber se o negócio está saudável. Uma margem combinada de 70% pode significar que a maioria dos clientes está em 80% e alguns estão em 20%. Ou pode significar que todos estão perto de 70%. As duas empresas têm riscos muito diferentes, e só a primeira tem um problema de usuários intensivos.
Um exemplo prático com números ilustrativos
Vamos montar um. Todos os números aqui são hipotéticos e redondos. Nenhum deles é um preço real.
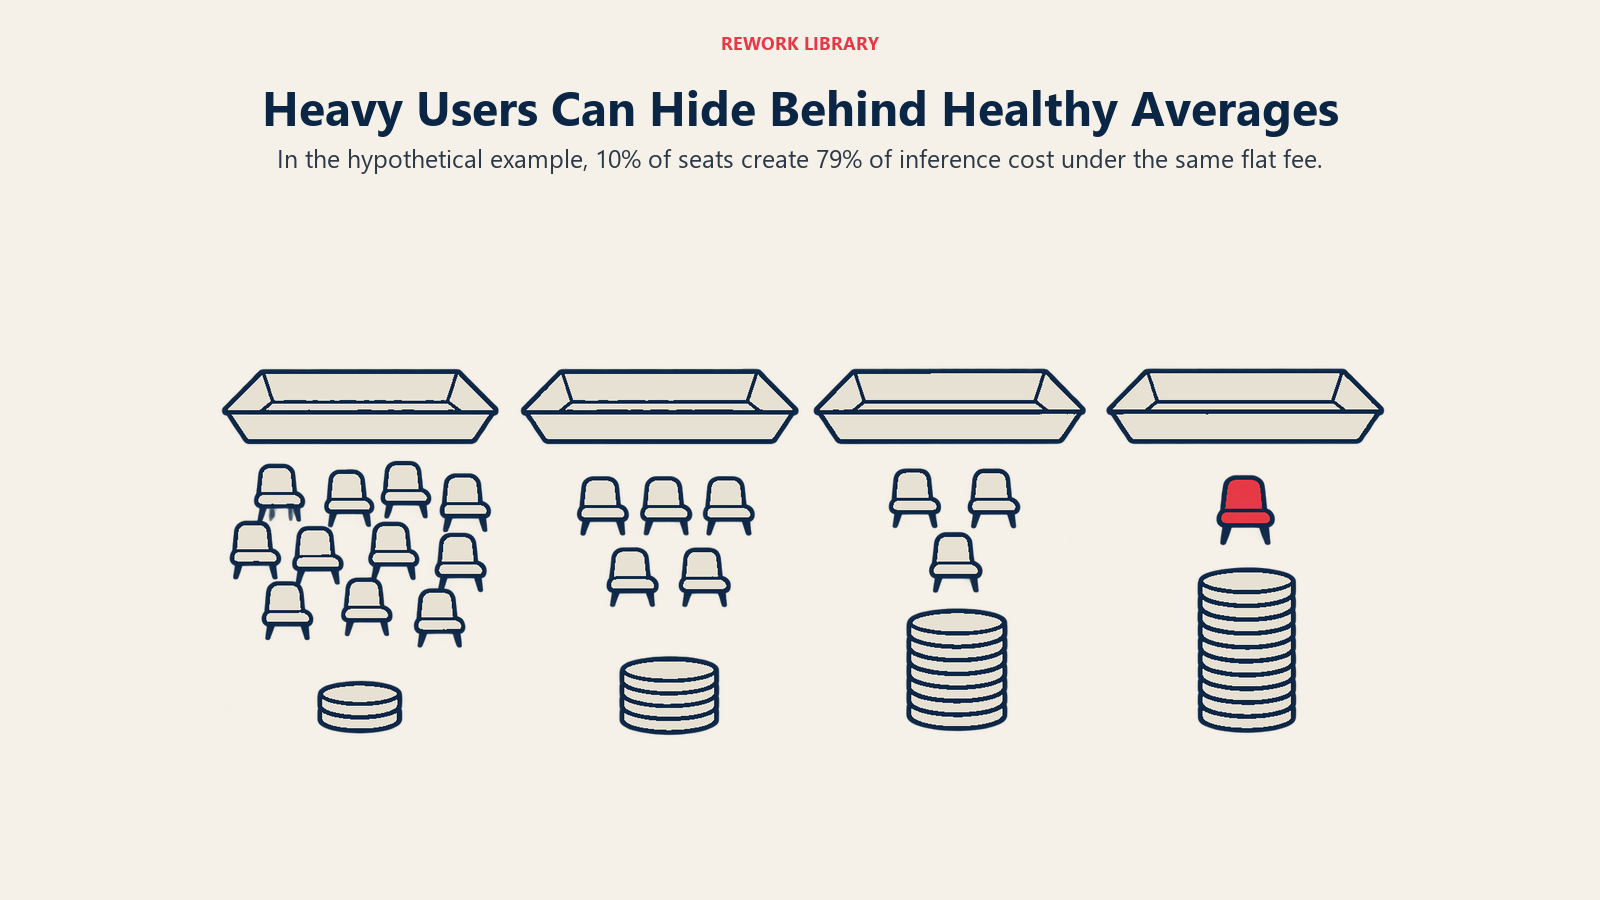
Suponha que você venda um assistente de IA por um valor fixo de US$ 30 por seat por mês. Suponha que uma requisição custe 1 centavo de inferência. Você tem 100 seats, e o uso é desigual, como quase sempre é:
| Grupo de clientes | Seats | Requisições por seat por mês | Custo de inferência por seat | Custo total de inferência |
|---|---|---|---|---|
| Leve | 60 | 50 | US$ 0,50 | US$ 30 |
| Médio | 30 | 400 | US$ 4,00 | US$ 120 |
| Intensivo | 9 | 4.000 | US$ 40,00 | US$ 360 |
| Extremo | 1 | 20.000 | US$ 200,00 | US$ 200 |
| Total | 100 | US$ 710 |
A receita é 100 seats vezes US$ 30, ou seja, US$ 3.000. A inferência é US$ 710. Ignorando todos os outros custos, a margem bruta é (3.000 menos 710) dividido por 3.000, ou cerca de 76%.
Parece saudável. Agora olhe por dentro.
- Cada um dos 60 seats leves gera cerca de US$ 29,50 de margem.
- Cada um dos 9 seats intensivos perde US$ 10, porque US$ 40 de inferência superam os US$ 30 que eles pagam.
- O único seat extremo perde US$ 170.
- Esses 10 seats intensivos e extremos (10% dos clientes) produzem US$ 560 dos US$ 710 de custo, o que equivale a cerca de 79% de todo o gasto com inferência.
O número combinado esconde um subsídio cruzado. Os usuários leves pagam pelos intensivos. Isso funciona enquanto a composição se mantém estável, e se torna frágil no momento em que ela muda.
O que acontece quando o uso por tarefa aumenta
Agora suponha que você lance uma atualização: o assistente vira um agente que executa várias etapas por requisição. Digamos que isso multiplique por cinco o custo de cada requisição, de modo que uma requisição passe a custar 5 centavos. Os clientes não mudam a quantidade de requisições que enviam. O custo agora é de US$ 3.550 contra US$ 3.000 de receita, então a margem bruta fica em cerca de 18% negativos.
Você melhorou o produto, o uso não mudou, e você passou de uma margem típica de software para perder dinheiro em cada seat. Um preço fixo não consegue absorver uma mudança no custo por requisição, porque o preço não sabe nada sobre requisições.
A cauda de usuários intensivos
O exemplo mostra o padrão chamado de cauda de usuários intensivos. O uso entre clientes raramente forma uma curva em sino. Ele tende a ser assimétrico, com a maioria dos clientes usando uma quantidade modesta e um pequeno grupo usando muito mais. Com precificação fixa, a receita de cada cliente tem um teto, mas o custo não.
Três fatores tornam a cauda pior na IA do que no software mais antigo.
- Os melhores clientes são os mais caros. As pessoas que amam o produto são as que mais o usam. Elas renovam, expandem e recomendam aos colegas. Mas as contas de inferência delas crescem junto com o entusiasmo.
- Os agentes elevam o teto. Uma pessoa só consegue enviar um certo número de requisições por hora. Um agente agendado pode enviar milhares. A automação remove o limite natural de uso por seat.
- A cauda cresce à medida que o produto melhora. Resultados melhores fazem os clientes confiarem ao produto tarefas maiores, documentos mais longos e trabalho mais autônomo. Cada um desses fatores eleva o custo por tarefa.
Nada disso torna a precificação fixa errada. Significa que a precificação fixa coloca o risco de custo sobre você, e você deve saber que esse é o acordo que fez.
Como a escolha do modelo de precificação decide quem carrega o risco
A forma mais clara de pensar a precificação de um produto de IA é fazer uma única pergunta: quando o custo por cliente sobe, quem paga?
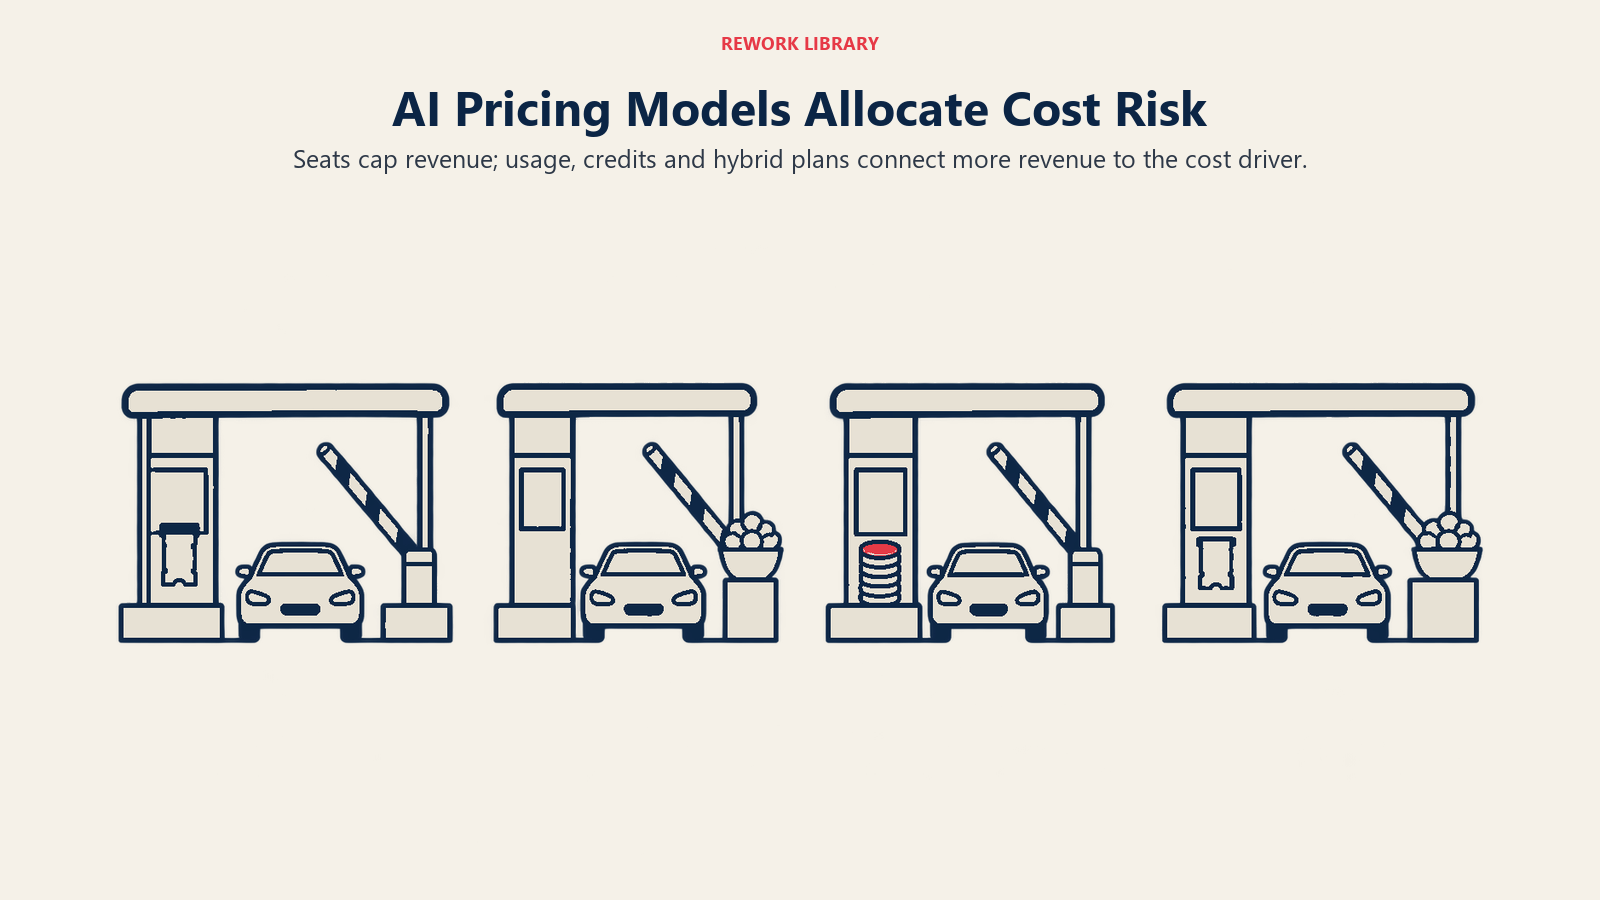
| Modelo de precificação | O que o cliente paga | Quem carrega o risco do custo de inferência | Quando a margem fica protegida |
|---|---|---|---|
| Fixo por seat | Acesso para um usuário | Principalmente você | Quando o uso por seat é estável e leve |
| Baseado em uso | Unidades consumidas (requisições, tarefas, minutos) | Principalmente o cliente | Quando o preço unitário cobre o custo com folga |
| Créditos | Um saldo pré-pago gasto em ações | Compartilhado, dependendo da tabela de preços | Quando os créditos por ação acompanham o custo real |
| Híbrido (taxa de plataforma mais uso incluído) | Uma base mais excedente | Compartilhado | Quando a franquia incluída fica bem abaixo da cauda |
Seats fixos são simples de vender e fáceis de prever para o comprador. Também são o modelo mais exposto à cauda. Nosso artigo sobre precificação por seat na era da IA explica por que a unidade de seat enfraquece quando o trabalho é feito por software, e não por pessoas.
A precificação baseada em uso liga a receita ao mesmo fator que gera o custo. Se cada requisição rende 3 centavos e custa 1 centavo, você mantém uma margem de 67% em cada requisição, não importa quantas cheguem. O preço que você paga em troca é a imprevisibilidade para o comprador.
Créditos são precificação por uso com uma embalagem. Se a tabela de preços é construída a partir de custos reais, a margem fica protegida por ação. Se o custo por ação muda e a tabela não, você recriou o problema do preço fixo dentro de um sistema de créditos. Tratamos das escolhas de design em precificação baseada em créditos explicada.
Os modelos híbridos combinam uma base previsível com uma franquia e medem o que passa dela. Eles dão ao comprador um número para orçar e dão a você um limite para o tamanho da cauda. Veja precificação híbrida para produtos de IA.
Voltando ao exemplo, a solução não é misteriosa. Se você mudasse para US$ 10 por seat mais 3 centavos por requisição além das primeiras 300 incluídas, o seat extremo pagaria cerca de US$ 600 em vez de US$ 30, e o seu custo de US$ 200 estaria coberto. Os seats leves pagariam a base de US$ 10 e ficariam dentro da franquia. Você teria que testar se o preço de vitrine menor ainda converte, o que é uma troca real. Mas a estrutura alinha receita e custo onde o custo de fato surge.
A tendência de longo prazo: mais barato por unidade, mais unidades por tarefa
Os fundadores costumam ouvir que a inferência está ficando mais barata e que, portanto, os problemas de margem vão se resolver sozinhos. Há verdade nisso, e há um porém.
A verdade está bem documentada. A análise da Andreessen Horowitz sobre essa tendência, que ela chama de LLMflation, diz que para um LLM de desempenho equivalente, o custo está caindo 10x por ano. A Epoch AI, que examinou modelos de ponta em seis benchmarks ao longo de cerca de três anos, conclui que a taxa de queda varia drasticamente conforme o marco de desempenho, indo de 9x a 900x por ano. Ela acrescenta que as quedas mais rápidas ocorreram no ano mais recente, então é menos claro que vão persistir. As duas afirmações tratam do preço para atingir um nível fixo de capacidade. Elas não dizem quanto você vai pagar pelo melhor modelo disponível no ano que vem.
O porém é a segunda metade da equação. O custo por tarefa é igual ao custo por unidade de capacidade vezes a quantidade de capacidade que a tarefa consome. O primeiro termo vem caindo rapidamente. O segundo tende a subir, pelos motivos apresentados antes neste artigo:
- Os clientes querem o modelo mais capaz, não o do ano passado, então continuam comprando na fronteira.
- As etapas de raciocínio acrescentam tokens a cada resposta.
- Os ciclos de agentes transformam uma requisição em muitas chamadas.
- Contextos mais longos e documentos maiores se tornam viáveis, então as pessoas os usam.
Os números da Anthropic acima mostram a escala do lado do uso: passar do chat para agentes multiplica várias vezes os tokens por tarefa. Uma queda anual de 10x no preço por unidade de capacidade pode ser consumida por um produto que usa muito mais unidades por tarefa. O efeito líquido na sua margem depende de qual força vence na sua carga de trabalho, e essa é uma pergunta empírica que você precisa responder com os seus próprios dados.
A postura de planejamento que decorre disso é conservadora. Não precifique o produto de hoje supondo que os custos vão cair o suficiente para salvá-lo. Precifique de forma que a margem de cada cliente se sustente com o custo de hoje e trate a queda dos custos unitários como um ganho adicional que você pode compartilhar com os clientes ou manter.
O que medir
A mecânica só ajuda se você conseguir vê-la nos seus próprios números. Acompanhe estes indicadores:
- Custo de inferência por cliente ativo, por mês. A média é menos útil do que a distribuição. Olhe a mediana, o percentil 90 e as dez maiores contas.
- Margem bruta por cliente, ou por grupo de uso. Descubra quantos clientes estão abaixo da sua meta.
- Custo por tarefa concluída, não por requisição. Se novas tentativas e etapas de agentes estão escondidas dentro de "uma tarefa", os números por requisição vão subestimar o custo.
- Participação dos 10% maiores usuários no custo. No exemplo, foi de 79%. Se a sua for igualmente concentrada, a precificação é o primeiro lugar para olhar.
- Custo por requisição ao longo do tempo com comportamento constante. Isso separa a queda do preço unitário do aumento da pegada de uso.
Se você não consegue calcular esses números hoje, construir os logs para isso vale mais do que a maioria dos experimentos de precificação, porque toda decisão de preço depende de saber de onde vem o custo.
Fatos principais: custos de inferência e margem bruta
- O treinamento constrói um modelo e é em grande parte independente do volume de clientes. A inferência executa o modelo a cada ação do cliente e escala com o uso, e é por isso que ela entra na margem bruta.
- O custo por requisição depende dos tokens de entrada e de saída, do tamanho do contexto, do tamanho do modelo, das etapas de raciocínio, dos ciclos de agentes e das novas tentativas.
- Os agentes normalmente usam cerca de 4x mais tokens do que interações de chat, e os sistemas multiagente cerca de 15x (engenharia da Anthropic, sobre o seu próprio sistema de pesquisa).
- Para um LLM de desempenho equivalente, o custo está caindo 10x por ano (a16z).
- A Epoch AI encontra quedas de preço que vão de 9x a 900x por ano conforme o marco de desempenho, com as quedas mais rápidas no ano mais recente.
- Com precificação fixa, a receita por cliente tem teto e o custo de inferência não, então os usuários intensivos podem operar com margem negativa enquanto o número combinado parece saudável.
- No exemplo ilustrativo deste artigo, 10% dos seats geram cerca de 79% do custo de inferência, e um aumento de 5x no custo por requisição transforma uma margem de 76% em prejuízo.
- A precificação por uso, por créditos e híbrida transfere ao cliente mais risco de custo do que os seats fixos.
A conclusão é curta. A inferência transforma o custo de entregar software de um erro de arredondamento em uma linha que se move a cada requisição, e o seu modelo de precificação decide se esse movimento recai sobre o cliente ou sobre a sua margem. Conheça a distribuição de uso entre as suas contas e precifique com base no custo que você tem agora.
Perguntas frequentes sobre custos de inferência e margem bruta
O que é inferência em IA?
Inferência é executar um modelo treinado para produzir um resultado para o usuário, como responder a uma pergunta ou concluir uma tarefa. Ela acontece toda vez que um cliente realiza uma ação, então o seu custo cresce com o uso. O treinamento, por outro lado, é o trabalho pontual ou periódico de construir o modelo.
Por que a inferência é um custo variável?
Cada requisição dispara a sua própria computação, e o tamanho dessa computação depende dos tokens de entrada e de saída, do tamanho do contexto, do tamanho do modelo, das etapas de raciocínio, dos ciclos de agentes e das novas tentativas. Mais requisições, ou requisições mais pesadas, significam uma conta maior. Isso é diferente do software clássico, em que uma requisição extra custa quase nada.
Como os custos de inferência afetam a margem bruta?
A inferência costuma ser o maior custo direto de entregar um produto de IA, então ela reduz a margem bruta diretamente. Como varia por cliente enquanto a receita de assinatura muitas vezes não varia, a margem passa a ser um número por cliente. Uma margem combinada saudável pode esconder clientes que custam mais do que pagam.
O que é o problema dos usuários intensivos na precificação de IA?
Com precificação fixa, a receita por cliente tem teto, mas o custo de inferência não. Um pequeno grupo de usuários intensivos, muitas vezes os seus clientes mais engajados, pode responder pela maior parte do custo e operar com margem negativa. Os usuários leves acabam subsidiando esses clientes, o que só funciona enquanto a composição de uso se mantém estável.
A queda nos preços de inferência vai resolver sozinha o problema de margem?
Não de forma confiável. Os preços para um nível fixo de capacidade caíram rapidamente, com a a16z citando cerca de 10x por ano e a Epoch AI uma faixa de 9x a 900x por ano. Mas os clientes também usam modelos mais capazes, contextos mais longos, raciocínio e agentes, o que aumenta a quantidade de computação por tarefa. Qual força vence depende da sua carga de trabalho.
Qual modelo de precificação protege melhor a margem dos custos de inferência?
Modelos que ligam a receita ao uso, como a precificação baseada em uso ou créditos com uma tabela de preços precisa, protegem a margem por requisição. Os híbridos com franquia incluída limitam a cauda e mantêm uma base previsível. Os seats fixos deixam a maior parte do risco com você. A escolha certa também depende de quanta imprevisibilidade os seus compradores aceitam.
O que devo medir primeiro?
Comece pelo custo de inferência por cliente e pela distribuição entre as contas, especialmente a participação dos 10% maiores usuários no custo. Depois acompanhe o custo por tarefa concluída em vez de por requisição e a margem bruta por grupo de uso. Esses três indicadores mostram se a sua precificação corresponde ao lugar onde o custo surge.
Leitura relacionada

Co-Founder & COO
On this page
- Treinamento versus inferência
- Por que a inferência se comporta como um custo variável
- Como o custo por requisição vira margem bruta
- Um exemplo prático com números ilustrativos
- O que acontece quando o uso por tarefa aumenta
- A cauda de usuários intensivos
- Como a escolha do modelo de precificação decide quem carrega o risco
- A tendência de longo prazo: mais barato por unidade, mais unidades por tarefa
- O que medir
- Leitura relacionada