Inferenzkosten und Bruttomarge in KI-Unternehmen
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Klassische Software hat eine glückliche Eigenheit: Sobald das Produkt gebaut ist, kostet die Bedienung eines weiteren Kunden fast nichts. Deshalb wurden die Bruttomargen von Software zu dem, was Investoren bewunderten. KI-Produkte brechen mit dieser Eigenheit. Jedes Mal, wenn ein Kunde das Produkt um etwas bittet, läuft ein Modell, und der Betrieb eines Modells kostet echtes Geld. Diese Kosten heißen Inferenz, und sie sind der wichtigste Grund, warum die Bruttomarge eines KI-Unternehmens ganz anders aussehen kann als die eines klassischen Softwareunternehmens.
Dieser Artikel erklärt die Mechanik: was Inferenz ist, warum sie sich wie ein variabler Kostenfaktor verhält, wie aus den Kosten einer einzelnen Anfrage eine Margenzahl wird, warum eine Handvoll intensiver Nutzer den Durchschnitt ruinieren kann und wie Ihr Preismodell entscheidet, wer das Risiko trägt. Er richtet sich an Gründer und inhabergeführte CEOs von B2B-Unternehmen mit einem Team. Das Rechenbeispiel verwendet runde, hypothetische Zahlen und spiegelt nicht den Preis eines realen Modells wider.
Wie diese Kosten in der Gewinn- und Verlustrechnung eingeordnet werden, lesen Sie unter Was bei einem KI-Unternehmen als COGS zählt. Wege, sie zu senken, finden Sie unter Kostenmanagement für KI-Modelle. Dieser Beitrag bleibt dabei, wie die Kosten funktionieren und wie sie die Marge erreichen.
Training im Vergleich zur Inferenz
Zwei verschiedene Tätigkeiten verbrauchen in einem KI-Geschäft Rechenleistung, und sie verhalten sich sehr unterschiedlich.
Training ist das Aufbauen oder Anpassen eines Modells. Es findet vor der Bedienung von Kunden statt (oder periodisch parallel dazu). Es ist teuer, sprunghaft und weitgehend unabhängig davon, wie viele Menschen Ihr Produkt nutzen. Wenn Sie Ihr eigenes Modell bauen, ähnelt ein Trainingslauf eher einem Entwicklungsprojekt als den Kosten für die Lieferung eines Verkaufs.
Inferenz ist das Ausführen eines trainierten Modells, um eine Antwort zu erzeugen. Sie findet jedes Mal statt, wenn ein Kunde eine Aktion ausführt. Wenn Sie ein Modell per Fine-tuning anpassen oder das eines anderen aufrufen, gilt dieselbe Trennung: Die Fähigkeit aufzubauen ist ein Kostenfaktor, sie bereitzustellen ein anderer.
Die Unterscheidung ist wichtig, weil beide auf unterschiedlichen Achsen skalieren. Die Trainingskosten skalieren damit, wie ambitioniert das Modell ist. Die Inferenzkosten skalieren damit, wie viel Ihre Kunden es nutzen. Ein Startup, das ein KI-Produkt an mehr Kunden verkauft oder bestehende Kunden dazu bringt, es stärker zu nutzen, steigert nicht seine Trainingsrechnung. Es steigert seine Inferenzrechnung, fast eins zu eins.
Deshalb sind Inferenzkosten die Kosten, die in der Bruttomarge auftauchen. Sie entstehen bei der Lieferung des Produkts, und sie steigen, wenn die Lieferung steigt.
Warum sich Inferenz wie ein variabler Kostenfaktor verhält
Bei einem klassischen Softwareprodukt sind die Grenzkosten einer Anfrage ein Rundungsfehler. Sie bezahlen Server in Blöcken, und der Traffic füllt diese Blöcke. Bei einem KI-Produkt erledigt jede Anfrage einen eigenen Rechenblock, und dessen Größe hängt davon ab, worum es in der Anfrage geht. Mehrere Faktoren bestimmen sie.
Tokens hinein und Tokens heraus. Sprachmodelle lesen und schreiben Text in kleinen Einheiten, den Tokens. Eine kurze Frage mit kurzer Antwort ist günstig. Ein langes Dokument mit langer Zusammenfassung ist es nicht. Anbieter wie auch selbst gehostete Setups behandeln die Leseseite (die Eingabe) und die Schreibseite (die Ausgabe) meist unterschiedlich, und lange Ausgaben kosten in der Erzeugung in der Regel mehr als das Lesen derselben Menge an Eingabe.
Kontextlänge. Viele Produkte packen zusätzliches Material in jede Anfrage: den bisherigen Gesprächsverlauf, abgerufene Dokumente, Anweisungen, Beispiele. Dieser Kontext wird jedes Mal neu gelesen. Ein Chat, der zwanzig Runden tief ist, kostet pro Nachricht mehr als die erste Nachricht, weil der gesamte Verlauf mitfährt.
Modellgröße. Ein größeres, leistungsfähigeres Modell kostet pro Token mehr als ein kleineres. Ein einziges Modell für jede Aufgabe zu wählen ist das einfachste Design und oft das teuerste.
Denkschritte. Manche Modelle verbrauchen zusätzliche Tokens, um zu „denken“, bevor sie antworten. Diese Denk-Tokens gehören in der Regel zu dem, wofür Sie bezahlen, auch wenn der Kunde sie nie sieht. Eine schwierige Frage kann um ein Vielfaches mehr Tokens erzeugen, als die sichtbare Antwort vermuten lässt.
Agent-Schleifen. Ein KI-Agent antwortet nicht einmal. Er plant, ruft ein Tool auf, liest das Ergebnis, entscheidet über den nächsten Schritt und wiederholt das. Jeder Durchlauf ist ein weiterer Modellaufruf, und jeder Aufruf liest einen wachsenden Kontext neu. Das Engineering-Team von Anthropic berichtet in seiner Beschreibung des eigenen Multi-Agent-Recherchesystems, dass Agents typischerweise etwa 4-mal mehr Tokens verbrauchen als Chat-Interaktionen und Multi-Agent-Systeme etwa 15-mal mehr. Das sind die Daten eines Unternehmens zu einer Art von Arbeitslast. Verstehen Sie die Verhältnisse daher als Veranschaulichung, wie steil die Kosten steigen können, wenn Sie vom Antworten zum Handeln übergehen, nicht als universellen Multiplikator.
Wiederholungen und Fehlschläge. Wenn eine Ausgabe eine Prüfung nicht besteht, von einem Validator abgelehnt wird oder ein Tool-Aufruf fehlschlägt, versucht es das Produkt oft erneut. Jede Wiederholung kostet so viel wie der ursprüngliche Versuch. Ein Produkt mit einer Wiederholungsrate von 10 % trägt etwa 10 % mehr Inferenzausgaben, als sein „Idealpfad“ vermuten lässt.
Zusammengenommen sehen Sie, warum zwei Aktionen, die in der Oberfläche Ihres Produkts identisch aussehen, etwa „Analyse ausführen“, sich in den Kosten um den Faktor zehn oder hundert unterscheiden können. Einen tieferen Blick auf die Kostenkontrolle speziell in Agent-Systemen bietet Kostenoptimierung für KI-Agents.
Wie aus den Kosten pro Anfrage die Bruttomarge wird
Die Bruttomarge ist der Umsatz abzüglich der direkten Kosten für die Lieferung des Produkts, geteilt durch den Umsatz. Bei einem KI-Unternehmen ist die Inferenz der größte direkte Kostenposten in dieser Subtraktion, meist ergänzt durch Hosting, Monitoring und Kundensupport. Unser Nachschlageartikel zur Bruttomarge behandelt die allgemeine Formel. Hier brauchen wir nur die Form des Zusammenhangs.
Wenn Ihr Umsatz pro Kunde fest ist und Ihre Inferenzkosten pro Kunde mit der Nutzung schwanken, dann schwankt die Bruttomarge von Kunde zu Kunde. Die Marge ist keine Eigenschaft des Produkts. Sie ist eine Eigenschaft des Produkts multipliziert damit, wie jeder Kunde es nutzt, bei einem gegebenen Preis.
Das hat eine praktische Konsequenz. Sie können die gemischte Margenzahl nicht ablesen und daraus schließen, ob das Geschäft gesund ist. Eine gemischte Marge von 70 % kann bedeuten, dass die meisten Kunden bei 80 % liegen und einige bei 20 %. Oder sie kann bedeuten, dass alle in der Nähe von 70 % liegen. Die beiden Unternehmen haben sehr unterschiedliche Risiken, und nur das erste hat ein Problem mit intensiven Nutzern.
Ein Rechenbeispiel mit illustrativen Zahlen
Bauen wir eines. Jede Zahl hier ist hypothetisch und rund. Keine davon ist ein realer Preis.
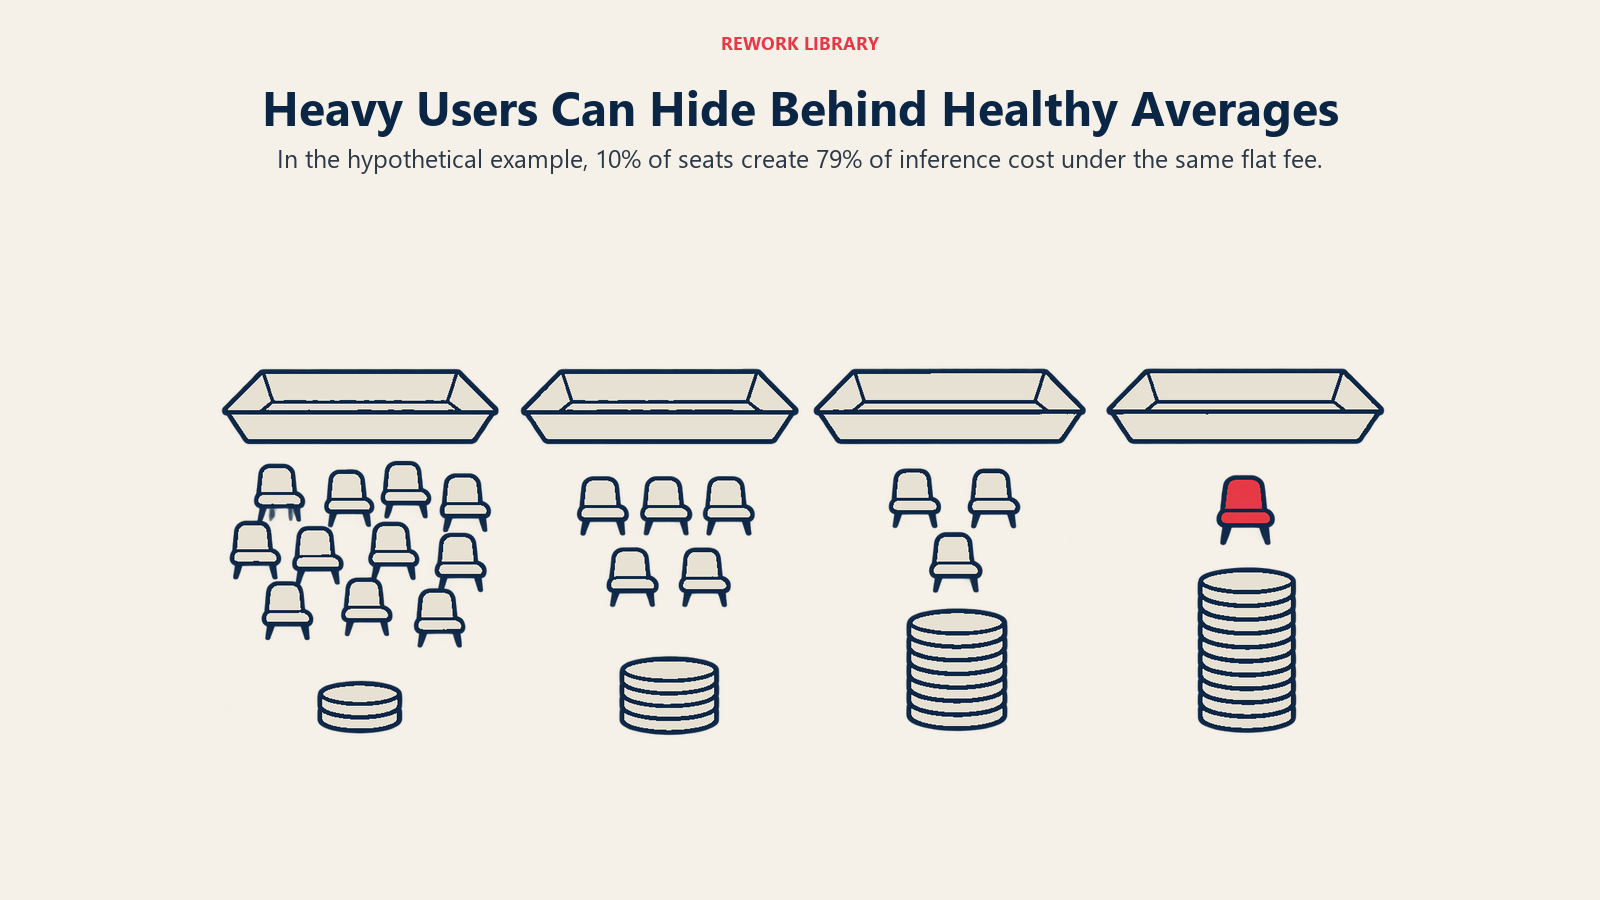
Angenommen, Sie verkaufen einen KI-Assistenten zum Pauschalpreis von $30 pro Seat und Monat. Nehmen Sie an, dass eine Anfrage Sie 1 Cent an Inferenz kostet. Sie haben 100 Seats, und die Nutzung ist ungleich verteilt, wie fast immer:
| Kundengruppe | Seats | Anfragen pro Seat und Monat | Inferenzkosten pro Seat | Gesamte Inferenzkosten |
|---|---|---|---|---|
| Gering | 60 | 50 | $0,50 | $30 |
| Mittel | 30 | 400 | $4,00 | $120 |
| Intensiv | 9 | 4.000 | $40,00 | $360 |
| Extrem | 1 | 20.000 | $200,00 | $200 |
| Gesamt | 100 | $710 |
Der Umsatz beträgt 100 Seats mal $30, also $3.000. Die Inferenz kostet $710. Ohne alle anderen Kosten beträgt die Bruttomarge (3.000 minus 710) geteilt durch 3.000, also etwa 76 %.
Sieht gesund aus. Schauen Sie jetzt hinein.
- Die 60 geringen Seats bringen jeweils etwa $29,50 Marge.
- Die 9 intensiven Seats verlieren jeweils $10, weil $40 Inferenz die $30 übersteigen, die sie zahlen.
- Der 1 extreme Seat verliert $170.
- Diese 10 intensiven und extremen Seats (10 % der Kunden) verursachen $560 der $710 Kosten, also etwa 79 % aller Inferenzausgaben.
Die gemischte Zahl verbirgt eine Quersubventionierung. Geringe Nutzer bezahlen für intensive. Das geht gut, solange die Mischung stabil bleibt, und wird fragil, sobald sie sich verschiebt.
Was passiert, wenn die Nutzung pro Aufgabe steigt
Angenommen, Sie liefern ein Upgrade aus: Der Assistent wird zu einem Agent, der pro Anfrage mehrere Schritte ausführt. Nehmen wir an, das verfünffacht die Kosten jeder Anfrage, sodass eine Anfrage 5 Cent kostet. Die Kunden ändern nicht, wie viele Anfragen sie senden. Die Kosten betragen jetzt $3.550 gegenüber $3.000 Umsatz, die Bruttomarge liegt also bei etwa minus 18 %.
Sie haben das Produkt verbessert, die Nutzung hat sich nicht verändert, und Sie sind von einer softwareähnlichen Marge zu einem Verlust bei jedem Seat übergegangen. Ein Pauschalpreis kann eine Veränderung der Kosten pro Anfrage nicht auffangen, weil der Preis nichts von Anfragen weiß.
Der Long Tail der intensiven Nutzer
Das Beispiel zeigt das Muster, das man den Long Tail der intensiven Nutzer nennt. Die Nutzung über Kunden hinweg ist selten eine Glockenkurve. Sie ist meist schief verteilt: Die meisten Kunden nutzen eine moderate Menge, eine kleine Gruppe nutzt ein Vielfaches davon. Bei Pauschalpreisen ist der Umsatz pro Kunde gedeckelt, die Kosten aber nicht.
Drei Dinge machen den Long Tail bei KI schlimmer als bei älterer Software.
- Die besten Kunden sind die teuersten. Die Menschen, die das Produkt lieben, nutzen es am meisten. Sie verlängern, sie expandieren, und sie erzählen Kollegen davon. Aber ihre Inferenzrechnungen wachsen mit ihrer Begeisterung.
- Agents heben die Obergrenze an. Ein Mensch kann nur eine begrenzte Zahl von Anfragen pro Stunde senden. Ein geplanter Agent kann Tausende senden. Automatisierung beseitigt die natürliche Grenze der Nutzung pro Seat.
- Der Long Tail wächst, wenn sich das Produkt verbessert. Bessere Ergebnisse bedeuten, dass Kunden dem Produkt größere Aufgaben, längere Dokumente und eigenständigere Arbeit anvertrauen. Jedes davon erhöht die Kosten pro Aufgabe.
Nichts davon macht Pauschalpreise falsch. Es bedeutet, dass Pauschalpreise das Kostenrisiko auf Sie legen, und Sie sollten wissen, dass das der Handel ist, den Sie eingegangen sind.
Wie die Wahl des Preismodells entscheidet, wer das Risiko trägt
Am klarsten denken Sie über die Preisgestaltung eines KI-Produkts nach, wenn Sie eine einzige Frage stellen: Wenn die Kosten pro Kunde steigen, wer bezahlt?
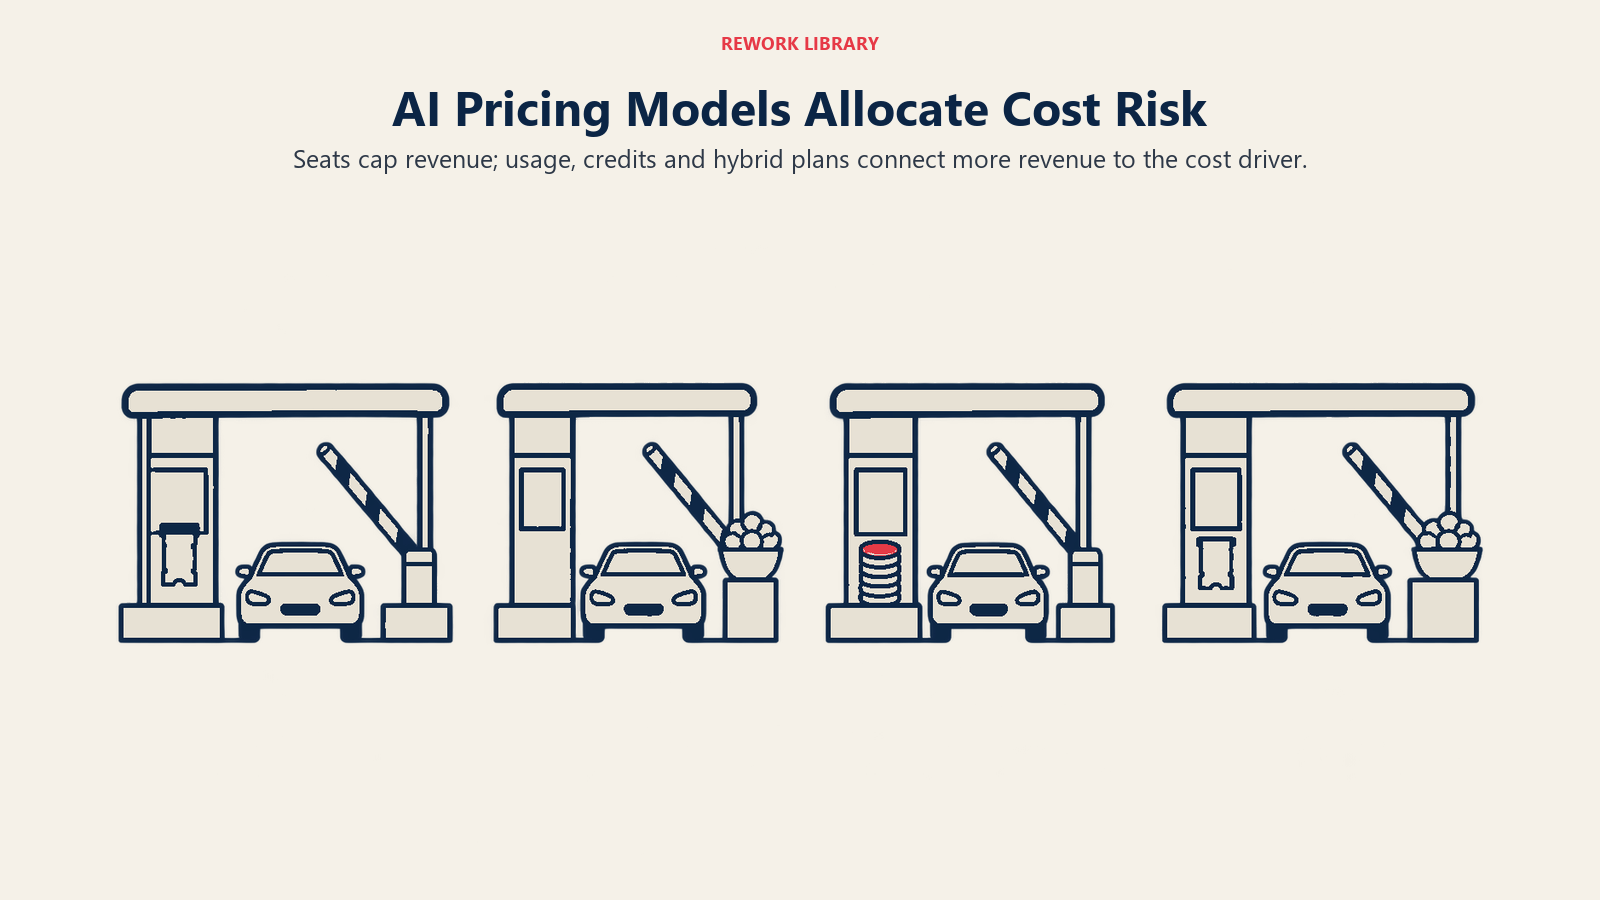
| Preismodell | Wofür der Kunde zahlt | Wer das Risiko der Inferenzkosten trägt | Wann die Marge geschützt ist |
|---|---|---|---|
| Pauschal pro Seat | Zugang für einen Nutzer | Überwiegend Sie | Wenn die Nutzung pro Seat stabil und gering ist |
| Nutzungsbasiert | Verbrauchte Einheiten (Anfragen, Aufgaben, Minuten) | Überwiegend der Kunde | Wenn der Einheitspreis die Kosten mit Spielraum deckt |
| Credits | Ein vorausbezahltes Guthaben, das für Aktionen ausgegeben wird | Geteilt, abhängig von der Preistabelle | Wenn die Credits pro Aktion den tatsächlichen Kosten folgen |
| Hybrid (Plattformgebühr plus enthaltene Nutzung) | Eine Grundgebühr plus Mehrverbrauch | Geteilt | Wenn das enthaltene Kontingent deutlich unterhalb des Long Tail bemessen ist |
Pauschale Seats sind einfach zu verkaufen und für den Käufer leicht zu prognostizieren. Sie sind aber auch das Modell, das dem Long Tail am stärksten ausgesetzt ist. Unser Artikel zur Preisgestaltung pro Nutzer im KI-Zeitalter erläutert, warum die Einheit Seat schwächer wird, wenn Arbeit von Software statt von Menschen erledigt wird.
Nutzungsbasierte Preisgestaltung bindet den Umsatz an denselben Treiber, der die Kosten treibt. Wenn jede Anfrage 3 Cent einbringt und 1 Cent kostet, behalten Sie bei jeder Anfrage eine Marge von 67 %, egal wie viele eintreffen. Der Preis, den Sie dafür zahlen, ist die mangelnde Planbarkeit für den Käufer.
Credits sind nutzungsbasierte Preisgestaltung in einer Verpackung. Wenn die Preistabelle auf realen Kosten beruht, ist die Marge pro Aktion geschützt. Wenn sich die Kosten pro Aktion ändern und die Preistabelle nicht, haben Sie das Problem des Pauschalpreises innerhalb eines Credit-Systems nachgebaut. Die Designentscheidungen behandeln wir in Creditbasierte Preisgestaltung für KI-Produkte.
Hybride Modelle kombinieren eine planbare Grundgebühr mit einem Kontingent und messen darüber hinaus ab. Sie geben dem Käufer eine Zahl zum Budgetieren und Ihnen eine Obergrenze dafür, wie weit der Long Tail reichen kann. Siehe Hybride Preisgestaltung für KI-Produkte.
Zurück zum Beispiel: Die Lösung ist kein Geheimnis. Wenn Sie auf $10 pro Seat plus 3 Cent pro Anfrage jenseits der ersten 300 enthaltenen umstellen würden, zahlte der extreme Seat rund $600 statt $30, und seine Kosten von $200 wären gedeckt. Die geringen Seats würden ihre Grundgebühr von $10 zahlen und innerhalb des Kontingents bleiben. Sie müssten testen, ob der niedrigere Listenpreis weiterhin konvertiert, und das ist ein echter Zielkonflikt. Aber die Struktur bringt Umsatz und Kosten dort zusammen, wo die Kosten tatsächlich entstehen.
Der langfristige Trend: günstiger pro Einheit, mehr Einheiten pro Aufgabe
Gründer hören oft, dass Inferenz immer günstiger wird, sodass sich Margenprobleme von selbst lösen. Daran ist etwas Wahres, aber es gibt einen Haken.
Das Wahre ist gut dokumentiert. Die Analyse von Andreessen Horowitz zu diesem Trend, den sie LLMflation nennt, besagt, dass bei einem LLM gleicher Leistung die Kosten jedes Jahr um den Faktor 10 sinken. Epoch AI, das Spitzenmodelle auf sechs Benchmarks über etwa drei Jahre untersucht hat, stellt fest, dass die Rate des Rückgangs je nach Leistungsmeilenstein dramatisch variiert und zwischen dem 9-Fachen und dem 900-Fachen pro Jahr liegt. Es fügt hinzu, dass die stärksten Rückgänge im jüngsten Jahr stattfanden, weshalb weniger klar ist, ob sie anhalten. Beide Aussagen betreffen den Preis für das Erreichen eines festen Fähigkeitsniveaus. Sie sagen nicht, was Sie im nächsten Jahr für das beste verfügbare Modell zahlen werden.
Der Haken ist die zweite Hälfte der Gleichung. Die Kosten pro Aufgabe entsprechen den Kosten pro Fähigkeitseinheit mal der Menge an Fähigkeit, die die Aufgabe verbraucht. Der erste Term ist schnell gefallen. Der zweite steigt tendenziell, aus den weiter oben in diesem Artikel genannten Gründen:
- Kunden wollen das leistungsfähigste Modell, nicht das vom letzten Jahr, also kaufen sie weiter an der Spitze.
- Denkschritte fügen jeder Antwort Tokens hinzu.
- Agent-Schleifen machen aus einer Anfrage viele Aufrufe.
- Längere Kontexte und größere Dokumente werden praktikabel, also nutzen die Menschen sie.
Die Zahlen von Anthropic oben zeigen die Größenordnung auf der Nutzungsseite: Ein Wechsel von Chat zu Agents vervielfacht die Tokens pro Aufgabe mehrfach. Ein jährlicher Preisrückgang um den Faktor 10 pro Fähigkeitseinheit kann von einem Produkt aufgezehrt werden, das pro Aufgabe weit mehr Einheiten verbraucht. Der Nettoeffekt auf Ihre Marge hängt davon ab, welche Kraft bei Ihrer Arbeitslast gewinnt, und das ist eine empirische Frage, die Sie aus Ihren eigenen Daten beantworten müssen.
Die daraus folgende Planungshaltung ist konservativ. Bepreisen Sie das heutige Produkt nicht unter der Annahme, dass die Kosten weit genug fallen, um es zu retten. Bepreisen Sie es so, dass die Marge jedes Kunden zu den heutigen Kosten hält, und behandeln Sie fallende Einheitskosten als Zusatzgewinn, den Sie mit Kunden teilen oder behalten können.
Was Sie messen sollten
Die Mechanik hilft nur, wenn Sie sie in Ihren eigenen Zahlen sehen können. Verfolgen Sie Folgendes:
- Inferenzkosten pro aktivem Kunden und Monat. Der Durchschnitt ist weniger nützlich als die Verteilung. Schauen Sie auf den Median, das 90. Perzentil und die zehn größten Accounts.
- Bruttomarge pro Kunde oder pro Nutzungskohorte. Finden Sie heraus, wie viele Kunden unter Ihrem Zielwert liegen.
- Kosten pro abgeschlossener Aufgabe, nicht pro Anfrage. Wenn Wiederholungen und Agent-Schritte in „einer Aufgabe“ verborgen sind, unterschätzen Zahlen pro Anfrage die Kosten.
- Kostenanteil der obersten 10 % der Nutzer. Im Beispiel waren es 79 %. Wenn Ihre Kosten ähnlich konzentriert sind, sollten Sie zuerst bei der Preisgestaltung ansetzen.
- Kosten pro Anfrage im Zeitverlauf bei konstantem Verhalten. Das trennt einen fallenden Einheitspreis von einem wachsenden Nutzungsfußabdruck.
Wenn Sie diese Werte heute nicht berechnen können, ist der Aufbau des dafür nötigen Loggings mehr wert als die meisten Preisexperimente, denn jede Preisentscheidung beruht darauf zu wissen, woher die Kosten kommen.
Wichtige Fakten: Inferenzkosten und Bruttomarge
- Training baut ein Modell und ist weitgehend unabhängig vom Kundenvolumen. Inferenz führt das Modell für jede Kundenaktion aus und skaliert mit der Nutzung, weshalb sie in der Bruttomarge landet.
- Die Kosten pro Anfrage hängen von Tokens hinein und heraus, Kontextlänge, Modellgröße, Denkschritten, Agent-Schleifen und Wiederholungen ab.
- Agents verbrauchen typischerweise etwa 4-mal mehr Tokens als Chat-Interaktionen, Multi-Agent-Systeme etwa 15-mal mehr (Engineering-Team von Anthropic, zum eigenen Recherchesystem).
- Bei einem LLM gleicher Leistung sinken die Kosten jedes Jahr um den Faktor 10 (a16z).
- Epoch AI stellt Preisrückgänge zwischen dem 9-Fachen und dem 900-Fachen pro Jahr fest, je nach Leistungsmeilenstein, mit den stärksten Rückgängen im jüngsten Jahr.
- Bei Pauschalpreisen ist der Umsatz pro Kunde gedeckelt, die Inferenzkosten aber nicht, sodass intensive Nutzer mit negativer Marge laufen können, während die gemischte Zahl gesund aussieht.
- Im illustrativen Beispiel dieses Artikels verursachen 10 % der Seats etwa 79 % der Inferenzkosten, und eine Verfünffachung der Kosten pro Anfrage macht aus einer Marge von 76 % einen Verlust.
- Nutzungsbasierte, creditbasierte und hybride Preisgestaltung verlagern mehr Kostenrisiko auf den Kunden als pauschale Seats.
Die Erkenntnis ist kurz. Inferenz macht aus den Kosten für die Lieferung von Software einen Rundungsfehler eine Position, die sich mit jeder Anfrage bewegt, und Ihr Preismodell entscheidet, ob diese Bewegung beim Kunden oder bei Ihrer Marge landet. Kennen Sie die Verteilung der Nutzung über Ihre Accounts, und bepreisen Sie auf Basis der Kosten, die Sie jetzt haben.
Häufig gestellte Fragen zu Inferenzkosten und Bruttomarge
Was ist Inferenz bei KI?
Inferenz ist das Ausführen eines trainierten Modells, um eine Ausgabe für einen Nutzer zu erzeugen, etwa eine Frage zu beantworten oder eine Aufgabe zu erledigen. Sie findet jedes Mal statt, wenn ein Kunde eine Aktion ausführt, daher wachsen ihre Kosten mit der Nutzung. Training ist dagegen die einmalige oder periodische Arbeit, das Modell aufzubauen.
Warum ist Inferenz ein variabler Kostenfaktor?
Jede Anfrage löst eine eigene Berechnung aus, und deren Umfang hängt von Tokens hinein und heraus, Kontextlänge, Modellgröße, Denkschritten, Agent-Schleifen und Wiederholungen ab. Mehr Anfragen oder aufwendigere Anfragen bedeuten eine höhere Rechnung. Das unterscheidet sich von klassischer Software, bei der eine zusätzliche Anfrage fast nichts kostet.
Wie wirken sich Inferenzkosten auf die Bruttomarge aus?
Inferenz ist in der Regel der größte direkte Kostenposten bei der Lieferung eines KI-Produkts und senkt die Bruttomarge daher direkt. Weil sie von Kunde zu Kunde schwankt, Abonnementumsätze oft aber nicht, wird die Marge zu einer Zahl pro Kunde. Eine gesunde gemischte Marge kann Kunden verbergen, die mehr kosten, als sie zahlen.
Was ist das Problem intensiver Nutzer bei der KI-Preisgestaltung?
Bei Pauschalpreisen ist der Umsatz pro Kunde gedeckelt, die Inferenzkosten aber nicht. Eine kleine Gruppe intensiver Nutzer, oft Ihre engagiertesten Kunden, kann den Großteil der Kosten verursachen und mit negativer Marge laufen. Geringe Nutzer subventionieren sie am Ende, was nur funktioniert, solange die Nutzungsmischung stabil bleibt.
Lösen fallende Inferenzpreise das Margenproblem von selbst?
Nicht zuverlässig. Die Preise für ein festes Fähigkeitsniveau sind schnell gefallen, a16z nennt etwa den Faktor 10 pro Jahr und Epoch AI eine Spanne vom 9-Fachen bis zum 900-Fachen pro Jahr. Kunden nutzen aber auch leistungsfähigere Modelle, längere Kontexte, Denkschritte und Agents, was die Rechenmenge pro Aufgabe erhöht. Welche Kraft gewinnt, hängt von Ihrer Arbeitslast ab.
Welches Preismodell schützt die Marge am besten vor Inferenzkosten?
Modelle, die den Umsatz an die Nutzung binden, etwa nutzungsbasierte Preisgestaltung oder Credits mit einer genauen Preistabelle, schützen die Marge pro Anfrage. Hybride Modelle mit einem enthaltenen Kontingent begrenzen den Long Tail und behalten eine planbare Grundgebühr. Pauschale Seats lassen das meiste Risiko bei Ihnen. Die richtige Wahl hängt auch davon ab, wie viel Unplanbarkeit Ihre Käufer akzeptieren.
Was sollte ich zuerst messen?
Beginnen Sie mit den Inferenzkosten pro Kunde und deren Verteilung über die Accounts, insbesondere dem Kostenanteil Ihrer obersten 10 % der Nutzer. Verfolgen Sie dann die Kosten pro abgeschlossener Aufgabe statt pro Anfrage und die Bruttomarge pro Nutzungskohorte. Diese drei zeigen, ob Ihre Preisgestaltung dazu passt, wo die Kosten entstehen.
Weiterführende Lektüre

Co-Founder & COO
On this page
- Training im Vergleich zur Inferenz
- Warum sich Inferenz wie ein variabler Kostenfaktor verhält
- Wie aus den Kosten pro Anfrage die Bruttomarge wird
- Ein Rechenbeispiel mit illustrativen Zahlen
- Was passiert, wenn die Nutzung pro Aufgabe steigt
- Der Long Tail der intensiven Nutzer
- Wie die Wahl des Preismodells entscheidet, wer das Risiko trägt
- Der langfristige Trend: günstiger pro Einheit, mehr Einheiten pro Aufgabe
- Was Sie messen sollten
- Weiterführende Lektüre